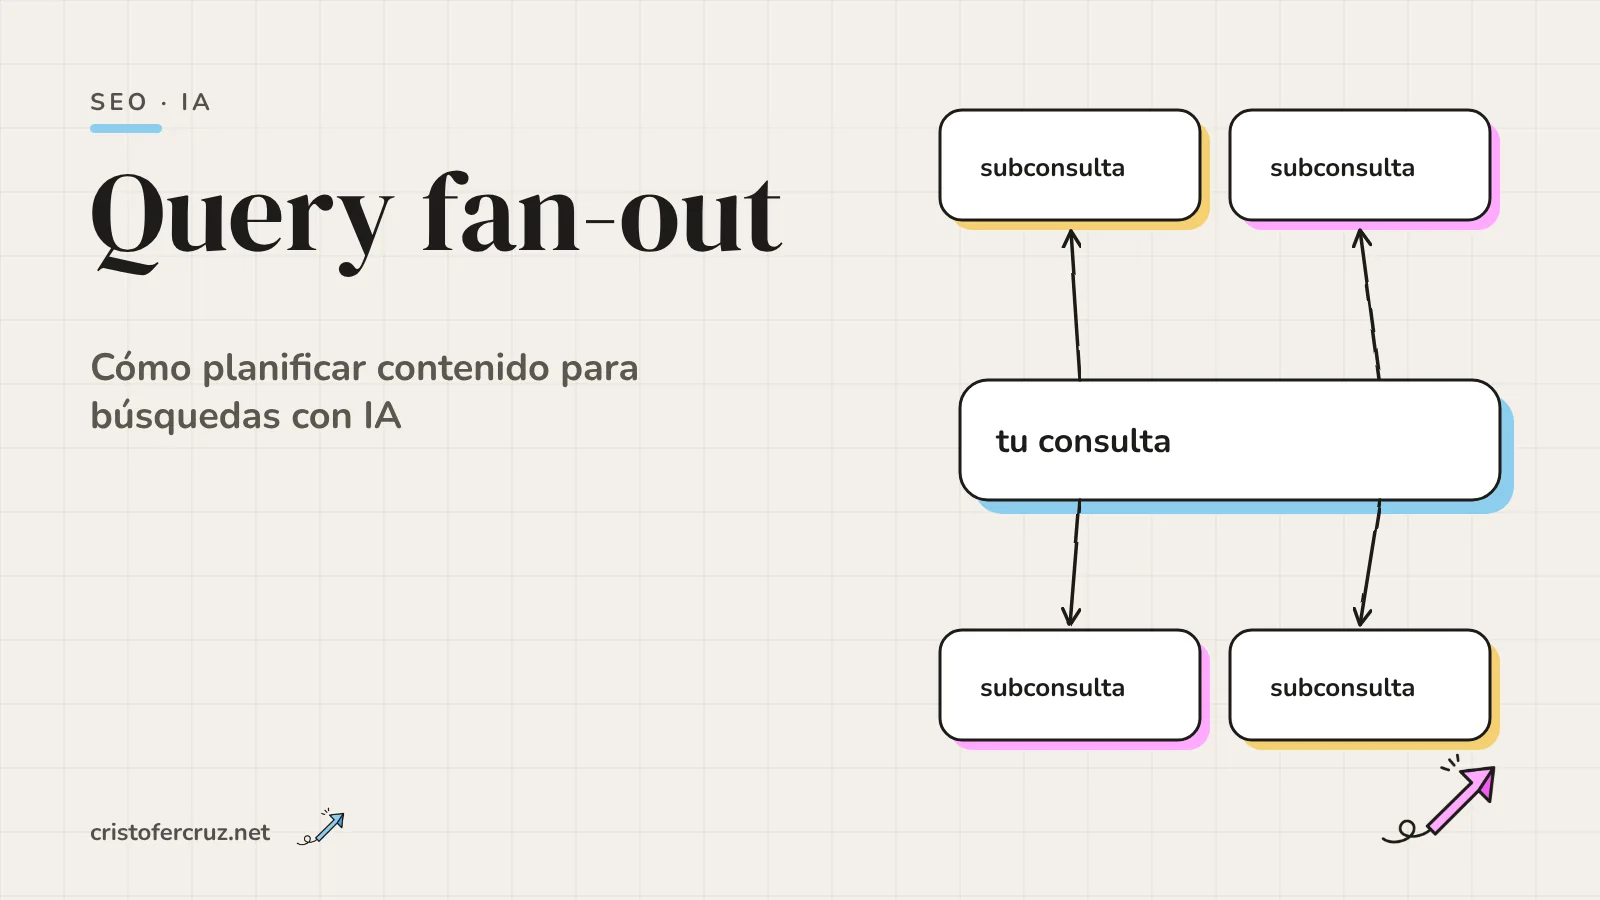
- Google documenta el query fan-out: AI Overviews y AI Mode pueden lanzar varias búsquedas relacionadas sobre subtemas y fuentes de datos. No documenta cuántas lanza ni cómo elige las páginas que enlaza.
- Las subconsultas reales no se ven. Lo que puedes hacer es estimarlas con People Also Ask, autosuggest, el top 10, tus consultas de Search Console y un modelo de IA, y tratar el resultado como aproximación.
- Un estudio de Seer Interactive sobre 501 prompts con la API de Gemini 3 midió una media de 10,7 subconsultas por prompt y un 95 % sin volumen de búsqueda. Es un dato de un modelo y un método, no de Google Search.
- Planificar con fan-out no es trocear páginas ni rellenar long tails: Google dice en su guía que no hace falta. Es comprobar que cada subtema relevante tiene una respuesta completa en tu sitio.
- Una plantilla de mapa (consulta, subconsulta, intención, página, formato, evidencia, estado) convierte la estimación en tareas concretas.
- Se mide con el informe de Rendimiento y el informe de IA generativa de Search Console, que da impresiones, no clics ni consultas.
Quien busca «query fan-out SEO» quiere saber qué cambia en su contenido si Google, ante una pregunta compleja, no lanza una búsqueda sino varias. Lo que he leído sobre el tema suele quedarse en una definición y una lista de consejos (cubre subtemas, usa encabezados, añade schema), y casi nunca separa lo que Google ha dicho de lo que se deduce de una patente o de un estudio de terceros.
Aquí separo esas capas y las convierto en un método: cómo estimar subconsultas, cómo anotarlas en un mapa y cómo comprobar si tu contenido las cubre. Lo aplico a un artículo de mi propio blog, con los límites a la vista.
Qué es el query fan-out y qué dice Google
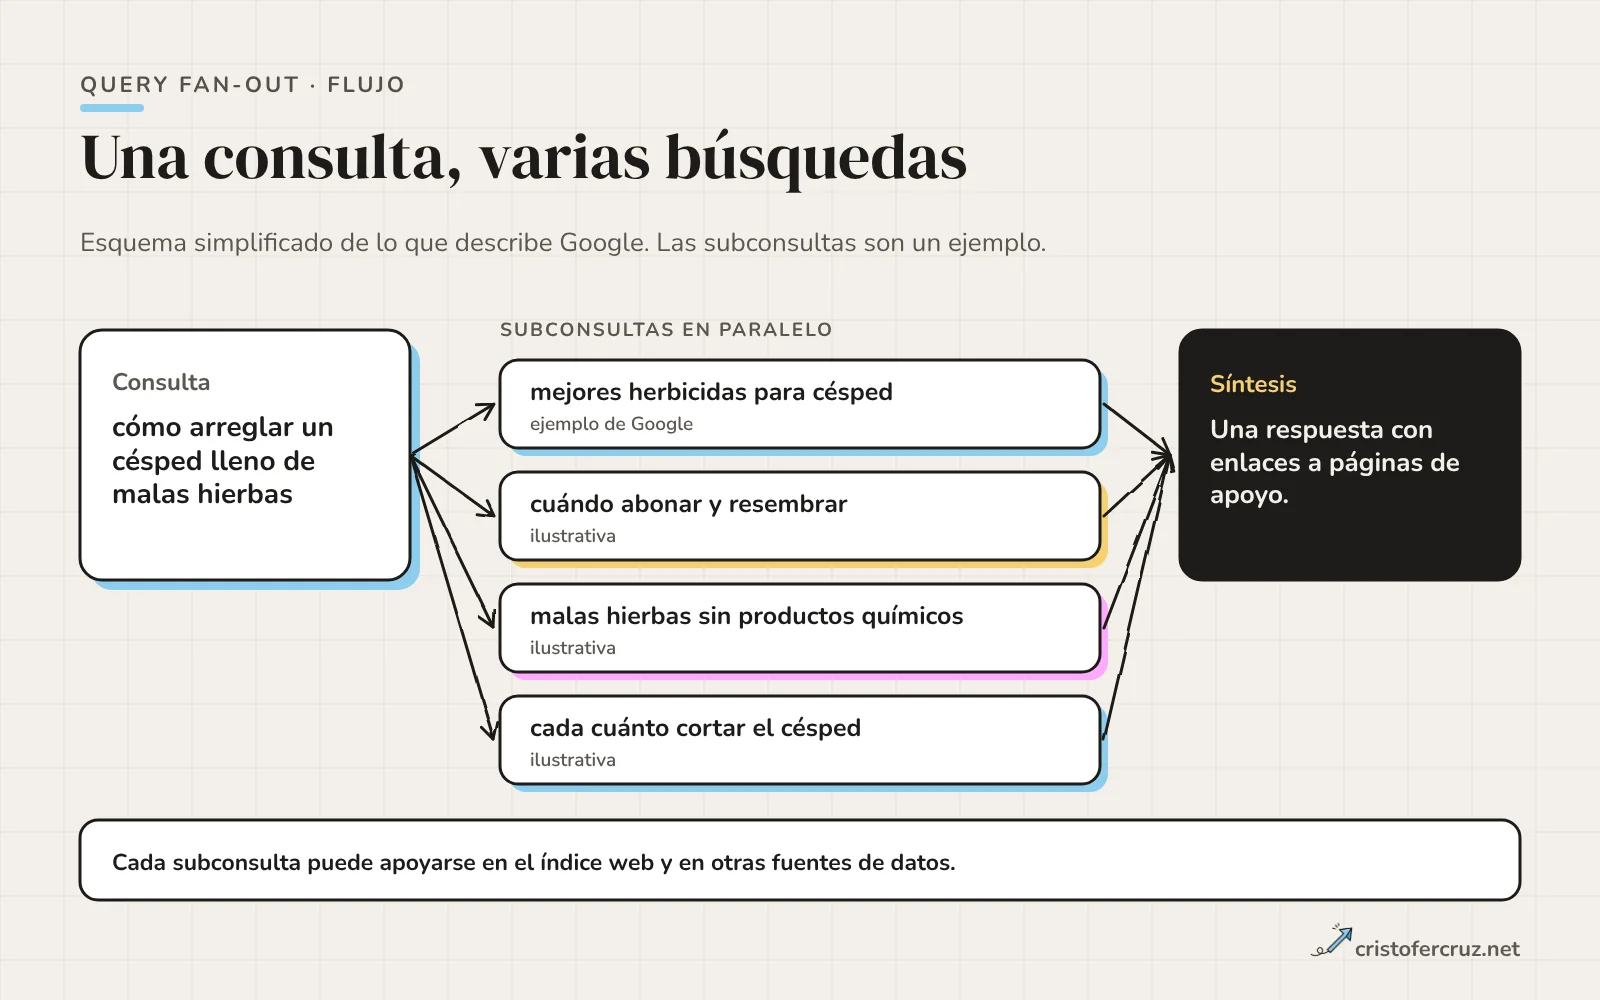
Query fan-out es la técnica por la que un sistema de búsqueda con IA descompone una consulta en varias búsquedas relacionadas, las lanza a la vez y combina lo que encuentra en una sola respuesta. El término es de Google, que lo usó al presentar AI Mode el 5 de marzo de 2025: según su anuncio, AI Mode emite varias búsquedas relacionadas de forma simultánea sobre subtemas y varias fuentes de datos (traducción mía). Para el producto en sí, tienes mi guía de AI Mode de Google.
Lo que Google ha dicho, con fecha y fuente, cabe en una tabla.
| Fuente | Fecha | Qué dice |
|---|---|---|
| Anuncio de AI Mode (blog de Google) | 5 mar. 2025 | AI Mode usa query fan-out: búsquedas relacionadas y simultáneas sobre subtemas y varias fuentes de datos |
| «AI in Search» (Elizabeth Reid, blog de Google) | 20 may. 2025 | AI Mode «usa nuestra técnica de query fan-out» y Deep Search usa la misma técnica «llevada al siguiente nivel», con cientos de búsquedas |
| AI features and your website (Search Central) | Actualizada 10 dic. 2025 | AI Overviews y AI Mode pueden usar query fan-out. Para salir como enlace de apoyo, la página debe estar indexada y ser apta para mostrarse con snippet; no hay requisitos técnicos adicionales |
| Optimizing your website for generative AI features (Search Central) | Actualizada 10 jul. 2026 | Define el fan-out como un conjunto de consultas relacionadas y simultáneas generadas por el modelo para pedir más información, con el ejemplo «how to fix a lawn that's full of weeds» que se abre en «best herbicides for lawns» |
La última fila es la más útil para un SEO: Google trata esto como parte de las funciones de IA sobre su búsqueda, que según su guía se apoyan en los sistemas de ranking y calidad de Search y recuperan páginas del índice (lo que llama grounding o RAG). Para cómo se comportan las AI Overviews como resultado, tengo otra guía.
Cómo funciona: lo documentado y lo que no
El proceso, a grandes rasgos, tiene cuatro pasos: el sistema interpreta la consulta, genera subconsultas, las ejecuta en paralelo y sintetiza una respuesta con enlaces. Google documenta la idea, no el detalle. La siguiente figura separa tres niveles de certeza.
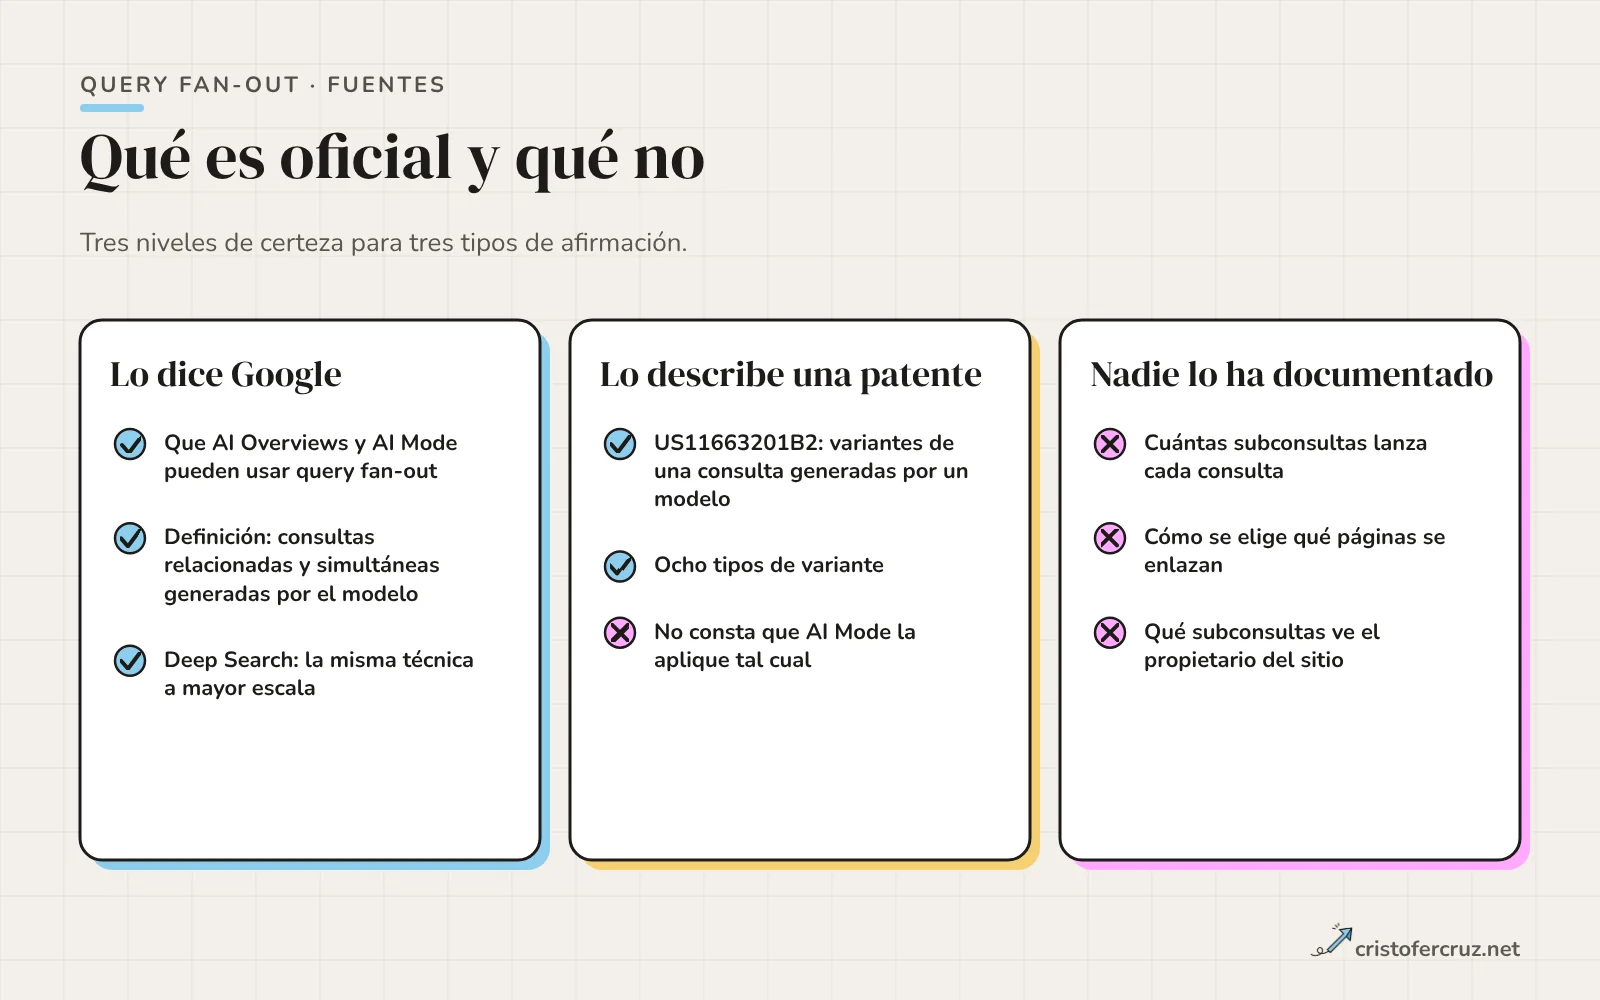
Sobre el volumen no hay cifra oficial para AI Mode ni para AI Overviews. Lo único que dice Google es que Deep Search puede lanzar cientos de búsquedas. Para tener un orden de magnitud hay estudios de terceros, con sus límites.
Un estudio con datos, y sus límites
Seer Interactive publicó el 21 de noviembre de 2025 un análisis de 501 prompts de sus clientes lanzados contra la API de Gemini 3 con la búsqueda web forzada en todos ellos. Midieron una media de 10,7 subconsultas por prompt, con un mínimo de 3 y un máximo de 28, y una longitud media de 6,7 palabras. El 95 % de esas subconsultas tenía volumen de búsqueda global cero y solo había un 1 % de solapamiento entre todas.
Tres cautelas antes de citarlo. Es la API de un modelo, no Google Search ni AI Mode. La búsqueda forzada en cada prompt no refleja cuándo busca el modelo por su cuenta. Y es una sola muestra de un solo proveedor. Sirve para dos ideas útiles: las subconsultas se parecen poco entre ejecuciones y las herramientas de volumen casi no las ven. Es una inferencia mía; el estudio no mide cómo se comporta Google.
Los artículos que revisé del top de resultados en español (Ahrefs, SISTRIX, Search Engine Land y varios blogs de consultores) explican bien el concepto. Lo que dejan sin cerrar es cómo obtener las subconsultas de una consulta concreta y cómo comprobar el resultado, que es lo que desarrollo desde aquí.
La patente: qué describe y qué no permite concluir
En el debate sobre fan-out se cita mucho una patente. La que he abierto es la US11663201B2, «Generating query variants using a trained generative model», de Google LLC: solicitada el 27 de abril de 2018 y concedida el 30 de mayo de 2023. Describe un modelo generativo que produce variantes de una consulta en tiempo de ejecución, incluso para consultas poco frecuentes, y que en algunas realizaciones puede generar varios tipos de variante. Las respuestas a las variantes pueden usarse para corroborar la respuesta a la consulta original, y las respuestas sin apoyo pueden omitirse o marcarse como no verificadas.
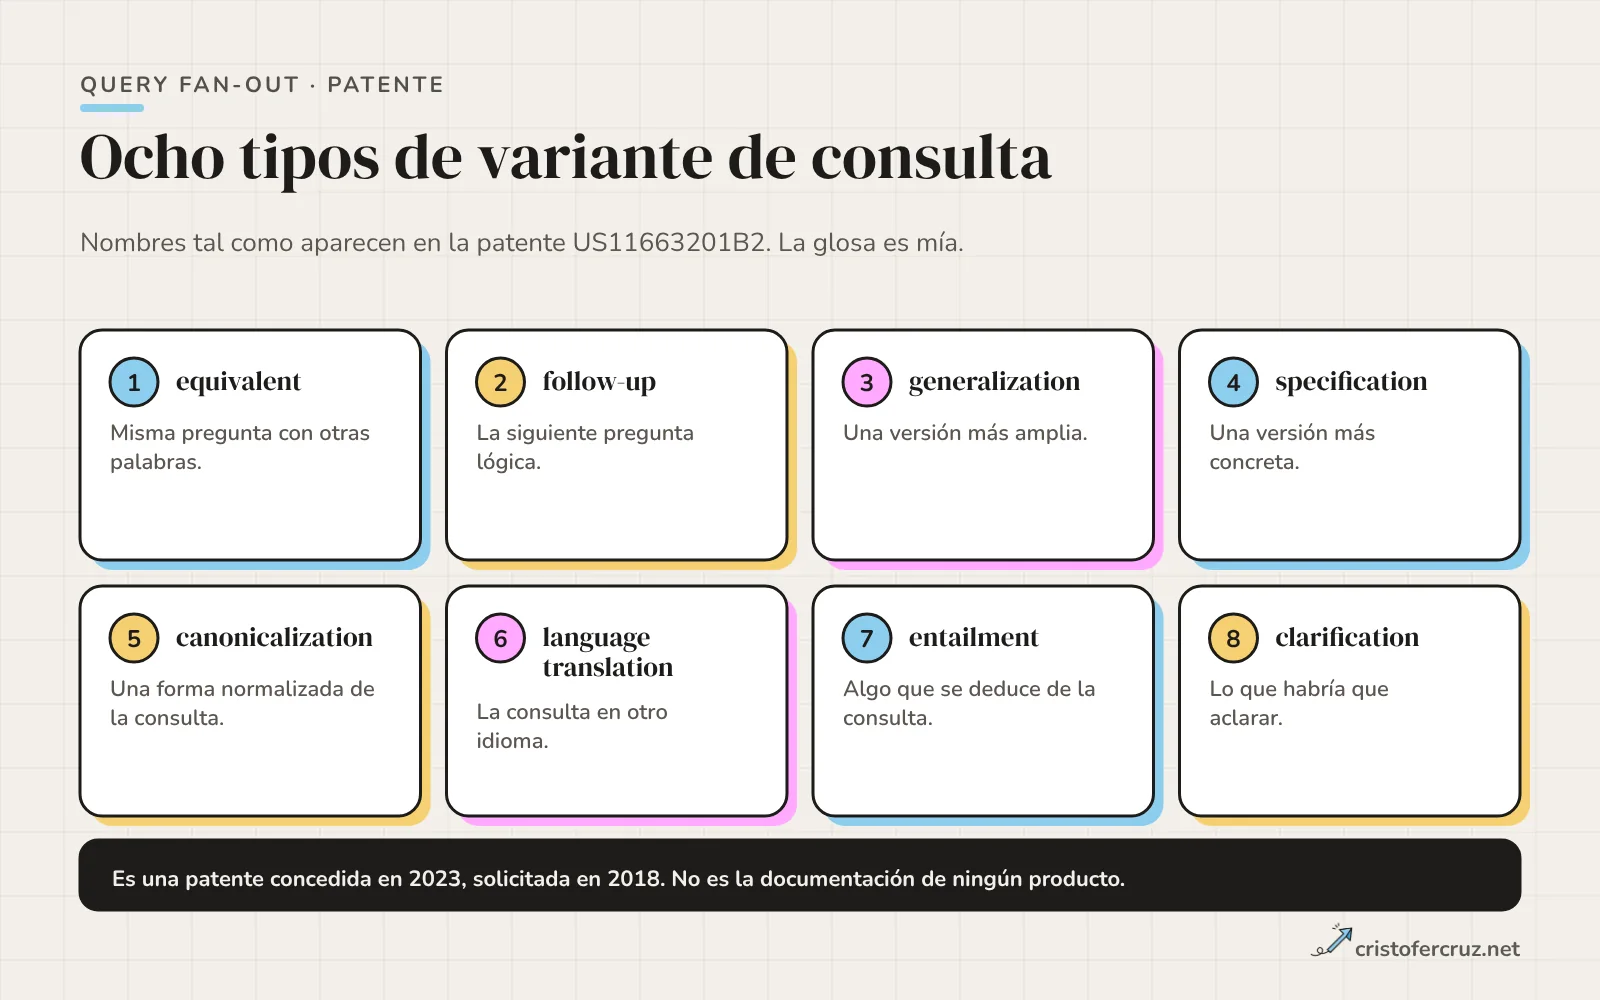
Lo que no permite concluir: la patente se solicitó años antes del anuncio de AI Mode, y no he encontrado ninguna declaración de Google que la relacione con él. Una patente describe una invención, no el producto. Me sirve como vocabulario: ocho maneras de preguntarse lo mismo, que uso como lista de comprobación al estimar subtemas, no como descripción del sistema real.
Qué cambia para el SEO y qué no
Lo que cambia es la unidad de planificación. Con una sola búsqueda, la pregunta era qué keyword y qué página. Con fan-out, la pregunta pasa a ser qué subtemas necesita alguien para resolver la tarea y cuáles tienes respondidos. Google dice además que estas funciones muestran un conjunto de enlaces más amplio y diverso que una búsqueda clásica, de modo que estar en el top de la keyword principal no es la única vía de entrada. No documenta con qué frecuencia ocurre.
Lo que no cambia es la base. Para aparecer como enlace de apoyo la página tiene que estar indexada y poder mostrarse con snippet, y Google insiste en que optimizar para estas funciones es SEO. Su guía de julio de 2026 enumera varias cosas que no hace falta hacer:
- crear llms.txt ni marcado especial;
- trocear el contenido en piezas diminutas («no hay ningún requisito de dividir tu contenido en trozos pequeños», en sus palabras, traducidas);
- reescribir el contenido para la IA, porque los sistemas entienden sinónimos y significados generales;
- preocuparte por no tener suficientes long tails;
- buscar menciones inauténticas.
Esto condiciona cómo se usa lo que sigue. Un mapa de fan-out no sirve para fabricar una página por subconsulta ni para repartir un texto en bloques de tres líneas. Sirve para detectar qué preguntas razonables de un lector no contesta tu contenido hoy. Si quieres el marco general de AEO y GEO y la hoja de ruta, está en mi guía de AEO y GEO.
Cómo estimar las subconsultas de una consulta
No hay forma documentada de ver las subconsultas que Google lanza para tu página. Lo que sí puedes es reunir señales de varias fuentes y quedarte con lo que coincide. Este es el método que sigo, de menos a más sesgado.
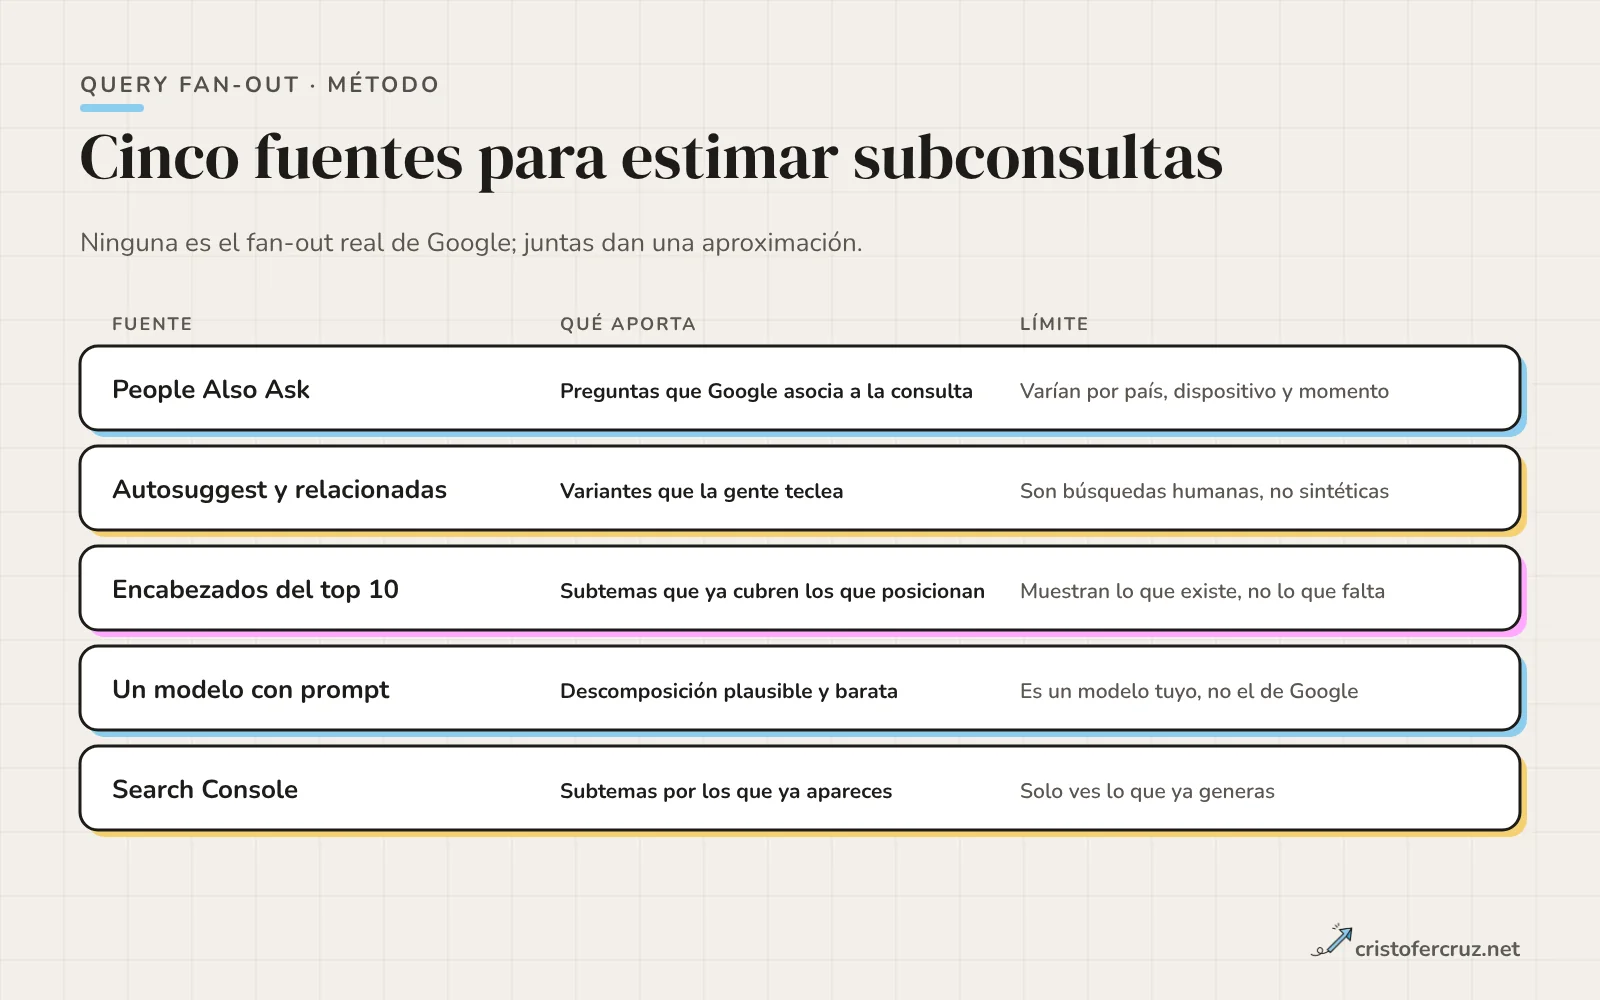
- Fija la consulta madre, el país y el idioma. People Also Ask y autosuggest cambian con ambos.
- Anota las preguntas de People Also Ask y las búsquedas relacionadas de la consulta, a mano y en el país que te interesa.
- Lee los encabezados de las páginas del top 10 y apunta los subtemas que se repiten. Te dicen lo que ya existe, no lo que falta.
- Saca de Search Console las consultas por las que ya recibe impresiones la página que quieres reforzar.
- Pide a un modelo de IA una descomposición. Abajo tienes el prompt.
- Repite el paso 5 varias veces y en más de un modelo. Lo que aparece una vez es ruido; lo que se repite y además sale en otra fuente es candidato a fila del mapa.
Este es el prompt que uso. Pide el tipo de variante con los nombres de la patente, que ayuda a no quedarse solo con reformulaciones.
Actúa como un sistema de búsqueda que descompone consultas.
Consulta: "enlazado interno SEO" (España, español, persona con una web propia).
Devuelve 15 subconsultas que lanzarías en paralelo para escribir una respuesta completa.
Para cada una indica: subconsulta | intención (informativa, comparativa, práctica,
transaccional) | tipo (equivalente, ampliación, concreción, siguiente pregunta,
otro idioma, implícita, aclaración).
No inventes volúmenes de búsqueda ni cites fuentes.
Un aviso sobre el resultado: es la descomposición de tu modelo, no la de Google. Dos modelos distintos darán listas distintas, y el estudio de Seer apunta a que las subconsultas exactas varían mucho de una ejecución a otra, así que conviene planificar por tema y no por cadena exacta. En proyectos grandes, este paso se cruza con un keyword research para medir la demanda de lo que sí tiene volumen.
Plantilla: el mapa de fan-out
El mapa convierte la lista en trabajo. Una fila por subconsulta y siete columnas.
| Columna | Qué se anota |
|---|---|
| Consulta madre | La consulta de partida, con país e idioma |
| Subconsulta | La pregunta concreta, en lenguaje de usuario |
| Intención | Informativa, comparativa, práctica o transaccional |
| Página objetivo | URL existente, sección nueva o página nueva |
| Formato | Definición, tabla, pasos, comparativa, respuesta corta de FAQ |
| Evidencia | De dónde sale: PAA, Search Console, top 10, modelo. Más de una fuente sube la prioridad |
| Estado | Cubierto, parcial o hueco |
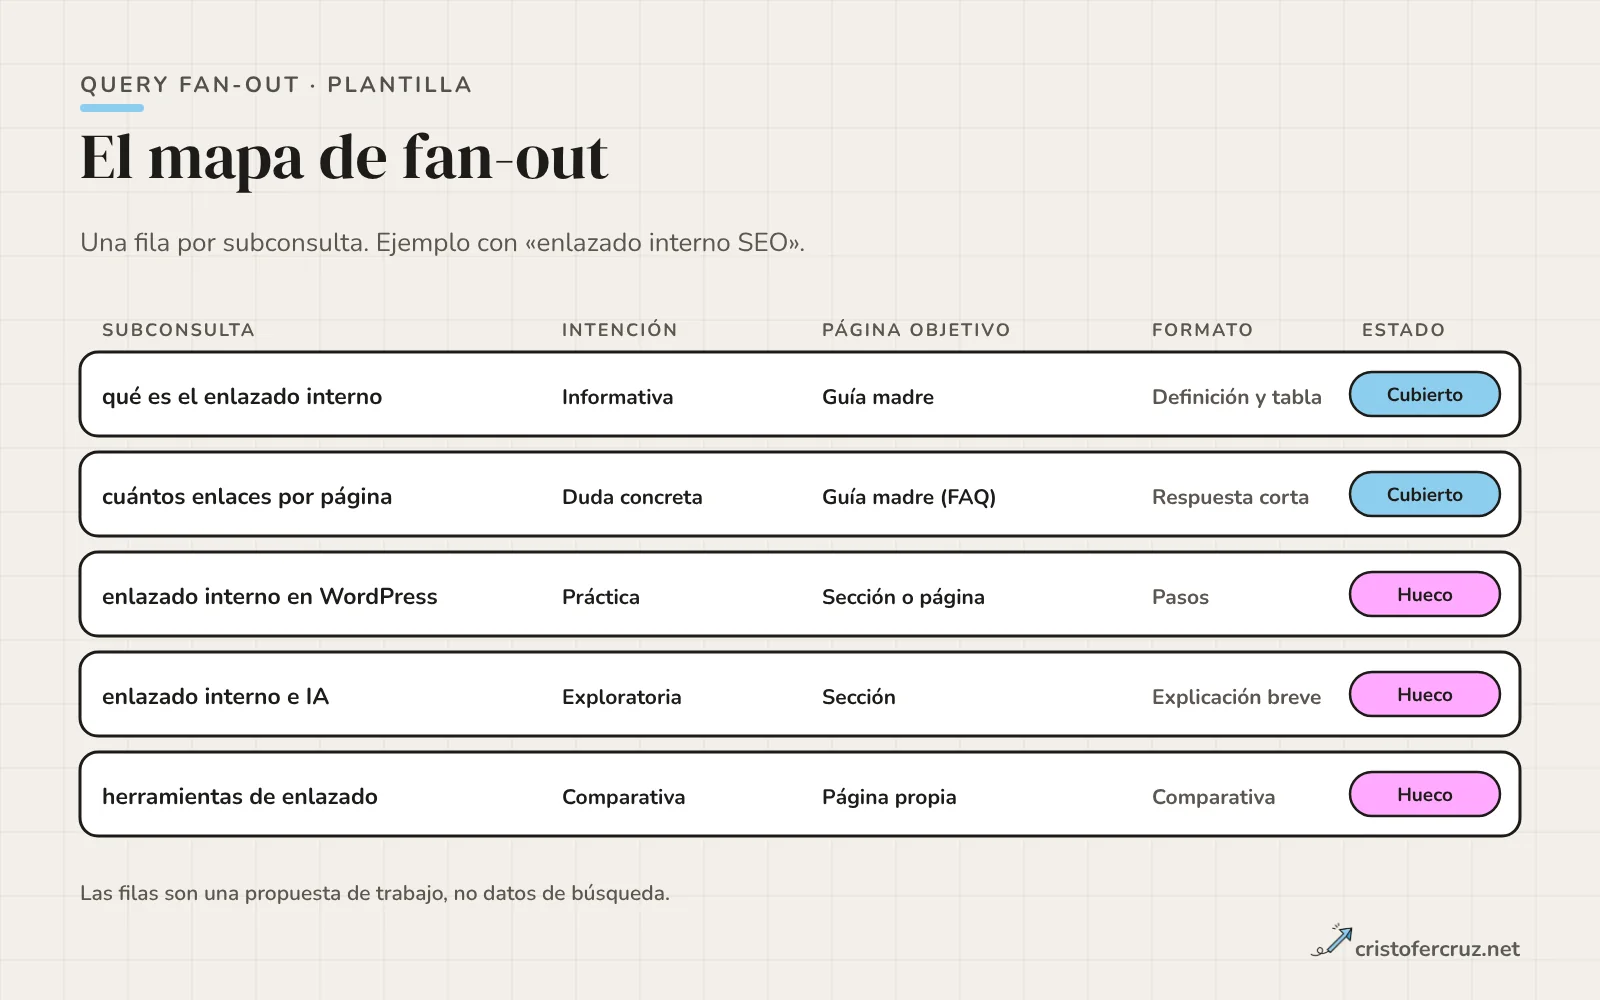
La decisión que más cuesta es la de la columna «Página objetivo». Mi regla: una página propia solo cuando la intención es distinta y la subconsulta se puede responder entera sin depender de otra página. Si es un matiz de lo que ya explicas, es una sección o una pregunta de FAQ. El mapa encaja en la fase de palabras clave, intención y arquitectura de mi metodología de proyectos SEO, antes de redactar nada.
Páginas por subtema, entidades y enlazado
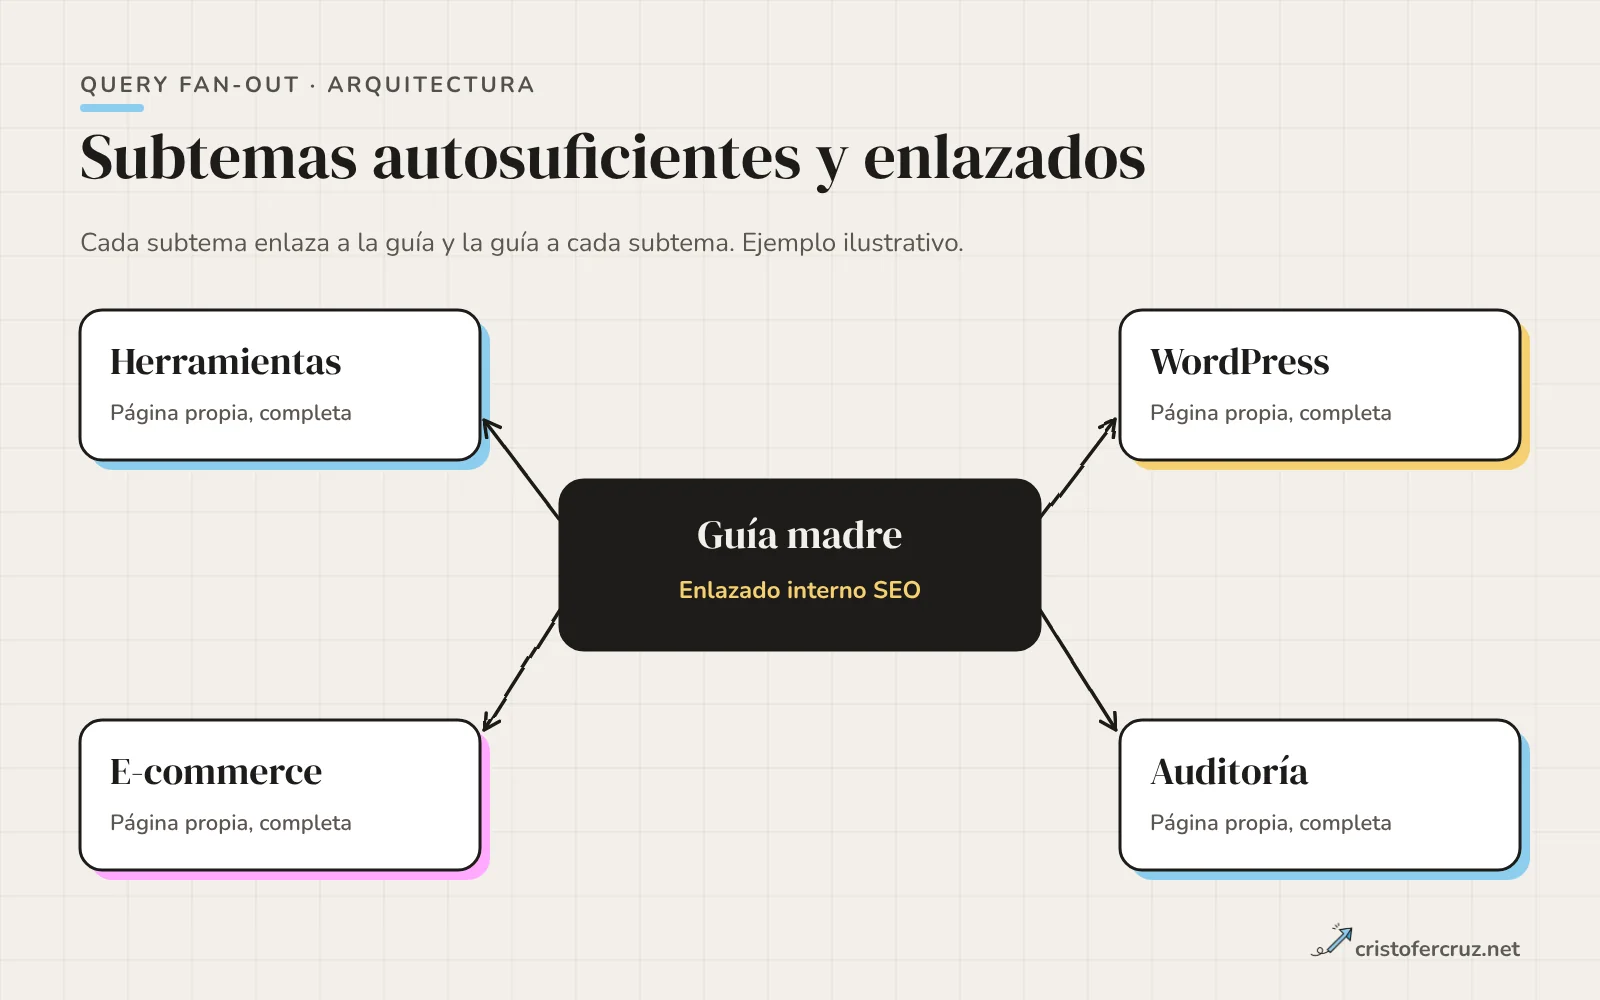
Cuando un subtema merece página, esta debe poder leerse sola: la respuesta directa arriba, los términos definidos donde aparecen y los datos con su fuente. No hace falta ningún formato especial; Google dice que entiende varios temas dentro de una misma página, y la estructura clara con encabezados sigue siendo lo que ayuda al lector.
Tres detalles que marcan la diferencia en subtemas comparativos o de producto. Nombra las cosas con precisión: producto, versión, país, fecha. Eso es trabajo de entidades y atributos: si la subconsulta es «X frente a Y», la tabla con los mismos criterios para ambos responde mejor que dos párrafos. Si usas datos estructurados, que reflejen lo visible; Google no pide marcado especial para estas funciones. Y la experiencia de primera mano (capturas propias, datos medidos, límites reconocidos) es lo que una página de subtema puede aportar y una síntesis no, como explico al hablar de las señales E-E-A-T.
Lo que une el conjunto es el enlazado: cada subtema enlaza a la guía madre y la guía a cada subtema, con anclas que describan el destino. Los detalles de anclas, huérfanas y profundidad están en mi guía de enlazado interno.
Cómo lo aplico a mi web: el caso del enlazado interno
Para probar el método cogí uno de mis artículos, el de enlazado interno SEO, y lo pasé por el mapa. Dos advertencias: la lista de subconsultas la hice yo a mano, con el método de arriba, y no son datos de búsqueda ni el fan-out real de Google. Además, escribí ese artículo, así que mi descomposición tiende a parecerse a su estructura; por eso salen pocos huecos.
Para el estado, comprobé el texto de content.html del artículo: sus 13 encabezados h2 y la búsqueda de términos clave dentro del texto.
| Subconsulta | Estado | Dónde |
|---|---|---|
| Para qué sirve un enlace interno | Cubierto | Sección «Para qué sirve un enlace interno» |
| Qué enlaces puede seguir Google, incluidos los de JavaScript | Cubierto | Sección «Qué enlaces puede seguir Google» |
| Profundidad de clics y regla de los tres clics | Cubierto | Arquitectura y FAQ |
| Páginas huérfanas y cómo encontrarlas | Cubierto | Sección propia y FAQ |
| Texto ancla | Cubierto | Sección propia y FAQ |
| Cuántos enlaces por página y nofollow interno | Cubierto | Sección propia y FAQ |
| Paginación y facetas | Cubierto | Sección propia |
| Cómo auditar el enlazado | Cubierto | Sección propia, con un script de rastreo |
| Herramientas y plugins (WordPress, rastreadores) | Hueco | Cero menciones a WordPress o plugins; «herramientas» aparece dos veces, de pasada |
| Enlazado interno en e-commerce | Hueco | Solo las facetas; el texto no habla de tiendas ni de e-commerce |
| Enlazado interno y búsqueda con IA | Hueco | Cero menciones a IA, LLM o AI Mode |
| Enlaces internos frente a externos | Hueco | Sin sección sobre enlaces externos; «salientes» aparece dos veces, de pasada |
El resultado: el núcleo está cubierto y los huecos están en los bordes (herramientas, e-commerce, IA, externos). Herramientas, e-commerce y enlaces externos son subtemas de intención distinta que, en caso de abordarlos, merecerían decisión propia; el de IA sería, como mucho, una sección corta y no un artículo.
No he cambiado nada del artículo a raíz de este ejercicio y no tengo datos de Search Console que digan si esos huecos me cuestan algo. Es un diagnóstico, y dice qué mirar primero. Un dato más de mi sitio, relacionado con lo que Google dice que no hace falta: en la raíz de mi web no hay un archivo llms.txt.
Cómo medir si el trabajo sirve
Hay tres fuentes de datos, y ninguna enseña las subconsultas.
- El informe de Rendimiento de Search Console. Según la documentación de Google, el tráfico de las funciones de IA se cuenta dentro del total y aparece en el tipo de búsqueda «Web»; no hay filtro para aislarlo.
- El informe de IA generativa, presentado por Google en junio de 2026. Da impresiones de AI Overviews, AI Mode y Discover por página, país, dispositivo (en el de Search) y fecha. Según Search Engine Journal y la ayuda de Google, desde el 31 de agosto de 2026 está desplegado para todos los sitios, aunque una propiedad con muy pocas impresiones de IA puede no verlo. No da clics ni consultas.
- Tus propias consultas, agrupadas por subtema. Es lo que más uso: un filtro de consultas con una expresión regular por subtema, aplicado a la página que has reforzado.
(herramient|plugin|wordpress|screaming)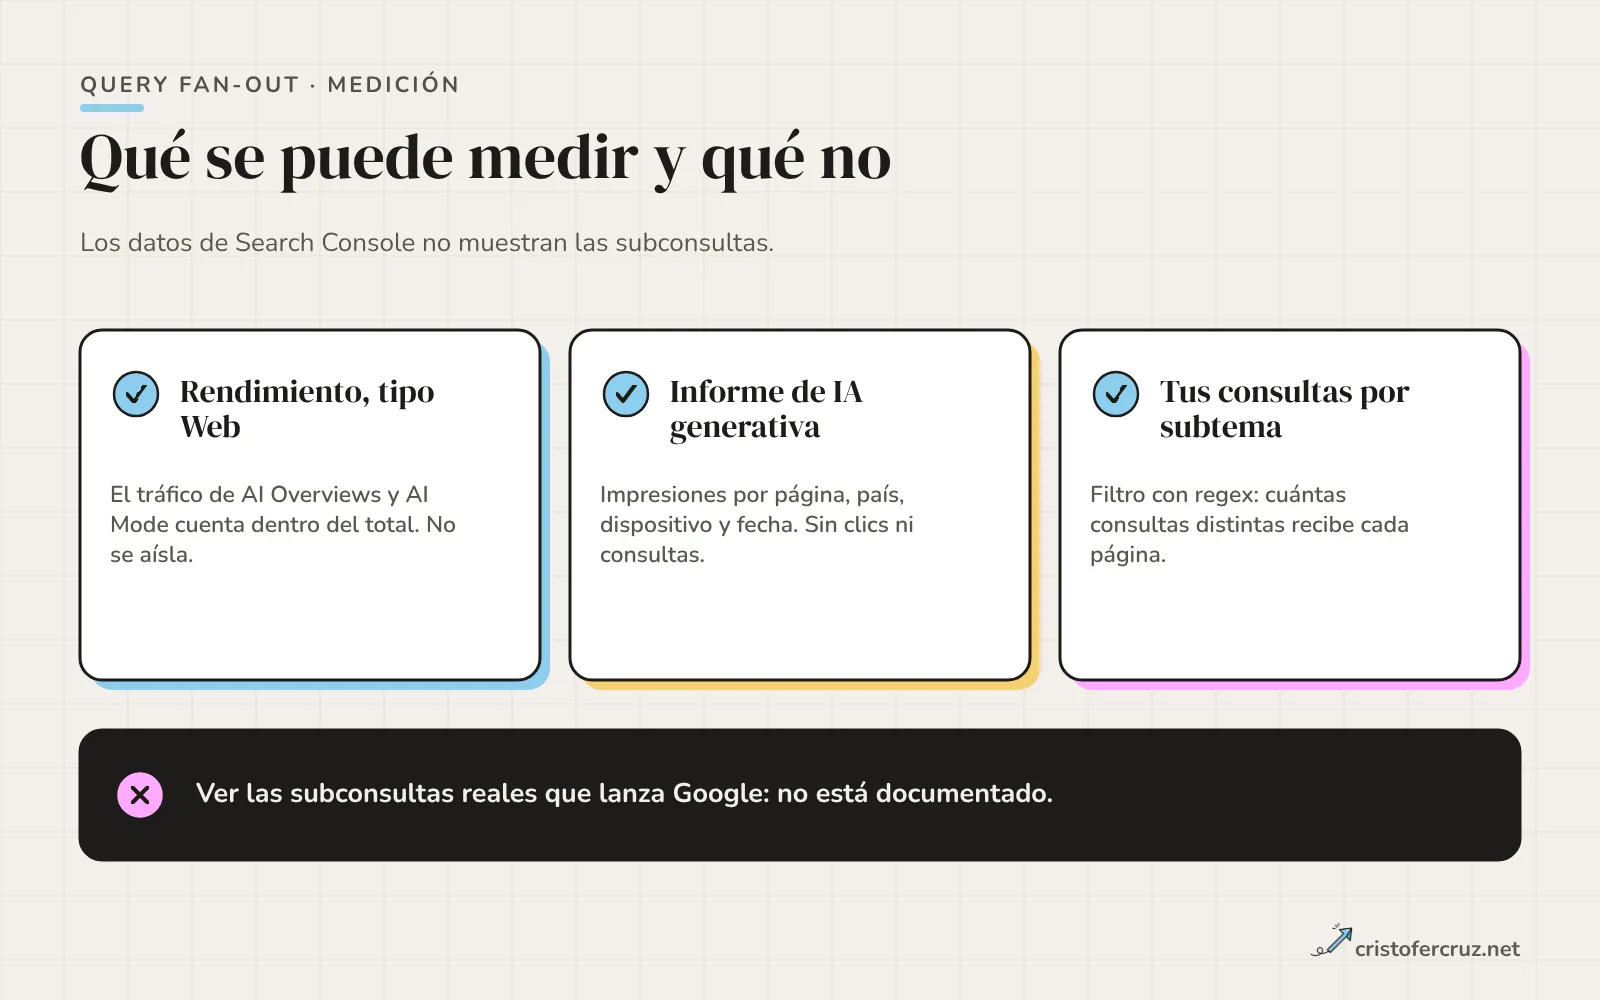
La medición que propongo: antes de cambiar, apunta para la página las impresiones y el número de consultas distintas de los últimos 28 días. Tras publicar los cambios, compara con 28 días posteriores y anota qué más cambió en ese periodo. Con una sola página, un antes y un después no prueban causa, solo orientan. El informe de IA generativa añade si empiezas a aparecer en esas funciones, y lo que pase con los clics lo tendrás que seguir en el informe de Rendimiento y en tu analítica; qué impacto tiene todo esto en el tráfico es otro tema, que trato en las búsquedas zero-click.
La propia guía de Google avisa de que hay que desconfiar de las herramientas de terceros que dicen acceder a métricas internas de Google. Las subconsultas «reales» que muestran algunas herramientas son, como mucho, estimaciones de sus modelos.
Errores habituales
Los que veo con más frecuencia al trabajar con fan-out:
- Tratar la lista de un modelo como si fuera el fan-out de Google. Es una hipótesis de trabajo.
- Crear una página por subconsulta. Google dice que producir páginas en masa para manipular el ranking incumple su política de abuso de contenido a escala; además, una página fina para cada matiz compite con tu guía madre.
- Trocear las páginas en secciones mínimas pensando en «pasajes», cuando la propia guía de Google dice que no hace falta.
- Rellenar de long tails que nadie ha buscado. Según el estudio de Seer, casi todas las subconsultas carecen de volumen, y precisamente por eso no sirven de guía de redacción.
- Olvidar lo básico: una página no indexada, bloqueada o sin snippet no puede salir como enlace de apoyo.
Qué hacer esta semana
- Elige una página que te importe y su consulta madre.
- Reúne las señales de los pasos 2 a 4 del método y pide tres descomposiciones a un modelo.
- Rellena el mapa con las filas que aparecen en más de una fuente.
- Marca cada fila como cubierta, parcial o hueco leyendo tu texto, no tu memoria.
- Decide por hueco: sección, FAQ o página propia, y enlaza el resultado con la guía madre.
- Anota las impresiones y las consultas distintas de la página para comparar dentro de 28 días.
Si el sitio es grande y varios equipos publican, el mapa pasa a ser un entregable que se mantiene; es el tipo de trabajo que planteo en una consultoría SEO.
Preguntas frecuentes
¿Confirma Google que existe el query fan-out?
Sí. Lo presentó con AI Mode el 5 de marzo de 2025 y su documentación para sitios dice que AI Overviews y AI Mode pueden usarlo. Lo que no detalla es cuántas subconsultas lanza ni cómo elige las páginas que enlaza.
¿Cuántas subconsultas lanza Google por consulta?
No está documentado. Google solo dice que Deep Search puede lanzar cientos de búsquedas. El dato de Seer (10,7 de media, entre 3 y 28) viene de la API de Gemini 3 con búsqueda forzada, así que no es extrapolable a Google Search.
¿Puedo ver las subconsultas que Google usa para mi página?
No he encontrado ninguna forma documentada. Search Console no las muestra, y el informe de IA generativa da impresiones por página, país, dispositivo y fecha, sin consultas ni clics.
¿Hay que crear una página por subconsulta?
No. Solo cuando la intención es distinta y la página puede responderse sola. En el resto de casos es una sección o una pregunta de FAQ. Google advierte contra producir páginas en masa para manipular el ranking.
¿El query fan-out sustituye al keyword research?
No. Las subconsultas son generadas por el modelo y la mayoría no tiene volumen, así que el keyword research sigue midiendo la demanda real. Sirve para decidir qué subtemas incluir en la página, no para estimar tráfico.
¿Funciona igual en ChatGPT o Perplexity?
Solo he verificado con documentación oficial el caso de Google. Otros sistemas pueden descomponer consultas de formas distintas y no he contrastado cómo lo hace cada uno.
¿Necesito llms.txt o marcado especial para el fan-out?
Para Google Search, no: su guía de julio de 2026 dice que no usa llms.txt ni requiere marcado especial para las funciones de IA. Los datos estructurados siguen sirviendo para los resultados enriquecidos.
Referencias y fuentes
Documentación y estudios consultados para esta guía.
- Optimizing your website for generative AI features on Google Search Google Search Central
- AI features and your website Google Search Central
- Expanding AI Overviews and introducing AI Mode Google, 5 mar. 2025
- AI in Search: Going beyond information to intelligence Google, 20 may. 2025
- US11663201B2: Generating query variants using a trained generative model Google Patents
- Initial Research: Gemini 3 Query Fan-Outs Seer Interactive, 21 nov. 2025
- Generative AI performance report (Discover) Search Console Help
- Google Search Console AI Reports Rolled Out Worldwide Search Engine Journal, 31 ago. 2026