- Google descubre páginas sobre todo siguiendo enlaces desde páginas que ya conoce, y solo sigue enlaces que sean un elemento
<a>con unhrefque lleve a una URL. - Toda página que te importe necesita al menos un enlace desde otra página de tu sitio. Un sitemap no sustituye a ese enlace.
- Google no da un número ideal de enlaces por página ni un máximo de clics desde la home. Esos límites hay que medirlos en tu sitio, no heredarlos de una regla.
- El texto ancla debe describir el destino. Un enlace con imagen usa el
altcomo ancla. - Con un rastreo propio de mi blog (47 artículos) mido profundidad, enlaces salientes y entrantes: la mediana de entrantes desde otros artículos es 5 y el mínimo, 2; una primera medición, antes de enlazar los textos nuevos desde los antiguos, dio tres con cero.
- Se audita con un rastreo, Search Console y los logs, y se planifica con una matriz de origen y destino.
Lo habitual en el enlazado interno no es hacerlo mal, es no haberlo decidido: cada artículo enlaza a lo que el autor recordaba el día que lo escribió y los textos nuevos no los enlaza nadie. El resultado son páginas que existen, están en el sitemap y reciben uno o dos enlaces, casi siempre desde un listado.
Los artículos en español que revisé explican bien el qué (descubrimiento, anclas, silos), pero dejan fuera cómo medir si funciona y los enlaces con JavaScript. Aquí cubro eso y lo contrasto con mi propio sitio, que rastreé con un script propio, carencias incluidas.
Para qué sirve un enlace interno
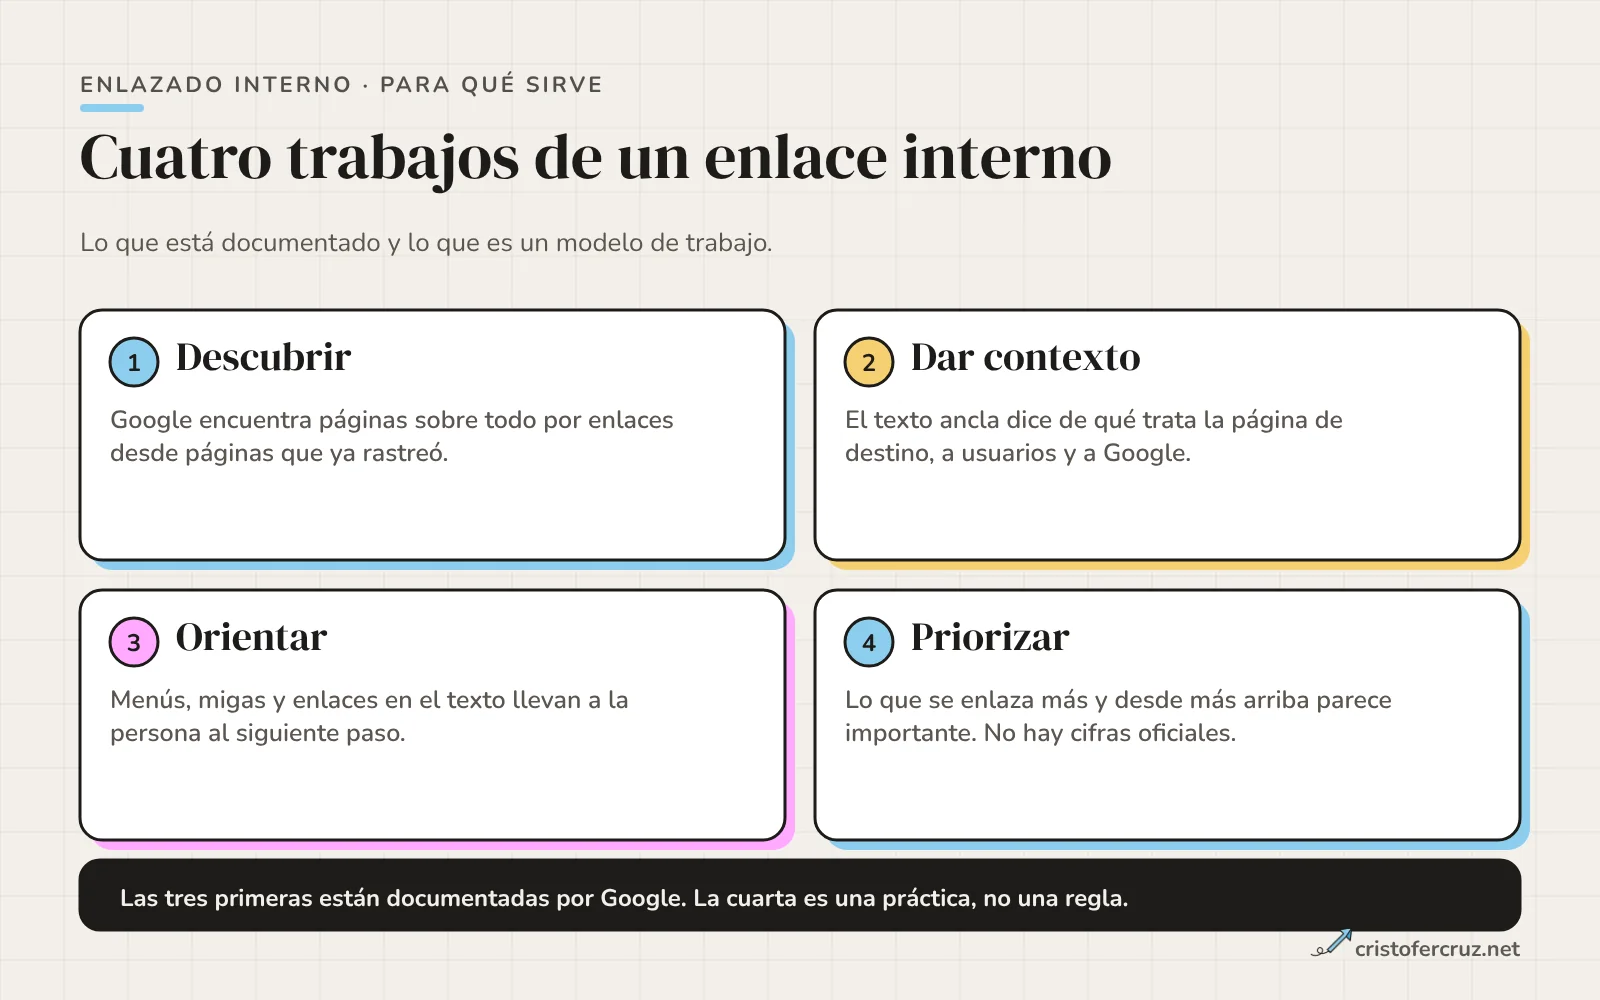
Un enlace interno hace cuatro trabajos, y conviene no mezclar cuáles están documentados y cuáles son criterio de oficio.
| Trabajo | Qué dice la documentación | Qué es práctica propia |
|---|---|---|
| Descubrir | Google encuentra las páginas sobre todo por enlaces desde páginas que ya rastreó | Medir cuántos clics hay desde la home |
| Dar contexto | El texto del enlace dice a usuarios y a Google de qué trata el destino | Variar el ancla según el contexto de la frase |
| Orientar | Los enlaces conectan a los usuarios con otras partes del sitio | Menús, migas y enlaces de «siguiente paso» |
| Priorizar | Sin cifras públicas sobre cuánto transmite un enlace interno | Enlazar más y desde páginas fuertes lo que quieres posicionar |
La cuarta fila es la que más se vende y menos se demuestra: el «reparto de autoridad» suele apoyarse en un modelo de PageRank con fórmulas y escalas que Google no publica. Yo lo uso como hipótesis, no como medida.
Qué enlaces puede seguir Google
La documentación de Google es literal: solo puede seguir un enlace si es un elemento <a> con atributo href. Un <a> sin href, un span con un onclick o un botón que cambia de vista con JavaScript no cumplen. Insertar enlaces con JavaScript sí vale si el resultado es un <a href> normal. El detalle de los casos (History API, fragmentos con #, router de la app) lo tienes en mi guía de SEO con JavaScript.
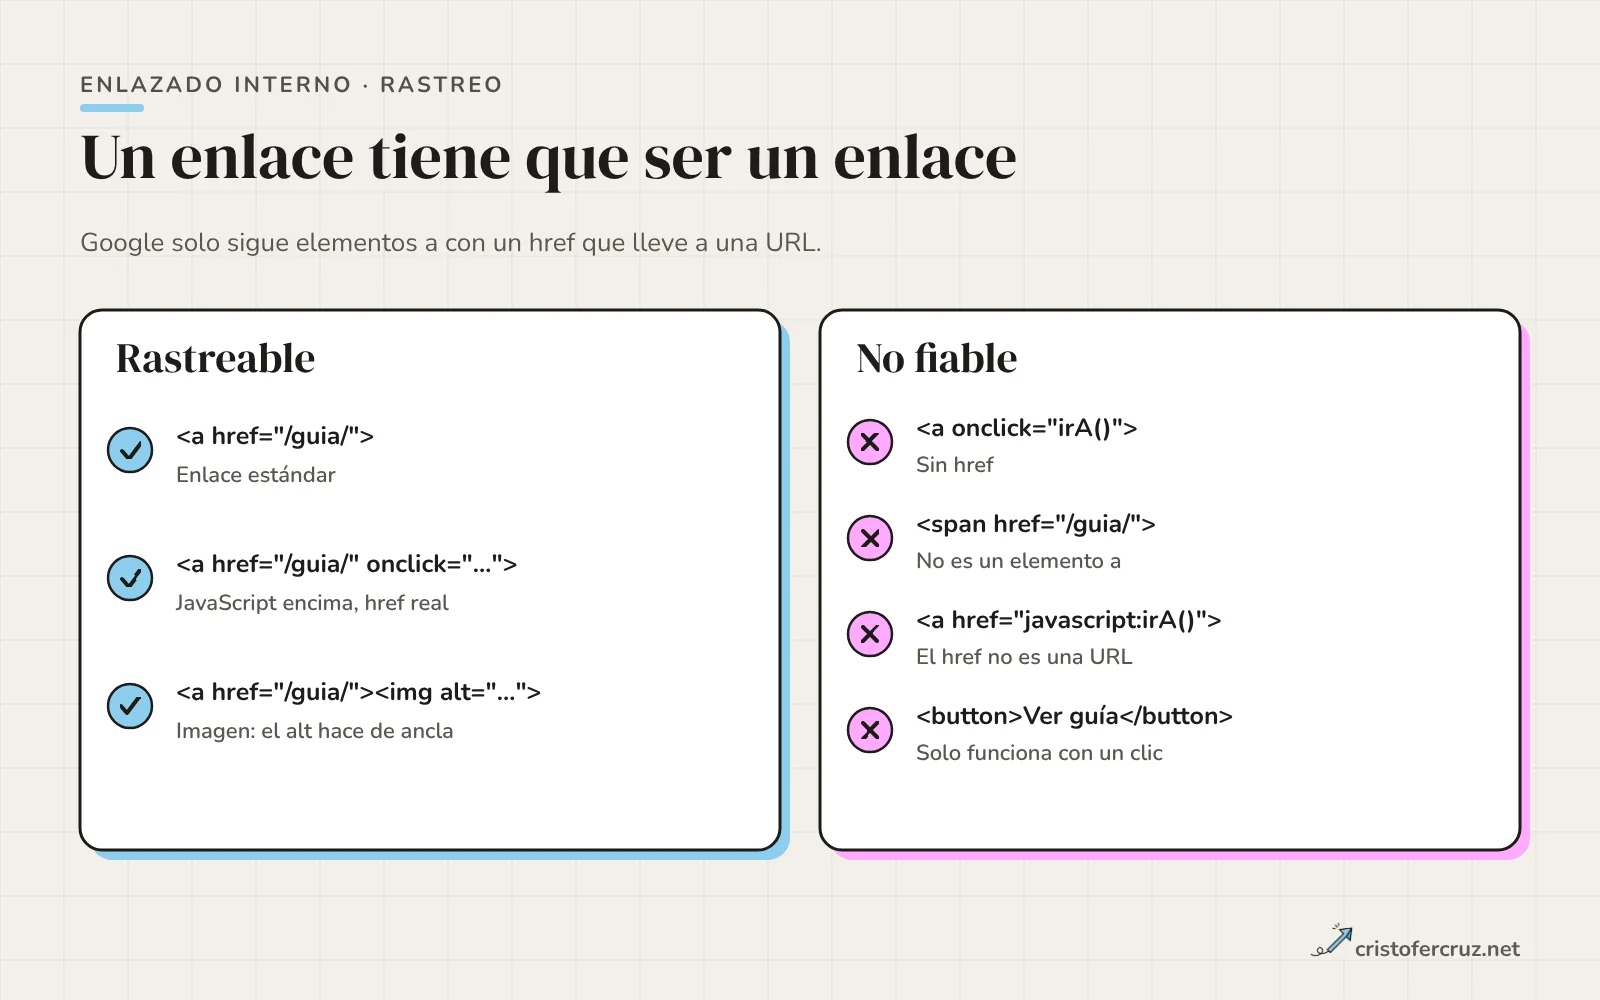
href con una URL. Lo demás depende de que Google interprete tu JavaScript.Tres matices. El href puede ser relativo o absoluto, y el formato afecta a migraciones y entornos de prueba, como explico en URLs absolutas y relativas en SEO. Cada variante de URL (parámetros, barra final, mayúsculas) es una URL distinta, así que enlazar unas veces con barra y otras sin ella reparte los enlaces entre dos direcciones. Y un enlace con imagen usa su alt como ancla: sin alt, el enlace no tiene texto.
Arquitectura: profundidad, clústeres y enlaces de plantilla
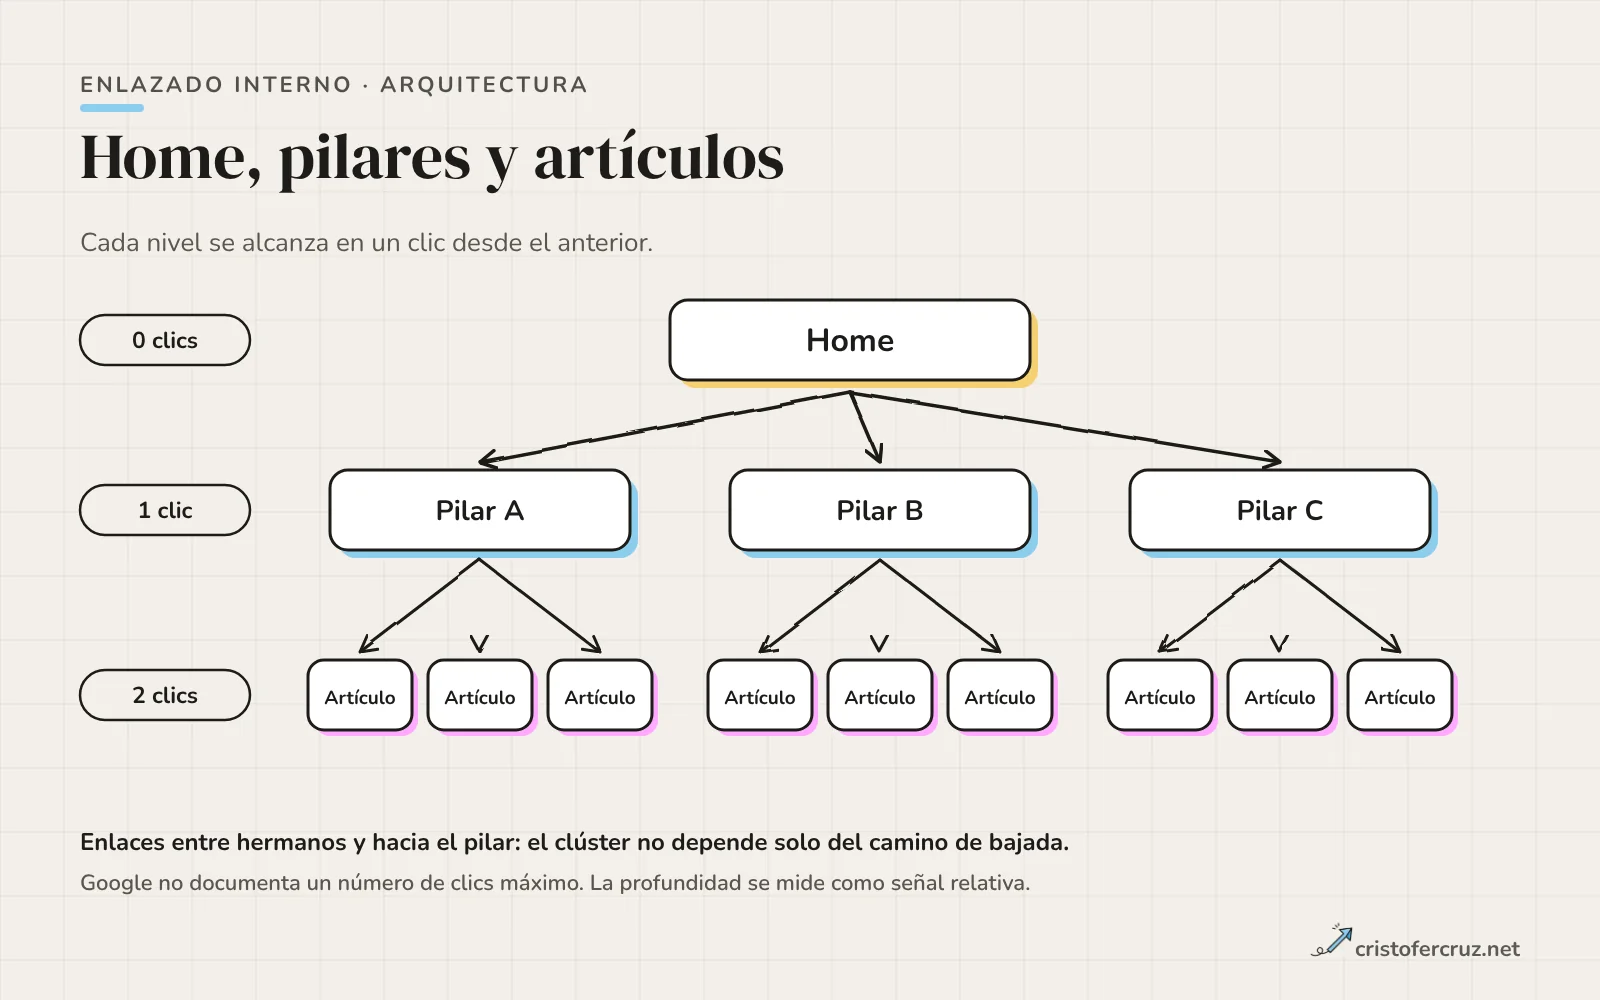
La profundidad de clics es el número mínimo de enlaces que hay que seguir desde la home hasta una página. Mucha literatura da por hecho que más de tres clics es un problema. Google no documenta ese umbral, y en su guía de inicio solo dice que organizar las páginas de forma lógica ayuda a usuarios y buscadores a entender cómo se relacionan, y que agrupar las parecidas en directorios le sirve para saber cada cuánto cambia una sección, algo que importa sobre todo por encima de unos miles de URLs. Yo mido la profundidad como señal relativa: si una página que quiero posicionar está tres niveles por debajo de otras de menor prioridad, la estructura no refleja mis prioridades.
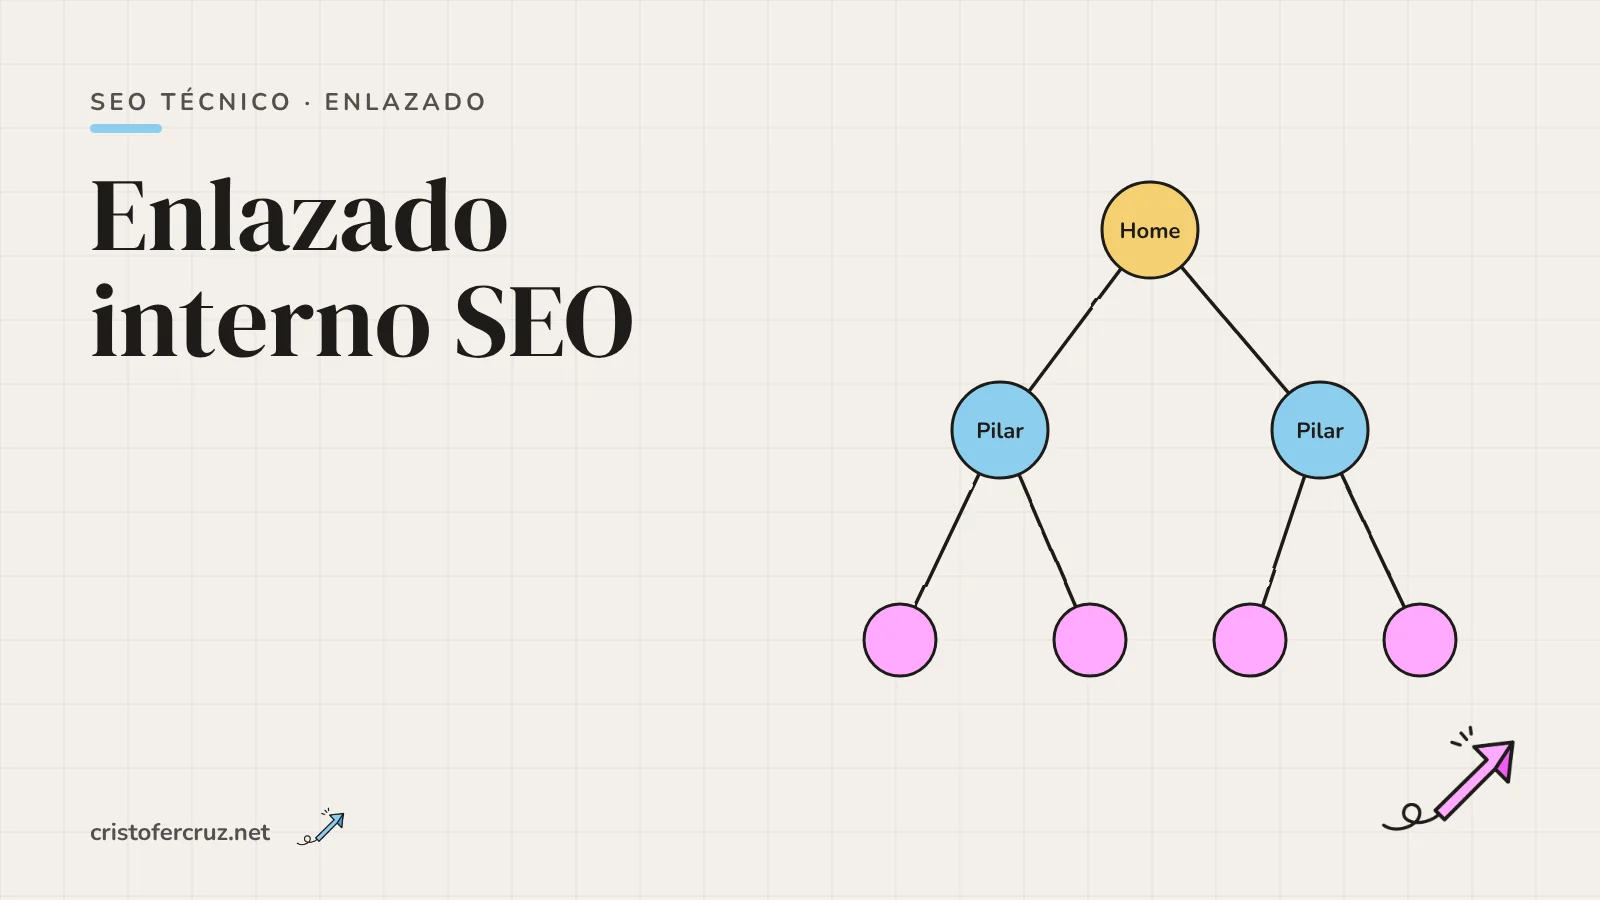
Una estructura sana suele ser una pirámide con clústeres: la home enlaza a pilares, cada pilar a sus artículos, y los artículos se enlazan entre sí y de vuelta al pilar. Si montas o reordenas un sitio grande, es el trabajo de arquitectura web.
Conviene separar los enlaces por quién los genera, porque se arreglan en sitios distintos.
| Tipo | Quién lo genera | Para qué sirve | Riesgo habitual |
|---|---|---|---|
| Menú principal | Plantilla | Llevar a las secciones clave desde cualquier página | Menús enormes que diluyen lo importante |
| Footer | Plantilla | Acceso a legales, contacto y secciones secundarias | Meter enlaces comerciales con anclas repetidas |
| Migas de pan | Plantilla | Orientar y enlazar hacia arriba en la jerarquía | Que no coincidan con la estructura real de URLs |
| Contextuales | Editor | Dar contexto con un ancla dentro de una frase | Olvidarlos en contenidos nuevos |
| Bloques relacionados | Plantilla o editor | Proponer el siguiente contenido | Repetir lo que ya enlaza el cuerpo |
| Paginación y filtros | Plantilla | Dar acceso a listados largos | Cadenas de páginas muy profundas y URLs infinitas |
Los de plantilla se repiten en todas las páginas. Los contextuales son los únicos que eliges tú, frase a frase, y los que más trabajo merecen.
Páginas huérfanas
Una página huérfana es una URL que existe y no recibe ningún enlace interno. Google recomienda que toda página que te importe tenga un enlace desde al menos otra página del sitio. Aparecen tras migraciones, campañas sin menú o contenidos nuevos que nadie enlaza.
Un sitemap XML ayuda a que Google conozca la URL, pero no le da contexto ni la integra en la estructura. Una página huérfana que sí está en el sitemap indica que se publicó sin pasar por la arquitectura. Para encontrarlas, compara las URLs de tu sitemap, tu CMS o tus logs con las que alcanza un rastreo desde la home: lo que solo está en la primera lista es huérfano.
Texto ancla: descriptivo, variado y sin forzar
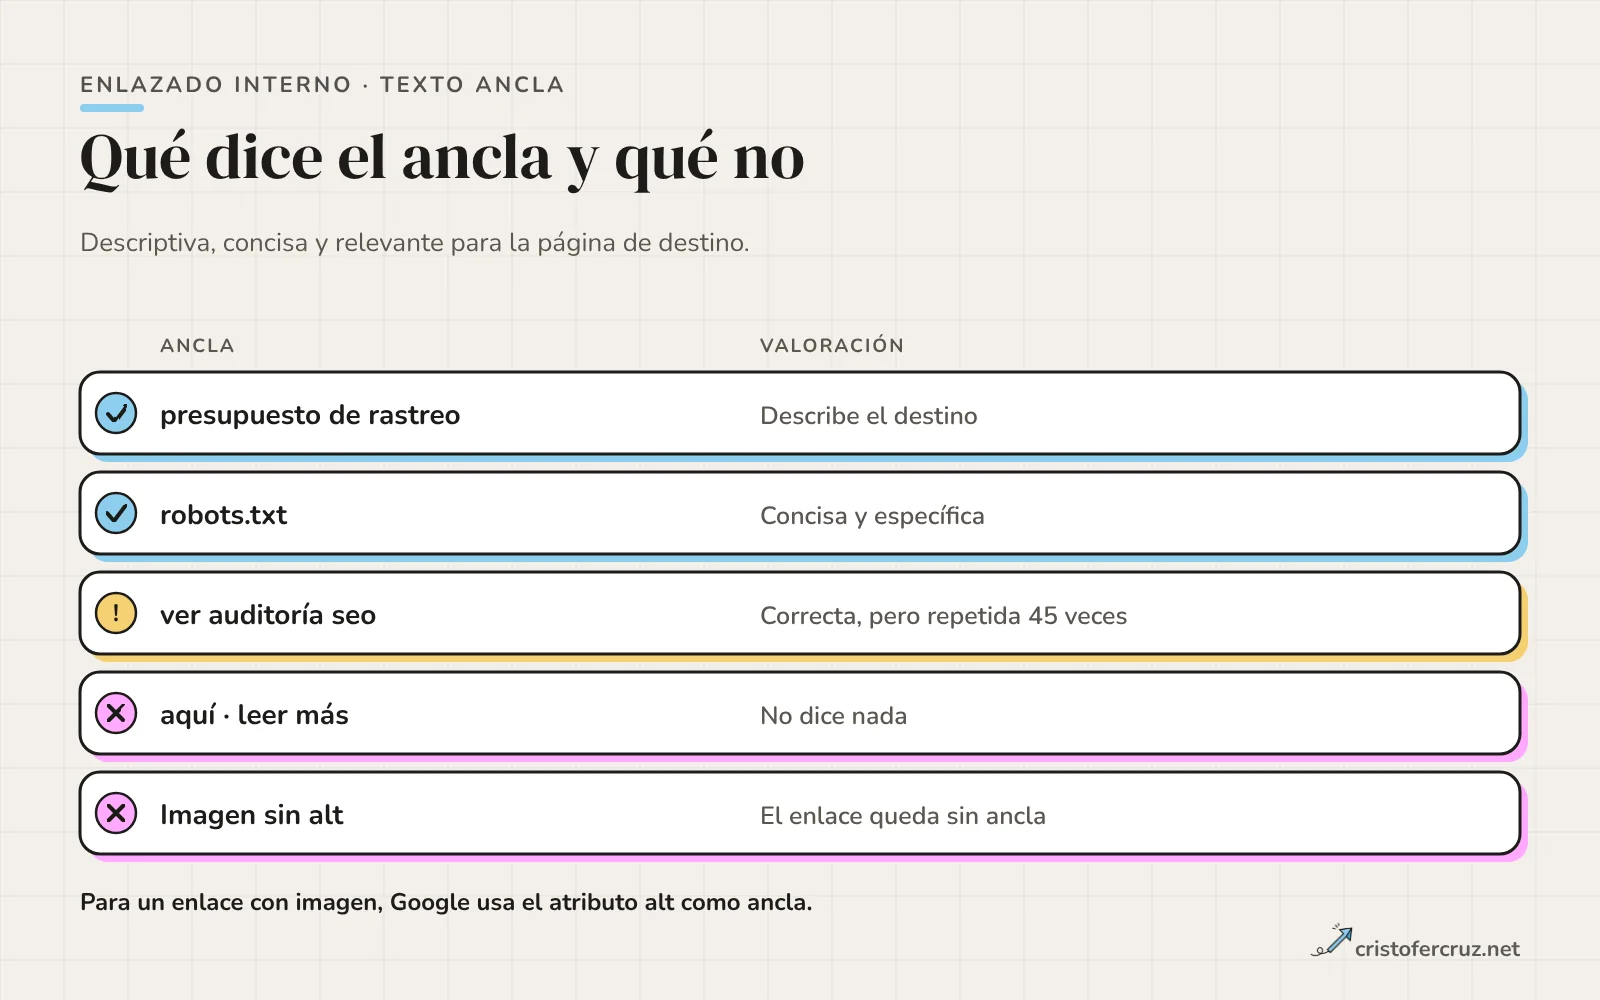
Según Google, un buen texto ancla es descriptivo, razonablemente conciso y relevante para la página donde está y para la que enlaza. También pide escribirlo con naturalidad y no meter todas las palabras clave. Los casos que reviso con más frecuencia son estos.
| Ancla | Valoración | Motivo |
|---|---|---|
| presupuesto de rastreo | Correcta | Describe el destino y cabe en la frase |
| aquí, leer más, este enlace | Evitar | No dice nada de la página de destino |
| mejor consultor SEO barato Salamanca (en todos los enlaces) | Evitar | Ancla forzada y repetida en cada enlace |
Enlace con imagen sin alt | Evitar | El enlace se queda sin ancla |
| Misma ancla exacta, decenas de veces, hacia la misma URL | Revisar | No está prohibido, pero indica una plantilla y no una decisión |
No conozco un umbral documentado de «sobreoptimización» en anclas internas, así que no te daré un porcentaje. Mi criterio: varía el ancla según la frase, mantenla corta (en mi blog la mediana es de 3 palabras) y que sea la que usaría un lector para describir el destino. Con imágenes, comprueba el alt siguiendo mi guía de texto alternativo. Y si conviertes en enlace una tarjeta o una caja entera, el ancla es todo su contenido: cómo resolverlo bien lo trato en enlazar una card entera.
Cuántos enlaces por página y cuándo no usar nofollow
Google lo dice sin rodeos: no existe un número ideal de enlaces por página, y si crees que son demasiados, probablemente lo sean. Lo útil es medir cuántos enlaces tiene cada tipo de página y comparar. En una página de artículo de mi blog hay unos 147 enlaces en el HTML y solo 11 son enlaces editoriales a otras páginas; el resto son menú, footer e índice del artículo.
Sobre nofollow: Google lo describe, junto con sponsored y ugc, para calificar enlaces que no quieres asociar a tu sitio, como anuncios o comentarios. Esos enlaces generalmente no se siguen, aunque la página enlazada puede rastrearse si Google la encuentra por otro camino. Entre tus propias páginas editoriales no tiene sentido: pides que no se siga lo que quieres que se descubra. Donde sí aparece en la documentación es en la navegación por facetas, con una condición que se incumple a menudo: solo funciona si cada enlace hacia esa URL lleva el atributo.
En mi web no hay ningún rel="nofollow" en enlaces internos: ninguno de los 12.408 enlaces internos que recogió mi rastreo lo lleva. Si el rastreo se te va a URLs que no te interesan, el recorte se hace con otras herramientas, que explico en la guía de presupuesto de rastreo.
Paginación y facetas
La documentación de Google para listados paginados pide tres cosas. Enlazar de cada página a la siguiente con etiquetas <a href>, porque sus rastreadores no pulsan botones ni ejecutan JavaScript que necesite una acción del usuario, algo que afecta a «cargar más» y al scroll infinito. Dar a cada página de la secuencia su propia URL y su propio canonical, sin apuntar todas a la primera. Y no esperar nada de rel="prev" y rel="next": Google ya no los usa, aunque otros buscadores aún puedan hacerlo. Los matices de canonical y listados los tienes en mi guía de canonical.
Para facetas y filtros, Google propone en primer lugar bloquear con robots.txt las URLs filtradas que no necesitan aparecer en búsquedas, dejando rastreables el listado sin filtrar y las fichas. El canonical hacia la versión sin filtrar puede reducir el rastreo de las variantes, pero la documentación lo considera menos eficaz a largo plazo. Y los filtros que se pongan detrás de un # no afectan al rastreo porque Google no suele soportar los fragmentos; cómo se construye cada parte de una URL está en sintaxis de URLs.
Un listado que solo enlaza a «siguiente» obliga a recorrer la cadena entera: la página 8 está a ocho clics de la home aunque sus artículos estén más cerca por otros caminos. Lo mido con mi propio listado más abajo.
Cómo lo planifico: una matriz de origen y destino
Antes de añadir enlaces me hago una matriz con una fila por página de origen y una columna por página de destino, rellena con lo que existe de verdad, no con lo que creo recordar. Esta es la de un clúster real de mi blog: seis artículos sobre redirecciones y códigos de respuesta, con los enlaces del cuerpo medidos con mi rastreo.
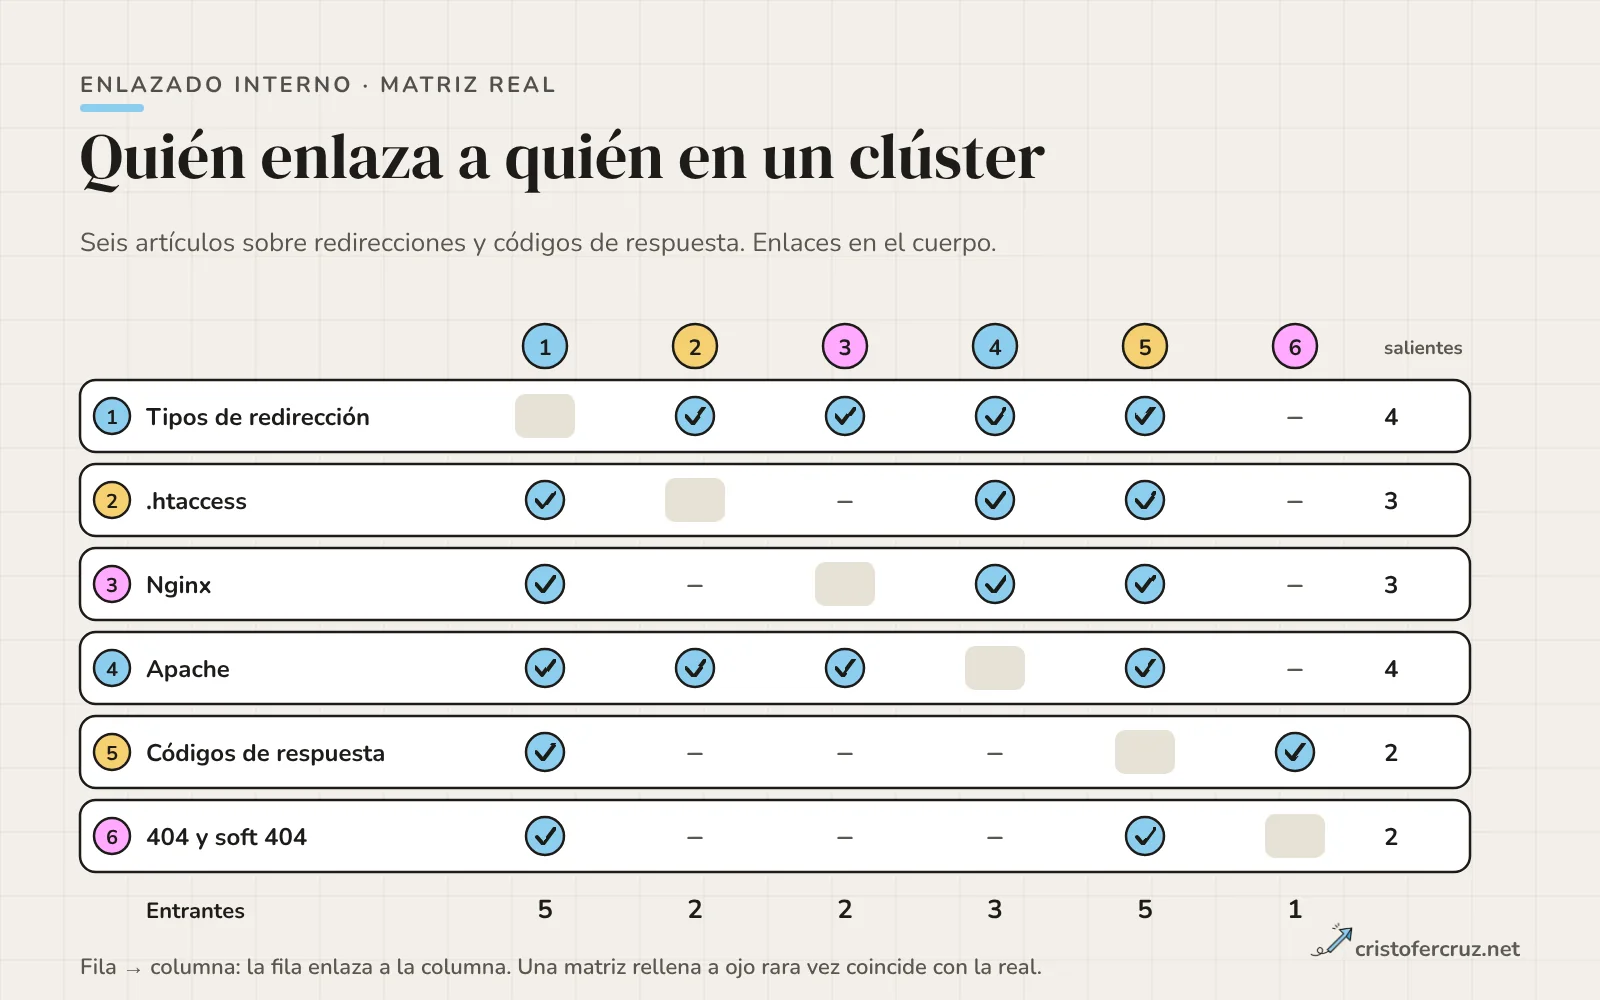
El artículo de tipos de redirección recibe los cinco enlaces posibles y el de 404 y soft 404 solo uno. Nginx y .htaccess, que resuelven lo mismo en servidores distintos, no se enlazan entre sí, y ninguno de los tres artículos de servidor enlaza al de 404 y soft 404. Cada hueco es una tarea concreta: un enlace en una frase donde ya se habla del tema del destino.
La segunda parte de la matriz es la de planificación. Para cada destino que quiero reforzar anoto la intención, un ancla candidata, desde qué páginas puede enlazarse con naturalidad y el estado. Este es el ejemplo con este mismo artículo; las filas son una propuesta mía y están pendientes de aplicar, no hechas.
| Destino | Intención | Ancla candidata | Orígenes posibles | Estado |
|---|---|---|---|---|
| /blog/enlazado-interno-seo/ | Guía de referencia sobre enlazado | enlazado interno | Presupuesto de rastreo, sitemaps XML, URLs absolutas y relativas | Propuesta, pendiente |
En un sitio grande, con varios equipos publicando, esta matriz es un entregable que preparo con el cliente en una consultoría SEO: lo difícil no es hacerla una vez, sino mantenerla.
Cómo lo trabajo en mi blog
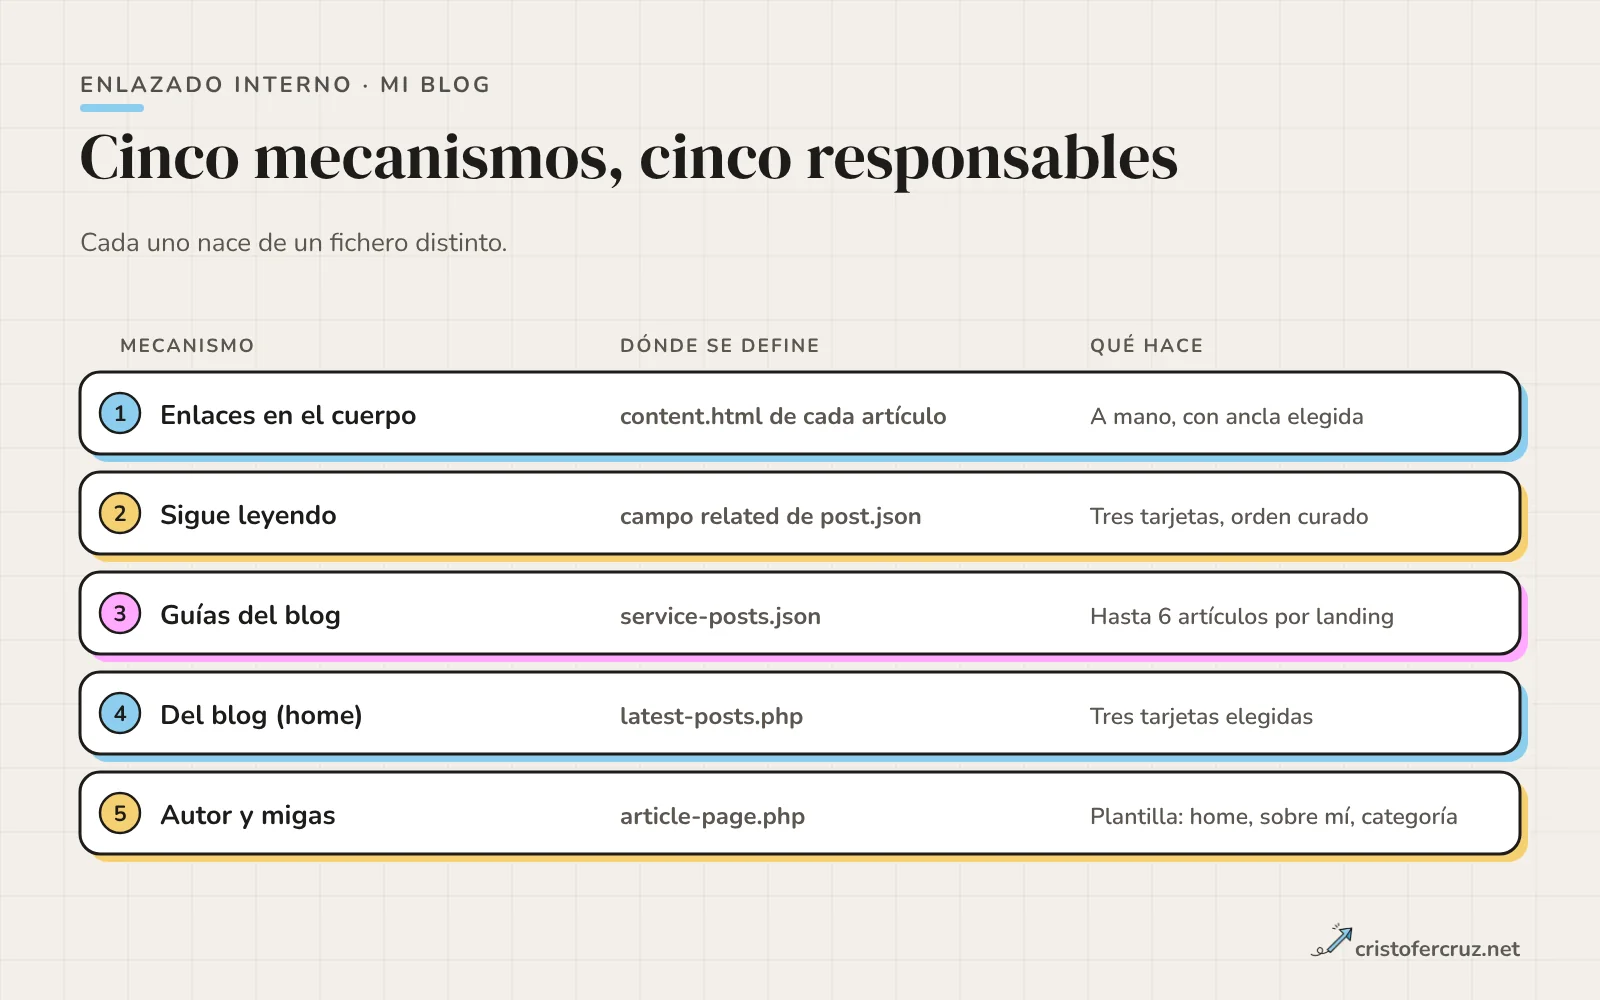
El blog de cristofercruz.net es PHP sin base de datos: cada artículo es una carpeta con post.json (metadatos) y content.html (cuerpo). El enlazado se reparte entre cinco mecanismos que leí en el código antes de describirlos.
Los cinco mecanismos
- Enlaces en el cuerpo. Los escribo a mano en
content.html, con el ancla que elijo en cada frase. - «Sigue leyendo». Al final de cada artículo salen tres tarjetas. La función
blog_relateddeincludes/blog.phptoma primero la lista curada del camporelateddepost.json, en el orden dado; si faltan, completa con artículos de la misma categoría y después con el resto, del más reciente al más antiguo. Cada tarjeta lleva un solo enlace, en el título. - «Guías del blog» en las landings. Las doce páginas de servicio incluyen
includes/service-posts.php, que leeincludes/service-posts.json(servicio → lista de artículos, hasta seis). - Del blog, en la home.
includes/latest-posts.phpmuestra tres artículos elegidos a mano (presupuesto de rastreo, Core Web Vitals y AEO y GEO). Si no existieran, caería a los tres más recientes. - Plantilla del artículo.
includes/article-page.phppinta las migas (Inicio, Blog, categoría, título), el índice con anclas internas y la caja de autor, que enlaza a Sobre mí y a la home.
"related": [
  "core-web-vitals",
  "crawl-budget",
  "logs-seo"
]
Es el related de mi artículo sobre caché. Todos los artículos publicados lo tienen definido. Si faltara, entraría el relleno automático, que favorece a los más recientes sobre los más relevantes. En 23 artículos la lista tiene cuatro entradas y solo se muestran tres.
Otros detalles del código: el listado pagina de seis en seis con enlaces «Anterior» y «Siguiente» y un canonical por página; las URLs filtradas por categoría o búsqueda llevan noindex, follow y su canonical apunta al listado; el JavaScript del listado intercepta los clics, pero los enlaces conservan un href real; y blog/sitemap.php lista todos los artículos, sin lastmod.
Qué mide mi rastreo
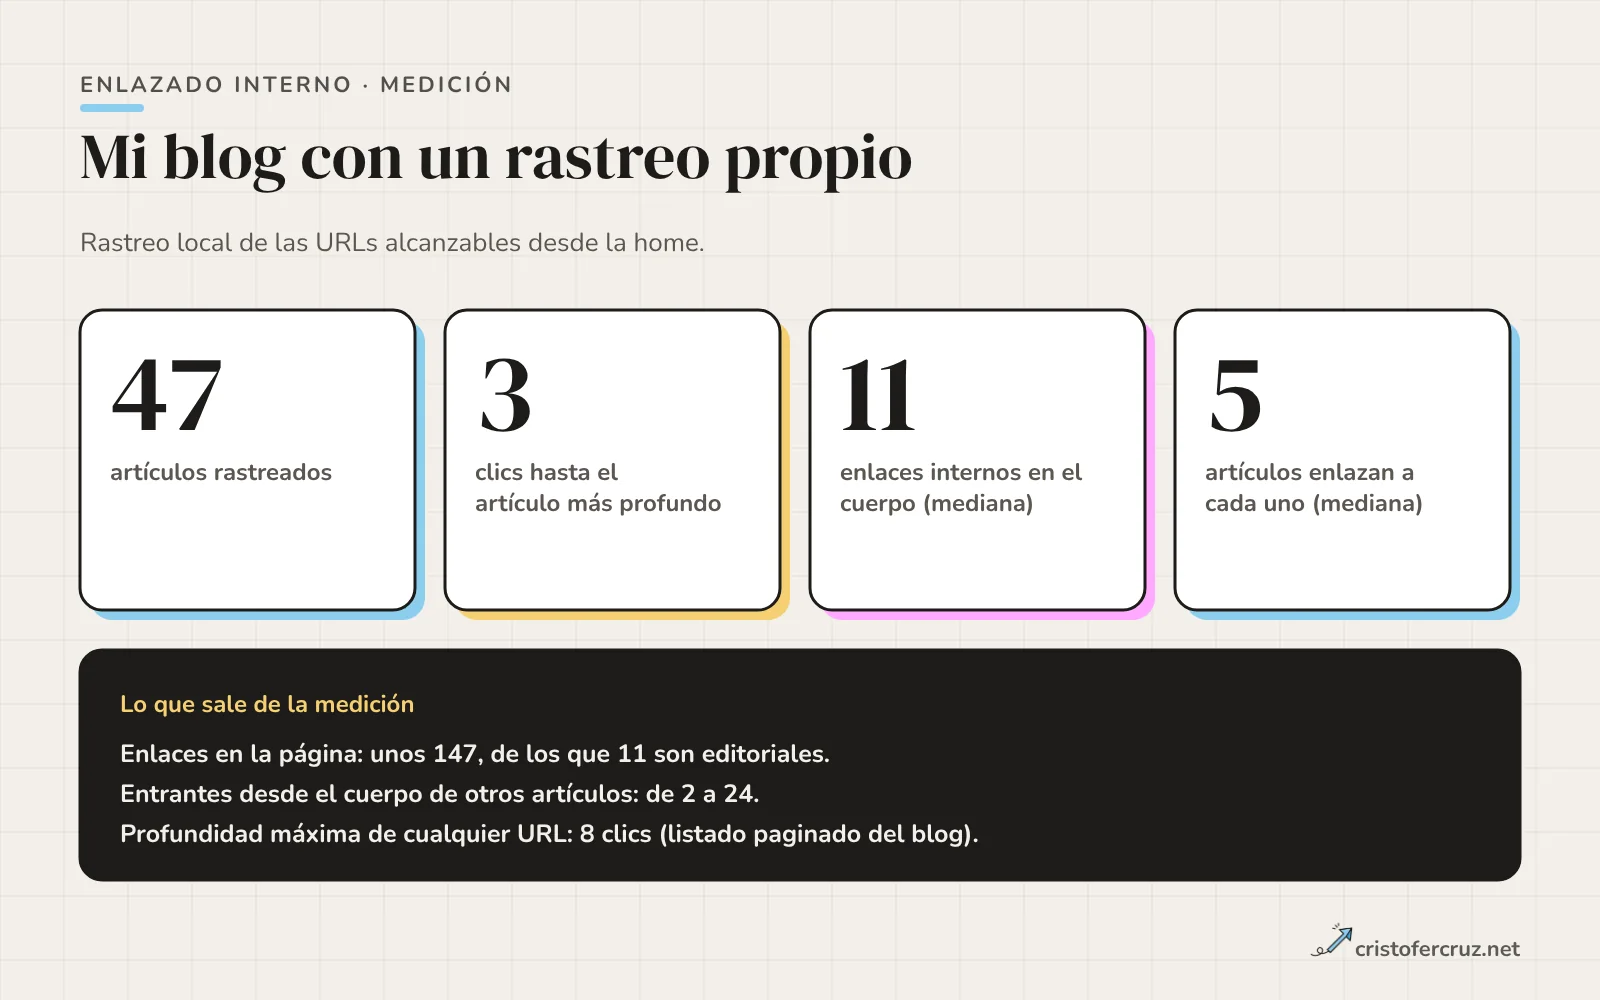
Escribí un rastreador en Python (más abajo, una versión reducida) que sigue los enlaces internos desde la home sobre el sitio local y anota en qué zona de la página está cada uno. Lo ejecuté dos veces: al terminar el último lote de artículos y de nuevo tras enlazar los textos nuevos desde los antiguos. Las cifras son de la segunda medición. Midió HTML servido por PHP, sin ejecutar JavaScript.
| Medida | Resultado |
|---|---|
| URLs rastreables desde la home | 111 (47 artículos, 12 landings de servicio y 21 URLs de listado del blog con filtros y paginación, y el resto páginas sueltas) |
| Profundidad de los artículos | 47 artículos: 3 a 1 clic, 34 a 2 clics y 10 a 3 clics |
| Profundidad máxima de cualquier URL | 8 clics, en las últimas páginas del listado paginado |
| Artículos a más de tres clics si se ignoran la paginación y las categorías | 0 de 47 |
| Enlaces en el HTML de una página de artículo | De 128 a 157 (mediana 147), con 22 destinos únicos en el menú y 22 en el footer |
| Enlaces internos editoriales en el cuerpo | De 6 a 16 por artículo (mediana 11), unos 3,3 por cada 1.000 palabras; 7,5 % de todos los enlaces de la página |
| Enlaces del cuerpo a otros artículos | De 5 a 13 por artículo (mediana 8) |
| Entrantes desde el cuerpo de otros artículos | De 2 a 24 (mediana 5) |
| Artículos en alguna landing o en la home | 34 de 47 (63 huecos en los bloques de las landings) |
| Enlaces entre artículos que son recíprocos | 62,2 % de 373 enlaces |
Entradas de related ya enlazadas en el cuerpo | 164 de 164 |
Carencias que me enseñan los datos
- Artículos sin entrantes desde otros cuerpos: ya no queda ninguno, pero en mi primera medición, antes de enlazar los textos nuevos desde los antiguos, había tres (cloaking-seo, implementacion-hreflang y referrer-policy-seo). Los que menos reciben ahora son que-es-un-consultor-seo (2), enlazado-interno-seo (3), enlazar-card-box (3), implementacion-hreflang (3).
- El ancla «Ver auditoría SEO» aparece 45 veces en 45 artículos, porque es el texto del botón de llamada a la acción. Es un enlace de plantilla, no una decisión editorial, y mi propia tabla de anclas lo marca como «revisar».
- Un 62,2 % de los enlaces entre artículos es recíproco. Si A enlaza a B porque es relevante, lo normal es que B también enlace a A, así que el resto son enlaces de ida sin vuelta que conviene revisar.
- El bloque «Sigue leyendo» repite enlaces que el cuerpo ya contiene: 164 de 164 entradas de
relatedestán enlazadas también en el texto. Aporta poco descubrimiento, y debería apuntar a artículos que el cuerpo no cita. - Mi rastreo local encuentra dos enlaces del footer, a
/aviso-legal/y a/politica-de-privacidad/, que apuntan a rutas inexistentes en el sitio local. No he comprobado si existen en producción. - 13 de mis 47 artículos no están en ningún bloque de landing ni en la home, de modo que dependen del cuerpo de otros artículos y del listado.
- El listado del blog solo tiene «Anterior» y «Siguiente»: las últimas páginas están a varios clics. Hoy no compensa porque los artículos están más cerca por otros caminos, pero no es una arquitectura de listado.
No he medido cómo trata Google estos enlaces ni cuánto rastrea cada artículo: mis cifras describen la estructura, no sus resultados.
Cómo auditar el enlazado interno
Esta es la secuencia que sigo, de más a menos barata.
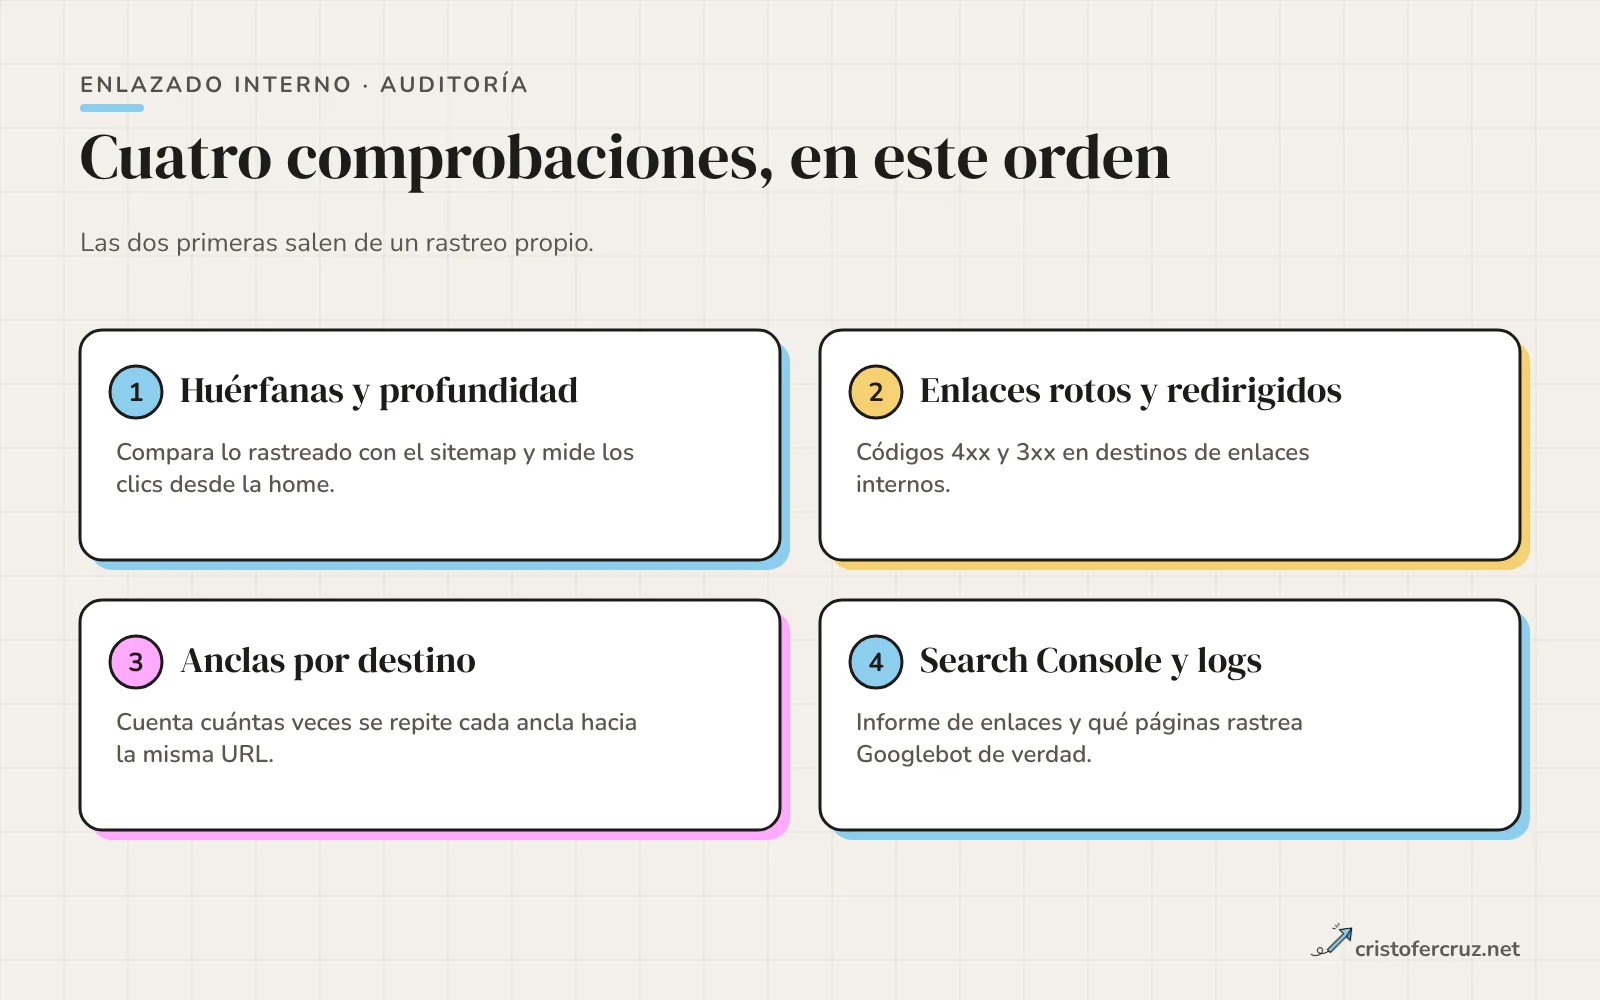
- Rastreo propio o con herramienta. Profundidad, huérfanas, enlaces rotos (4xx) y enlaces que apuntan a redirecciones (3xx). Un enlace interno a una URL que redirige funciona, pero obliga a un salto de más y delata un enlace desactualizado.
- Anclas por destino. Agrupa por URL de destino y cuenta cuántas veces se repite cada ancla.
- Search Console. En el informe de enlaces, la tabla de enlaces internos lista las páginas más enlazadas. No he podido verificar en la ayuda oficial el detalle de cómo se calcula, así que lo uso como referencia y no como medida exacta.
- Logs. Qué páginas rastrea Googlebot de verdad y cuáles no ha tocado en meses. Cruzado con la lista de huérfanas y de enlaces profundos, indica dónde actuar primero (la técnica está en la guía de logs SEO).
Este es el rastreador reducido: cuenta URLs, profundidad máxima y los artículos con menos entrantes. Lo ejecuté contra mi sitio local. El servidor de desarrollo de PHP devuelve el listado del blog con un 200 para URLs que no existen, así que mi versión completa descarta las páginas cuyo canonical no coincide con su ruta.
import collections, urllib.request
from urllib.parse import urljoin, urlsplit
from html.parser import HTMLParser

BASE = "http://127.0.0.1:8099"

class Links(HTMLParser):
    def __init__(self):
        super().__init__(); self.out = []
    def handle_starttag(self, tag, a):
        a = dict(a)
        if tag == "a" and a.get("href"):
            self.out.append(a["href"])

depth, inbound, q = {"/": 0}, collections.defaultdict(set), collections.deque(["/"])
while q:
    url = q.popleft()
    p = Links()
    p.feed(urllib.request.urlopen(BASE + url).read().decode("utf8", "replace"))
    for href in p.out:
        t = urlsplit(urljoin(BASE + url, href))
        if t.netloc != urlsplit(BASE).netloc or t.path.startswith("/assets"):
            continue
        dest = t.path + ("?" + t.query if t.query else "")
        inbound[dest].add(url)
        if dest not in depth:
            depth[dest] = depth[url] + 1
            q.append(dest)

print(len(depth), "URLs, profundidad máxima", max(depth.values()))
blog = [(len(s), u) for u, s in inbound.items() if u.startswith("/blog/") and "?" not in u]
for n, u in sorted(blog)[:5]:
    print(n, u)
El script cuenta todos los enlaces, también los de menú y footer. Mi versión completa anota la zona del HTML de cada enlace (por la clase del contenedor), que es lo que separa «recibe enlaces» de «recibe enlaces editoriales».
Qué hacer esta semana
- Rastrea tu sitio y saca tres listas: huérfanas, páginas muy profundas y enlaces a URLs que redirigen o fallan.
- Elige las diez páginas que más te importan y cuenta cuántos enlaces editoriales reciben. Si alguna recibe menos de tres, ya tienes tarea.
- Para cada contenido nuevo, añade enlaces desde dos o tres artículos antiguos el mismo día que lo publicas.
- Revisa las anclas más repetidas hacia una misma URL y separa las editoriales de las de plantilla.
- Guarda la matriz de origen y destino y revísala cada trimestre.
Si solo puedes hacer una cosa, enlaza cada contenido nuevo desde dos o tres antiguos y relacionados el día que lo publicas: es lo que más páginas huérfanas evita.
Preguntas frecuentes
¿Cuántos enlaces internos debe tener una página?
Google dice que no existe un número ideal y que, si te parecen demasiados, probablemente lo sean. Compara tus páginas entre sí y fíjate sobre todo en cuántos enlaces son editoriales y cuántos son de plantilla.
¿Hay que estar a menos de tres clics de la home?
Google no documenta esa regla; es una referencia habitual en la literatura SEO. Úsala como señal relativa, no como umbral.
¿Los enlaces internos pasan autoridad?
Google no publica cifras sobre cuánto transmite un enlace interno. Lo que sí documenta es que descubre páginas siguiendo enlaces. El reparto de autoridad es una hipótesis útil, pero no una medida.
¿Puedo usar nofollow en enlaces internos?
Rara vez tiene sentido. Google lo describe para enlaces que no quieres asociar a tu sitio, como anuncios o comentarios. En facetas funciona solo si todos los enlaces hacia esa URL lo llevan, y robots.txt suele ser más directo.
¿Un enlace con onclick es rastreable?
Solo si es un <a> con un href real. El onclick puede añadirse encima para que tu aplicación intercepte el clic, pero sin href Google no puede extraer la URL de forma fiable.
¿El texto ancla debe llevar la palabra clave exacta?
No. Debe describir el destino con naturalidad. No conozco un umbral documentado de repetición.
¿Cómo encuentro las páginas huérfanas?
Comparando dos listas: las URLs que conoces por sitemap, CMS o logs y las que alcanza un rastreo desde la home. Las que solo están en la primera lista son huérfanas.
Referencias y fuentes
Documentación y artículos consultados para esta guía.
- Link best practices for Google Google Search Central
- SEO Starter Guide Google Search Central
- JavaScript SEO basics Google Search Central
- Pagination, incremental page loading, and their impact on Google Search Google Search Central
- Managing crawling of faceted navigation URLs Google Search Central
- Qualify your outbound links to Google Google Search Central
- Enlaces internos para SEO: una guía práctica Ahrefs
- Enlaces internos en SEO: estrategias clave y mejores prácticas SE Ranking