- El canonical es una pista, no una directiva: Google puede elegir otra URL distinta de la que declaras.
- Según la documentación de Google, las redirecciones y
rel="canonical"son señales fuertes, y la inclusión en el sitemap es una señal débil. - Pon un canonical autorreferencial en cada página indexable, con URL absoluta y un solo elemento dentro del
<head>. - Para paginación, cada página lleva su propio canonical: Google desaconseja apuntar todas a la primera.
- Canonical,
noindexy 301 resuelven problemas distintos. Mezclarlos manda señales contradictorias. - Se comprueba en Inspección de URL comparando el canonical declarado por el usuario con el seleccionado por Google.
Pones un canonical en una página, Google indexa otra URL y el informe de Search Console te dice que «Google eligió una canónica diferente a la del usuario». La causa casi nunca es un fallo de la etiqueta, sino que el resto de señales (redirecciones, enlaces internos, sitemap, contenido) apuntan a otro sitio.
Aquí explico qué dice Google sobre el canonical, qué método pesa más, cuándo usar canonical, noindex o una 301, qué errores veo con más frecuencia y cómo se genera el canonical en cristofercruz.net, incluyendo una decisión mía que conviene revisar.
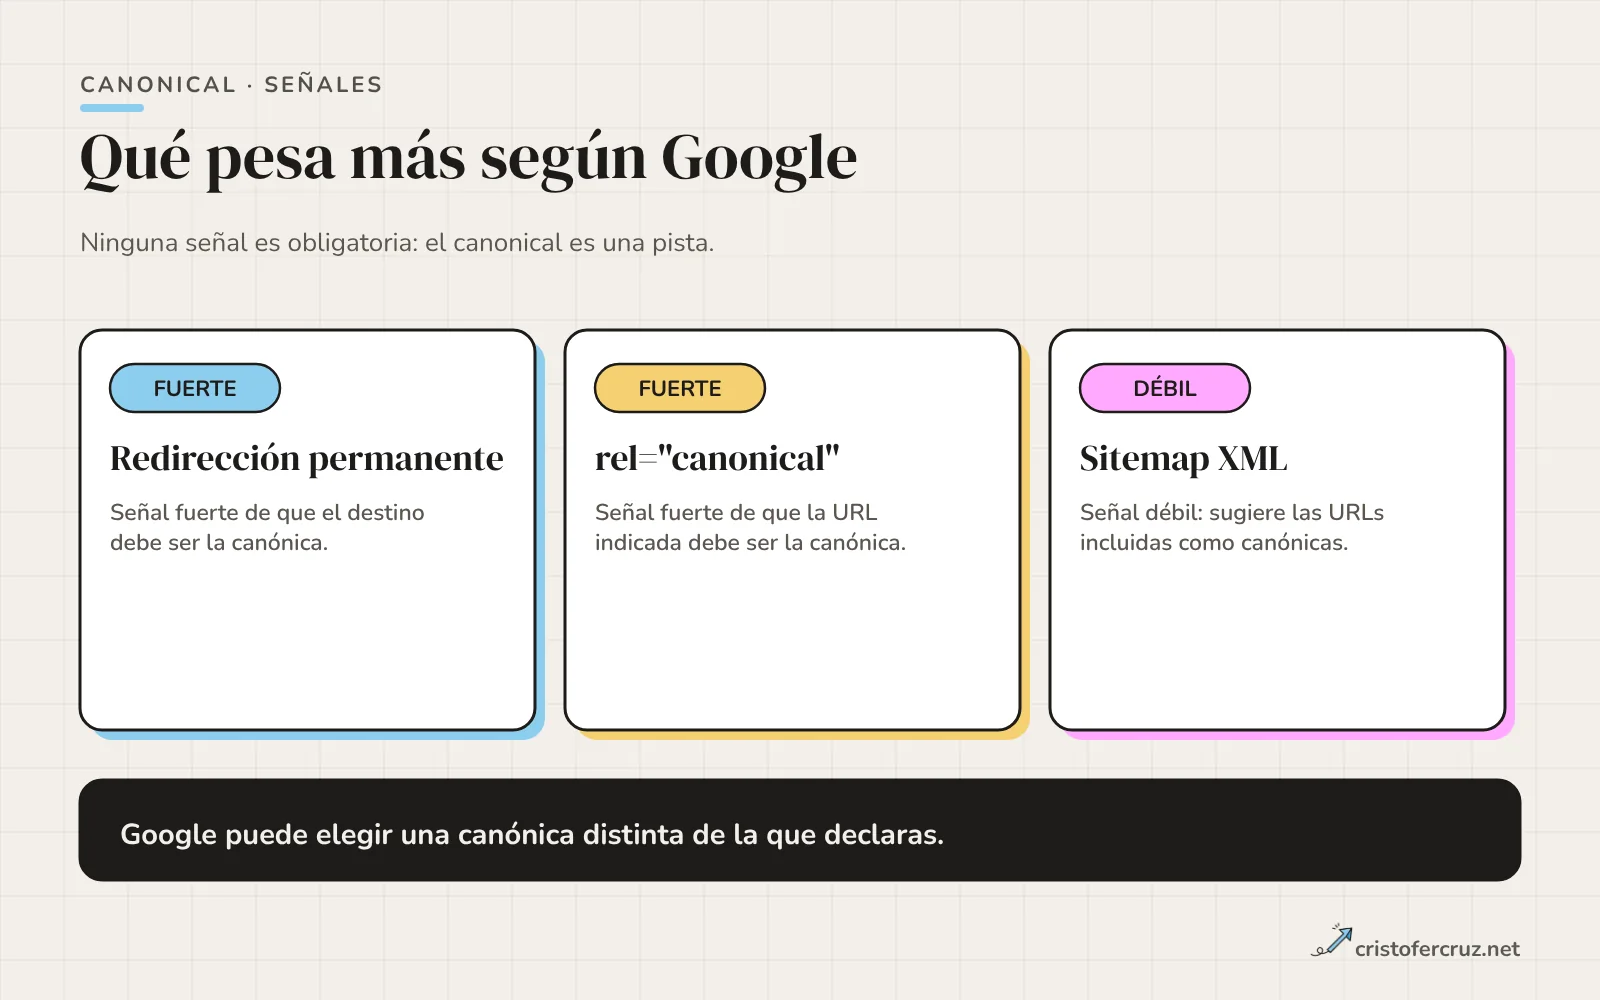
Qué es el canonical y qué problema resuelve
Cuando varias URLs muestran el mismo contenido o uno muy parecido, Google las agrupa y elige una como canónica: la que mostrará en resultados y la que rastreará con más frecuencia. Según la documentación, la canónica se elige por ser la más completa y útil para el usuario, y las demás se rastrean menos, algo que pesa en el presupuesto de rastreo cuando el sitio es grande.
El elemento rel="canonical" sirve para decirle cuál prefieres. Los duplicados aparecen sin que nadie los cree a propósito:
- La misma página con y sin barra final, con
httpyhttps, o con y sinwww. - Parámetros de seguimiento (
?utm_source=,?gclid=), ordenación y filtros. - Versiones imprimibles, móviles en otra URL o variantes regionales casi idénticas.
- Contenido sindicado o republicado en otro dominio.
El objetivo es concentrar señales en una URL y evitar que Google decida por ti con información peor.
Sugerencia, no directiva
La propia documentación lo dice sin rodeos: indicar una preferencia de canonical es «una pista, no una regla», y Google puede elegir una página distinta de la tuya. Ninguno de los métodos es obligatorio y tu sitio puede funcionar sin declarar nada.
Lo que cambia con esto es cómo debuggeas. Si Google ignora tu canonical no hay un error que corregir en la etiqueta: hay que buscar qué otras señales dicen otra cosa. Las habituales son enlaces internos que apuntan a la variante equivocada, un sitemap con URLs no canónicas, contenido que difiere demasiado entre las dos páginas o una redirección que contradice el canonical.
La diferencia con noindex es de naturaleza: noindex es una directiva que Google obedece, mientras que el canonical solo orienta la elección dentro de un grupo de duplicados.
Métodos para indicar el canonical y su fuerza relativa
Google documenta tres señales de canonicalización con distinta fuerza. La cabecera HTTP no es un método aparte en esa lista: es otra forma de declarar rel="canonical".
| Método | Fuerza según Google | Cuándo usarlo |
|---|---|---|
| Redirección permanente | Señal fuerte | Al retirar una URL duplicada para siempre |
<link rel="canonical"> en el HTML | Señal fuerte | Duplicados que deben seguir accesibles |
Cabecera HTTP Link | La misma señal que el elemento HTML | PDF y otros ficheros que no tienen <head> |
| Sitemap XML | Señal débil | Refuerzo: lista solo las URLs que quieres como canónicas |
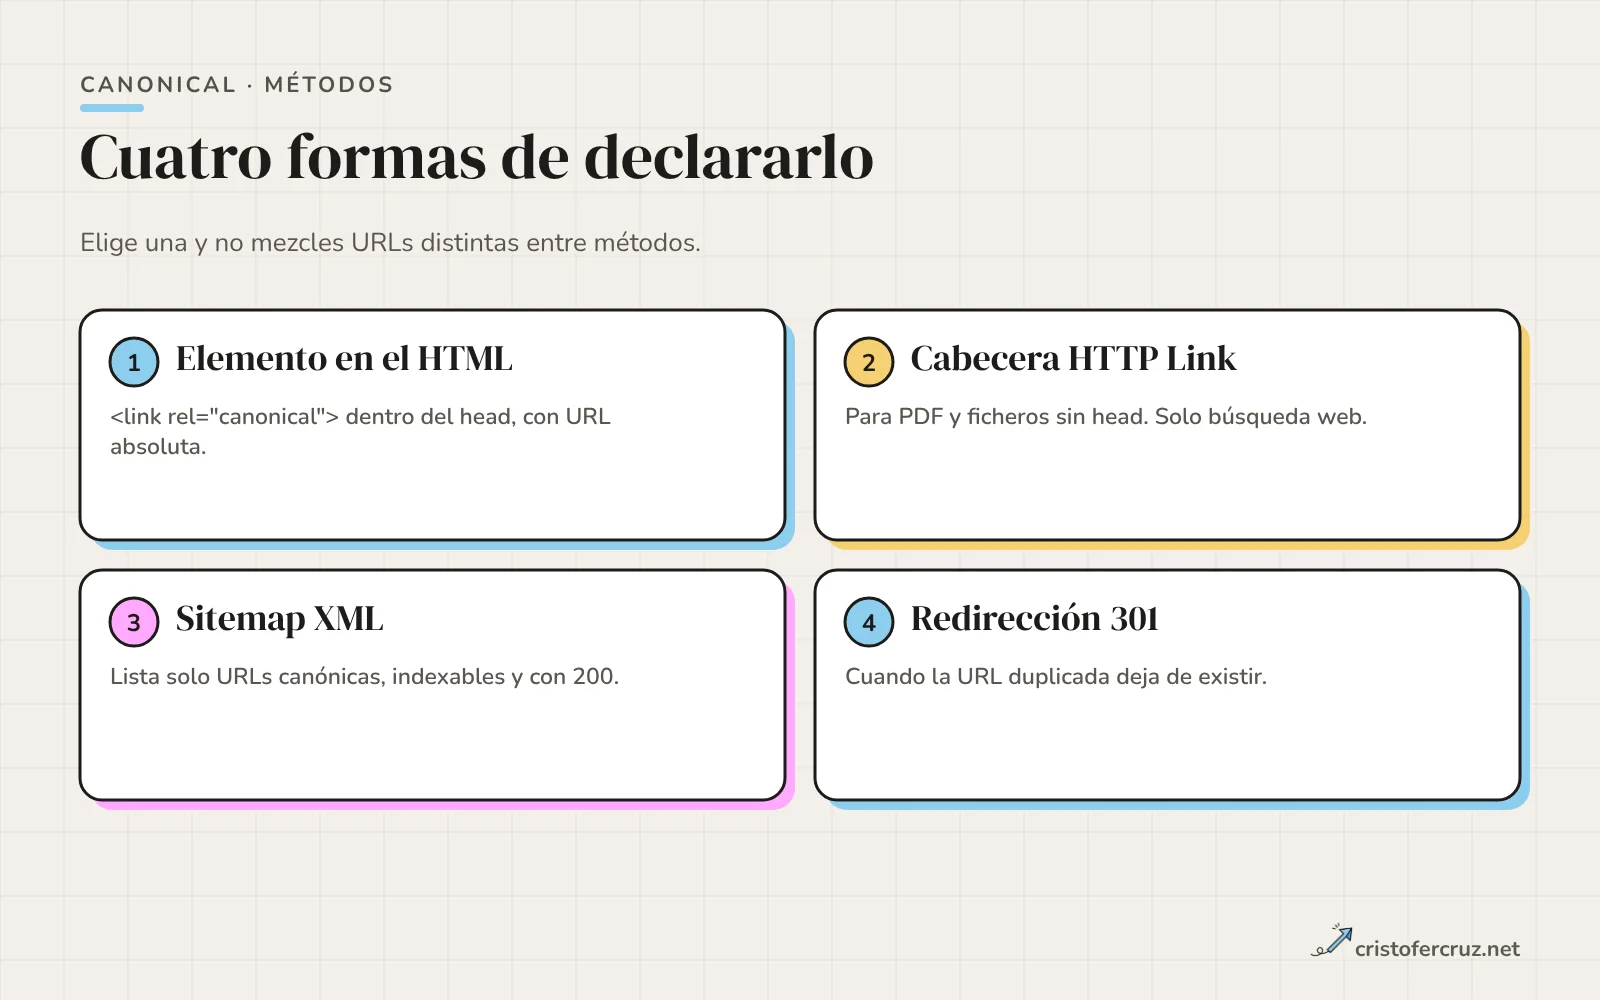
Link equivale al elemento HTML para ficheros sin <head>.En el HTML
Es el método habitual. Google solo acepta el elemento si aparece en la sección <head>, y pide URL absolutas:
<link rel="canonical" href="https://www.ejemplo.com/zapatillas/running/">En la cabecera HTTP
Para documentos sin HTML, como un PDF, se envía en la respuesta, en el mismo sitio del servidor donde se configura la cabecera X-Robots-Tag. Según Google, este método solo vale para la búsqueda web:
Link: <https://www.ejemplo.com/guia.pdf>; rel="canonical"Google avisa de que usar a la vez HTML y cabecera es más propenso a errores. Elige uno.
En el sitemap
Todas las URLs de un sitemap se sugieren como canónicas y Google decide cuáles son duplicados. Por eso conviene que el sitemap contenga únicamente URLs canónicas, indexables y con respuesta 200. Cómo montarlo bien lo detallo en la guía de sitemaps XML.
Con redirecciones
Una redirección permanente es la señal más clara cuando el duplicado ya no tiene que existir. La documentación indica usarla solo cuando retiras la página duplicada. Si los usuarios todavía necesitan acceder a ambas URLs, el canonical es la herramienta. En una migración SEO las redirecciones y los canonical tienen que contar la misma historia.
Canonical autorreferencial
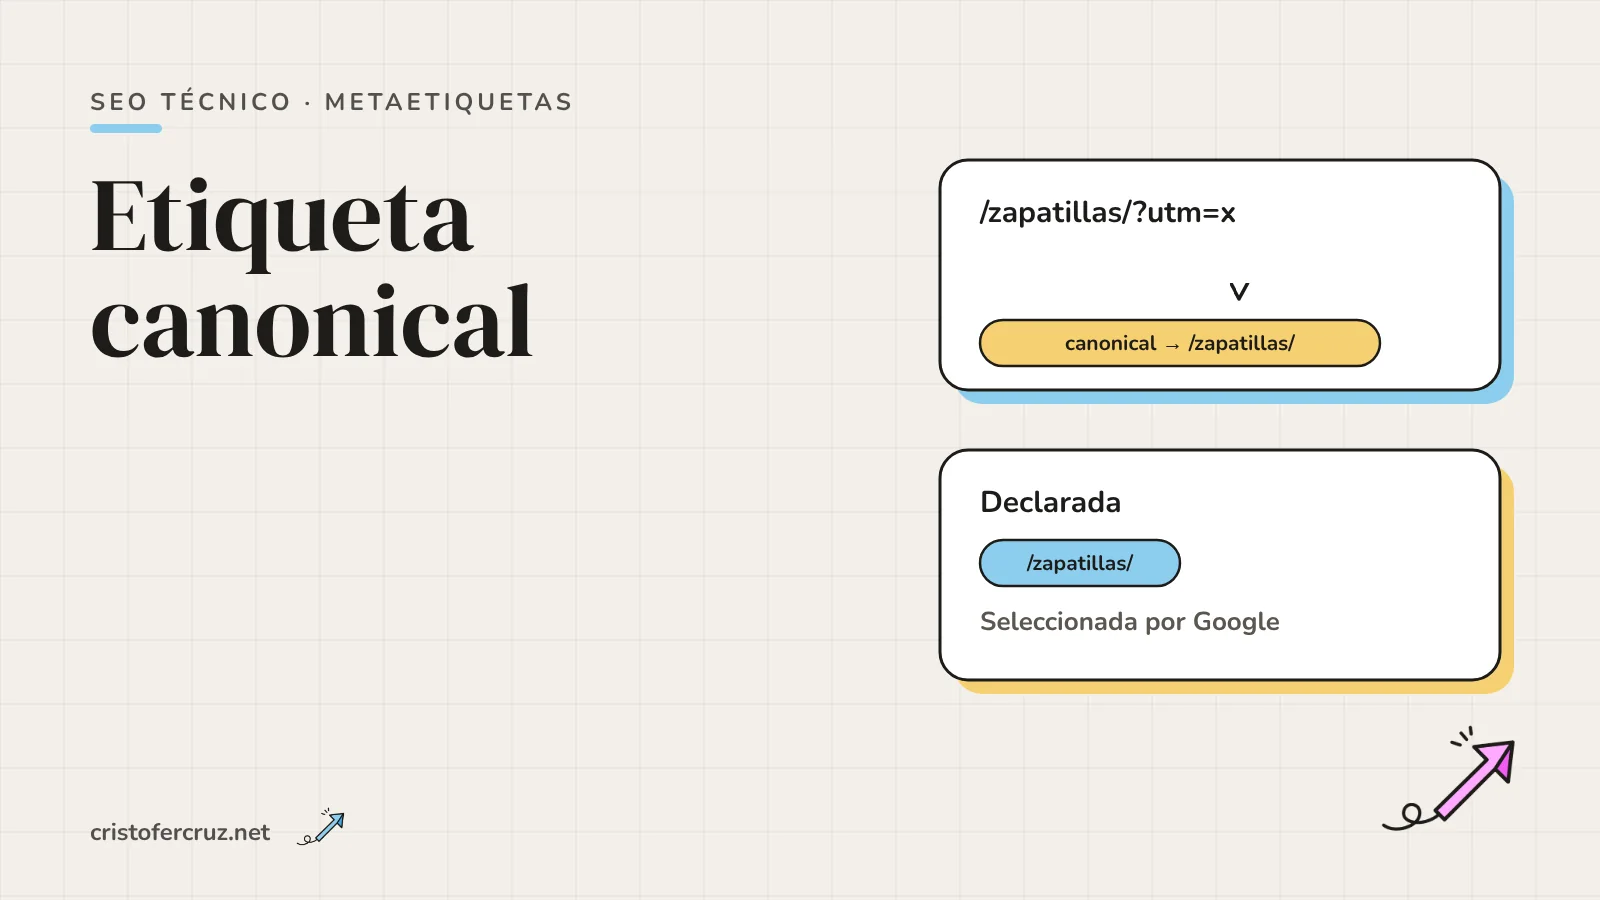
Consiste en que la página se declare a sí misma como canónica. Google recomienda incluir el canonical en la propia página canónica, y es la medida más barata contra duplicados que no has previsto: si alguien enlaza ?utm_source=newsletter o la URL sin barra final, la copia hereda un canonical que apunta a la versión limpia.
Debe cumplir tres condiciones: URL absoluta con protocolo y dominio, una única declaración por página y valor idéntico al de la URL que quieres ver indexada, incluida la barra final.
Parámetros, filtros y ordenaciones
Un parámetro que no cambia el contenido (utm_*, gclid, sesiones) debería canonicalizar a la URL sin parámetro. Google usa justo un ejemplo así en su documentación: /dresses/cocktail?gclid=ABCD como variante no preferida.
Los filtros y ordenaciones que sí cambian el contenido dependen de su valor SEO. Si una combinación tiene demanda de búsqueda, merece URL propia, contenido propio y canonical autorreferencial. Si no la tiene, tienes dos opciones: canonical hacia la lista sin filtrar o noindex. La guía de Google sobre paginación recomienda noindex o reglas en robots.txt para variantes filtradas u ordenadas, aunque, como explico más abajo, el robots.txt no impide la indexación de la URL.
Paginación
La instrucción de Google es explícita: no uses la primera página de una secuencia paginada como canónica del resto. Cada página tiene su URL y su canonical autorreferencial, porque su contenido es distinto. Si todas apuntan a la página 1, le dices a Google que las páginas 2 y 3 son la misma que la 1, cuando listan contenido distinto.
Google tampoco usa ya rel="prev" y rel="next"; lo que recomienda son enlaces <a href> normales a la página siguiente. Y nada de fragmentos (#pagina-2) para numerar: Google ignora los identificadores de fragmento.
Duplicados entre dominios y sindicación
El canonical puede apuntar a otro dominio, y es lo habitual cuando republicas un artículo en otro medio y quieres que el original conserve el protagonismo. La documentación de solución de problemas matiza que el elemento canonical no se recomienda a quien quiere evitar duplicación con socios que sindican su contenido: en ese caso los socios deberían bloquear la indexación.
En la práctica, un canonical cruzado entre dominios sigue siendo una pista. Si el medio que republica tiene más autoridad, o mejor rastreo, Google puede quedarse con su copia. Si dependes de que el original gane, pide un canonical, pero no des por hecho que lo respetarán. Con contenido repetido entre un subdominio y el dominio principal pasa algo parecido, y conviene decidir bien entre subdominio o subdirectorio antes de duplicar nada.
Canonical, noindex o 301: cuál elegir
| Situación | Herramienta | Por qué |
|---|---|---|
| La URL duplicada ya no debe existir | 301 a la canónica | Usuarios y bots llegan a la URL final, y es señal fuerte |
| Las dos URLs deben seguir accesibles y son equivalentes | rel="canonical" | Consolida señales sin eliminar la URL |
| La página no debe aparecer en resultados y no tiene equivalente | noindex | Es una directiva, no una pista |
| Fichero PDF equivalente a una página HTML | Cabecera Link | No hay <head> donde poner el elemento |
| Copia en el dominio de un socio de sindicación | Pedir noindex en la copia | Es lo que indica Google para este caso |
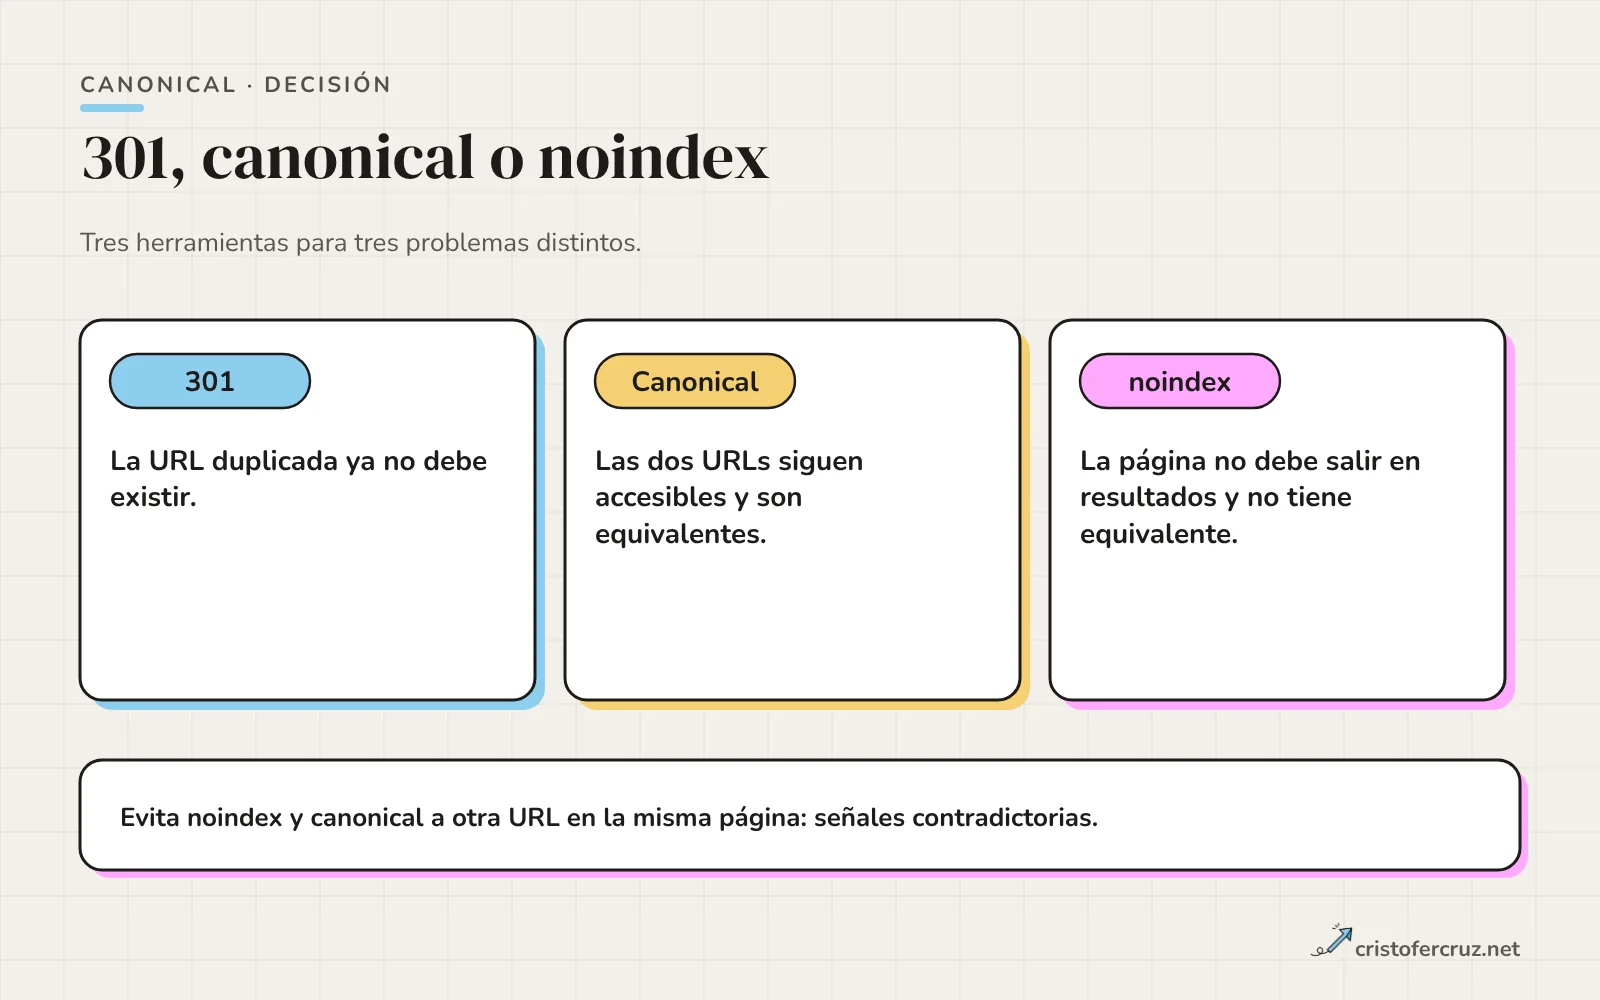
Evita combinar noindex con un canonical a otra URL: dices «no indexes esta» y «consolida en aquella» a la vez. Google indica que no recomienda noindex para evitar la elección de una canónica dentro de un mismo sitio. Con las dos señales a la vez no se sabe cuál prevalecerá, y la guía de Ahrefs advierte que, aunque Google suele priorizar el canonical, no está garantizado.
Antes de añadir una etiqueta, pregúntate si la URL duplicada debería existir. Si la respuesta es no, la 301 resuelve el problema de raíz y el canonical sobra.
Los casos más habituales de un vistazo
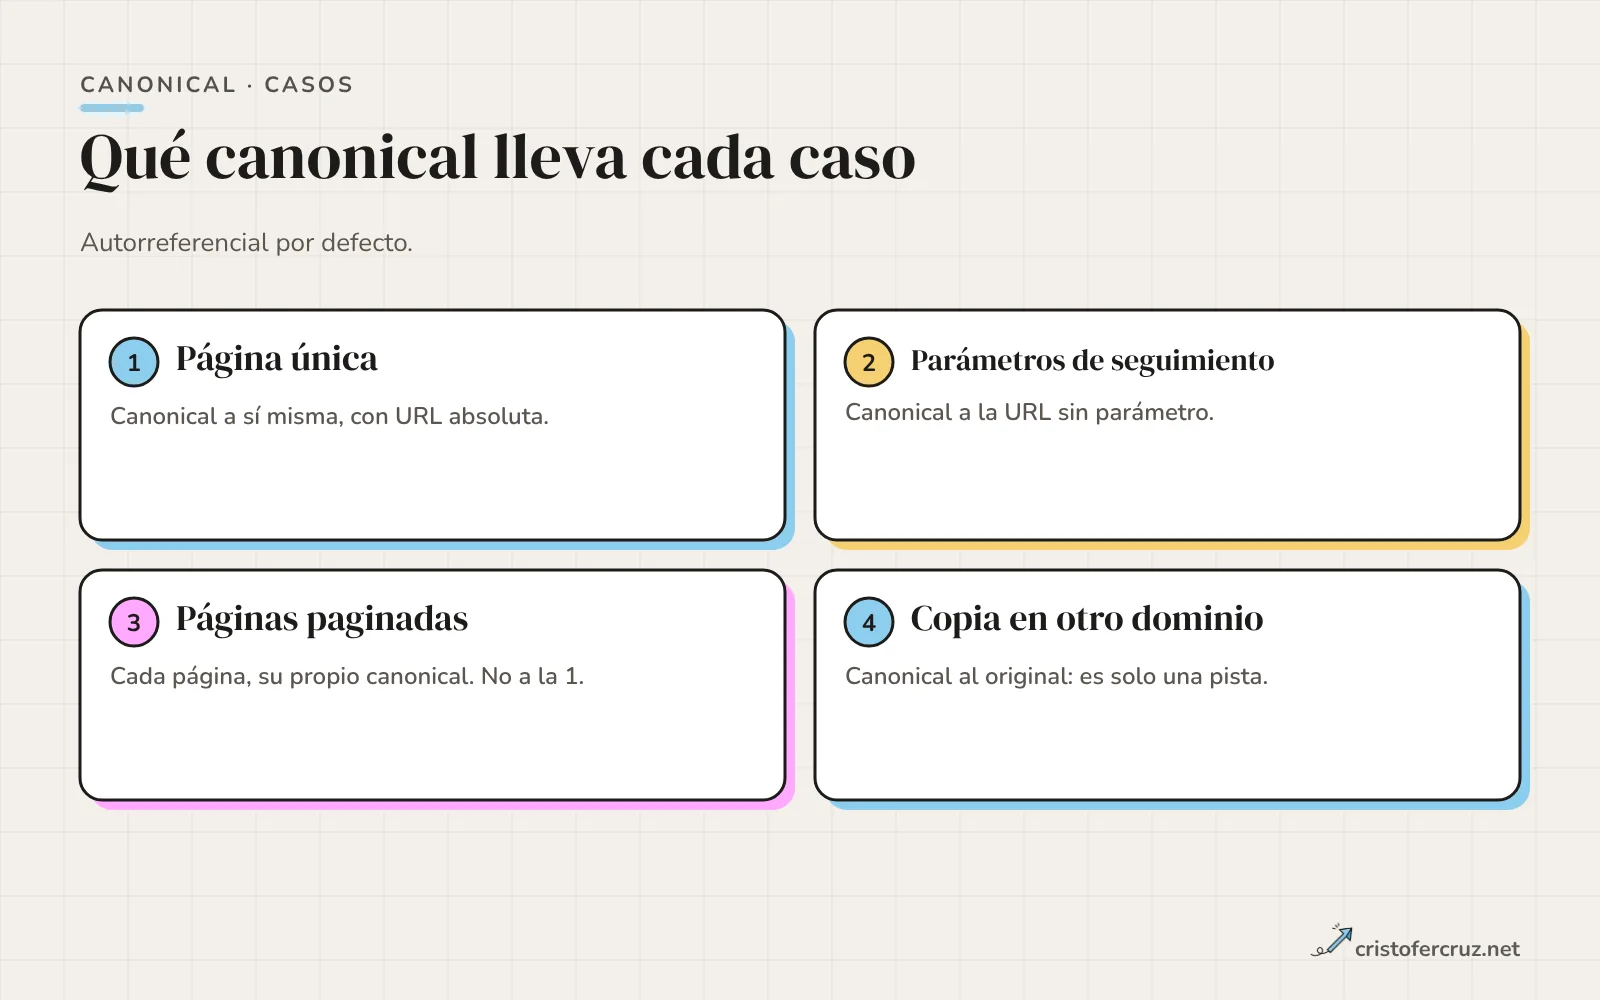
Resumen de la sección anterior en una pantalla: autorreferencial por defecto, parámetros neutros hacia la URL limpia, paginación con su propio canonical y copias entre dominios apuntando al original, sabiendo que esto último es solo una pista.
Errores típicos
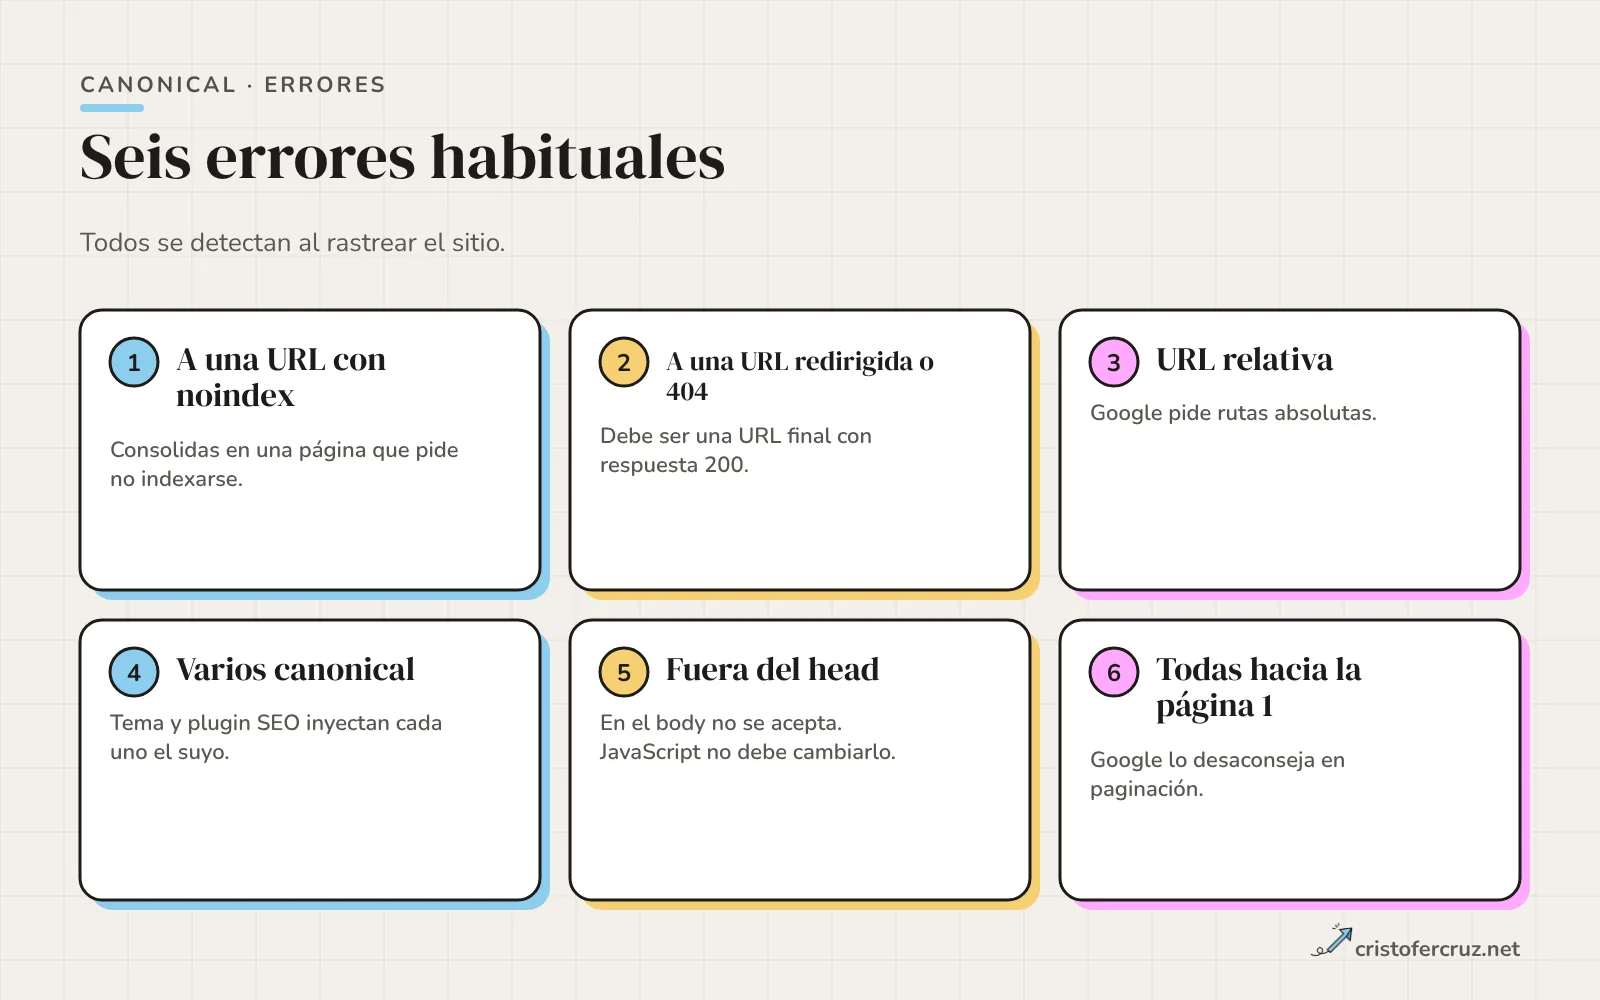
- Canonical a una URL con noindex. Pides consolidar en una página que, a la vez, le dice a Google que no la indexe. La documentación desaconseja usar
noindexpara gestionar la elección de canónica. - Canonical a una URL redirigida o que da 404. El canonical debe apuntar a una URL final con respuesta 200. Una cadena de redirecciones diluye la señal; un error la rompe.
- URL relativa. Google pide rutas absolutas. Una relativa puede resolverse mal si cambia el dominio, el protocolo o el entorno.
- Varios canonical en la misma página. Suelen venir de un tema y un plugin SEO que inyectan cada uno el suyo. Con dos valores distintos, nadie sabe cuál se leerá.
- Elemento fuera del head. Si queda en el
<body>, por un error de marcado o por JavaScript, Google no lo acepta. La documentación también pide que JavaScript no modifique el elemento. - Todas las páginas paginadas hacia la primera. Google lo desaconseja de forma expresa.
- Usar robots.txt para canonicalizar. Google puede indexar URLs bloqueadas (lo detallo en la guía de robots.txt), y si bloqueas la duplicada no podrá ver su canonical.
- Canonical a un fragmento (
#). Google no los admite como canónica.
Si trabajas con la etiqueta hreflang, añade un error más: la canónica de cada versión debe estar en el mismo idioma. Para variantes regionales en el mismo idioma, Google recomienda usar canonical y hreflang a la vez.
Cómo lo genero en mi web
En cristofercruz.net el canonical sale de includes/header.php, una única plantilla para las páginas con diseño actual. La lógica es esta:
$canonical = $canonicalOverride ?? (SITE_URL . url($pagePath));
<link rel="canonical" href="<?= e($canonical) ?>">
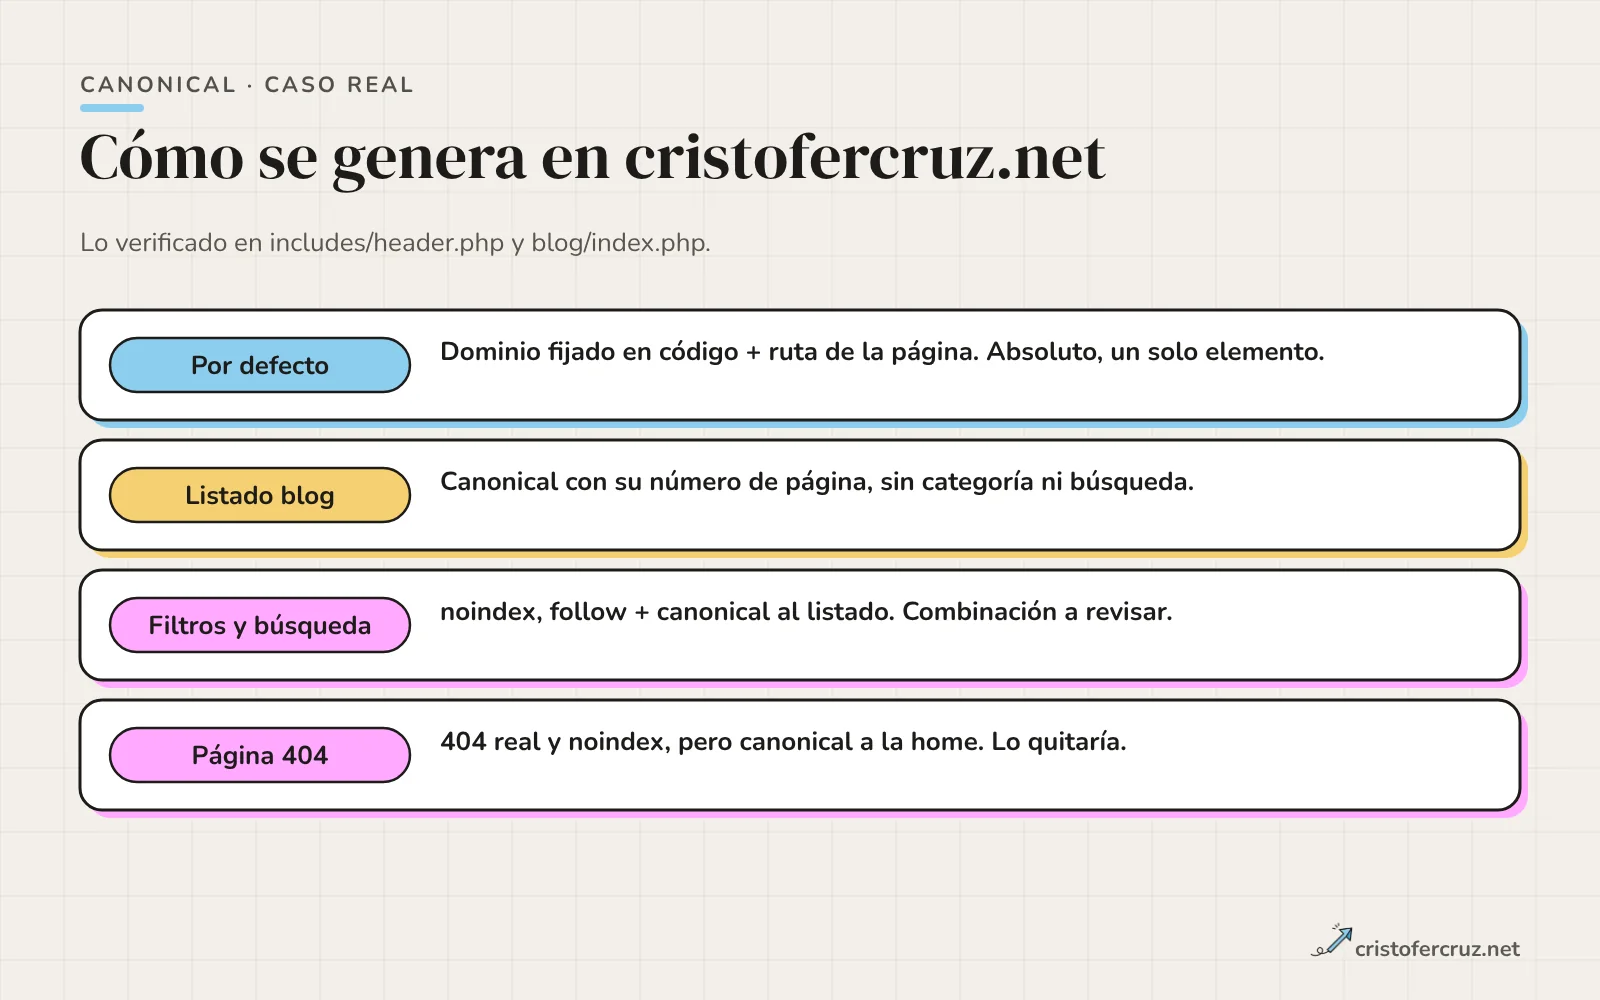
Es decir, por defecto el canonical es el dominio definido en configuración (https://cristofercruz.net) más la ruta de la página: siempre absoluto, con protocolo y dominio fijados en código y sin parámetros de entrada. Cada artículo del blog hereda así un canonical autorreferencial, y se emite un solo elemento por página, dentro del <head>. Las mismas páginas declaran también hreflang «es-ES» y «x-default» apuntando a esa misma URL.
El listado del blog
El listado sobrescribe el canonical con $canonicalOverride, construido con la página actual pero sin categoría ni búsqueda. Comprobado en local, /blog/ declara https://cristofercruz.net/blog/. Con pocos artículos hay una sola página; si el listado crece, la página 2 declarará /blog/?pagina=2, es decir, un canonical propio y no hacia la primera, como pide Google. Un ?pagina= mayor que el total se ajusta a la última página existente, y el canonical sale de ese valor ajustado.
Las URLs con filtro de categoría o búsqueda (?categoria=wpo, ?q=seo) llevan noindex, follow y un canonical que apunta al listado sin filtro. Es la combinación que describía antes como contradictoria. Son páginas de utilidad sin valor propio en buscadores, y el canonical al listado deja clara su relación. No lo he contrastado con datos de Search Console: si Inspección de URL mostrara conflictos, quitaría una de las dos señales.
La página 404
La plantilla 404 devuelve estado 404, X-Robots-Tag: noindex, nofollow y meta robots noindex, nofollow, pero también declara como canonical la home. Es un canonical hacia una URL sin relación con la petición. Con el 404 real y el noindex es improbable que cause problemas, pero es un valor que no aporta nada y lo eliminaría.
Lo que no hago
- No uso cabecera HTTP
Linkpara canonical: no sirvo PDF propios. - Mi
sitemap.xmly el de blog solo listan URLs limpias, sin parámetros, y las canónicas coinciden con ellas. - El
.htaccessdel repositorio no contiene redirecciones dehttpahttpsni dewwwa nowww. Si existen, estarán a nivel de hosting y no las he verificado aquí. Es una comprobación pendiente: un canonical sin esa redirección es solo una pista sobre variantes que deberían redirigir.
Cómo comprobar los canonical
Inspección de URL
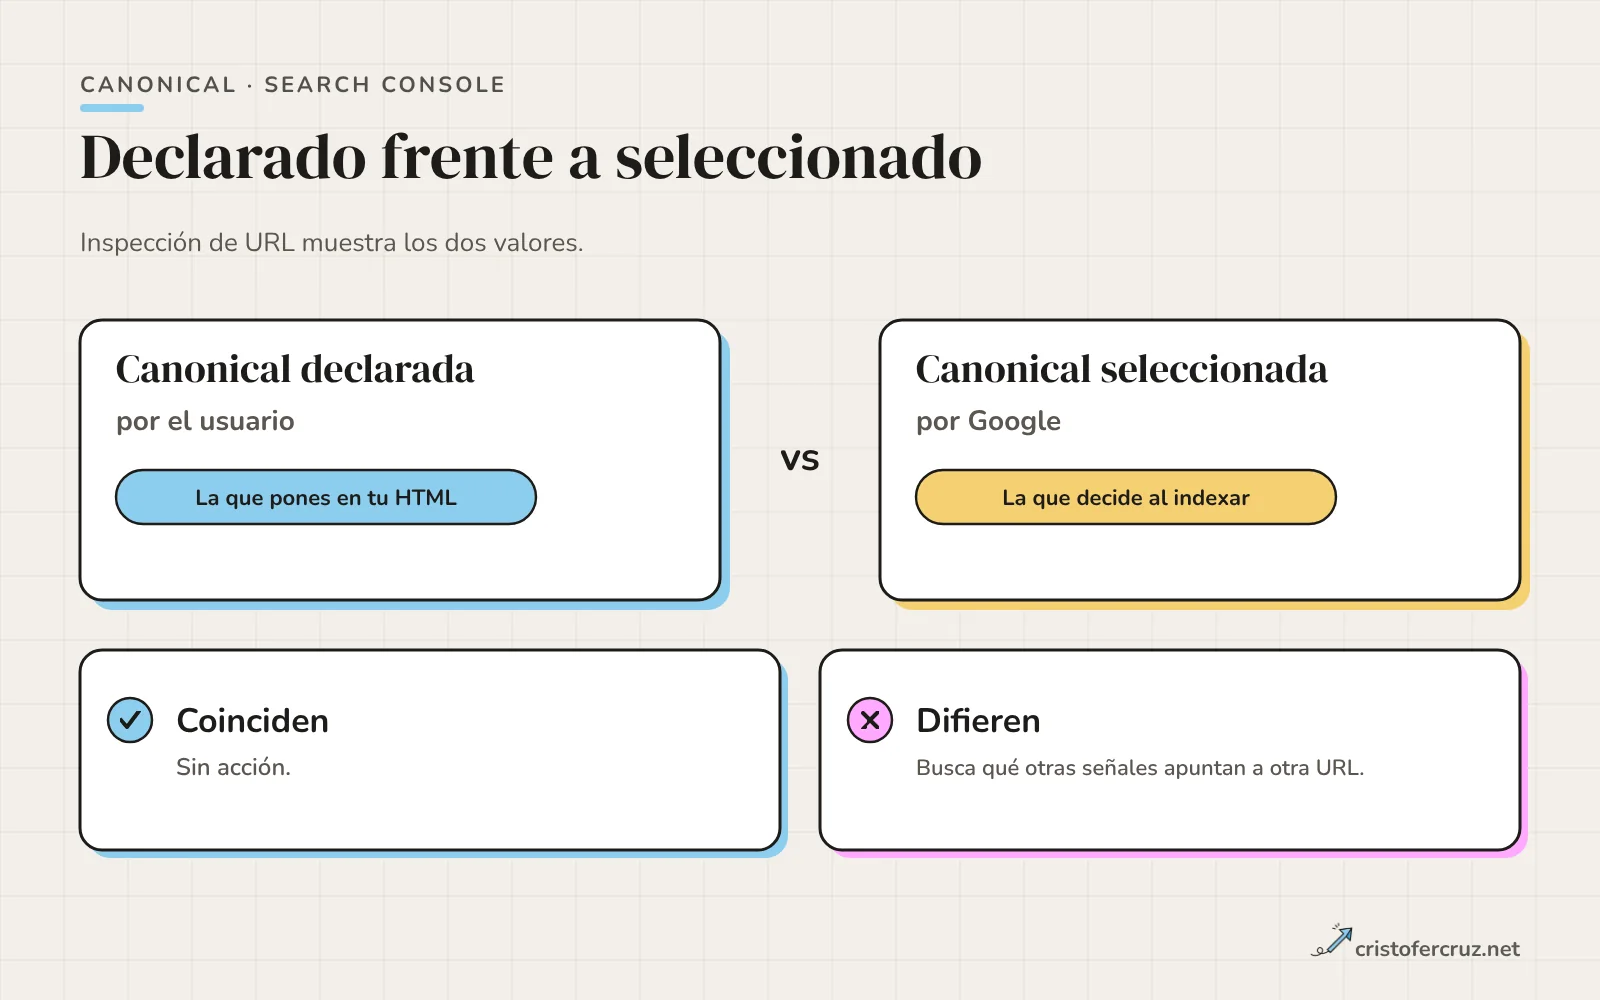
En Search Console, Inspección de URL muestra dos campos: «Canonical declarada por el usuario» y «Canonical seleccionada por Google». Google explica que puede elegir tu canónica, pero a veces escoge otra URL, y que si la página no tiene versiones alternativas la seleccionada es la propia URL inspeccionada. Dos matices de la ayuda: el dato puede ir unas horas por detrás del índice y la prueba en vivo no puede predecir qué versión se considerará canónica, porque la elección se hace al indexar.
El informe de indexación recoge los estados asociados. «Duplicada: Google eligió una canónica diferente a la del usuario» significa que marcaste una página como canónica del grupo pero Google cree que otra URL lo es mejor. «Página alternativa con etiqueta canónica adecuada» indica que apunta bien a una canónica indexada y no hay nada que hacer.
Otras comprobaciones
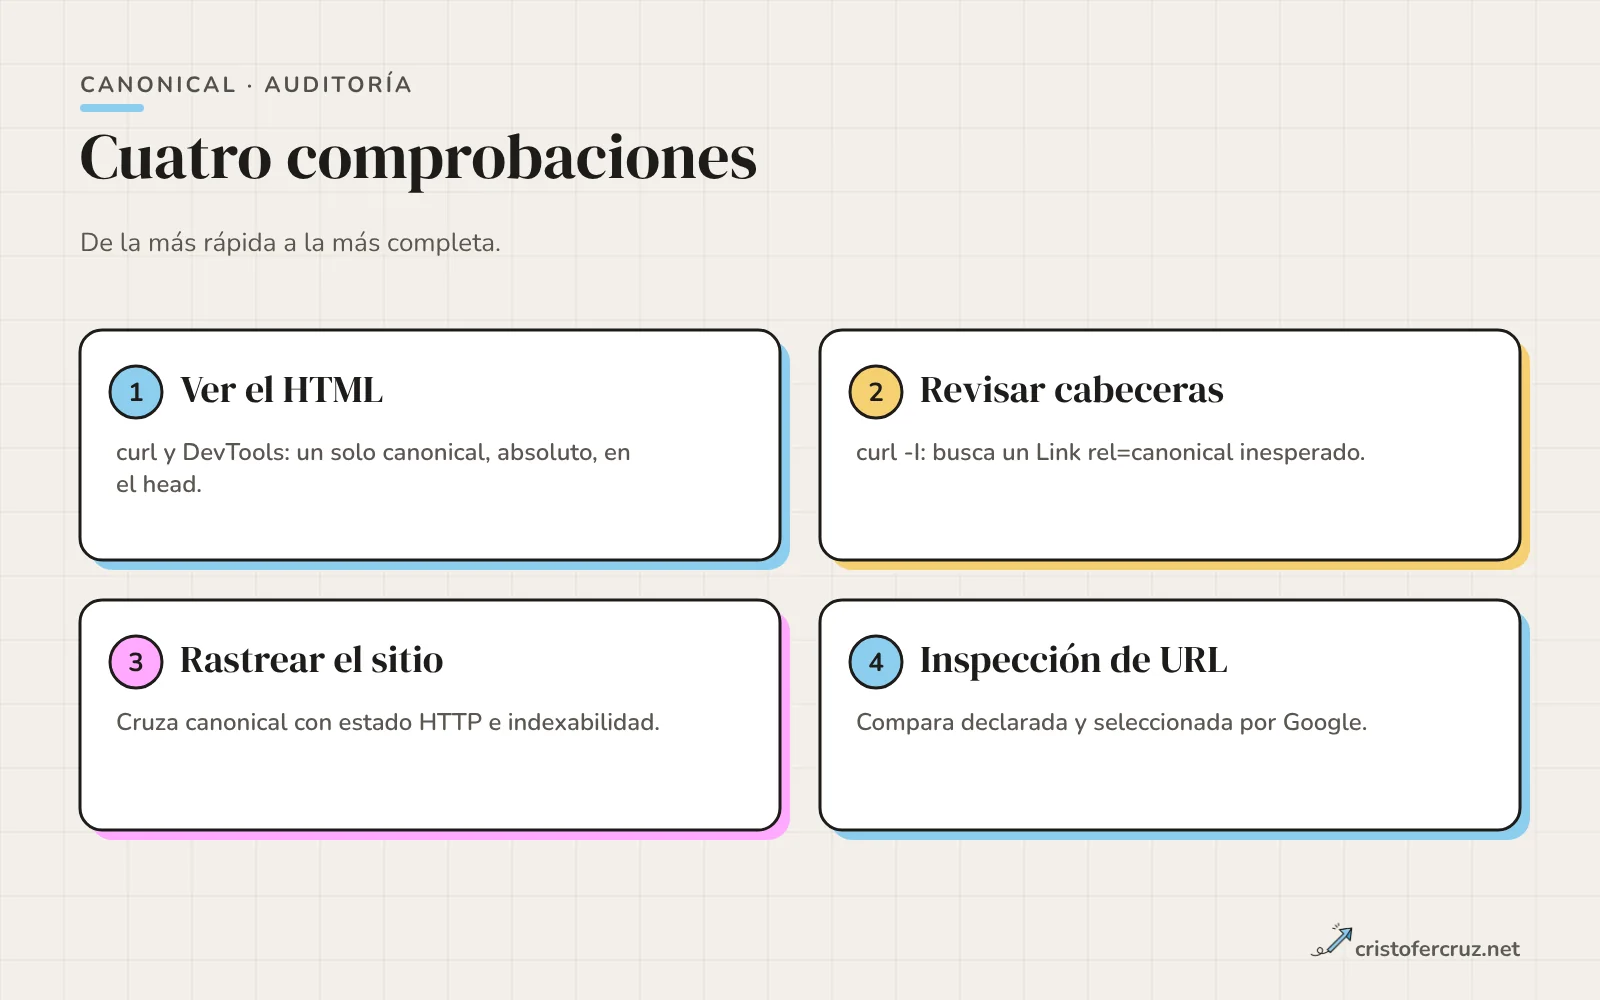
- Ver el HTML servido (
curl -s URL | grep -i canonical) y el renderizado en DevTools: deben coincidir, y debe haber un solo elemento. - Cabeceras con
curl -Ipara detectar unLink: rel="canonical"inesperado. - Rastrear el sitio y cruzar canonical con estado HTTP e indexabilidad: busca canónicas que apunten a 3xx, 4xx o
noindex. - Comparar el sitemap con los canonical declarados: toda URL del sitemap debería ser canónica de sí misma.
Tras corregir, Google indica que reevaluar un grupo de duplicados puede tardar hasta dos semanas. Solicitar indexación tiene cuota: guárdala para las URLs importantes.
Si Google elige una canónica distinta, antes de tocar la etiqueta mira si esa elección tiene sentido para el usuario. A veces la URL que has declarado es la equivocada.
Qué hacer esta semana
- Rastrea tu sitio y exporta el canonical de cada URL junto a su estado HTTP y su indexabilidad.
- Corrige los canonical que apunten a redirecciones, errores o páginas con
noindex. - Asegúrate de que hay un solo canonical absoluto por página, y de que el CMS y el plugin SEO no se pisan.
- Revisa que cada página paginada declara su propia URL y no la de la primera.
- Deja en el sitemap solo URLs canónicas con respuesta 200.
- Mira en Search Console las páginas con «Google eligió una canónica diferente» y decide caso a caso. Si necesitas ayuda, mira cómo hago consultoría SEO o escríbeme.
Preguntas frecuentes
¿Google siempre respeta el canonical?
No. Según su documentación es una pista, y puede elegir una página distinta. Se ve en Inspección de URL comparando la canónica declarada con la seleccionada por Google.
¿Necesita cada página un canonical autorreferencial?
Google recomienda incluirlo en la propia página canónica. No es obligatorio, pero protege frente a variantes con parámetros o barra final que no controlas.
¿Puedo usar canonical y noindex a la vez?
Es mejor evitarlo: son señales contradictorias, y Google no recomienda noindex para gestionar la elección de canónica dentro de un sitio. Si la página no debe indexarse usa noindex; si es un duplicado que debe consolidarse, canonical o 301.
¿Canonical o 301 para http y https?
Redirección 301. Las dos versiones no tienen por qué seguir accesibles, y la redirección es una señal fuerte. El canonical, además, debe declarar siempre la versión https.
¿Qué canonical lleva una página paginada?
El suyo propio. Google desaconseja usar la primera página de la secuencia como canónica del resto.
¿Puede apuntar un canonical a otro dominio?
Sí, pero sigue siendo una pista. Para sindicación, la documentación de Google indica que el elemento canonical no se recomienda para evitar duplicados con socios y que estos deberían bloquear la indexación.
¿Cuánto tarda Google en reflejar un cambio de canonical?
Google indica que reevaluar un grupo de duplicados puede tardar hasta dos semanas tras corregirlo. No hay un plazo garantizado.
Referencias y fuentes
Documentación consultada para este artículo.
- Cómo especificar una URL canónica con rel="canonical" y otros métodos Google Search Central
- What is URL canonicalization Google Search Central
- Fix canonicalization issues Google Search Central
- Pagination, incremental page loading and their impact on Google Search Google Search Central
- URL Inspection tool Ayuda de Search Console
- Page indexing report Ayuda de Search Console
- Canonical Tags Explained: Why They Matter For SEO Ahrefs
- Etiqueta canonical: todo lo que necesitas saber SE Ranking