hreflangno posiciona una página: le dice a Google qué versión de un mismo contenido enseñar según el idioma o la región del usuario.- Solo valen códigos de idioma ISO 639-1 y, opcionalmente, de región ISO 3166-1 alpha-2.
en-UKes un error clásico: el código correcto esen-GB. - Se puede declarar en el HTML, en una cabecera HTTP
Linko en el sitemap. Para Google son equivalentes: elige uno y no los mezcles. - Cada versión debe enlazar a todas las demás y a sí misma. Si A apunta a B y B no apunta a A, Google ignora las etiquetas.
- Cada URL del grupo debe tener un canonical coherente, en su propio idioma, y ser indexable. Un
noindexo una redirección dentro del grupo lo rompe. - Mi web es monolingüe:
hreflangno hace falta, y lo que emite hoy es inocuo pero no aporta nada medible.
El fallo habitual con hreflang no es no ponerlo: es ponerlo y que no haga nada. Una etiqueta sin enlace de vuelta, un código inventado o una URL que redirige bastan para que Google descarte la anotación sin avisarte, y el síntoma es que la versión mexicana de tu tienda sigue apareciendo en España.
Aquí explico qué problema resuelve, cómo se escribe cada código, las tres formas de implementarlo, las reglas de reciprocidad y canonical, cómo auditarlo ahora que Search Console ya no tiene informe de segmentación internacional y qué hay realmente en cristofercruz.net, que tiene un solo idioma.
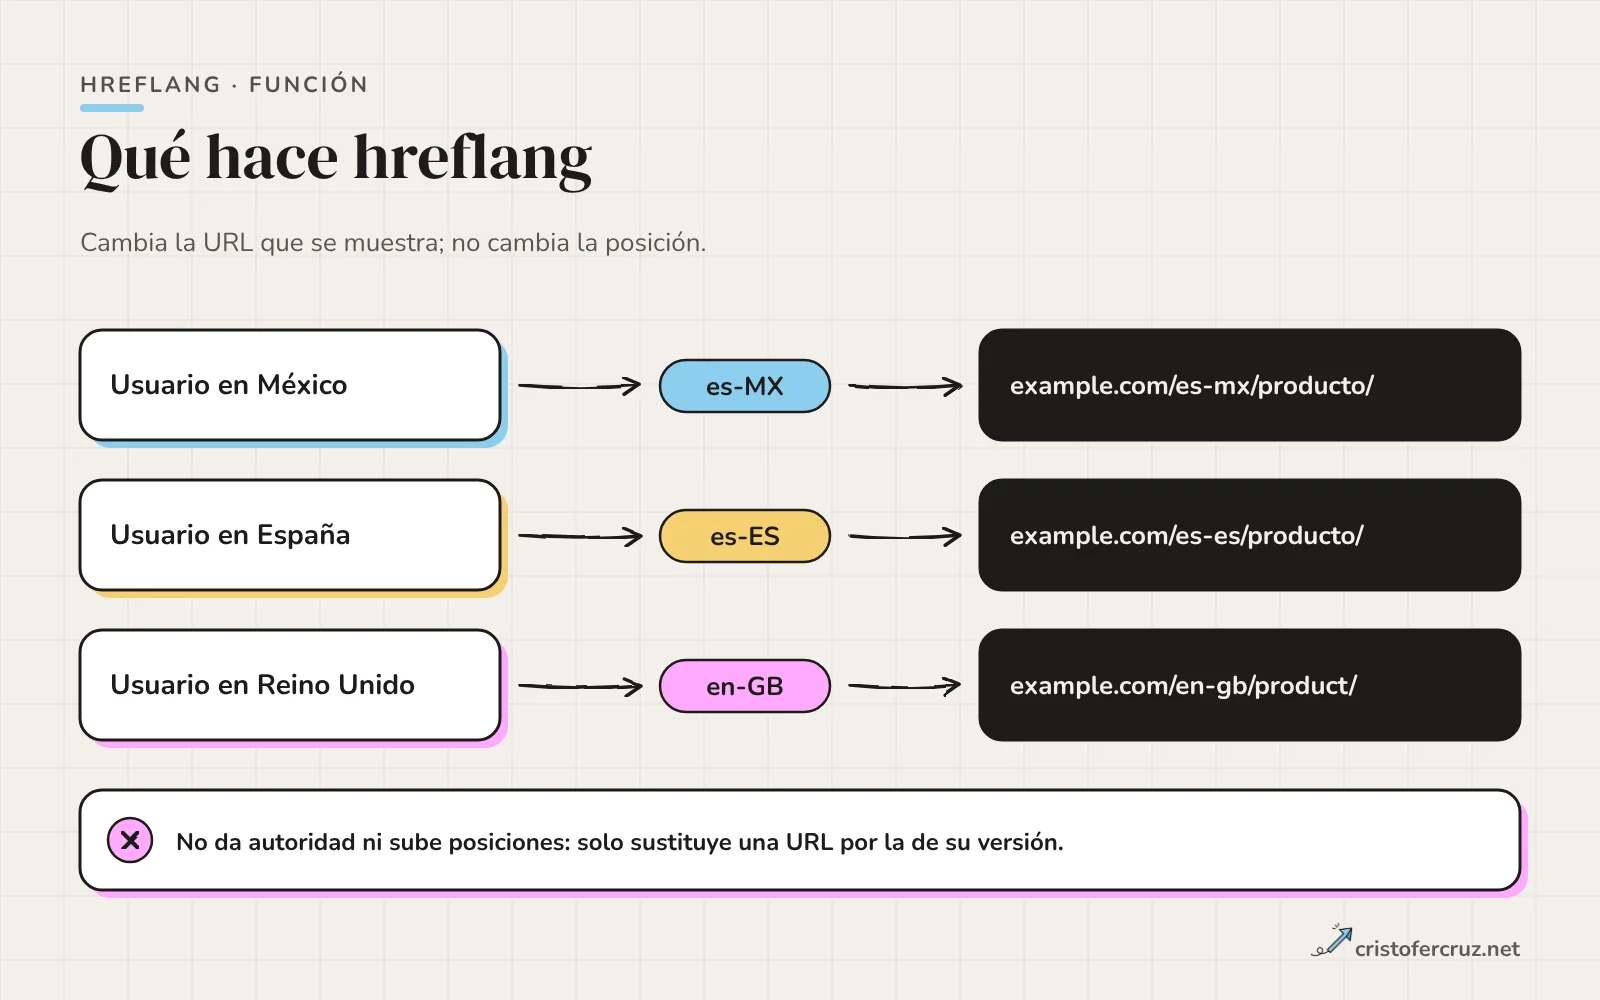
Qué hace hreflang y qué no hace
Según la documentación de Google, los sitios multilingües o multirregionales usan hreflang para indicar que varias páginas son variantes localizadas del mismo contenido. El objetivo documentado es que Google Search dirija a cada usuario a la versión más adecuada por idioma o región. Google también reconoce que puede encontrar las alternativas por su cuenta, pero recomienda declararlas.
De ahí salen tres consecuencias prácticas. La primera: hreflang no da autoridad ni empuja una URL hacia arriba, solo sustituye la URL que ya se iba a mostrar por la equivalente. Si tu versión en inglés no posiciona, hreflang no la arregla. La segunda: no sirve para detectar el idioma. Google lo dice expresamente: no usa hreflang ni el atributo lang del HTML para identificar el idioma de una página, lo hace con sus propios algoritmos (cómo afecta eso a los anglicismos del texto lo trato en préstamos lingüísticos en SEO). La tercera: no es una redirección. El usuario que llega por un enlace directo a la versión «equivocada» seguirá viéndola.
Encaja en tres situaciones que Google menciona: contenido principal en un solo idioma con partes traducidas, mismo idioma para distintos países (español de España y de México, por ejemplo) y sitio completamente traducido a varios idiomas. Si tu sitio no cae en ninguna, no hay nada que declarar.
Cuándo lo necesitas y cuándo no
Lo necesitas cuando existen, o van a existir, dos o más URLs con el mismo contenido para audiencias distintas. Un caso claro es una tienda con /es-es/ y /es-mx/ que difieren en moneda y envíos pero comparten casi todo el texto. Otro es un blog traducido al inglés y al italiano.
No lo necesitas si el sitio tiene un solo idioma y una sola audiencia, que es mi caso. Tampoco si dos páginas tratan cosas distintas aunque estén en idiomas diferentes: eso no son versiones, son contenidos diferentes. Y una traducción automática que nadie ha revisado, publicada solo para «cubrir» un idioma, es un riesgo de calidad que ninguna etiqueta soluciona.
Si dudas entre estructuras (ccTLD, subdominio o subcarpeta), eso es otra decisión (tengo una guía para decidir entre subdominio y subdirectorio): la documentación de Google sobre sitios multirregionales las compara, y hreflang funciona igual en todas. Lo trabajo en SEO internacional antes de tocar una sola etiqueta.
Códigos de idioma y región
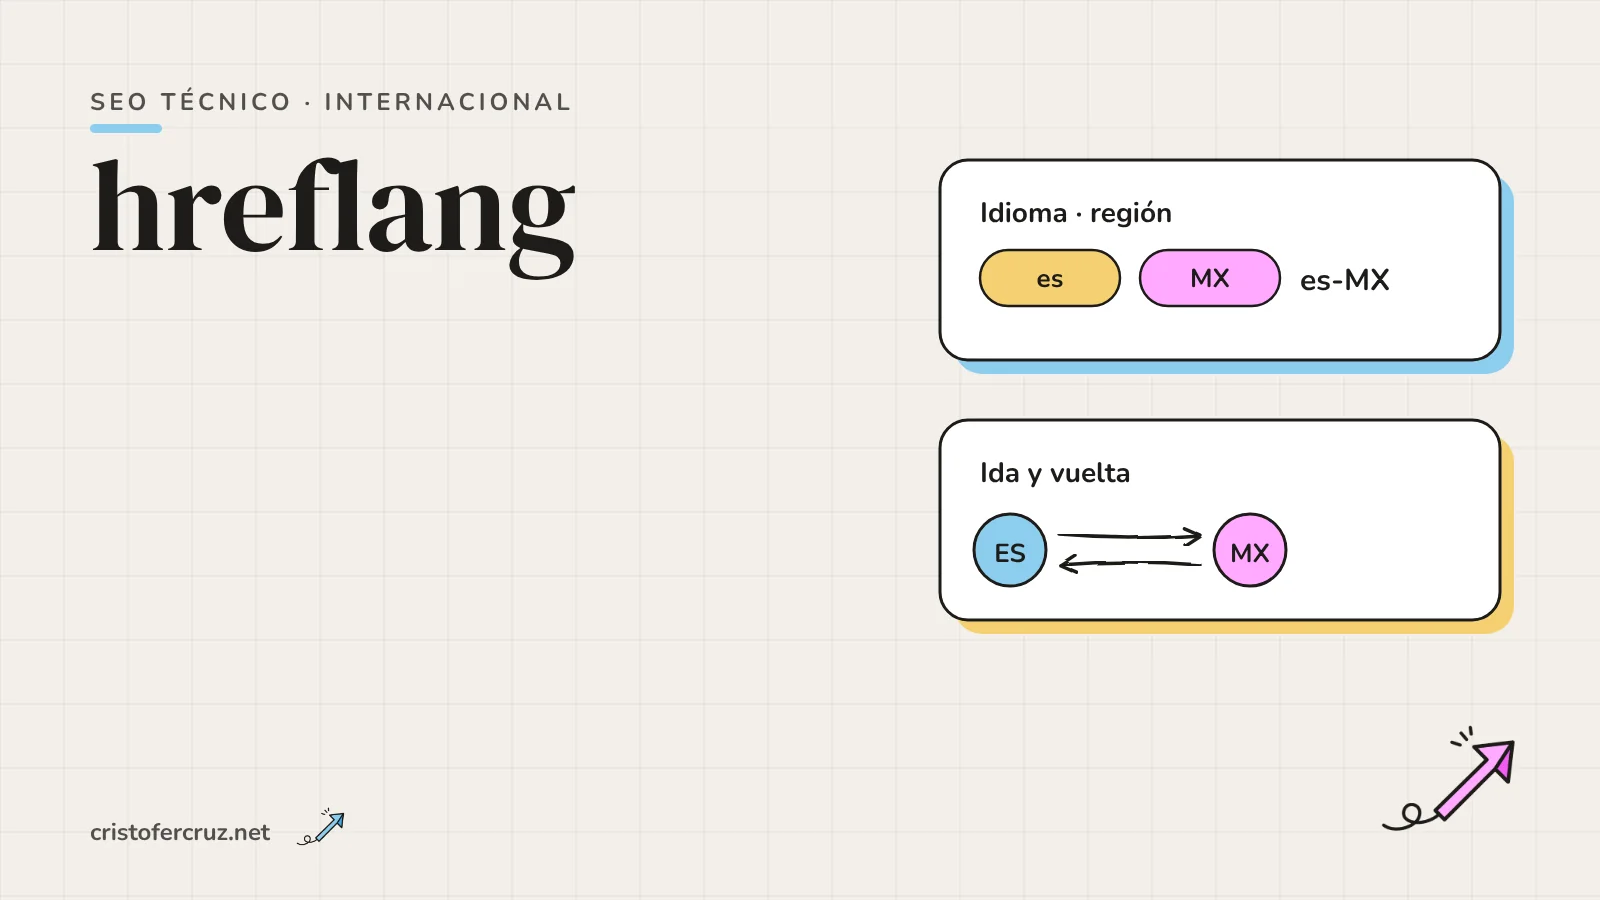
El valor de hreflang combina un idioma y, de forma opcional, una región. Google solo admite códigos de idioma ISO 639-1 (dos letras: es, en, it, pt) y códigos de región ISO 3166-1 alpha-2 (ES, MX, GB). Para escrituras distintas se pueden usar códigos ISO 15924, como zh-Hant y zh-Hans. Los valores no distinguen mayúsculas de minúsculas, aunque la convención es idioma en minúsculas y región en mayúsculas.
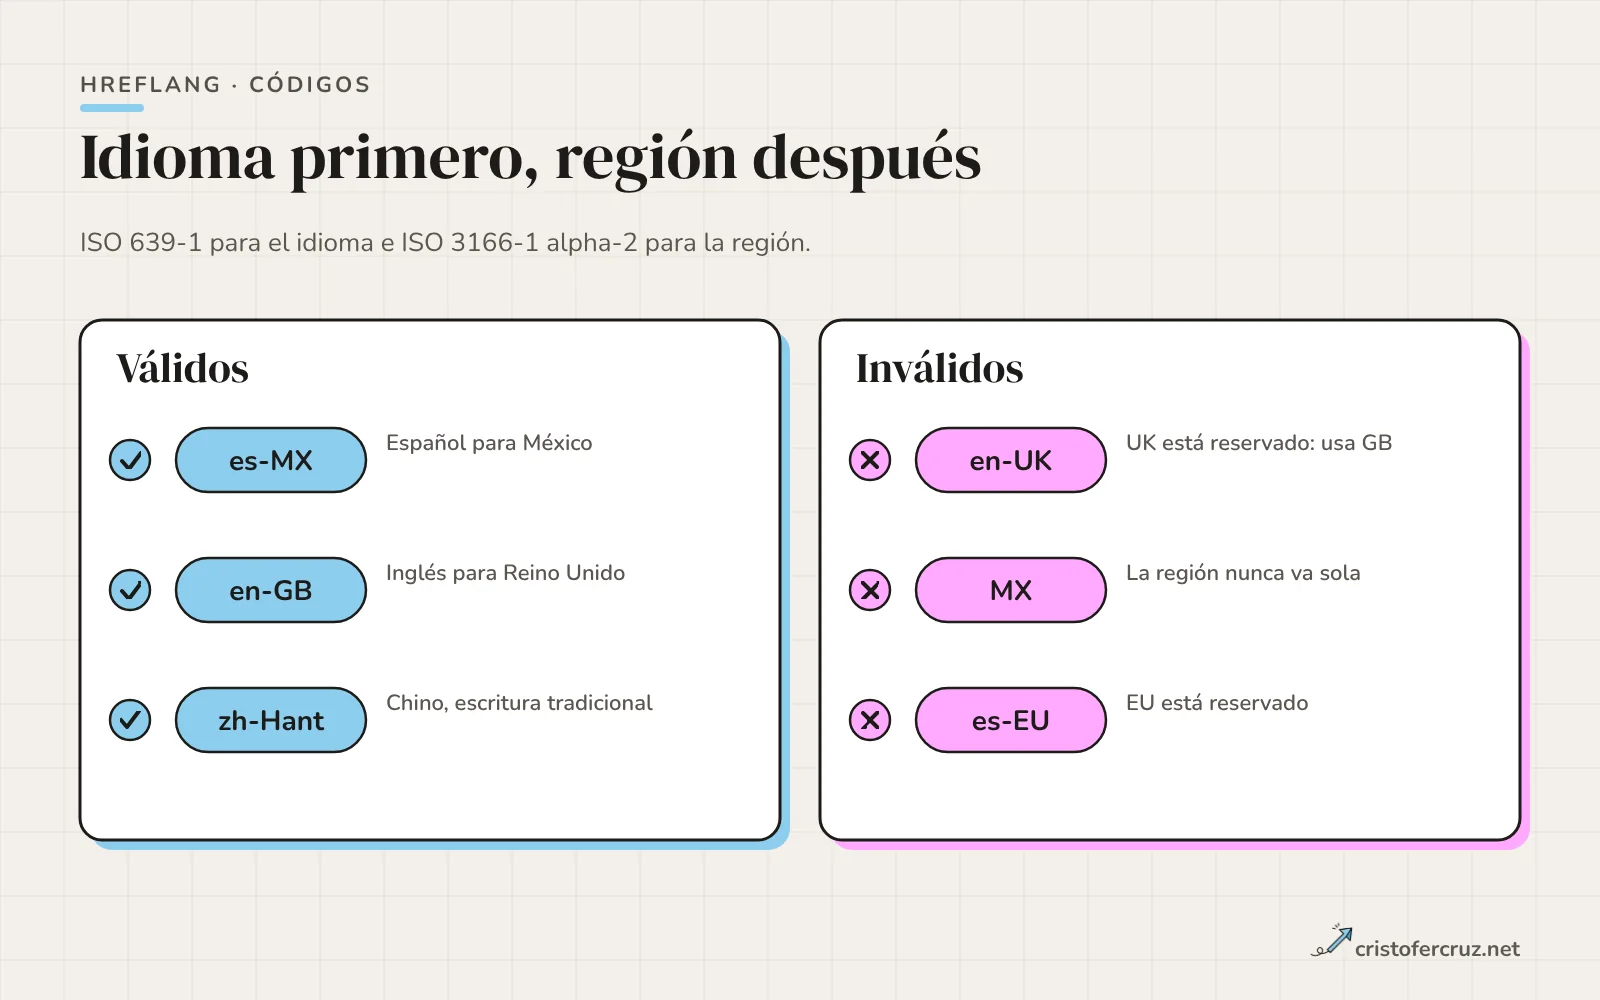
| Valor | ¿Válido? | Qué pasa |
|---|---|---|
es | Sí | Español, sin distinguir país |
es-MX | Sí | Español para México |
en-GB | Sí | Inglés para Reino Unido |
zh-Hant | Sí | Chino con escritura tradicional |
en-UK | No | UK es un código reservado sin efecto como región; el correcto es GB |
MX | No | Google no admite el código de país por sí solo |
es-EU | No | EU está reservado y no tiene efecto como región |
Una decisión de fondo que sale de estos códigos: ¿es o es-ES? Si tienes una sola versión en español para todos, es basta. Si tienes versiones separadas para España y México, usa es-ES y es-MX y decide si quieres además una genérica es para el resto de países hispanohablantes. Para eso último puedes apoyarte en x-default, que cubre los usuarios que no coinciden con ninguna versión.
Las tres formas de implementarlo
Google acepta tres métodos y, desde su punto de vista, son equivalentes: usar los tres a la vez no da ningún beneficio en Search. Lo razonable es escoger el que menos fricción tenga en tu stack.
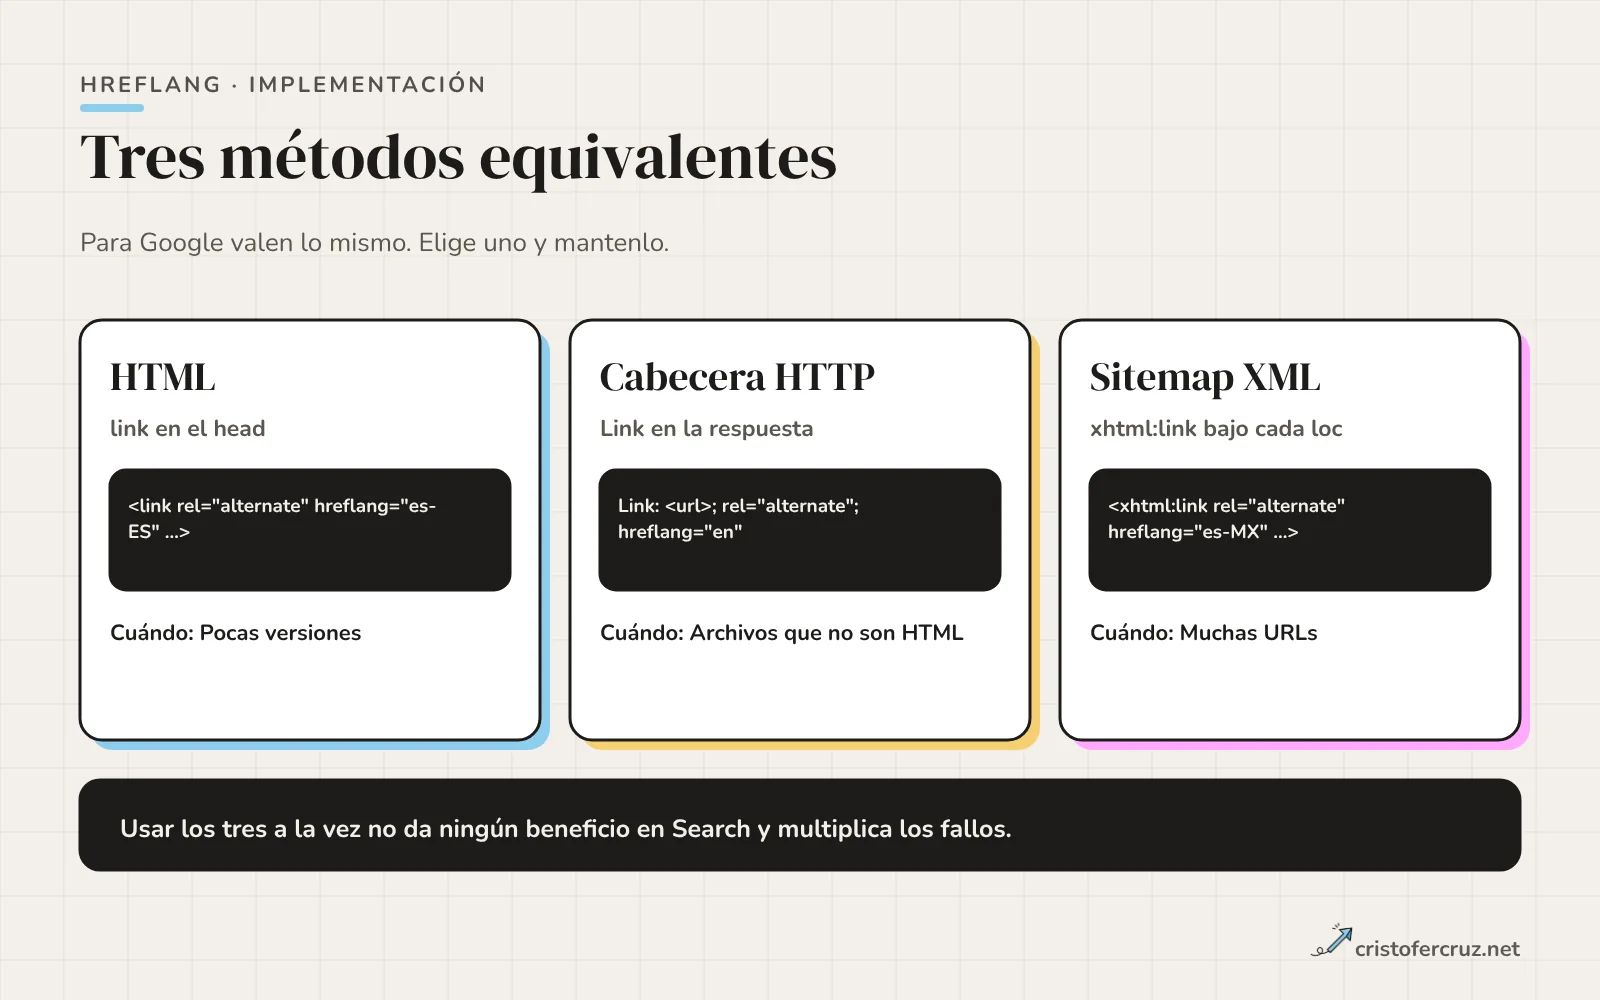
| Método | Dónde va | Cuándo encaja |
|---|---|---|
| HTML | <link> en el <head> | Webs con plantilla propia o CMS y pocas versiones |
| Cabecera HTTP | Link en la respuesta | Archivos que no son HTML, como PDF |
| Sitemap XML | xhtml:link bajo cada <loc> | Muchas URLs o muchas versiones: no engorda el HTML |
En el HTML
Una línea por versión, dentro de un <head> bien formado, con URL absoluta. Cada versión lleva el mismo bloque completo, incluida ella misma:
<link rel="alternate" hreflang="es-ES" href="https://example.com/es-es/producto/" />
<link rel="alternate" hreflang="es-MX" href="https://example.com/es-mx/producto/" />
<link rel="alternate" hreflang="en-GB" href="https://example.com/en-gb/product/" />
<link rel="alternate" hreflang="x-default" href="https://example.com/producto/" />
Google avisa de que no se debe combinar hreflang con otros atributos como media en la misma etiqueta. Y como son absolutas, hay que incluir el protocolo: las URL relativas a la raíz (/producto/) o al protocolo (//example.com/) no valen.
En la cabecera HTTP
Útil para ficheros donde no puedes tocar un <head>. Se declara todo en una sola cabecera Link:
Link: <https://example.com/file.pdf>; rel="alternate"; hreflang="en",
      <https://example.com/de/file.pdf>; rel="alternate"; hreflang="de"
En el sitemap
Dentro de cada <url> se listan todas las versiones, la propia incluida, con el espacio de nombres xhtml. Estos elementos no cuentan para el límite de URLs del sitemap:
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"
        xmlns:xhtml="http://www.w3.org/1999/xhtml">
  <url>
    <loc>https://example.com/es-es/producto/</loc>
    <xhtml:link rel="alternate" hreflang="es-ES" href="https://example.com/es-es/producto/" />
    <xhtml:link rel="alternate" hreflang="es-MX" href="https://example.com/es-mx/producto/" />
  </url>
  <url>
    <loc>https://example.com/es-mx/producto/</loc>
    <xhtml:link rel="alternate" hreflang="es-ES" href="https://example.com/es-es/producto/" />
    <xhtml:link rel="alternate" hreflang="es-MX" href="https://example.com/es-mx/producto/" />
  </url>
</urlset>
Con cientos de URLs por versión, el sitemap suele ganar: se genera desde la base de datos y no depende de que cada plantilla pinte bien el <head>. Si no tienes claro cómo montarlo, tengo una guía sobre sitemaps XML. Para PDF u otros archivos, la cabecera es la única opción práctica.
Reciprocidad: los enlaces de vuelta
La regla que más tumba implementaciones es esta: si dos páginas no se apuntan entre sí, las etiquetas se ignoran. Si tu página en español declara una alternativa en inglés, la página en inglés tiene que declarar la de español. No basta con que lo haga una de las dos.
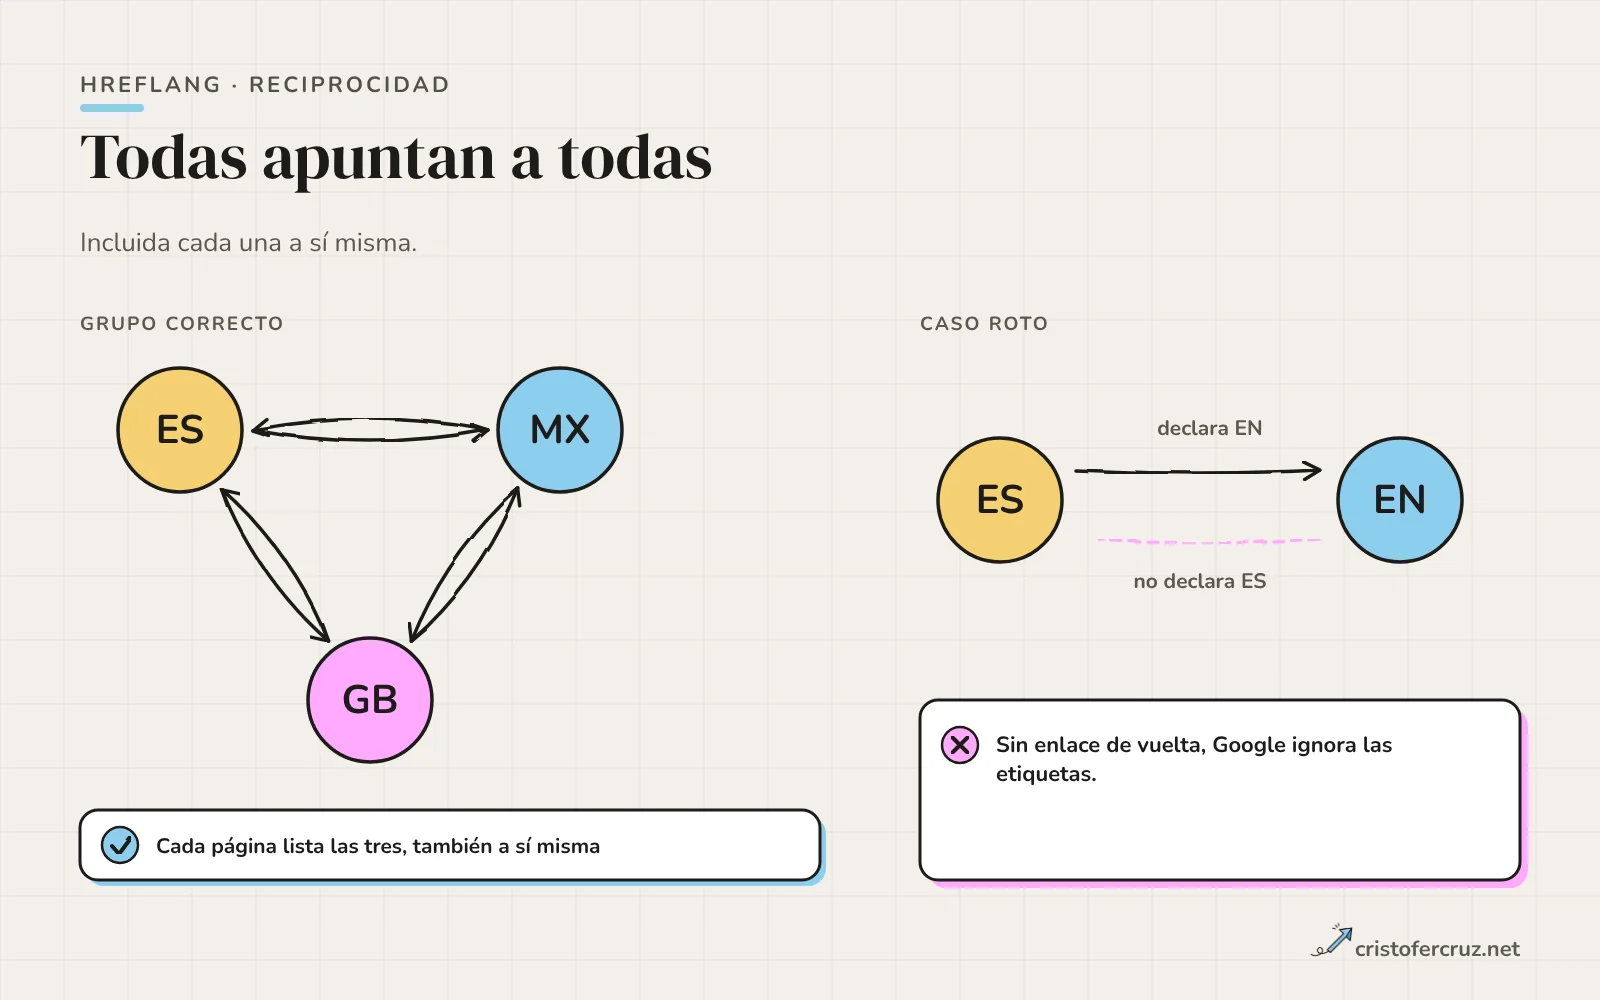
La segunda parte de la regla es la autorreferencia: cada versión debe listarse a sí misma además de a las demás, y el conjunto de anotaciones debe ser idéntico en todas las páginas del grupo. En el sitemap, cada <url> incluye su propia dirección entre los xhtml:link.
El fallo de reciprocidad aparece de forma natural al añadir una versión nueva: se actualiza la plantilla de la nueva y se olvida actualizar las antiguas. Con tres versiones son nueve anotaciones (3 por página); con seis, treinta y seis. Cuanto más crece el grupo, menos viable es mantenerlo a mano, y por eso conviene que salga de una sola fuente de datos.
Canonical coherente con hreflang
El canonical y hreflang hacen cosas distintas y deben decir lo mismo. La documentación de Google sobre consolidación de URLs duplicadas indica que, si usas hreflang, cada página localizada debe tener como canonical una página en su mismo idioma, o la mejor sustituta si no existe. También aclara que las anotaciones rel="canonical" con atributos hreflang, lang, media o type no se usan para canonicalizar: para idioma y país se usa rel="alternate" con hreflang.
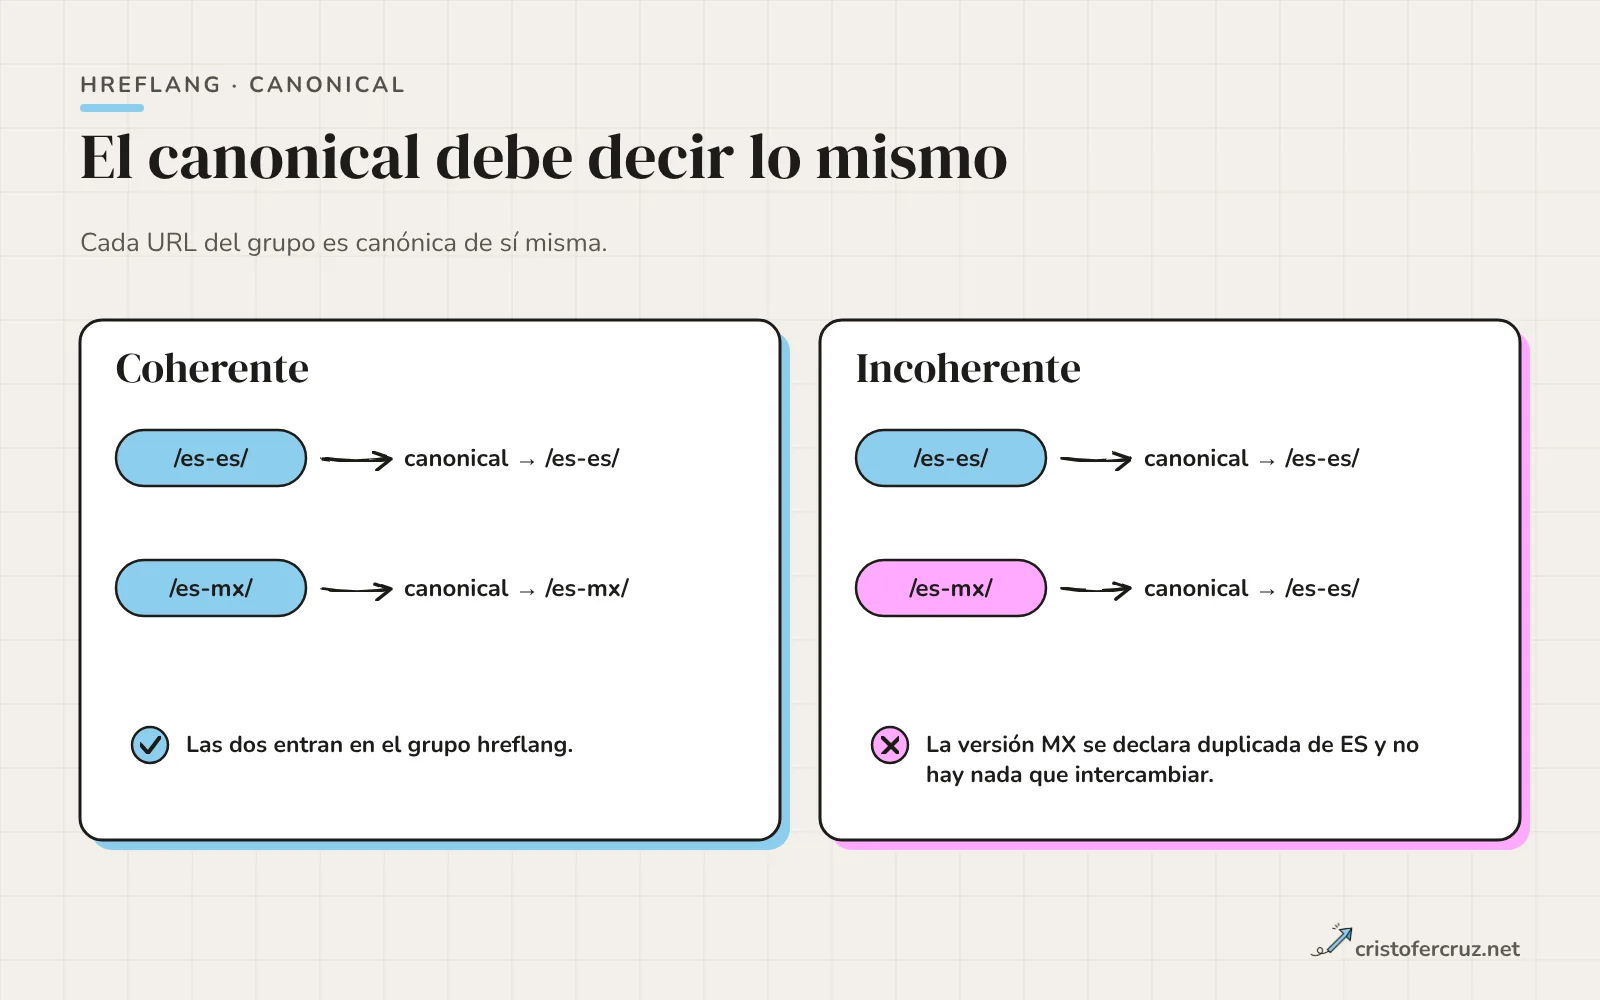
El error típico: una web copia la versión de España en /es-mx/, cambia el precio y, por pereza o por miedo al contenido duplicado, deja el canonical apuntando a /es-es/. Resultado: la URL mexicana se declara duplicada de otra y hreflang no tiene nada que intercambiar. Si las dos versiones son muy parecidas, Google recomienda elegir una preferida y usar canonical y hreflang para servir la URL correcta, y señala que las páginas localizadas solo cuentan como duplicadas si el contenido principal queda sin traducir.
La misma guía añade un matiz útil: Google prefiere, al elegir canónica, URLs que forman parte de grupos hreflang recíprocos. Es decir, un grupo bien hecho ayuda también a que se elija la versión que tú quieres. Para el resto de reglas de canonical, tienes el artículo sobre canonicals.
Antes de publicar una versión nueva, pregúntate si su canonical apunta a sí misma, si la URL responde 200 y si no lleva noindex. Esas tres condiciones evitan la mayoría de los grupos rotos.
Errores típicos
La mayoría de los problemas con hreflang se repiten en todos los proyectos. Estos son los que se repiten con más frecuencia:
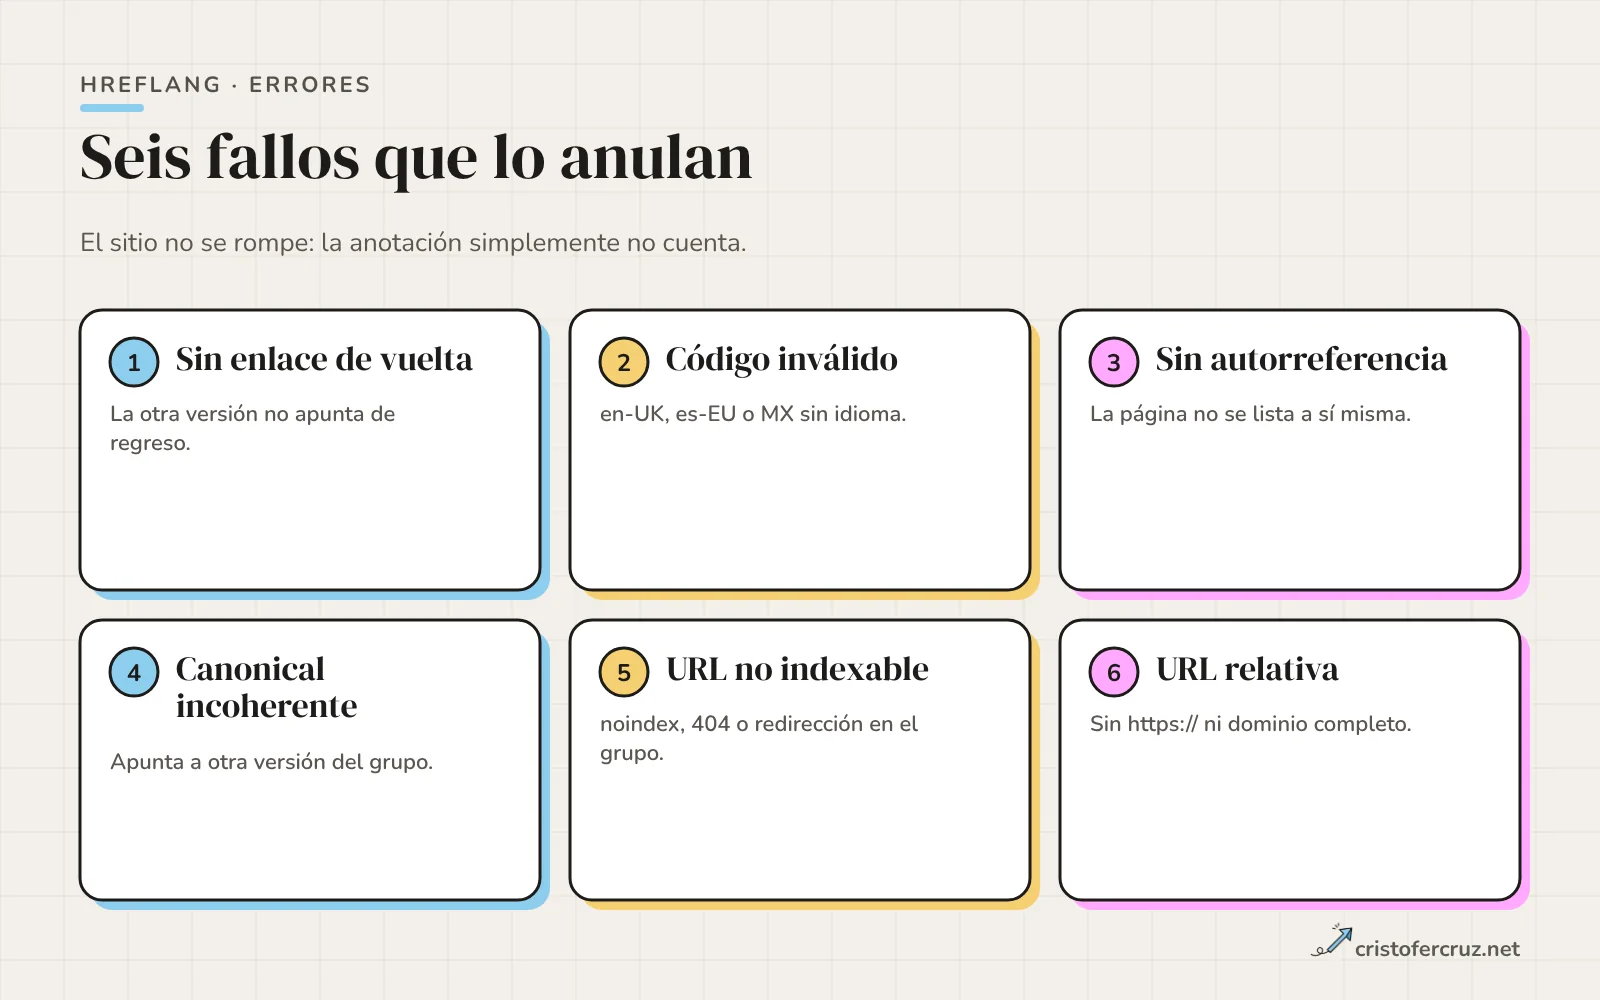
| Error | Ejemplo | Corrección |
|---|---|---|
| Falta enlace de vuelta | La página EN apunta a ES, pero ES no apunta a EN | Generar el grupo completo en todas las URLs |
| Código inválido | en-UK, es-EU, MX | en-GB, es-ES, es-MX |
| Sin autorreferencia | La página no se incluye en su propio listado | Añadir la propia URL con su código |
| Canonical incoherente | La versión MX canonicaliza a ES | Canonical de cada URL a sí misma |
| URL no indexable | Alternativa con noindex, 404 o redirección | Listar solo URLs finales, 200 e indexables |
| URL relativa o sin protocolo | href="/en/" | URL absoluta completa con https:// |
De la lista, el de las URLs no indexables es el que menos se ve. La documentación de Google no trata el noindex dentro de un grupo hreflang, pero sí avisa de que usar noindex para elegir canonical dentro de un mismo sitio bloquea la página por completo en Search. Si una versión sale de los resultados, el grupo queda cojo. Lo mismo pasa si un bloqueo en robots.txt impide rastrear una de las alternativas: Google no podrá leer sus etiquetas. La documentación recomienda además listar la versión HTTPS, no la HTTP, y lo mismo vale para www y la barra final: cada alternativa debe ser la URL exacta a la que responde el servidor, sin redirigir.
Otro fallo, de arquitectura más que de etiquetas: redirigir automáticamente al usuario según su IP o su idioma. Google desaconseja redirigir por idioma supuesto porque puede impedir que usuarios y rastreadores vean todas las versiones, y recomienda enlaces visibles para elegir idioma o región. Los rastreadores de Google proceden en su mayoría de Estados Unidos y no varían su ubicación para descubrir versiones, así que las variantes hay que declararlas de forma explícita.
Cómo auditar hreflang
El Search Console antiguo tenía un informe de segmentación internacional que mostraba errores de hreflang. Ese informe está retirado: Google anunció su baja el 24 de agosto de 2022 y la fijó para el 22 de septiembre de 2022, según Search Engine Land. La ayuda de Search Console dice solo que el informe está obsoleto y que Google sigue admitiendo hreflang; no ofrece un sustituto para esos errores. Por tanto, hoy la auditoría depende de tus propias comprobaciones.
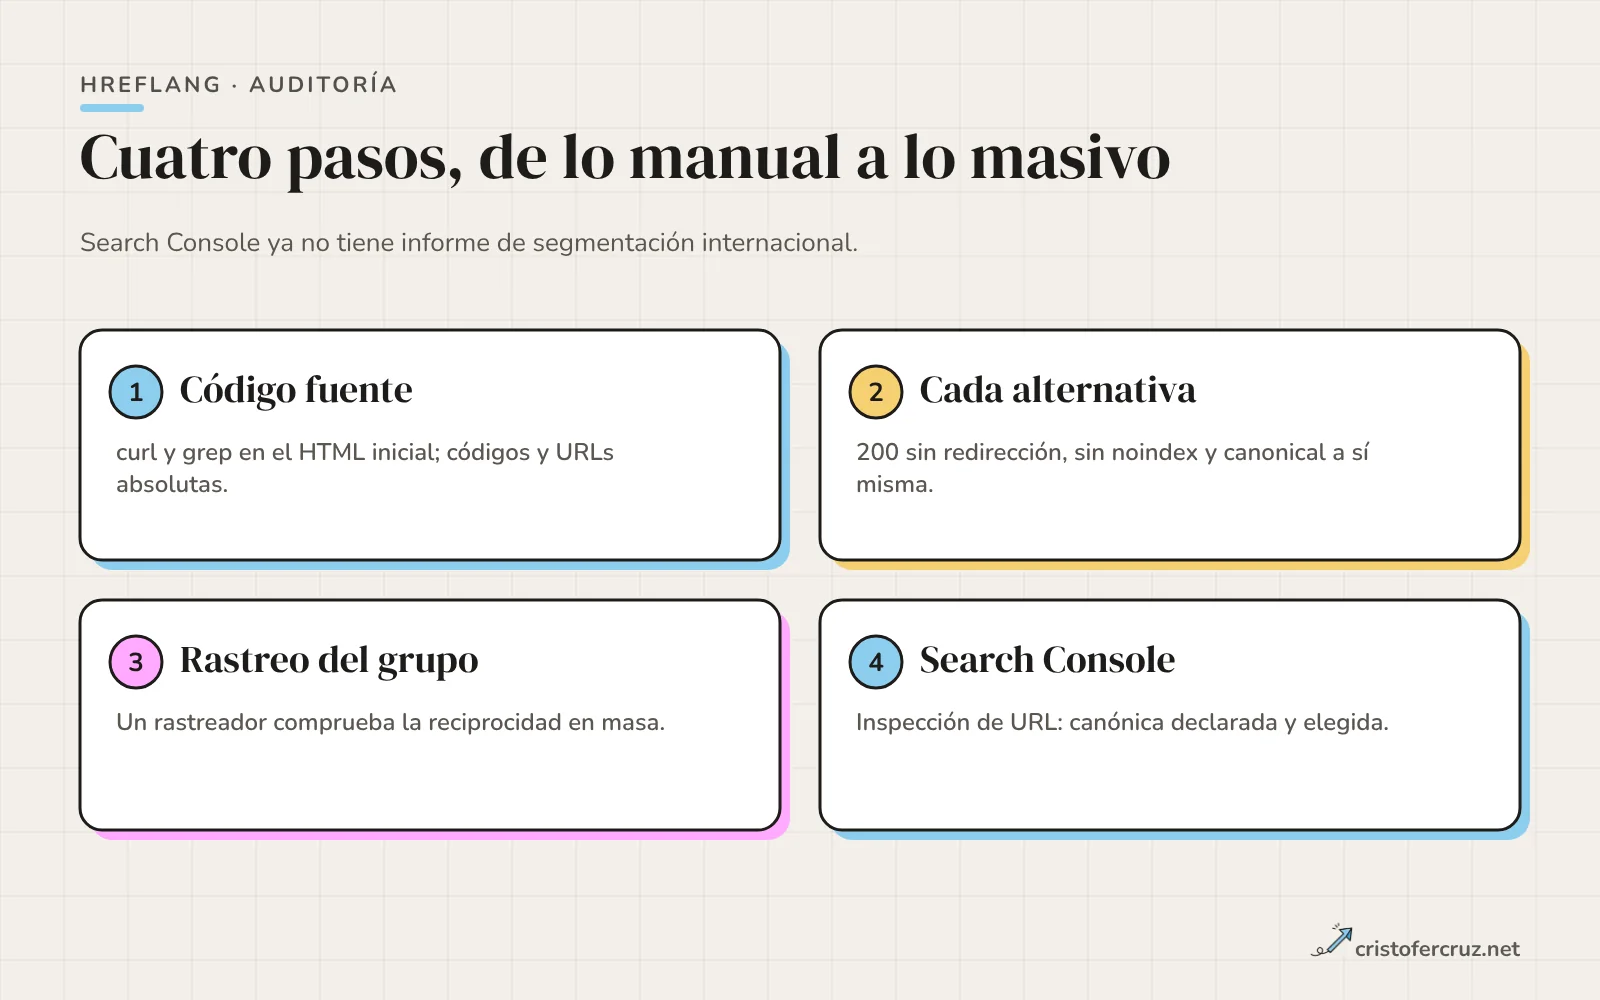
- Mira el código fuente. Busca
hreflangen el HTML inicial, no en el DOM renderizado, y comprueba que los códigos son válidos y las URLs absolutas. Concurl -s URL | grep -i hreflanglo ves en segundos, ycurl -sI URL | grep -i '^link'te dice si hay cabecera. - Abre cada alternativa. Confirma que responde 200 sin redirigir, que no lleva
noindexy que su canonical apunta a sí misma. Es un trabajo mecánico, y aquí se detectan los errores de la tabla anterior. - Rastrea el conjunto. Pasadas unas pocas URLs, un rastreador de SEO técnico es lo único viable para verificar reciprocidad masiva. Revisa que todas las páginas del grupo tengan las mismas anotaciones.
- Contrasta con Search Console. La inspección de URL muestra la canónica que declaras y la que ha elegido Google. Si Google elige otra distinta de la tuya, el grupo no se está leyendo como esperabas.
No tengo una comprobación fiable de cómo reporta Search Console hoy los fallos de hreflang en sus informes de indexación, y no he encontrado documentación oficial que lo describa. Si lo vas a necesitar para un cliente, pruébalo con un caso roto controlado antes de fiarte.
Compara el grupo desde dos puntos: la URL de cada versión y el sitemap. Si declaras en HTML y en sitemap y no coinciden, Google tiene dos fuentes contradictorias. Mantén una sola.
Cómo lo trato en mi web
Esta sección describe lo que hay en el código de cristofercruz.net, que revisé al escribir este artículo. Mi web está en un solo idioma, español, y no tiene versiones por país. El HTML declara <html lang="es">.
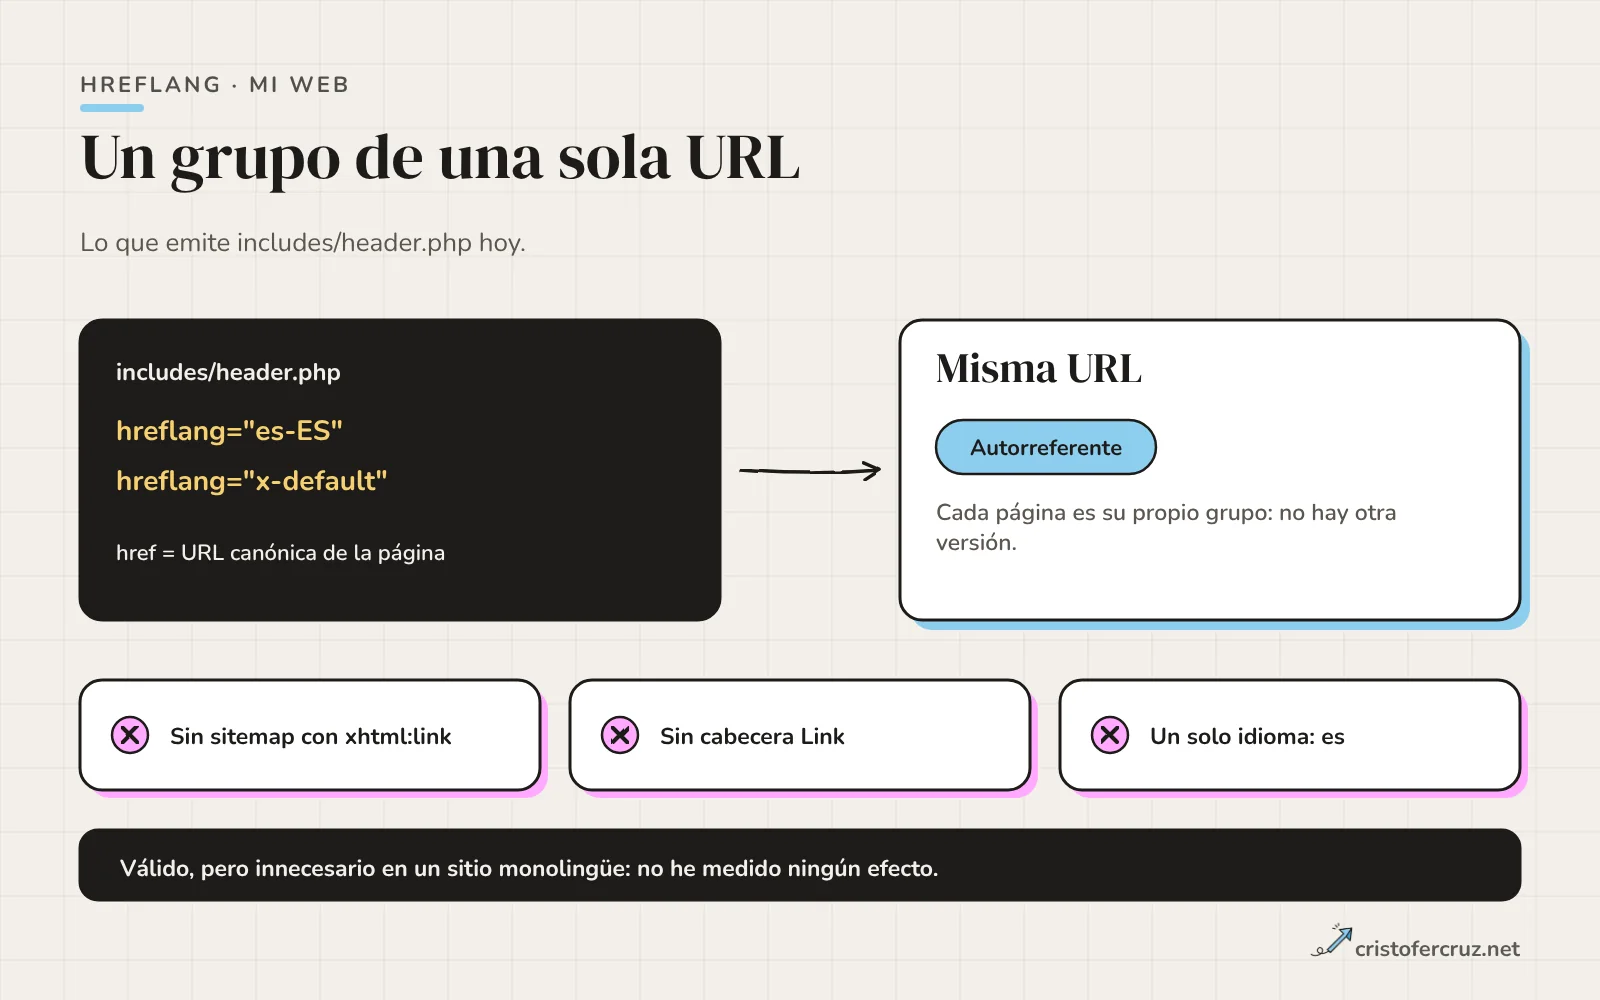
La cabecera común (includes/header.php) emite, en todas las páginas con el diseño actual, dos etiquetas:
<link rel="alternate" hreflang="es-ES" href="[URL canónica de la página]">
<link rel="alternate" hreflang="x-default" href="[URL canónica de la página]">
Las dos apuntan a la misma URL que el canonical de esa página, de modo que cada página es su propio grupo de uno: se referencia a sí misma, y no hay otra versión a la que enlazar. En el blog paginado, la URL del hreflang coincide con el canonical de la página concreta del listado, porque ambas salen de la misma variable.
¿Es correcto? Es válido, pero innecesario. Un grupo de una sola URL cumple las reglas (autorreferencia y coherencia con el canonical) y no puede romperse por falta de reciprocidad, pero tampoco cambia nada: no hay ninguna versión que intercambiar. Google documenta hreflang para cuando existen variantes localizadas, y yo no tengo ninguna. No he medido ningún efecto, positivo ni negativo, de estas etiquetas, así que no puedo defender que aporten algo.
Hay un detalle menor que he visto al leer el código: la página 404, que lleva noindex, nofollow y cabecera X-Robots-Tag, también emite las dos etiquetas, y las dirige a la portada porque su canonical está forzado a la home. No rompe nada, pero es un ejemplo de por qué conviene que la lógica de hreflang no se pinte a ciegas en todas las plantillas.
| Aspecto | En mi web |
|---|---|
| Idiomas y regiones | Solo español |
| Método | HTML, en la cabecera común |
| Códigos emitidos | es-ES y x-default |
| Destino | La propia URL canónica de cada página |
Sitemap con xhtml:link | No |
Cabecera Link para hreflang | No |
Si algún día añadiera una versión en inglés, habría que sustituir esa lógica: cada página debería listar sus equivalentes reales, y solo las que existan. Hasta entonces, la decisión más limpia sería quitarlas. Si decides mantenerlas, deben seguir una regla simple: que apunten siempre a la URL canónica de esa página. El papel del x-default en un caso como este lo trato en el artículo sobre x-default.
¿Y otros buscadores?
Todo lo anterior es la documentación de Google. No he verificado en documentación oficial qué hacen otros buscadores con hreflang, así que no doy por hecho que lo lean igual. Si tu mercado depende de otro buscador, mira su documentación antes de invertir en una implementación basada solo en las reglas de Google.
Pasos antes de publicar un grupo hreflang
- Lista las URLs del grupo y confirma que todas responden 200, sin redirección y sin
noindex. - Asigna un código válido a cada una (ISO 639-1 y, si hace falta, ISO 3166-1 alpha-2) y decide si habrá
x-default. - Genera el mismo bloque completo en todas, incluida cada URL a sí misma, desde una sola fuente de datos.
- Comprueba que el canonical de cada URL apunta a sí misma, con las mismas variantes de protocolo,
wwwy barra final. - Elige un único método (HTML, cabecera o sitemap) y retira los demás.
- Rastrea el conjunto y revisa la reciprocidad; después, inspecciona dos o tres URLs en Search Console.
Si necesitas que alguien lo revise o lo diseñe contigo, escríbeme desde la página de contacto y lo vemos con tus URLs delante.
Preguntas frecuentes sobre hreflang
¿hreflang mejora el posicionamiento?
No directamente. Según la documentación de Google, sirve para que Search dirija a los usuarios a la versión más adecuada por idioma o región. No añade autoridad a ninguna URL: cambia cuál se muestra, no cuánto posiciona.
¿Es es-ES o es-es?
Los valores no distinguen mayúsculas de minúsculas para Google. La convención es idioma en minúsculas y región en mayúsculas, es decir, es-ES, y es lo que conviene mantener por claridad.
¿Puedo usar solo el código de país, como MX?
No. Google indica que no se puede especificar el código de país por sí solo: el idioma es obligatorio y la región, opcional. Para México en español, es-MX.
¿Por qué en-UK no funciona?
Porque UK no es el código ISO 3166-1 alpha-2 de Reino Unido, que es GB. Google lista UK entre los códigos reservados que no tienen efecto como región. Usa en-GB.
¿Qué método es mejor: HTML, cabecera o sitemap?
Para Google son equivalentes. El HTML es cómodo con pocas versiones, el sitemap escala mejor con muchas URLs y la cabecera Link sirve para archivos que no son HTML, como PDF. Usar los tres a la vez no da ningún beneficio y multiplica los puntos que pueden desincronizarse.
¿Hace falta hreflang en un sitio con un solo idioma?
No. Está pensado para sitios con variantes localizadas del mismo contenido. En un sitio monolingüe, una anotación autorreferente cumple las reglas pero no cambia el resultado.
¿Qué pasa si falta un enlace de vuelta?
Según Google, si dos páginas no se apuntan entre sí, las etiquetas se ignoran. Todas las versiones deben listar a todas las demás y a sí mismas, con el mismo conjunto de anotaciones.
Referencias
- Tell Google about localized versions of your page Google Search Central
- Managing multi-regional and multilingual sites Google Search Central
- What is URL canonicalization Google Search Central
- The International Targeting report is deprecated Ayuda de Search Console
- Google Search Console to remove International Targeting report Search Engine Land
- Etiquetas hreflang en SEO: qué es, implementación y errores Wanatop
- Hreflang SEO: qué es y cómo implementarlo correctamente Borja Aranda