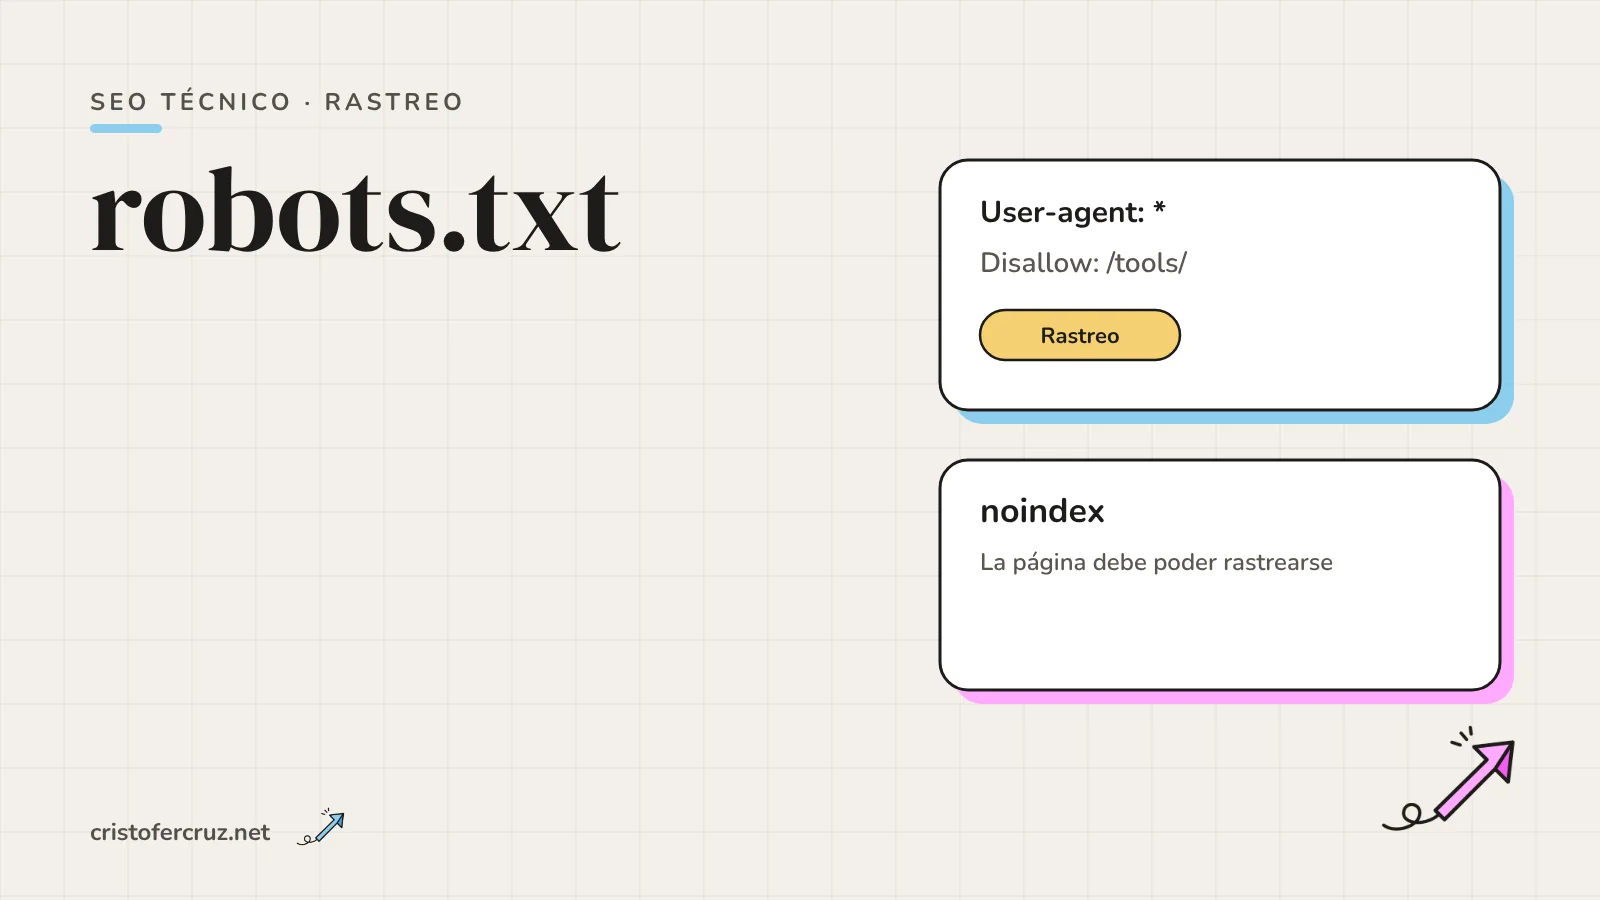
- robots.txt controla qué URLs puede rastrear un bot. No controla qué se indexa: una URL bloqueada puede aparecer en Google sin descripción si otras webs la enlazan.
- Para sacar una página de los resultados hace falta
noindex, y para que Google lo lea la página no puede estar bloqueada en robots.txt. - Cada bot obedece un solo grupo: el de su
User-agentmás específico. Los grupos no se suman con el grupo*. - Google lee hasta 500 KiB, guarda el archivo normalmente hasta 24 horas y solo reconoce
user-agent,allow,disallowysitemap. - Para los bots de IA hay que decidir por separado entrenamiento, búsqueda y visitas iniciadas por un usuario, y robots.txt no cubre siempre las tres.
- Se prueba con el informe de robots.txt de Search Console, la inspección de URL y una petición directa al archivo.
El error más caro con robots.txt es creer que sirve para quitar páginas de Google. Se bloquea una carpeta con Disallow, las URLs siguen apareciendo en los resultados con un título pelado y nadie entiende por qué. La causa es que el archivo gestiona el acceso del rastreador, no el contenido del índice.
Aquí separo lo que robots.txt hace de lo que no, explico cómo se leen los grupos, los comodines y los límites de Google, qué conviene hacer con los bots de IA y cómo comprobarlo. Termino con el archivo real de cristofercruz.net, línea a línea y con sus decisiones discutibles.
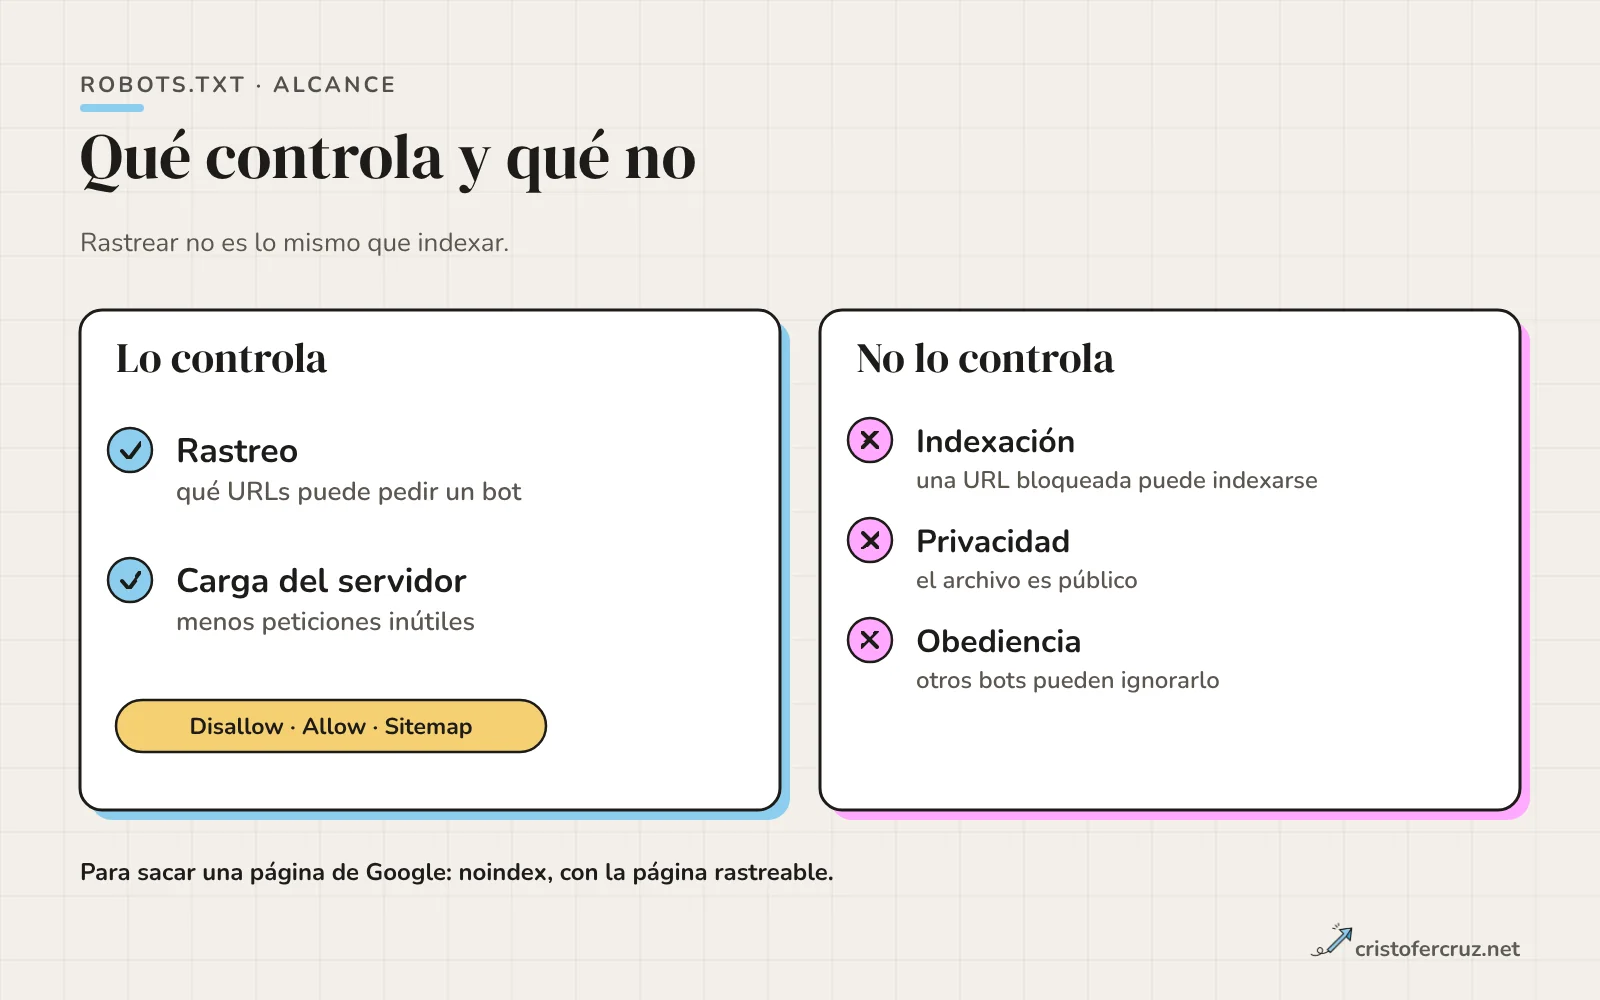
Qué controla robots.txt y qué no
Según la documentación de Google, robots.txt indica a los rastreadores a qué URLs de tu sitio pueden acceder. Sirve sobre todo para no sobrecargar el servidor con peticiones y para no gastar presupuesto de rastreo en páginas repetitivas o sin valor. Nada más.
| Quieres… | ¿Sirve robots.txt? | Qué usar |
|---|---|---|
| Que Googlebot no pida ciertas URLs | Sí | Disallow |
| Que una página no salga en Google | No | noindex (meta robots o X-Robots-Tag) o contraseña |
| Proteger información sensible | No | Autenticación en el servidor |
| Obligar a un bot a obedecer | No | Bloqueo en servidor o firewall |
| Reducir carga de rastreo de URLs inútiles | Sí | Disallow con patrones |
Google es claro con dos advertencias. La primera: una página bloqueada puede seguir apareciendo en los resultados si otras webs la enlazan; saldrá la URL y, a veces, el texto del enlace, pero sin descripción. La segunda: Googlebot y los rastreadores fiables respetan el archivo, pero otros pueden ignorarlo, así que no es un mecanismo de seguridad. Además, un archivo público es una lista de las rutas que no quieres que se vean.
Rastreo e indexación son pasos distintos
Rastrear es descargar una URL. Indexar es decidir si se guarda y se puede mostrar. Google puede indexar una URL que nunca ha descargado, solo con la información de los enlaces que apuntan a ella. Por eso Disallow no vacía el índice.
Por qué no puedes combinar Disallow y noindex
Si bloqueas una URL en robots.txt, Google no puede descargarla, y si no la descarga no ve su noindex. La documentación de la etiqueta robots lo dice así: la información sobre reglas de indexación o de servicio «will not be found and will therefore be ignored», y las URLs que contienen esas reglas no pueden estar bloqueadas para el rastreo.
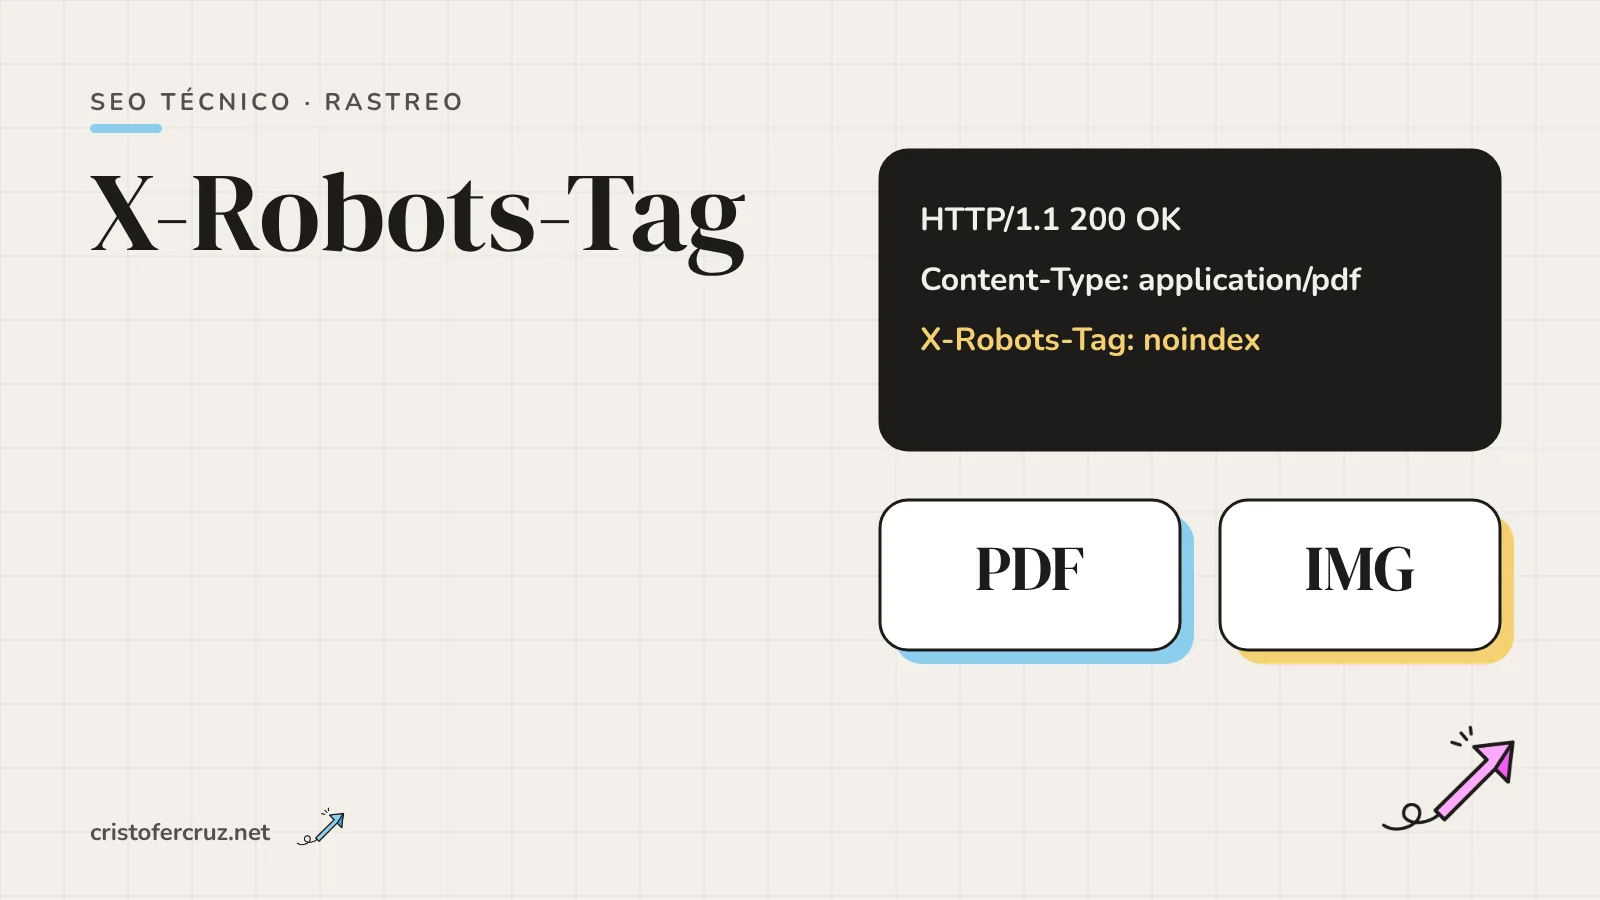
El orden correcto para sacar una sección del índice es: dejarla rastreable, añadir noindex, esperar a que Google la vuelva a visitar y, solo entonces, si hace falta, bloquear el rastreo. Tampoco metas noindex dentro de robots.txt: no está entre los campos que Google soporta en ese archivo. Para PDF e imágenes, donde no hay <head>, el noindex se envía con la cabecera X-Robots-Tag. Si quieres profundizar en lo que ocurre cuando se mezclan señales, lo trabajo también en la auditoría SEO.
Antes de añadir un Disallow pregunta si esas URLs ya están indexadas. Si lo están y quieres que desaparezcan, bloquear primero las deja en el índice sin forma de que Google vea que deberían salir.
Dónde vive el archivo y cómo lo trata Google según la respuesta HTTP
El archivo debe estar en la raíz del host y llamarse exactamente robots.txt. Las reglas solo valen para el host, el protocolo y el puerto donde está alojado: https://example.com/robots.txt no gobierna a https://blog.example.com/ ni a http://example.com/. Un robots.txt dentro de una subcarpeta no es válido. Por eso elegir entre subdominio o subdirectorio decide también cuántos archivos tendrás que mantener. Google lo pide con una petición GET no condicional.
Lo que ocurre cuando el archivo falla es lo que más sorprende, y conviene tenerlo en una tabla.
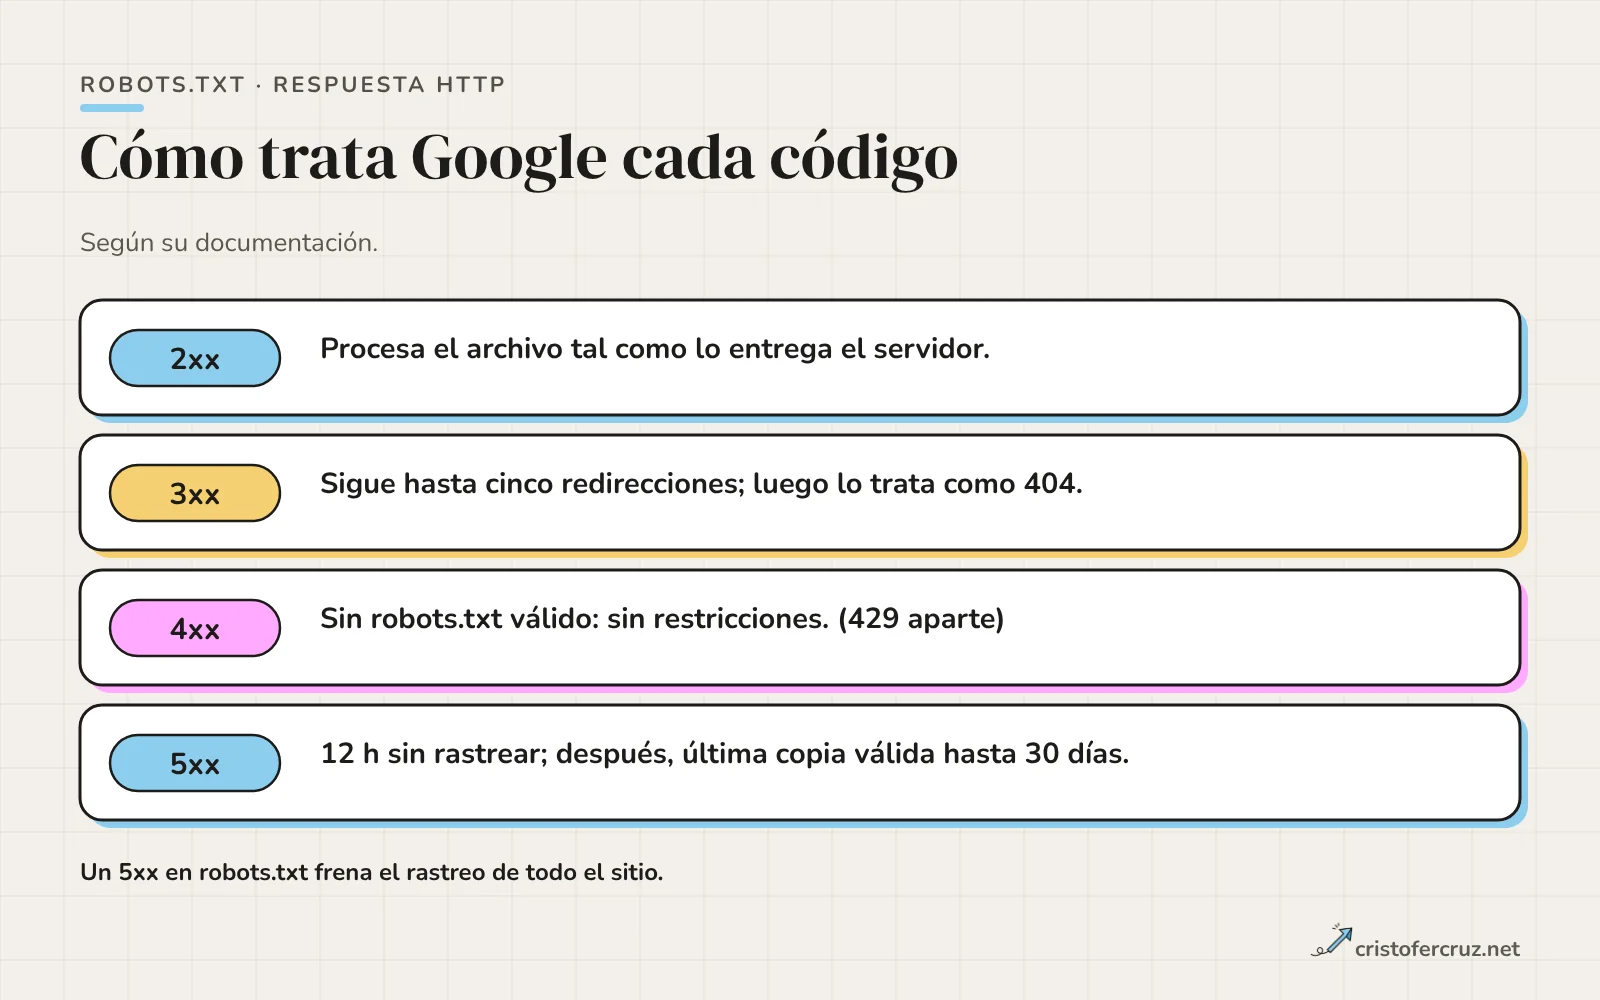
| Respuesta | Qué hace Google |
|---|---|
| 2xx | Procesa el archivo tal como lo entrega el servidor. |
| 3xx | Sigue al menos cinco redirecciones; después lo trata como 404. No sigue redirecciones lógicas (frames, JavaScript o meta refresh). |
| 4xx (salvo 429) | Lo trata como si no existiera un robots.txt válido: sin restricciones de rastreo. 401 y 403 no sirven para limitar el rastreo. |
| 5xx (y errores de red o DNS) | Durante las primeras 12 horas deja de rastrear el sitio y sigue intentando leer el archivo. Después usa la última versión válida hasta 30 días; si no hay copia, asume que no hay restricciones. |
Dos consecuencias prácticas. Un 5xx en robots.txt frena el rastreo de todo el sitio, así que un despliegue que rompa ese archivo es un incidente aunque las páginas respondan bien. Y un 403 o 401 no «cierra» el sitio: se interpreta como ausencia de reglas.
Sintaxis básica y grupos de user-agent
El archivo es texto plano en UTF-8 con líneas del tipo campo: valor. Los nombres de campo no distinguen mayúsculas, pero las rutas sí. Los comentarios empiezan por #. Google ignora las líneas inválidas, incluida la marca BOM, y las reglas sin ruta.
Los campos que Google soporta son cuatro: user-agent, allow, disallow y sitemap. Campos como crawl-delay no los soporta. Aparece en muchas plantillas copiadas; no hace daño, pero Googlebot no lo lee.
# Grupo para todos los bots
User-agent: *
Disallow: /privado/
Allow: /privado/prensa/

# Grupo propio para un bot concreto
User-agent: Googlebot-Image
Disallow: /fotos-internas/

Sitemap: https://example.com/sitemap.xml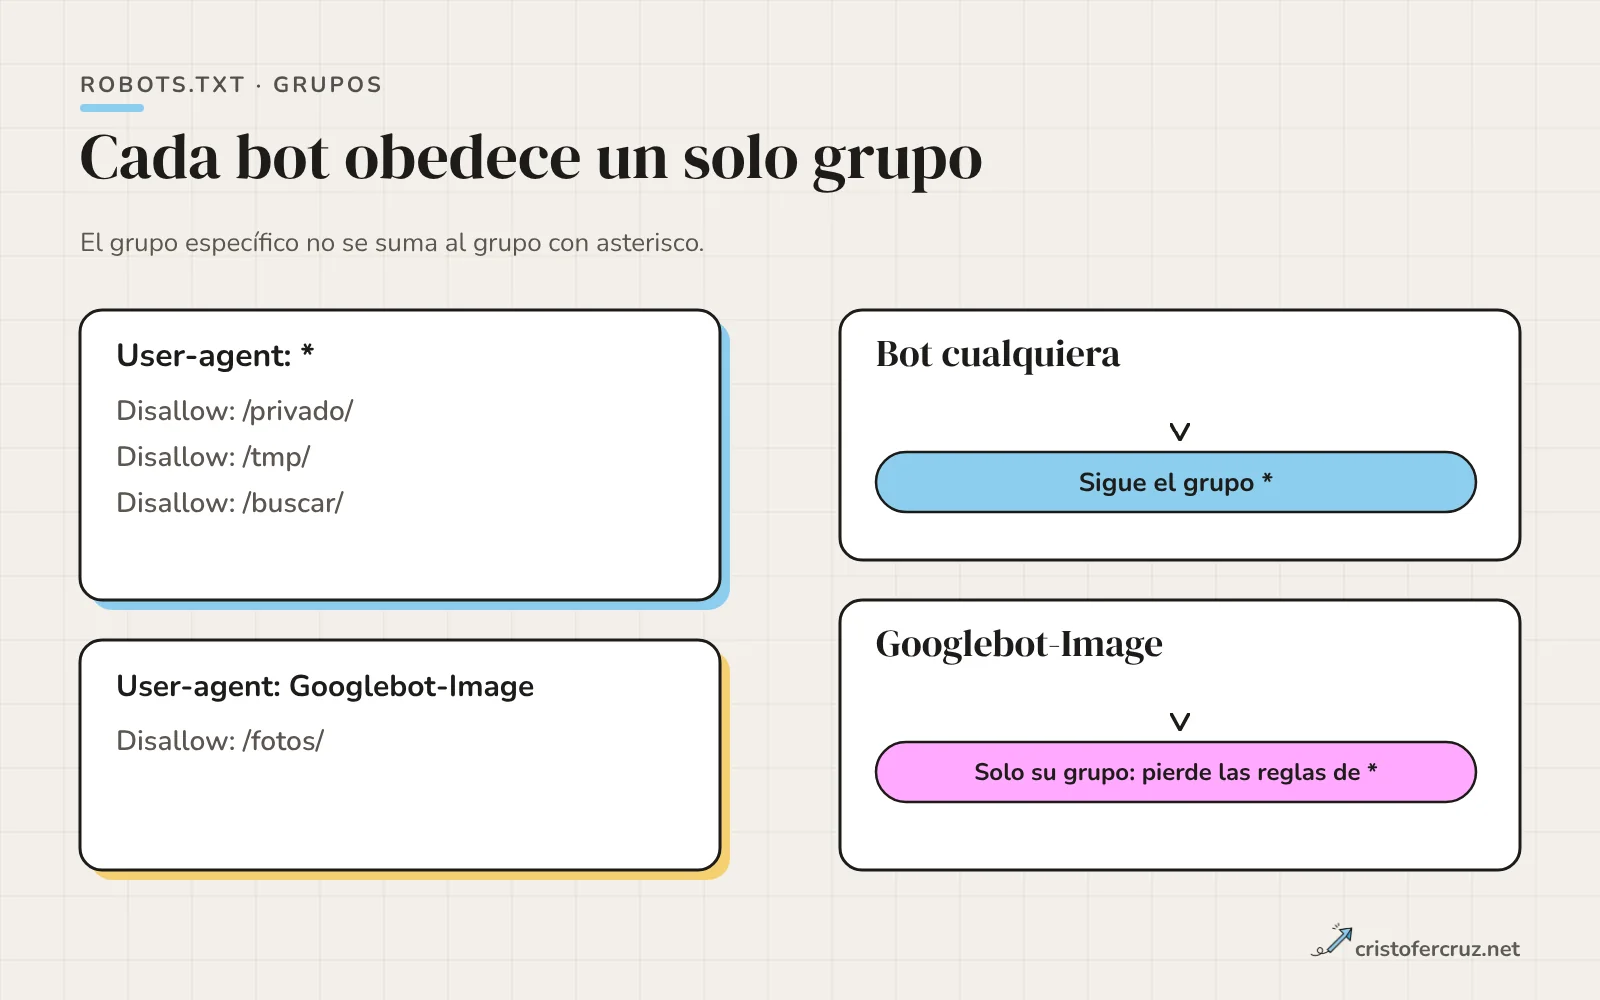
Cómo elige un bot su grupo
Un rastreador sigue solo el grupo con el user-agent más específico que coincida con él. Los grupos específicos no se combinan con el grupo *. Si hay varios grupos para el mismo agente, sus reglas se juntan, y el orden de los grupos no importa.
Esto provoca un fallo clásico: añades un grupo para Googlebot con una sola regla y, sin darte cuenta, Googlebot deja de obedecer todo lo que había en el grupo *. Si necesitas que un bot concreto mantenga las reglas generales, tienes que repetirlas en su grupo.
Comodines, $ y qué regla gana
Hay dos caracteres especiales: * equivale a cero o más caracteres cualesquiera y $ marca el final de la URL. Valen en allow y disallow, no en sitemap.
| Regla | Qué coincide |
|---|---|
Disallow: /*.gif$ | Cualquier URL que termine en .gif (ejemplo de la documentación de Google para Googlebot). |
Disallow: /carpeta/ | Todo lo que cuelgue de esa carpeta, con la barra final. |
Disallow: /*?orden= | URLs con ese parámetro en cualquier ruta. |
Disallow: / | Todo el sitio. |
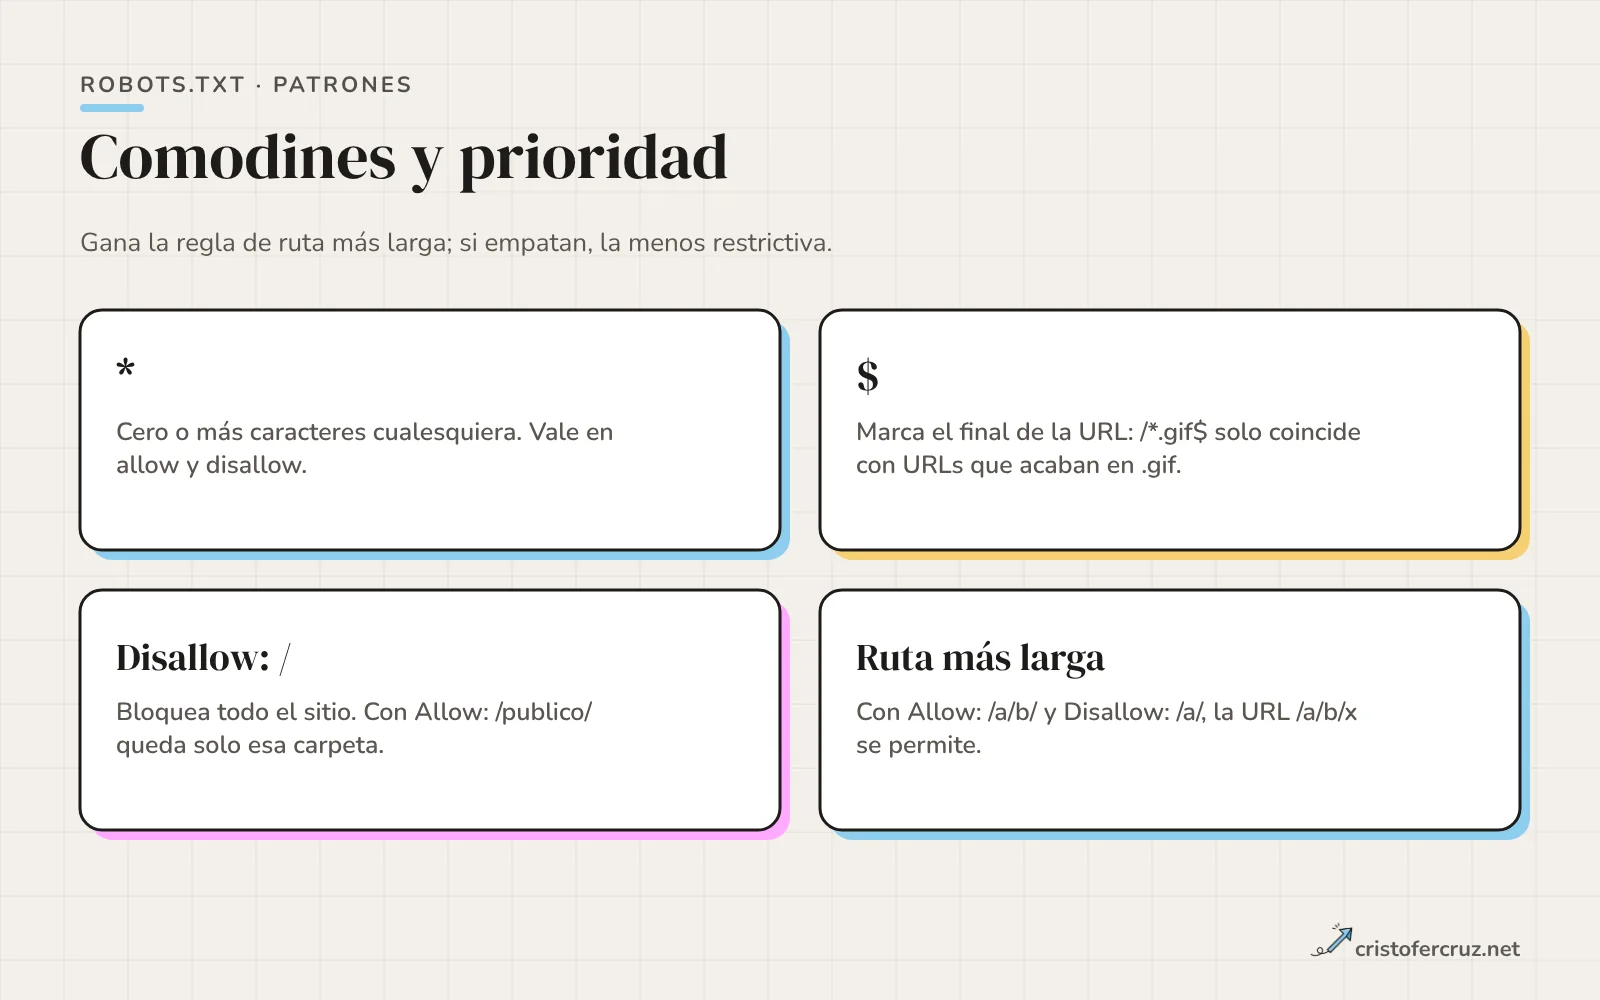
Cuando dos reglas afectan a la misma URL, gana la más específica, es decir, la de ruta más larga. Si hay conflicto, gana la menos restrictiva: con allow: /folder y disallow: /folder, la URL /folder/page se permite. Por eso el patrón Disallow: / seguido de Allow: /publico/ funciona: la regla de /publico/ es más larga.
Límite de tamaño y caché del archivo
Google procesa hasta 500 KiB; lo que pase de ahí se ignora. Con un sitio normal no llegas, pero sí con listas enormes de URLs bloqueadas una a una. Si te acercas, el problema no es el tamaño sino el diseño: sustituye listas por patrones con comodines.
La caché pesa más de lo que se piensa. Google normalmente guarda el contenido hasta 24 horas, puede guardarlo más si no consigue actualizarlo (timeouts, 5xx) y puede ajustar la duración según las cabeceras max-age. De ahí salen dos hábitos: no esperar efectos inmediatos tras editar el archivo y no cambiarlo a la ligera un viernes por la tarde.
Si has corregido un error o desbloqueado URLs importantes, el informe de robots.txt de Search Console permite solicitar un nuevo rastreo del archivo desde el icono de ajustes junto al archivo. La documentación avisa de que no garantiza un rastreo inmediato.
La línea Sitemap
La directiva Sitemap debe llevar una URL absoluta completa. Puedes poner varias, no está ligada a ningún user-agent y puede apuntar a otro host. Es una forma barata de que cualquier rastreador que lea el archivo encuentre tus sitemaps sin configurar nada más. Del contenido y la estructura de los sitemaps hablo en mi guía de sitemap XML.
Bots de IA y Google-Extended
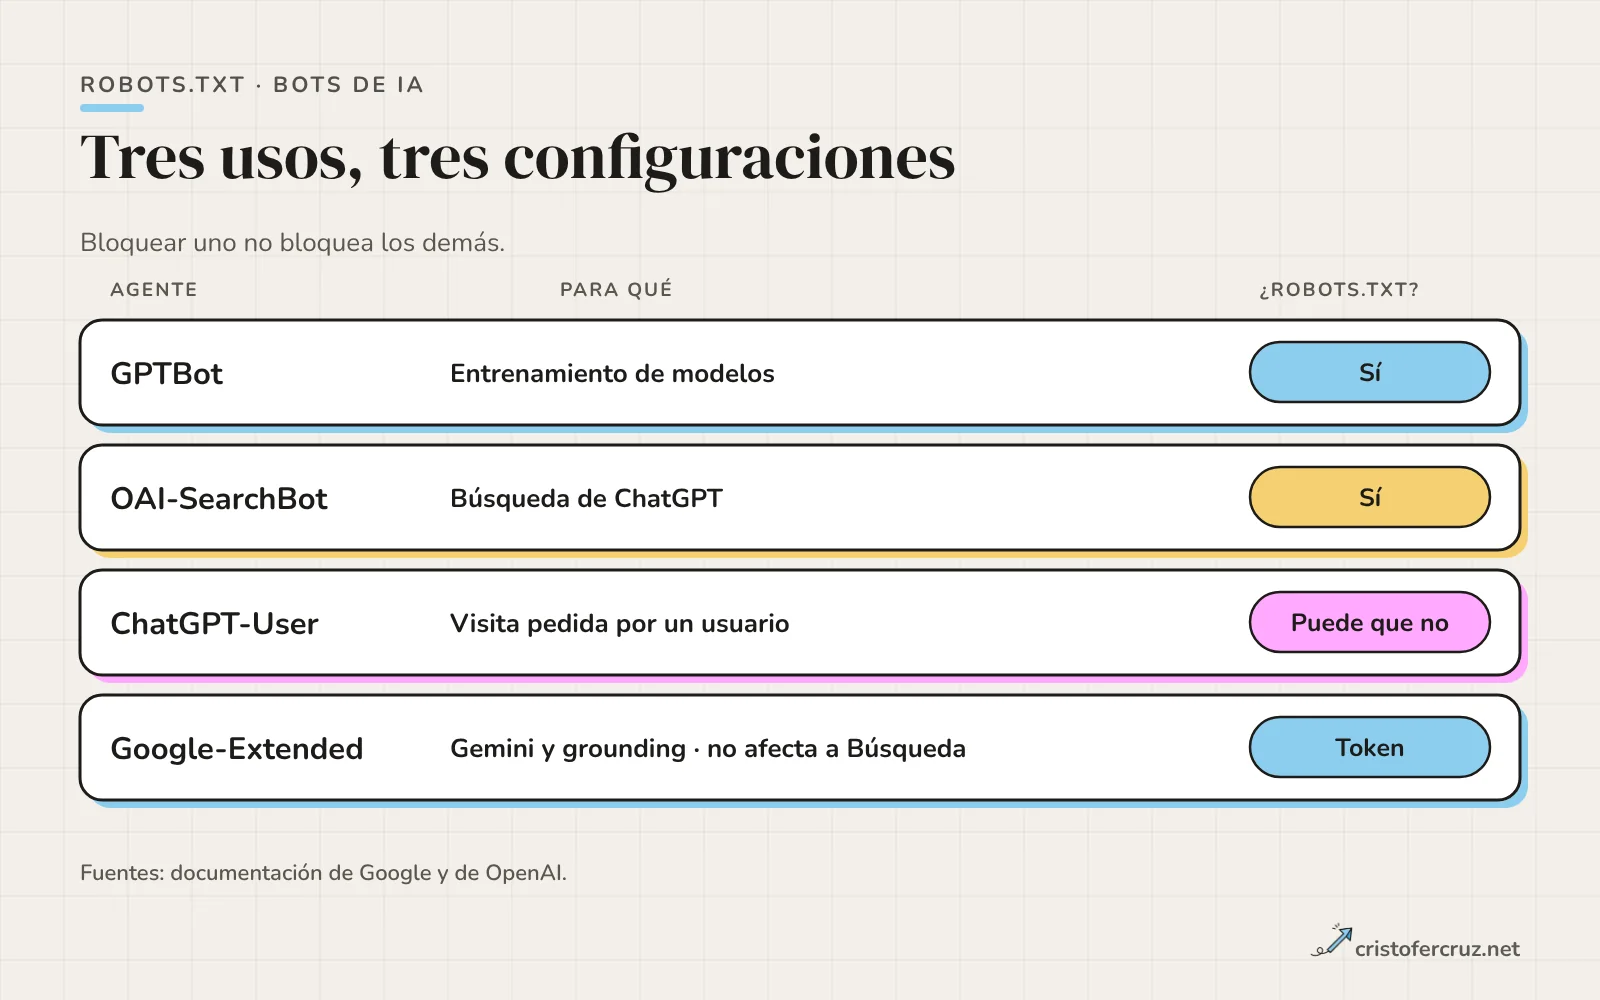
Aquí hay que separar tres usos que se mezclan en casi todas las guías: que tu contenido se use para entrenar modelos, que aparezca en búsquedas de un asistente y que un bot lo visite porque un usuario se lo ha pedido.
Google-Extended
Google-Extended es un token que se usa en el User-agent de robots.txt y no tiene un user agent HTTP propio: el rastreo se hace con los user agents de Google ya existentes. Controla si el contenido que Google rastrea de tu sitio se puede usar para entrenar futuras generaciones de modelos Gemini y para grounding, es decir, aportar contenido al modelo en el momento de la consulta. Afecta a Gemini Apps, a la API de Vertex AI para Gemini y a Grounding with Google Search en Vertex AI. Google indica que no afecta a la inclusión de un sitio en la Búsqueda ni se usa como señal de ranking.
Bots de OpenAI
OpenAI documenta tres agentes con funciones distintas:
| Agente | Para qué | ¿Se rige por robots.txt? |
|---|---|---|
GPTBot | Rastrea contenido que puede usarse para entrenar modelos. Bloquearlo indica que no debe usarse para entrenamiento. | Sí |
OAI-SearchBot | Indexa sitios para las funciones de búsqueda de ChatGPT. Si lo excluyes, no apareces en esas respuestas, aunque puede salir un enlace de navegación. | Sí |
ChatGPT-User | Visitas cuando un usuario hace una consulta en ChatGPT o en un GPT personalizado. No determina si apareces en la búsqueda. | Puede que no: al iniciarlo un usuario, las reglas pueden no aplicarse |
OpenAI añade que los cambios pueden tardar unas 24 horas en reflejarse en los resultados de búsqueda. Para otros asistentes (Anthropic, Perplexity y demás) no he verificado la documentación en este artículo, así que no te doy reglas concretas: consulta la página oficial de cada uno antes de escribir su grupo.
La decisión de fondo es de negocio. Si quieres aparecer citado en respuestas de asistentes pero no ceder contenido para entrenar, el patrón es permitir los agentes de búsqueda y bloquear los de entrenamiento. Lo desarrollo desde el lado de la visibilidad en AEO y GEO.
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Ese bloque dice «no uséis mi contenido para entrenamiento» a esos dos, sin tocar la Búsqueda de Google ni la búsqueda de ChatGPT. Ten en cuenta que, como cada bot sigue su grupo, esas reglas no se mezclan con las del grupo *.
Errores típicos de robots.txt
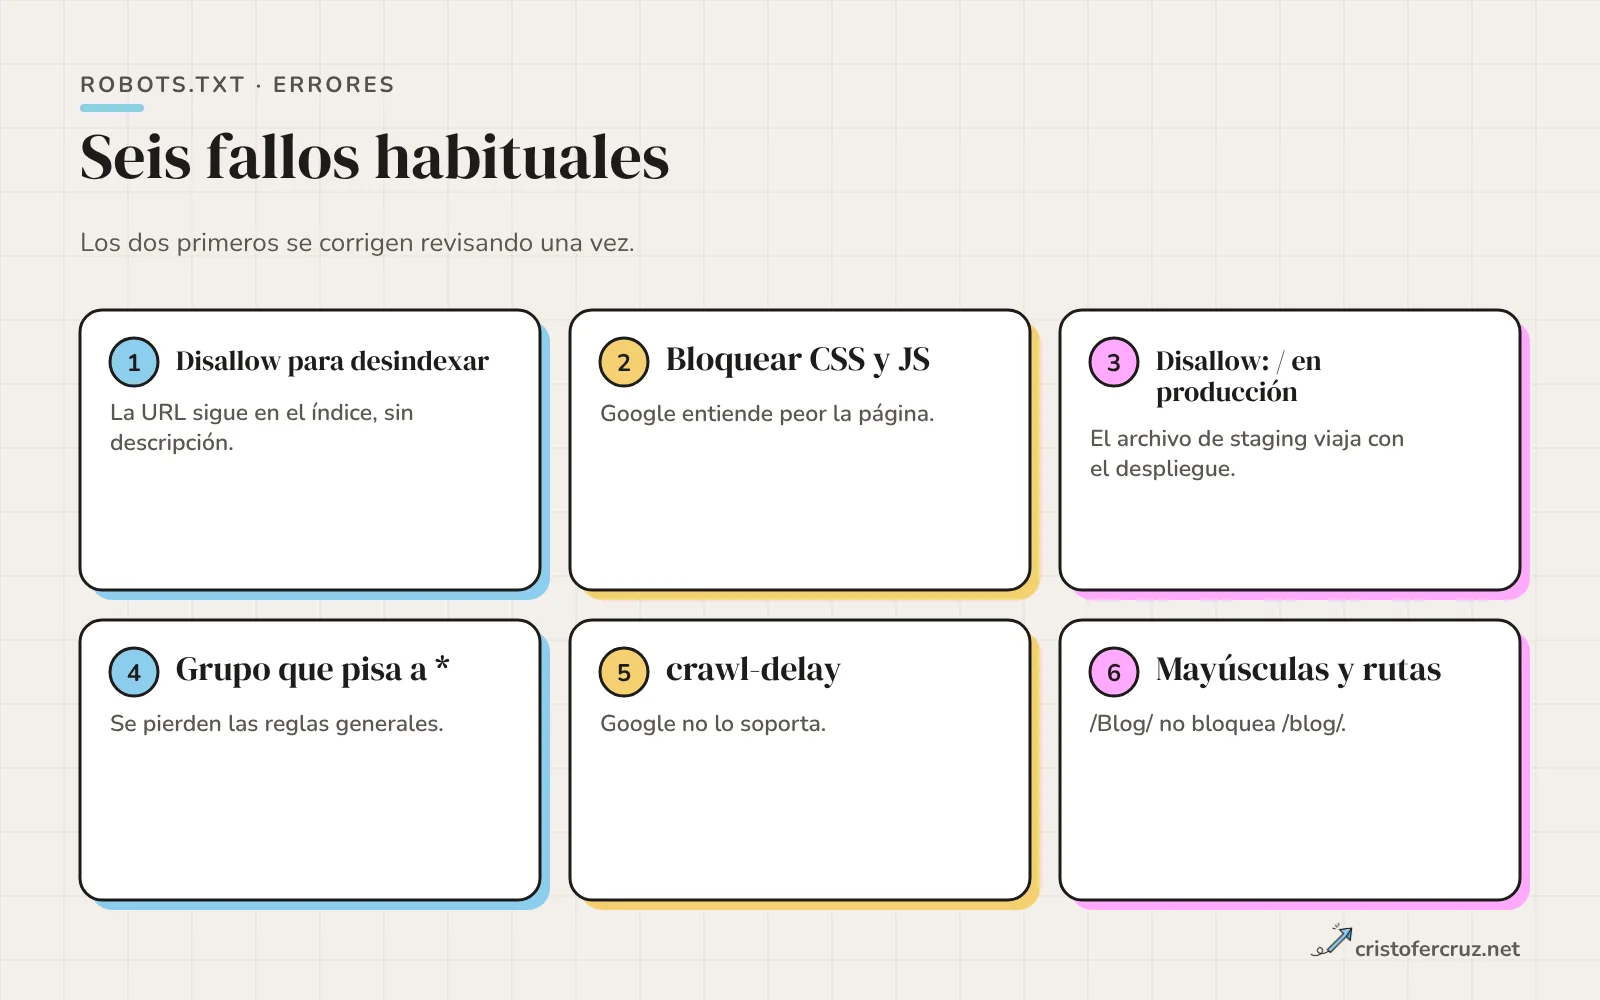
- Usar Disallow para desindexar. Ya lo hemos visto: la URL puede seguir indexada, sin descripción.
- Bloquear CSS, JavaScript o imágenes. Google advierte de que bloquear recursos necesarios para el contenido puede dificultar que entienda la página. Esto enlaza con lo que cuento sobre renderizado, y el caso de los recursos JavaScript bloqueados lo desarrollo aparte.
- Dejar
Disallow: /tras un despliegue. El robots.txt de staging, con todo bloqueado, que viaja a producción. Abrir ese archivo debería ser un paso fijo antes de cualquier lanzamiento, y es lo primero que compruebo cuando acompaño una migración SEO. - Olvidar que el grupo específico anula al general. Se añade un grupo para un bot y se pierden las reglas del
*. - Esperar que
crawl-delayfuncione en Google. No está soportado. - Rutas mal escritas. Las rutas distinguen mayúsculas y minúsculas y deben empezar por
/;Disallow: /Blog/no bloquea/blog/.
Hay un séptimo error que no es de sintaxis: bloquear parámetros o filtros que ya llevan su propia señal. Si una URL de filtro devuelve noindex o un canonical, bloquearla en robots.txt impide que Google lea esa señal. Es justo el caso del apartado siguiente.
Cómo probar robots.txt
La comprobación completa son cuatro pasos y casi todos se hacen en minutos.
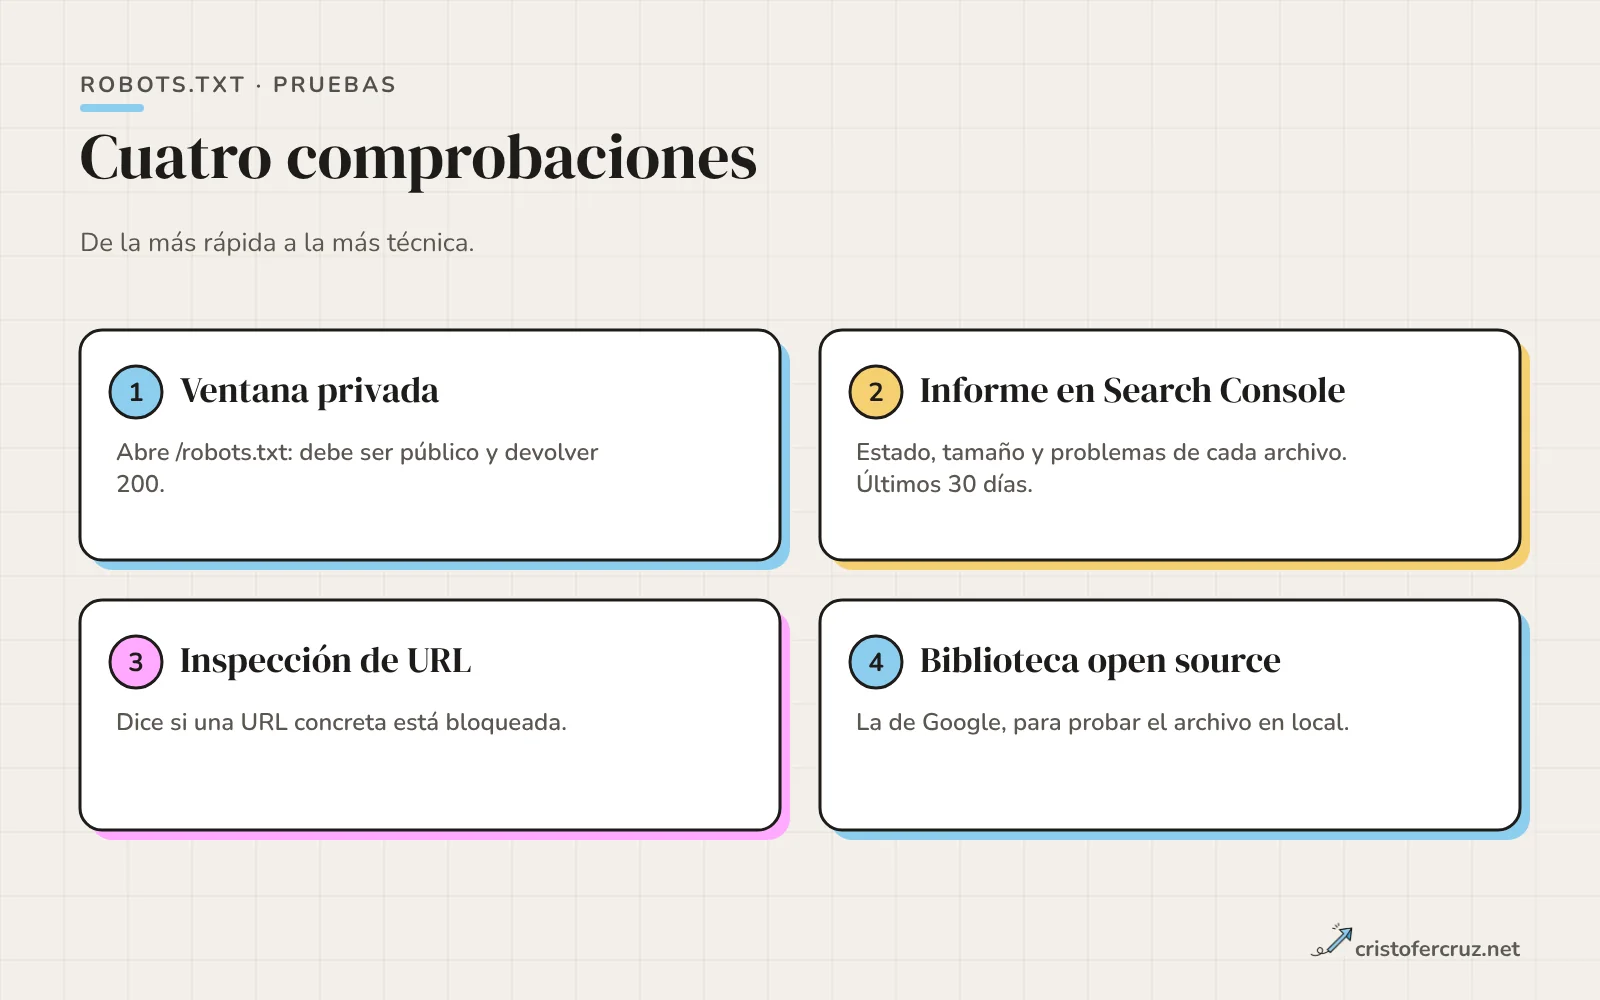
- Abrirlo en una ventana privada y comprobar que es público, que devuelve 200 y que el contenido es el que esperas.
- Informe de robots.txt en Search Console. Muestra los archivos que Google encontró en los 20 principales hosts del sitio, cuándo los rastreó, su tamaño y los problemas de análisis. Solo está disponible para propiedades de dominio o de prefijo de URL sin ruta. Los errores impiden usar una regla; las advertencias no. Guarda las solicitudes de los últimos 30 días y registra una nueva solo si el archivo o el resultado cambió.
- Inspección de URL. Para saber si una URL concreta está bloqueada, Google recomienda esta herramienta.
- La biblioteca open source de Google para probar el archivo en local, pensada para quien desarrolla.
Ten en cuenta que la documentación no dice que el informe sustituya a ningún probador anterior, así que no te lo afirmo. Tampoco confundas lo que Google entiende con lo que entiende otro buscador: el propio Google avisa de que distintos rastreadores pueden interpretar la misma sintaxis de forma diferente.
Cuando audito un sitio, además miro los logs del servidor: un bot que sigue pidiendo rutas que deberías haber bloqueado indica que el archivo no se está leyendo o que ese bot no lo respeta. Tengo una herramienta de análisis de logs para eso.
El robots.txt real de mi web
Este es el archivo de cristofercruz.net tal cual está en el repositorio, sin retoques:
# cristofercruz.net
# Reglas comunes para rastreadores que respetan robots.txt.
User-agent: *
# Carpetas internas, dependencias y material de desarrollo.
Disallow: /includes/
Disallow: /contact-private/
Disallow: /PHPMailer/
Disallow: /tools/
Disallow: /tests/
Disallow: /.git/
# Procesamiento de formularios y plantilla interna.
Disallow: /send.php
Disallow: /plantilla-pagina.php

# El resto del sitio queda permitido por defecto.
# Mantener accesibles CSS, JavaScript, fuentes, imagenes y herramientas.
# No bloquear /blog/feed.php: participa en la carga del listado.
# No bloquear filtros, busquedas ni paginacion del blog:
# el servidor gestiona canonical y noindex segun la URL.
# robots.txt no protege archivos privados ni elimina URLs del indice.

Sitemap: https://cristofercruz.net/sitemap.xml
Sitemap: https://cristofercruz.net/blog/sitemap.php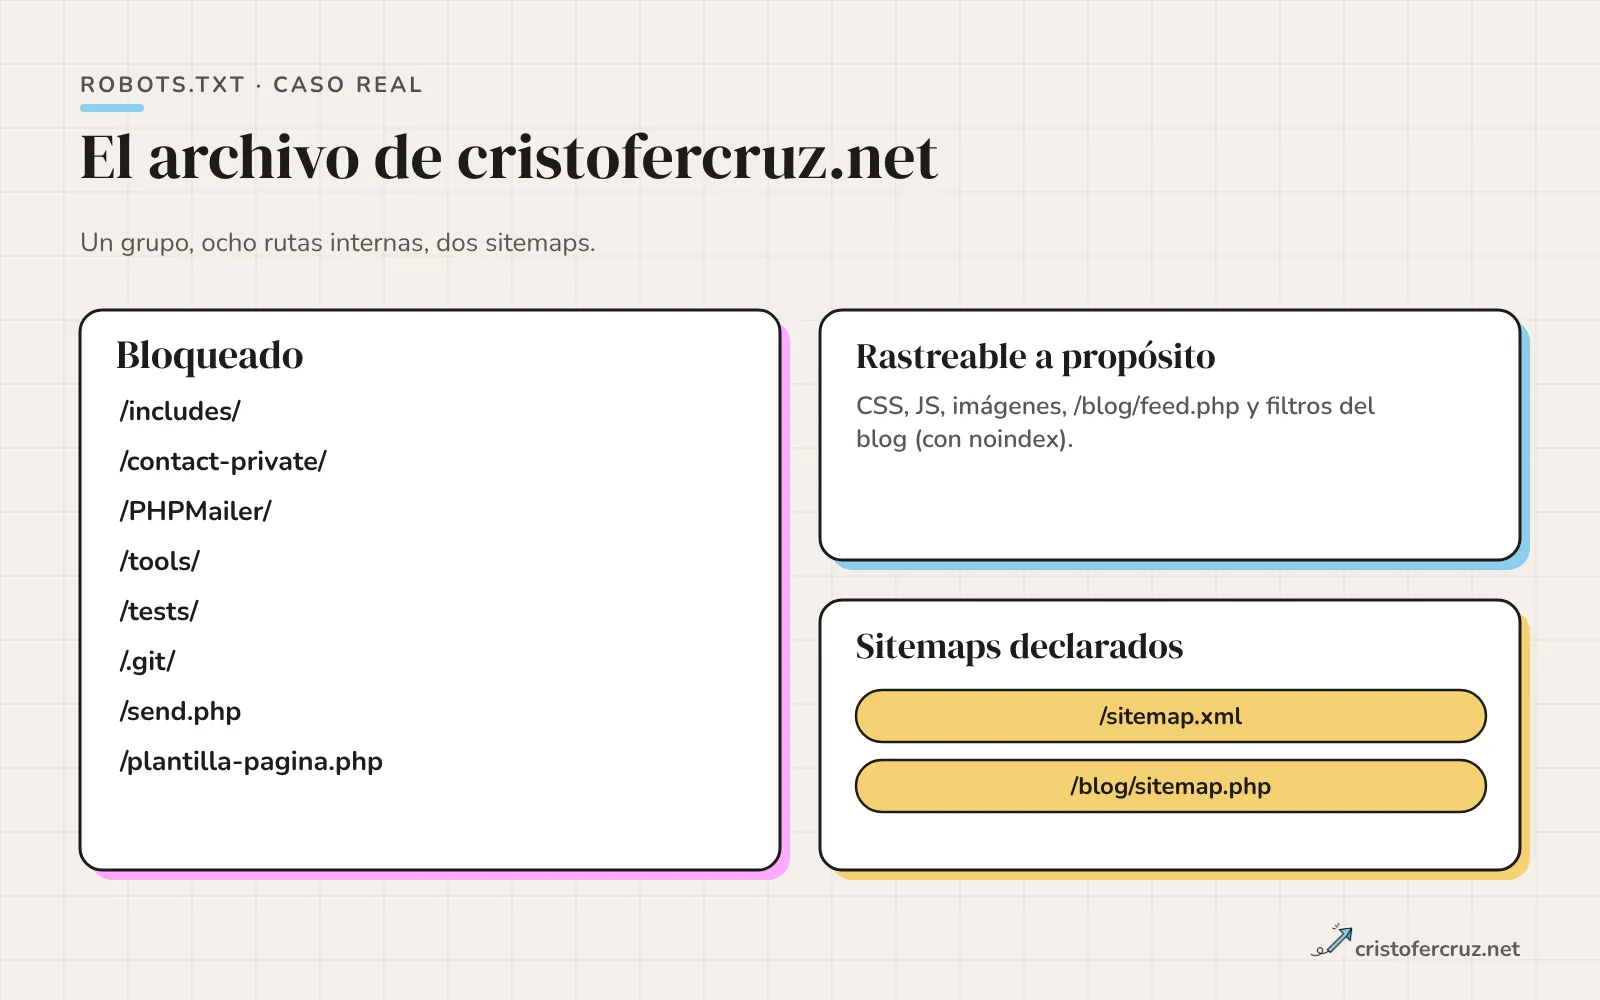
Las decisiones que hay detrás, con lo que he podido comprobar en el código:
- Un solo grupo,
User-agent: *. No tengo reglas propias para Googlebot ni para ningún otro bot, así que no hay grupos que se pisen. - Ocho rutas bloqueadas, todas internas:
/includes/,/contact-private/,/PHPMailer/,/tools/,/tests/,/.git/,/send.phpy/plantilla-pagina.php. En el repositorio no existe hoy una carpetatests; esa regla es preventiva. - No es mi única capa. El
.htaccessbloqueatools/y.git/con una regla de reescritura[F]y deniega el acceso a archivos de documentación y aplantilla-pagina.php. robots.txt es la capa cortés; el servidor es la que protege de verdad. - Coste conocido: como el archivo es público, esa lista revela que existen rutas como
/contact-private/. Lo acepto porque lo que hay detrás está protegido en servidor, pero es un compromiso real. - Filtros y búsquedas del blog, sin bloquear. Cuando el listado tiene filtro de categoría o una búsqueda, la página envía
noindex, follow, y la paginación lleva su propio canonical. Si bloqueara esas URLs en robots.txt, Google nunca vería esenoindex, que es el caso del apartado anterior. /blog/feed.phpsin bloquear. Es el punto de carga del listado y responde conX-Robots-Tag: noindexyCache-Control: no-store. Se puede rastrear y no se indexa.- Los errores 404 llevan
noindex, nofollowpor cabecera y por meta, de nuevo sin bloquear en robots.txt. - Dos sitemaps:
sitemap.xmlyblog/sitemap.php.
Lo que hoy no hago: no tengo grupos específicos para GPTBot, Google-Extended ni otros bots de IA, así que mi contenido queda permitido para todos ellos. Si cambio de criterio, el bloque de ejemplo de la sección de bots de IA es el punto de partida. Tampoco tengo un archivo llms.txt.
Cómo auditar el robots.txt de cualquier sitio
Mi secuencia es corta y se puede repetir en cada proyecto:
- Abrir
/robots.txten cada host que importe (con y sinwww, subdominios) y comprobar código de respuesta y redirecciones. - Leer cada
Disallowy preguntarse qué hay detrás: si son URLs ya indexadas, si llevannoindex, si son recursos de renderizado. - Buscar grupos específicos que pisen al grupo
*. - Revisar el informe de robots.txt en Search Console: estado de obtención, tamaño y problemas.
- Comparar con las URLs de tu sitemap: una URL en el sitemap y bloqueada en robots.txt es una contradicción que conviene resolver.
- Mirar logs para confirmar qué bots piden realmente qué rutas.
Preguntas frecuentes sobre robots.txt
¿Es obligatorio tener un robots.txt?
No. Si Google recibe un 404 al pedirlo, lo trata como si no hubiera restricciones de rastreo. Tenerlo es útil cuando quieres bloquear rutas concretas o declarar sitemaps.
¿Bloquear una URL en robots.txt la quita de Google?
No. Una URL bloqueada puede seguir apareciendo en los resultados si otros sitios la enlazan, normalmente sin descripción. Para que no salga hay que usar noindex con la página rastreable, o proteger la URL con contraseña.
¿Puedo poner noindex dentro de robots.txt?
No cuentes con ello: los campos que Google documenta para ese archivo son user-agent, allow, disallow y sitemap. Usa meta robots o la cabecera X-Robots-Tag en la propia página.
¿Cuánto tarda Google en leer un cambio?
Google normalmente guarda el archivo hasta 24 horas, y puede tardar más si no consigue actualizarlo. Desde Search Console puedes solicitar un nuevo rastreo del archivo, aunque no garantiza que sea inmediato.
¿Qué pasa si mi robots.txt devuelve un error 500?
Durante las primeras 12 horas Google deja de rastrear el sitio y sigue intentando leer el archivo. Después usa la última versión válida hasta 30 días, y si no tiene ninguna, asume que no hay restricciones.
¿Bloquear Google-Extended afecta a mi posicionamiento?
Según Google, no: no influye en la inclusión del sitio en la Búsqueda ni se usa como señal de ranking. Solo controla el uso de tu contenido para entrenar y fundamentar modelos Gemini y los servicios que Google lista.
¿Los bots de IA siempre respetan robots.txt?
No hay garantía general. OpenAI documenta que GPTBot y OAI-SearchBot se rigen por robots.txt, pero indica que ChatGPT-User, al iniciarlo un usuario, puede no aplicar esas reglas. Y cualquier bot ajeno a esas políticas puede ignorar el archivo; si necesitas bloquearlo de verdad, hazlo en el servidor.
Referencias
- Introducción a robots.txt Google Search Central
- Cómo interpreta Google la especificación de robots.txt Google Search Central
- Crear y enviar un archivo robots.txt Google Search Central
- Especificaciones de la etiqueta meta robots y X-Robots-Tag Google Search Central
- Rastreadores comunes de Google (Googlebot y Google-Extended) Google Search Central
- Informe de robots.txt Ayuda de Search Console
- Bots de OpenAI: GPTBot, OAI-SearchBot y ChatGPT-User OpenAI
- ¿Qué es el archivo robots.txt y cómo configurarlo? SE Ranking