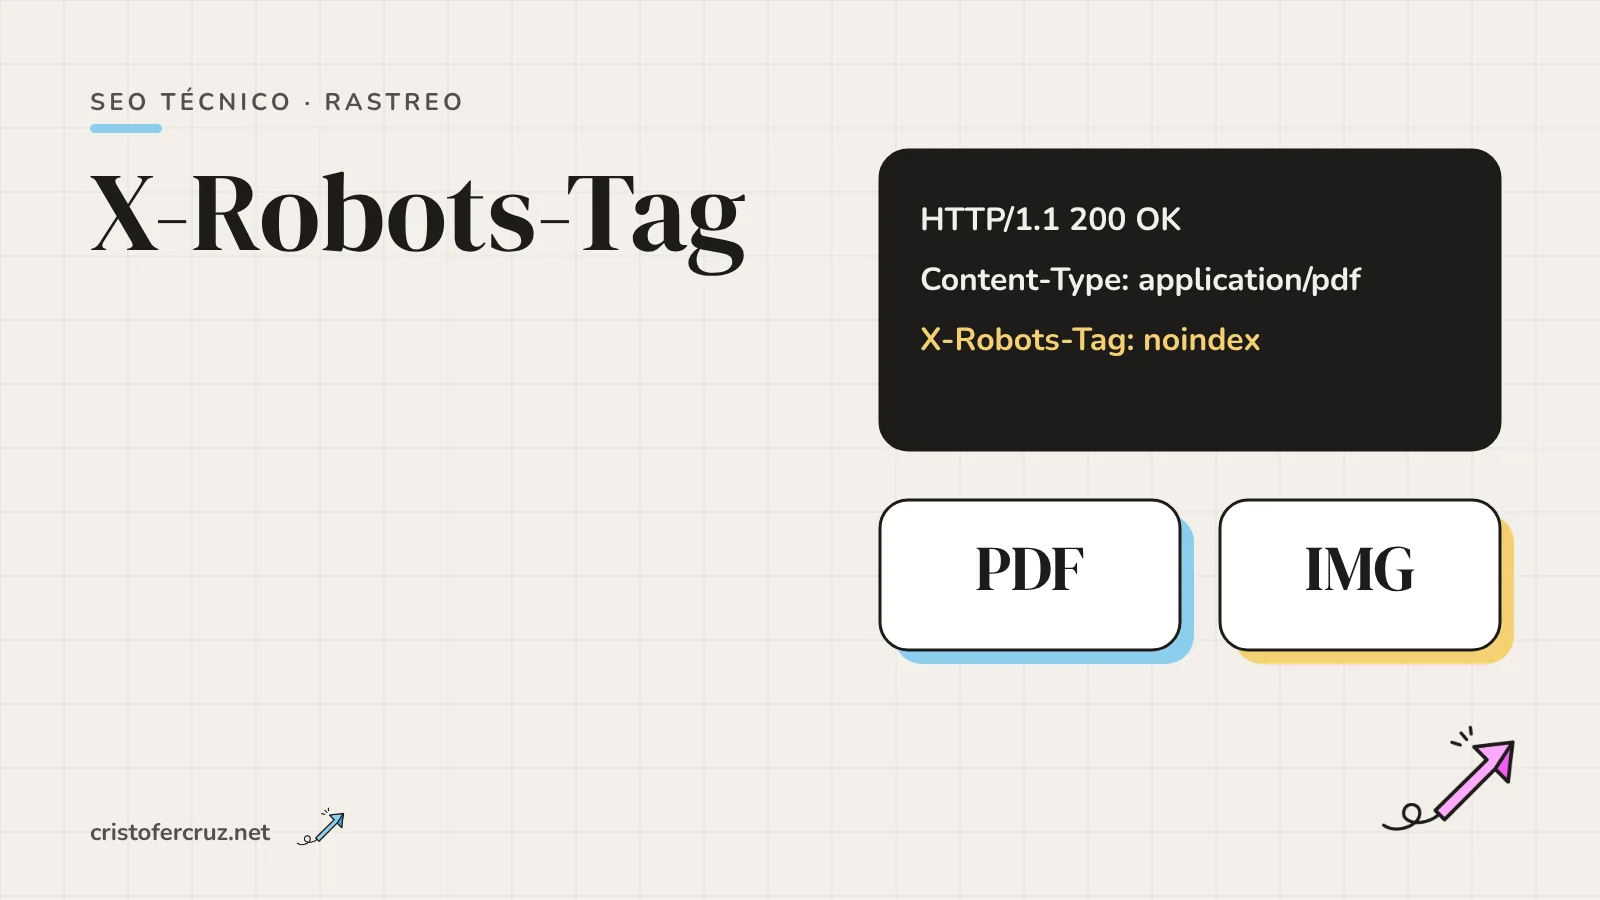
X-Robots-Tages una cabecera HTTP que da a Google las mismas instrucciones de indexación que la etiqueta meta robots, y es la única opción para PDF, imágenes y otros archivos que no son HTML.- Google documenta estas directivas:
all,noindex,nofollow,none,nosnippet,indexifembedded,max-snippet,max-image-preview,max-video-preview,notranslate,noimageindexyunavailable_after. - Si dos reglas chocan, Google aplica la más restrictiva. Con
max-snippet:50ynosnippet, gananosnippet. - Si la URL está bloqueada en robots.txt, Google no puede rastrearla y no llega a leer la cabecera: el
noindexno se aplica. - En Apache necesitas
mod_headers; en Nginx,add_headerconalwaysy cuidado con la herencia entre bloques; en PHP,header()antes de cualquier salida. - Se verifica con
curl -Iprimero y con la Inspección de URL de Search Console después.
Un PDF con la tarifa de hace dos años sigue saliendo en Google y no hay ninguna etiqueta que ponerle: un PDF no tiene <head>. Lo mismo pasa con un fichero de descarga interno o una imagen que no quieres ver en Google Imágenes. Para eso existe X-Robots-Tag, una cabecera de la respuesta HTTP que transmite las mismas instrucciones que la meta robots.
Aquí cubro qué directivas acepta Google según su documentación, cómo se escribe con un user-agent concreto, cómo se implementa en Apache, Nginx y PHP, qué pasa cuando dos reglas se contradicen, por qué bloquear en robots.txt la deja inservible y cómo comprobar que funciona. También cuento cómo uso yo la cabecera en este sitio, incluida una incoherencia que he encontrado al revisarlo.
Qué es X-Robots-Tag y en qué se diferencia de la meta robots
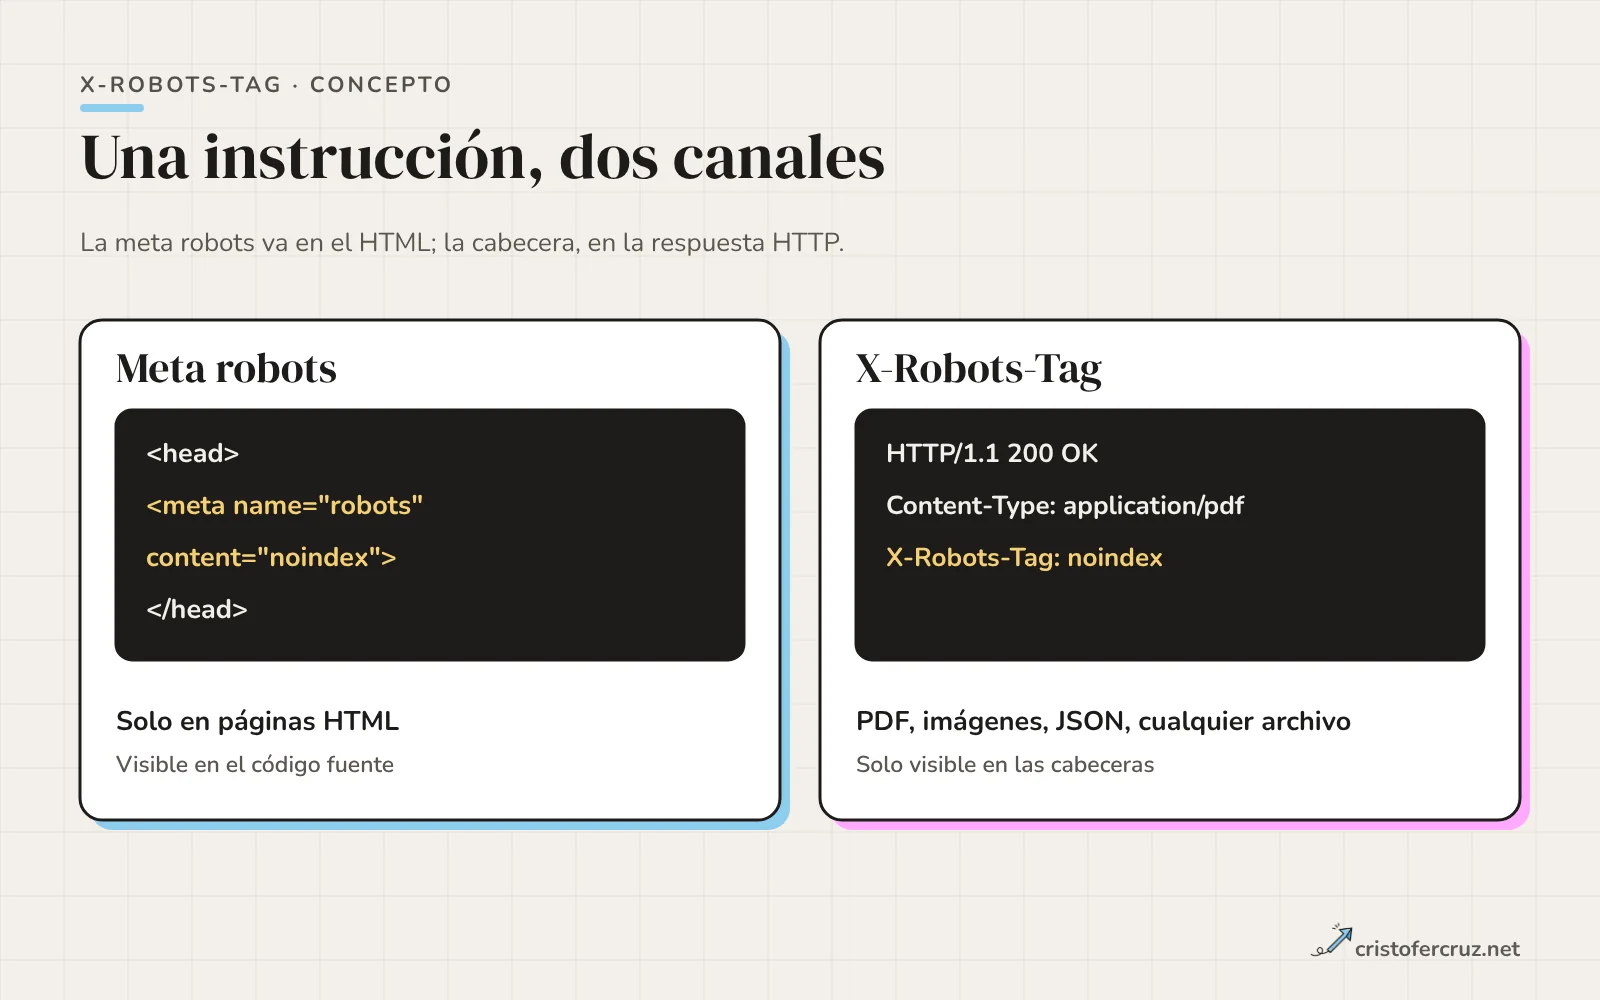
Cuando un rastreador pide una URL, el servidor responde con una línea de estado, una serie de cabeceras y, después, el cuerpo. X-Robots-Tag es una de esas cabeceras. Según la documentación de Google sobre las especificaciones de robots meta, sirve para archivos que no son HTML, como imágenes o PDF, donde no se puede insertar una etiqueta meta.
La etiqueta <meta name="robots" content="noindex"> y la cabecera X-Robots-Tag: noindex expresan lo mismo. Cambia el canal, y con él lo que puedes hacer.
| Aspecto | Meta robots | X-Robots-Tag |
|---|---|---|
| Dónde va | Dentro del <head> del HTML | En la cabecera de la respuesta HTTP |
| Tipos de archivo | Solo páginas HTML | Cualquiera: HTML, PDF, imágenes, vídeo, JSON, XML |
| Dónde se configura | Plantilla, CMS o plugin | Servidor web, CDN o código de la aplicación |
| Aplicación en bloque | Página a página | Por patrón: todos los .pdf, toda una carpeta |
| Visible en el código fuente | Sí | No: solo en las cabeceras de la respuesta |
La segunda ventaja, aplicar una regla a muchas URLs a la vez, es la que más pesa en sitios grandes: un patrón en el servidor cubre todos los PDF de una vez, mientras que revisarlos uno a uno es inviable. En una página HTML normal prefiero la meta robots, porque queda a la vista en el código fuente y cualquiera del equipo la encuentra al revisar la plantilla.
Cuándo tiene sentido usar la cabecera
Estos son los casos en los que la cabecera es la herramienta correcta, no una opción más.
- PDF y documentos de Office que no deben competir con la página que los enlaza: fichas técnicas duplicadas, tarifas caducadas, contratos o formularios de descarga. Si el PDF duplica una página HTML, también puedes señalar el original con una cabecera canonical en lugar de excluirlo.
- Imágenes que no quieres en Google Imágenes, con
noindexaplicado a una carpeta o a una extensión. Para las que sí quieres posicionar, mira cómo optimizar las imágenes para SEO. - Respuestas que no son páginas: endpoints JSON, feeds internos, resultados de buscador interno.
- Entornos de staging, donde una regla global a nivel de servidor evita tocar cada plantilla (aunque en staging la protección con contraseña es más segura que cualquier directiva).
- Contenido con fecha de caducidad, con
unavailable_after, cuando sabes de antemano cuándo deja de tener sentido.
Si el archivo es HTML y puedes editar su plantilla, la meta robots hace lo mismo con menos riesgo de que una regla de servidor afecte a más URLs de las previstas.
Directivas que soporta Google
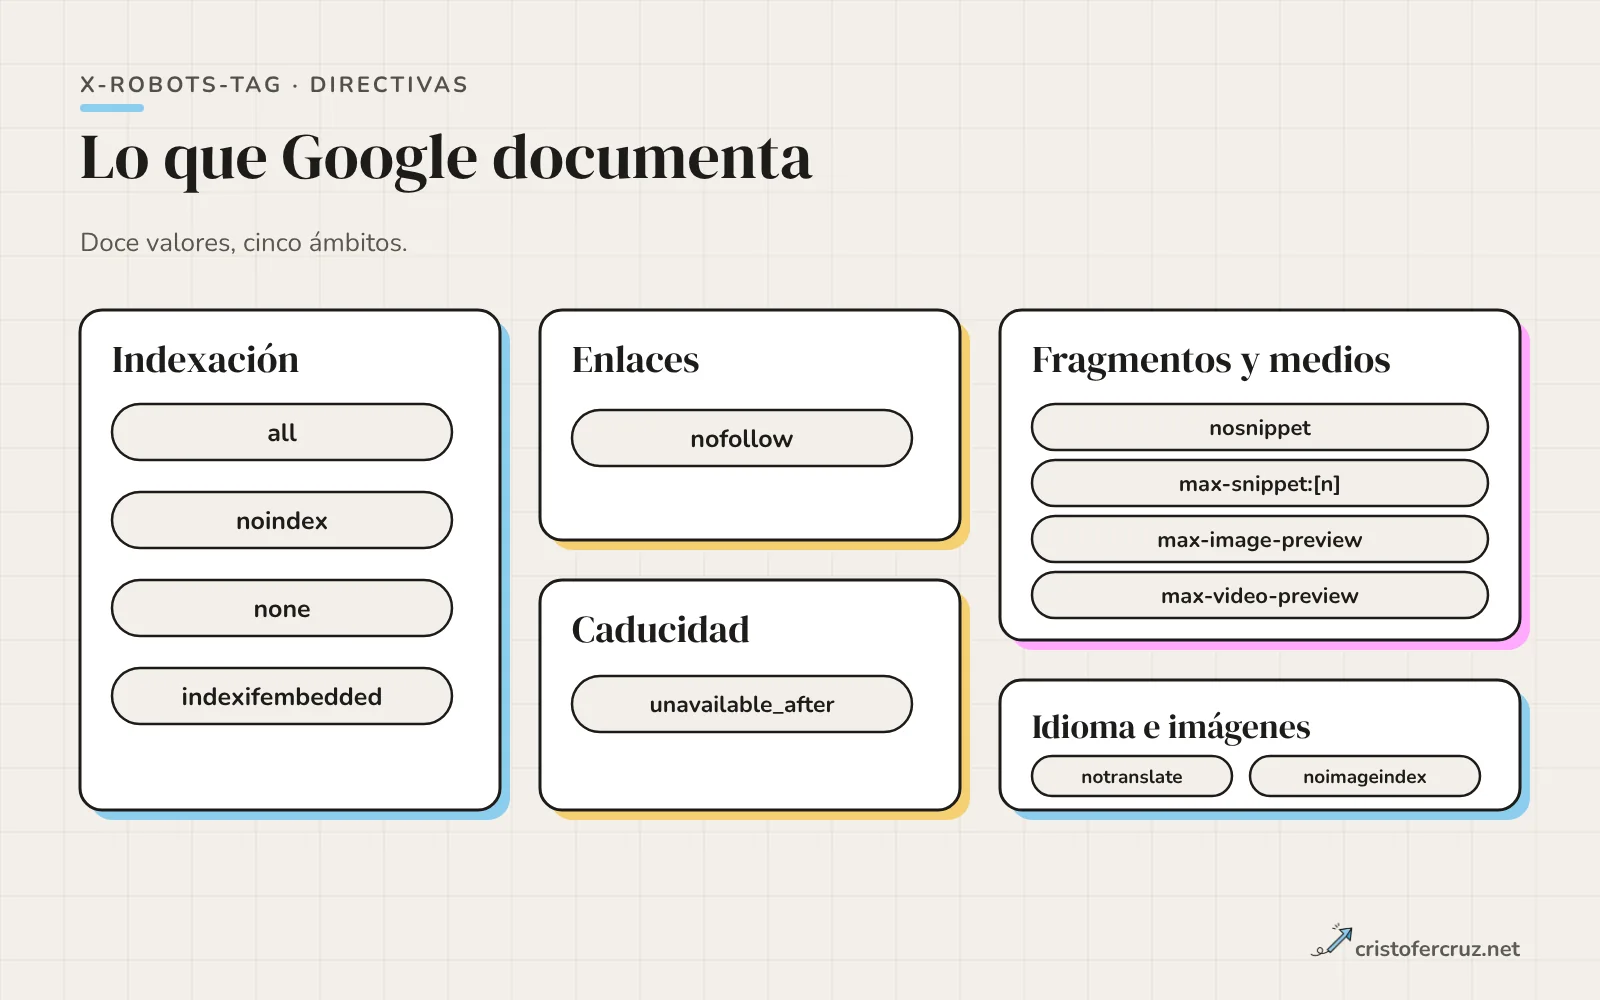
La documentación de Google lista las directivas que se pueden usar en la meta robots y en la cabecera. Se pueden combinar separadas por comas y no distinguen mayúsculas de minúsculas. Esta es la lista tal y como aparece en su especificación.
| Directiva | Qué hace |
|---|---|
all | Sin restricciones. Es el valor por defecto. |
noindex | No muestra la página en los resultados. |
nofollow | No sigue los enlaces de la página. |
none | Equivale a noindex, nofollow. |
nosnippet | No muestra fragmento de texto ni vista previa de vídeo. |
indexifembedded | Permite indexar el contenido cuando se incrusta en otra página (iframe o similar), aunque tenga noindex. Solo tiene efecto junto a noindex. |
max-snippet:[n] | Límite de caracteres del fragmento. 0 equivale a nosnippet; -1 no fija límite. |
max-image-preview:[ajuste] | Tamaño máximo de la imagen en vista previa: none, standard o large. |
max-video-preview:[n] | Segundos máximos de la vista previa de vídeo. |
notranslate | No ofrece traducción de la página en los resultados. |
noimageindex | No indexa las imágenes de la página. |
unavailable_after:[fecha] | Deja de mostrar la página después de la fecha indicada. |
noarchive circula en muchas guías, pero no aparece en la lista de la especificación que he leído para este artículo, así que no lo trato como directiva soportada por Google.
unavailable_after: el formato de fecha
Google pide una fecha y hora en un formato ampliamente adoptado y menciona RFC 822, RFC 850 e ISO 8601. Su ejemplo es unavailable_after: 25 Jun 2010 15:00:00 PST. Si la fecha no es válida, la regla se ignora, y sin esta regla el contenido no tiene fecha de caducidad. Mi consejo es escribir la fecha con zona horaria explícita y comprobar la cabecera con curl: un error de formato no da ningún aviso, simplemente no ocurre nada.
La documentación tampoco detalla cuánto tarda en aplicarse. Solo indica que, pasada la fecha, Googlebot reduce considerablemente la frecuencia de rastreo de esa URL. No hay un plazo documentado.
Sintaxis: varias reglas y user-agent concreto
La forma básica es una cabecera con una lista separada por comas, que se aplica a todos los rastreadores:
X-Robots-Tag: noindex, nofollowGoogle acepta también varias cabeceras X-Robots-Tag en la misma respuesta, y se combinan. Para dirigir una regla a un rastreador concreto, se antepone su nombre seguido de dos puntos. El ejemplo de la documentación:
X-Robots-Tag: googlebot: nofollow
X-Robots-Tag: otherbot: noindex, nofollow
Las reglas sin user-agent valen para todos los rastreadores. El nombre de la cabecera, el user-agent y los valores no distinguen mayúsculas. Un uso real: X-Robots-Tag: googlebot: noindex para que Google no indexe un recurso y otros buscadores sí. No hace falta salvo que tengas un motivo claro; en el resto de casos, una regla general es más fácil de mantener.
Un detalle práctico: este valor depende de que el rastreador entienda la cabecera. La especificación que cito es la de Google. Para otros buscadores, comprueba su propia documentación antes de asumir que soportan las mismas directivas.
Implementación en Apache con .htaccess
En Apache la cabecera se añade con la directiva Header del módulo mod_headers, que debe estar cargado. En un .htaccess funciona si el servidor permite AllowOverride FileInfo, según la documentación de Apache. Un patrón con FilesMatch y una expresión regular cubre todas las extensiones que necesites:
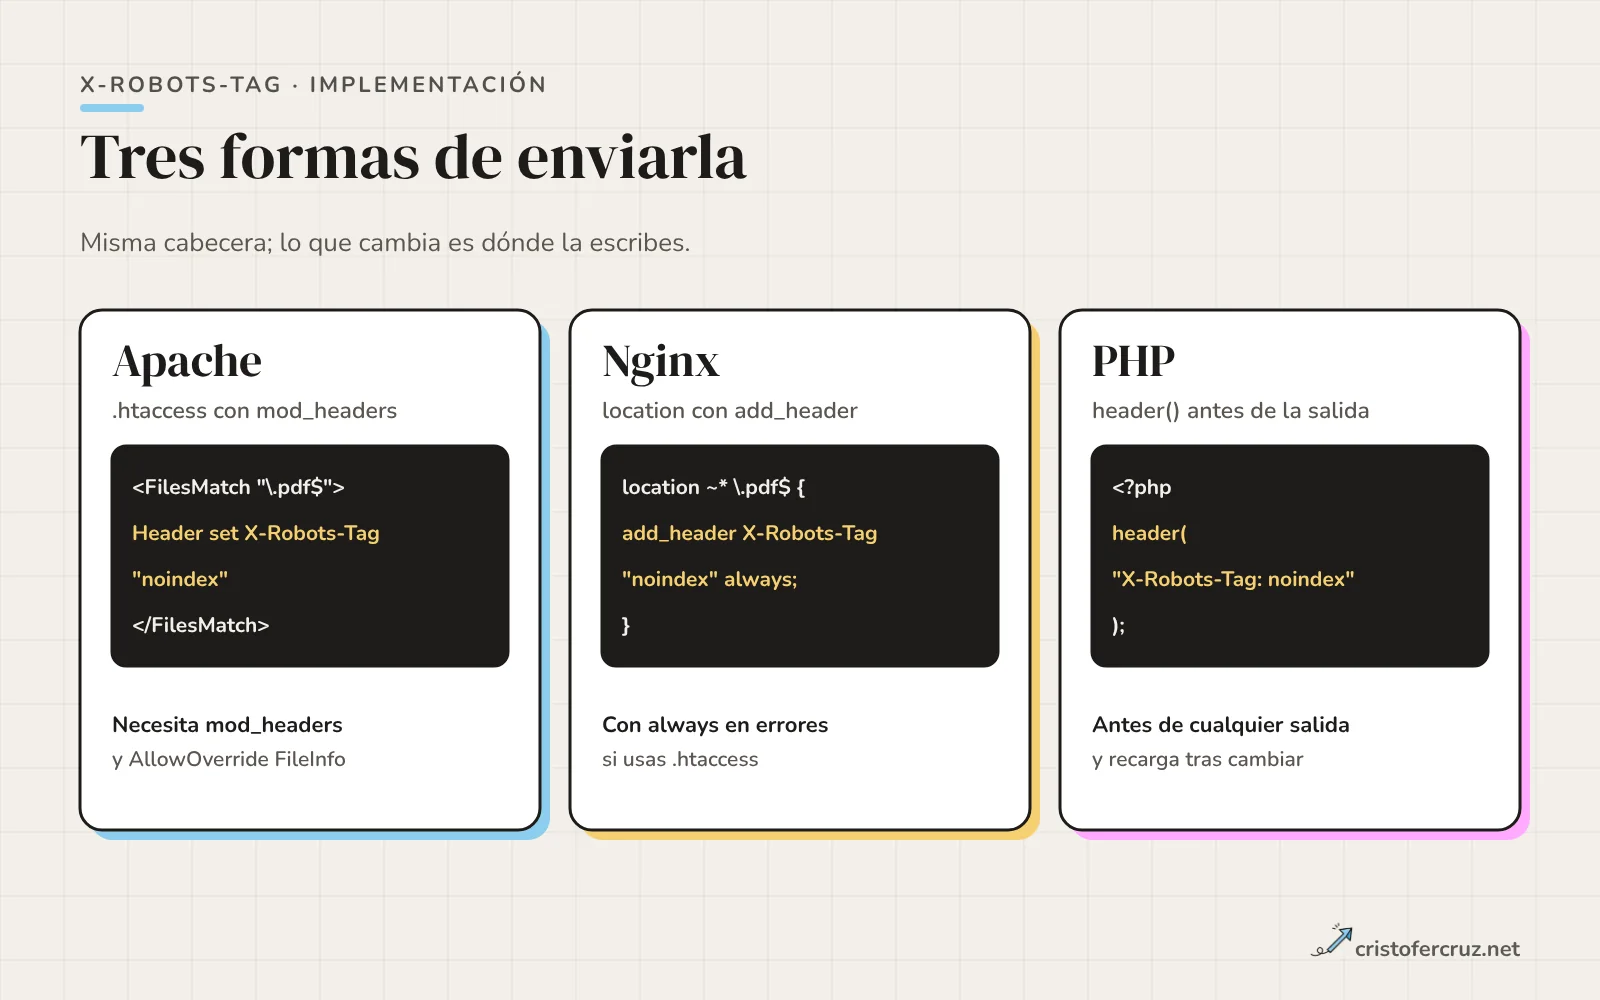
<IfModule mod_headers.c>
  <FilesMatch "\.(pdf|docx?|xlsx?)$">
    Header set X-Robots-Tag "noindex, nofollow"
  </FilesMatch>
</IfModule>
El ejemplo de la documentación de Google usa <Files ~ "\.pdf$"> con la misma idea. Tres detalles que he visto fallar:
- El punto va escapado (
\.). Sin escapar,.pdf$coincide con cualquier carácter antes depdf. - La expresión distingue mayúsculas. Un
Informe.PDFno encaja con\.pdf$; añade(?i)al principio si hay extensiones en mayúsculas. - Sin condición,
Header setactúa sobre las respuestas 2xx. Para que se añada también en errores, la documentación de Apache indica la condiciónalways:Header always set X-Robots-Tag "noindex".
Una carpeta entera
Para toda una carpeta, coloca un .htaccess dentro de ella con Header set X-Robots-Tag "noindex, nofollow", o usa un bloque <Directory> o <Location> en la configuración del servidor si tienes acceso. Para los ficheros PDF de una ruta, FilesMatch dentro de ese .htaccess es suficiente.
Implementación en Nginx
En Nginx se usa add_header dentro de un bloque location. Es el ejemplo que da Google, con la misma lógica que en Apache:
location ~* \.(pdf|docx?|xlsx?)$ {
    add_header X-Robots-Tag "noindex, nofollow" always;
}
Dos reglas de la documentación de Nginx evitan los problemas más comunes:
always: sin este parámetro, la cabecera solo se añade en las respuestas con código 200, 201, 204, 206, 301, 302, 303, 304, 307 o 308. Conalways, se añade con cualquier código.- Herencia: los
add_headerde un nivel se heredan al siguiente solo si el nivel actual no define ninguno propio. Si añades unadd_headeren unlocationque ya tenía otros definidos en elserver, los delserverdejan de aplicarse ahí. Es la razón por la que a veces desaparecen cabeceras de seguridad al añadir una de SEO.
Tras cada cambio, recarga la configuración (nginx -s reload) después de validarla con nginx -t.
Implementación en PHP
Cuando la respuesta la genera tu código, lo más simple es enviar la cabecera desde ahí con header():
<?php
header('X-Robots-Tag: noindex, nofollow');
// resto de la respuesta
Según el manual de PHP, header() debe llamarse antes de enviar cualquier contenido, y un espacio o una línea en blanco antes de la etiqueta <?php en un include basta para romperlo; en ese caso PHP emite un E_WARNING. Además, por defecto header() reemplaza una cabecera anterior del mismo nombre: si quieres enviar varias X-Robots-Tag, pasa false como segundo parámetro. En un CMS o un framework conviene hacerlo en el punto donde se prepara la respuesta, no en una plantilla ya renderizada.
Este método es el que cubre los casos dinámicos que ni Apache ni Nginx ven con un patrón: un listado filtrado, una respuesta de error personalizada o un endpoint JSON.
Qué pasa cuando las reglas chocan
Las reglas pueden llegar de varios sitios a la vez: una meta robots en el HTML, una o varias cabeceras del servidor, otra que añade un plugin o la CDN. La documentación de Google lo resuelve así: ante reglas en conflicto, se aplica la más restrictiva. Su ejemplo: si una página tiene max-snippet:50 y nosnippet, se aplica nosnippet.
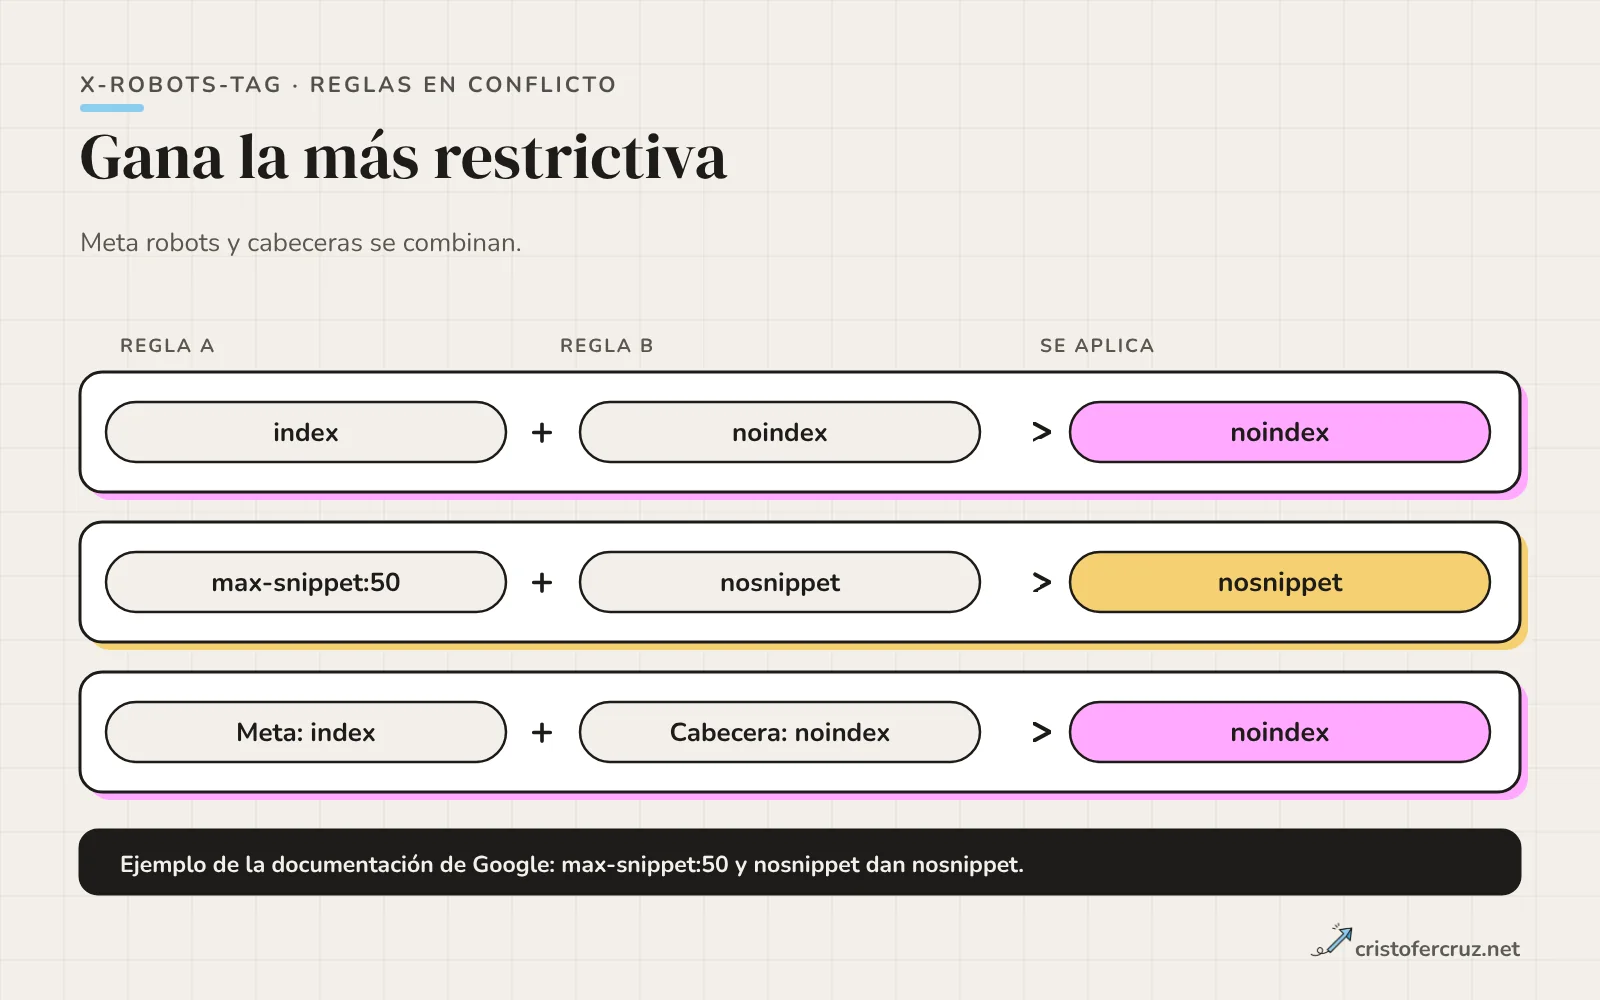
En la práctica significa dos cosas. La primera: no puedes anular un noindex de la cabecera poniendo index en la meta robots; la cabecera seguirá mandando. La segunda: un noindex heredado de un entorno de staging, una regla genérica de servidor o una opción de un plugin puede seguir activo sin que lo veas en el HTML. Por eso, cuando una página no se indexa y su meta robots parece limpia, miro las cabeceras antes que nada.
Si una URL no se indexa y en el código fuente no hay ningún noindex, ejecuta curl -I contra ella. La cabecera no aparece en el código fuente y es un sitio donde suele esconderse un noindex que nadie puso a propósito.
La trampa: bloquear en robots.txt y esperar que funcione el noindex
Es un error muy repetido. Alguien quiere sacar de Google un conjunto de PDF, pone noindex en la cabecera y, por si acaso, añade un Disallow en robots.txt. El Disallow anula la cabecera.
La cabecera solo se lee si Google pide la URL. Si robots.txt se lo impide, Google no recibe la respuesta, no ve la cabecera y el noindex no se aplica. La documentación de Google lo dice de forma explícita: si las reglas de indexación o de servido deben cumplirse, las URLs que las contienen no pueden estar bloqueadas para el rastreo. Y una URL bloqueada puede seguir apareciendo en los resultados, sin descripción, si otras páginas la enlazan.
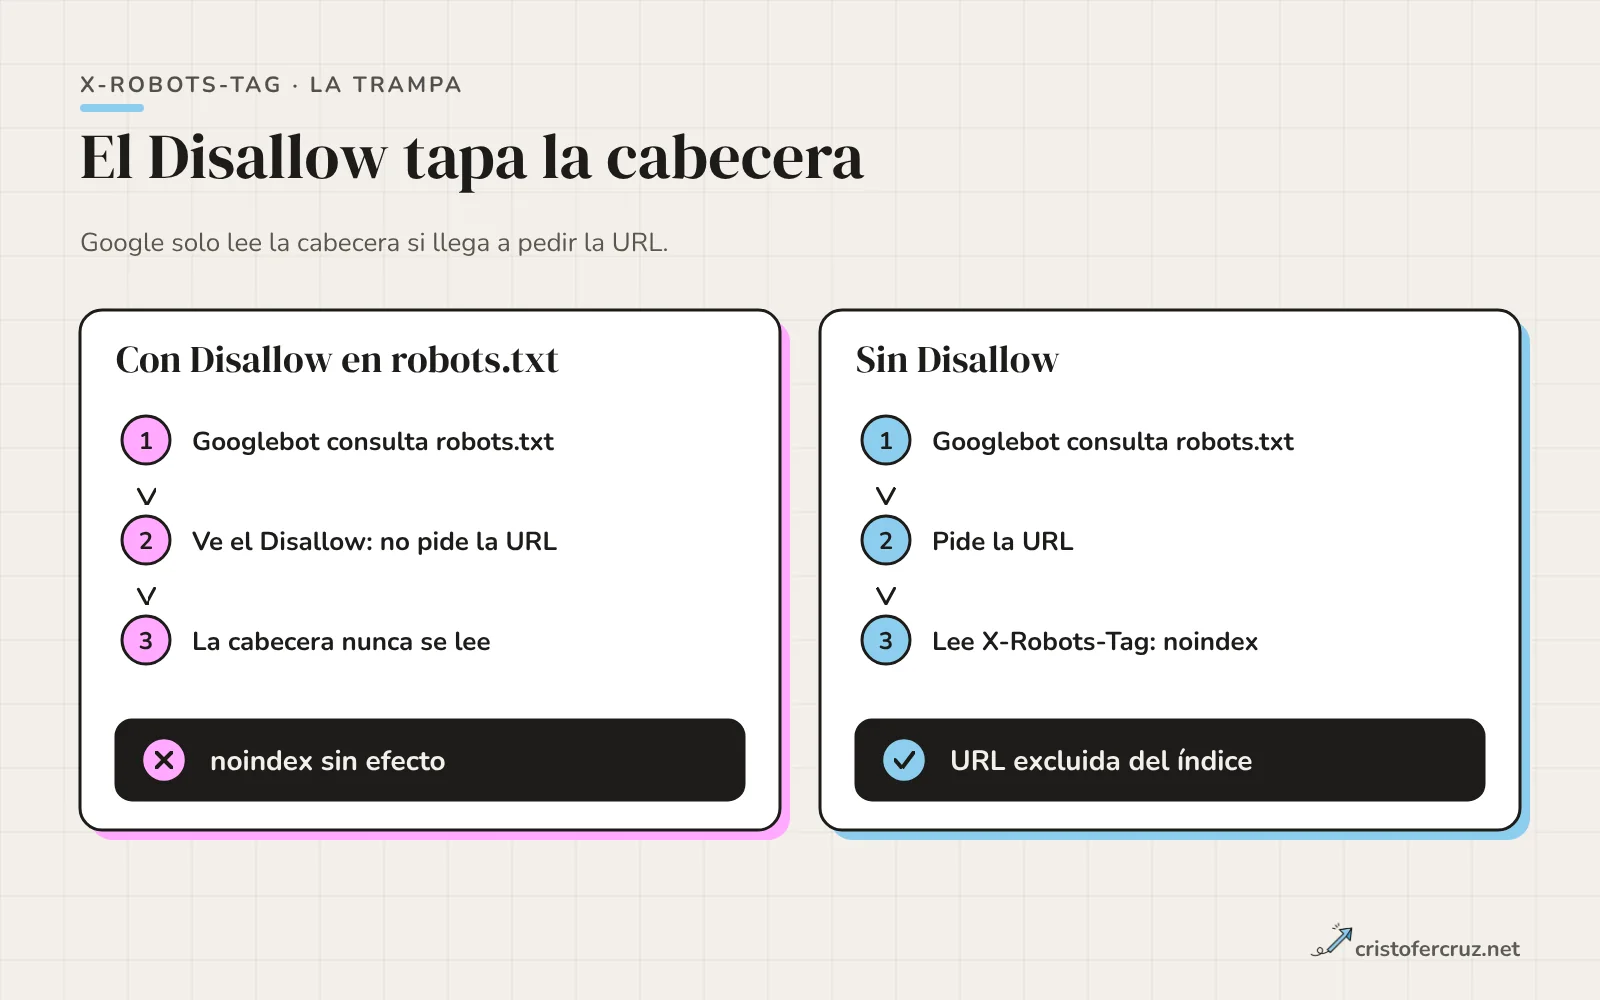
El orden correcto es dejar la URL rastreable con su noindex, esperar a que Google la procese y, solo entonces, si hace falta ahorrar rastreo, valorar el bloqueo. Para el detalle de cómo funcionan los bloqueos, lo cuento en el artículo sobre robots.txt.
Esto enlaza con otra confusión: X-Robots-Tag controla indexación y servido, no rastreo. Google rastrea la URL para leer la cabecera, así que tampoco ahorra presupuesto de rastreo. Si el objetivo es solo recortar fragmentos en lugar de excluir la página, las directivas nosnippet y max-snippet hacen eso, y para un trozo concreto del texto tienes data-nosnippet.
Cómo la uso en mi web
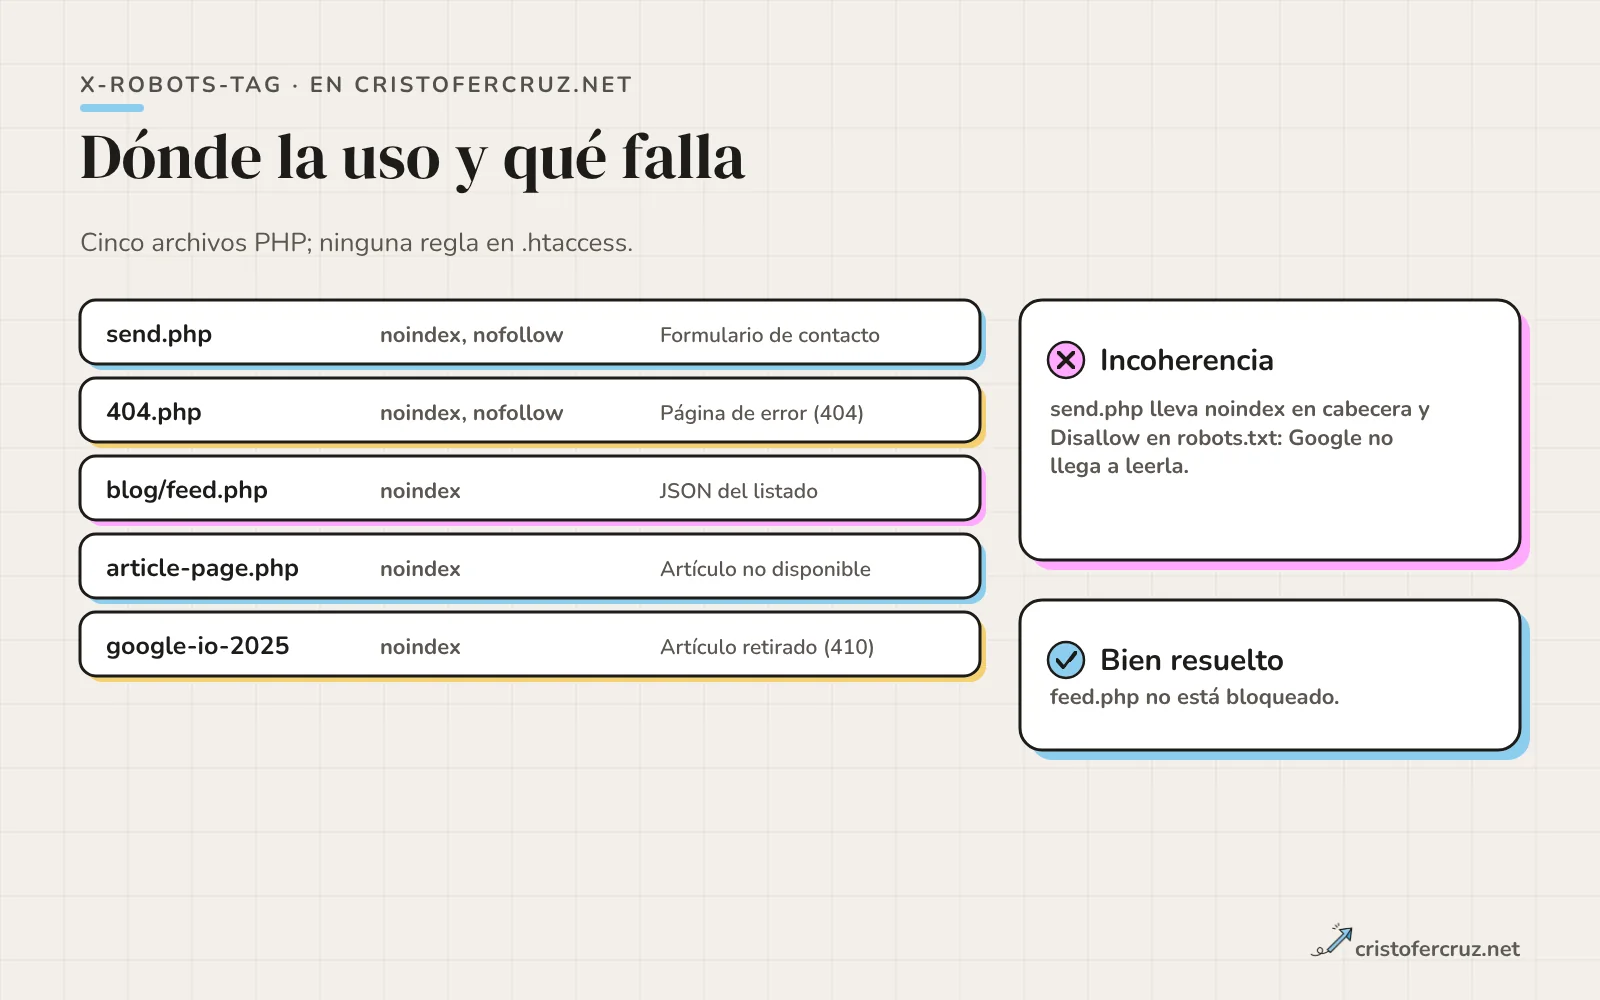
Lo que sigue sale de leer el código de este sitio, no de lo que me gustaría tener. El uso real de X-Robots-Tag es pequeño y siempre desde PHP:
| Archivo | Cabecera | Para qué |
|---|---|---|
send.php | noindex, nofollow | Procesa el formulario de contacto. No es una página para el buscador. |
404.php | noindex, nofollow | Página de error. Responde con 404 real y, además, lleva meta robots noindex, nofollow en el HTML. |
blog/feed.php | noindex | Respuesta JSON que carga el listado del blog. No es contenido indexable. |
includes/article-page.php | noindex | Solo en un caso: el artículo no existe, no está publicado o le falta el cuerpo (devuelve 404). |
blog/google-io-2025/index.php | noindex | Artículo retirado: responde con 410 y un aviso de que se ha retirado. |
Todo lo demás lleva la etiqueta meta en el HTML. La plantilla includes/header.php imprime por defecto index, follow, max-image-preview:large, max-snippet:-1, max-video-preview:-1, y el listado del blog cambia a noindex, follow cuando hay un filtro de categoría o una búsqueda. Esa es la razón por la que esas URLs no usan cabecera: son HTML y puedo controlarlas desde la plantilla.
Lo que no tengo: ninguna regla de X-Robots-Tag en el .htaccess. Hoy no hay ningún PDF en el sitio, así que no he necesitado un FilesMatch. El .htaccess sí usa Header always set para otras cabeceras (X-Content-Type-Options, Referrer-Policy y X-Frame-Options), y de ahí saldría el patrón si tuviera que sumar uno.
Dos incoherencias que he encontrado al revisarlo
La primera es justo la trampa de la sección anterior. send.php envía X-Robots-Tag: noindex, nofollow, pero mi robots.txt tiene Disallow: /send.php. Con el Disallow, Googlebot no pide esa URL y la cabecera nunca llega a leerse. Aquí no tiene consecuencias prácticas, porque un GET a send.php sin un envío previo devuelve 405 con el mensaje «Envía tu consulta desde el formulario de la web» y no hay contenido que indexar. Pero la cabecera, tal como está, no cumple función ante Google. Si quisiera que la regla fuera efectiva, tendría que quitar el Disallow, o asumir que el bloqueo es la única protección y retirar la cabecera para no aparentar una garantía que no existe.
La segunda es menor. En article-page.php, el 404 por artículo no publicado envía noindex, pero los otros dos casos de 404 (fecha futura y cuerpo vacío) responden 404 sin la cabecera. Un 404 ya sirve para que Google deje de indexar la URL, así que no es grave; lo dejo anotado porque si algún día cambiara el código de estado, la cabecera tampoco estaría en esos casos.
Un acierto del mismo archivo de robots.txt: en él hay un comentario que dice que /blog/feed.php no se bloquea porque participa en la carga del listado. Eso deja la URL rastreable y la cabecera noindex de feed.php sí se puede leer, que es el patrón correcto.
Cómo comprobar que funciona
La cabecera no se ve en el código fuente, así que hay que mirarla en la respuesta. Este es el orden que sigo:
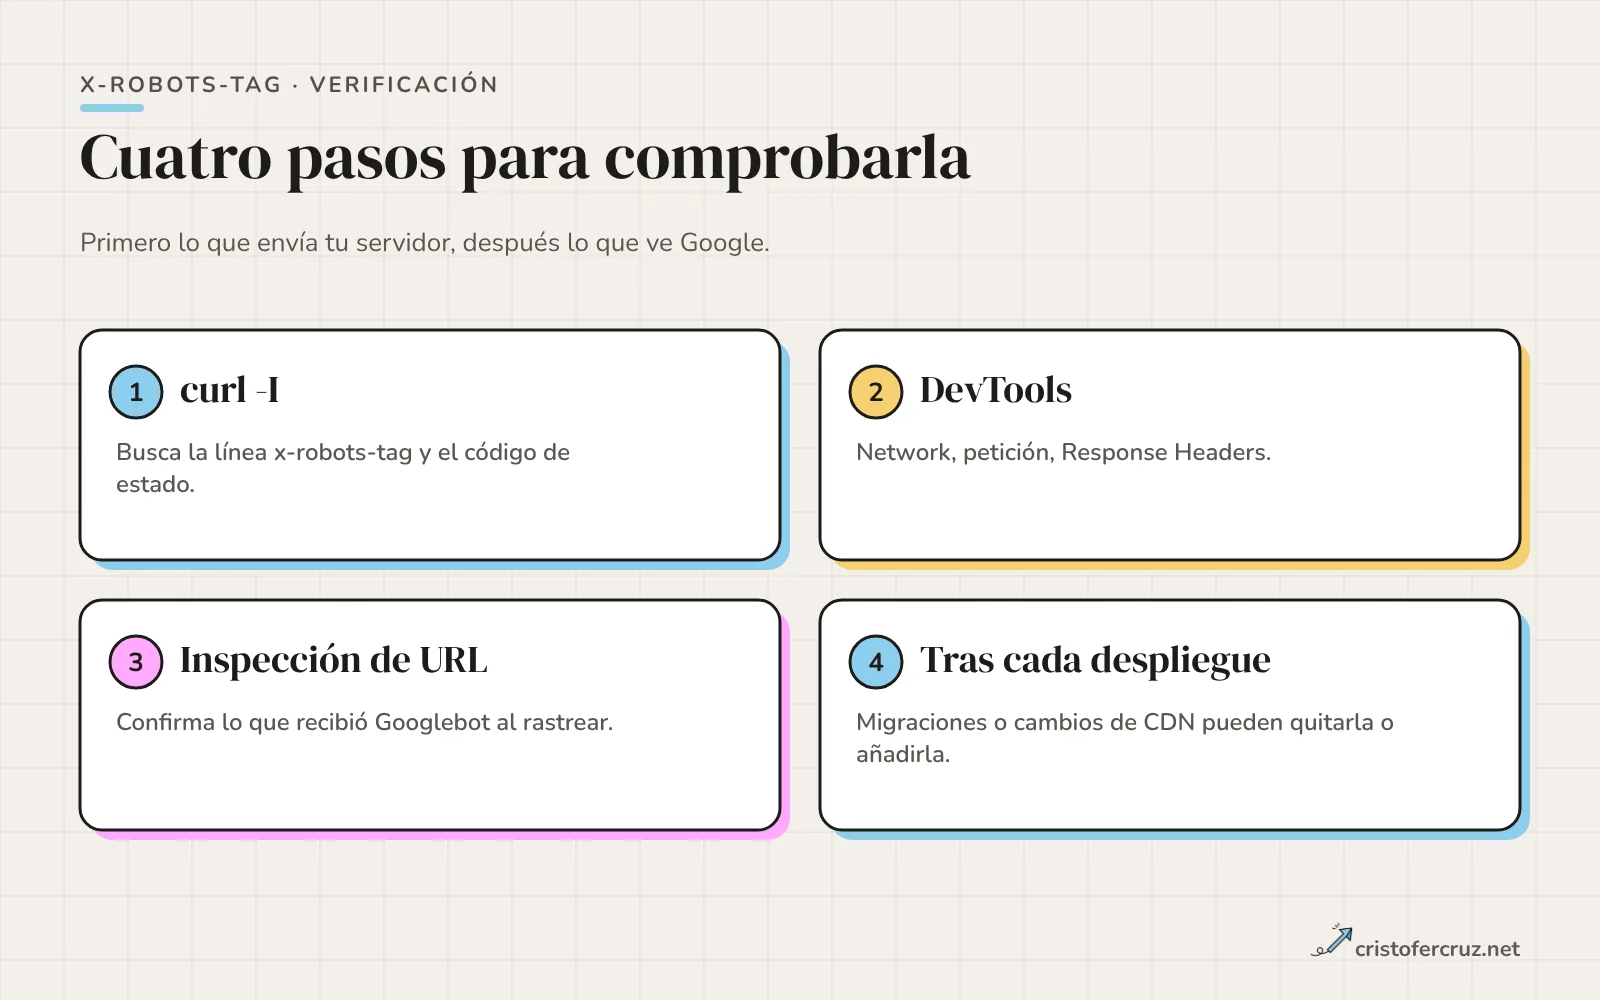
- curl -I. Muestra solo las cabeceras de la respuesta:
Busca la líneacurl -I https://tudominio.com/archivo.pdfx-robots-tagy comprueba que el código de estado es el esperado. Algunos servidores o aplicaciones responden distinto a una petición HEAD que a un GET; si dudas,curl -s -D - -o /dev/null URLhace un GET y muestra solo las cabeceras. - DevTools. En la pestaña Network, selecciona la petición y revisa «Response Headers». Útil para páginas que cargan tras un redirect.
- Inspección de URL en Search Console. La documentación de Google indica que la herramienta permite ver lo que recibió Googlebot al rastrear la URL. Sirve para confirmar que la regla llegó, no para saber cuándo desaparecerá del índice.
- Tras cada despliegue. Una migración, un cambio de CDN o un nuevo bloque
locationpueden quitar o añadir la cabecera sin que nadie lo note. Compruébala después de tocar el servidor.
Dos comprobaciones cruzadas más: que la URL no esté en Disallow, y que no aparezca en el sitemap XML si le has puesto noindex, porque es una señal contradictoria.
Un noindex no saca la URL del índice en el momento. Google tiene que volver a rastrearla. Google no documenta un plazo y yo tampoco te lo voy a inventar: depende de la frecuencia de rastreo de esa URL.
Errores frecuentes
| Error | Qué provoca | Cómo evitarlo |
|---|---|---|
| Disallow en robots.txt y noindex en cabecera a la vez | Google no lee la cabecera; la URL puede seguir en resultados sin descripción | Dejar la URL rastreable hasta que desaparezca |
| Regex sin escapar el punto ni anclar el final | La regla afecta a más archivos de los previstos | Usar \.pdf$ y probar con curl en URLs que no deberían encajar |
add_header en Nginx sin always | La cabecera no se envía en respuestas de error | Añadir always |
add_header en un location que ya tenía otros | Se pierden las cabeceras del nivel superior | Repetirlas en el location o revisar la herencia |
| Regla heredada de staging | El sitio en producción se queda en noindex | Revisar cabeceras y meta robots en cada despliegue |
header() tras salida de HTML | La cabecera no se envía y PHP lanza un aviso | Enviarla antes de cualquier salida |
Fecha mal escrita en unavailable_after | La regla se ignora sin aviso | Usar un formato de los que cita Google, con zona horaria |
Preguntas frecuentes
¿X-Robots-Tag sustituye a la meta robots?
No hace falta que la sustituya. Expresan las mismas instrucciones por dos vías. En páginas HTML que puedes editar, prefiero la meta robots por visibilidad. La cabecera es necesaria cuando no hay HTML, como en PDF o imágenes, o cuando quieres aplicar una regla por patrón desde el servidor.
¿Cómo pongo noindex a un PDF?
Enviando X-Robots-Tag: noindex en la respuesta de ese PDF, con un FilesMatch en Apache o un location en Nginx. El PDF debe poder rastrearse: no lo bloquees en robots.txt, o Google no verá la cabecera.
¿Puedo dirigir la regla solo a Googlebot?
Sí. Se antepone el user-agent: X-Robots-Tag: googlebot: noindex. Las reglas sin user-agent se aplican a todos los rastreadores, y las que llevan uno solo a ese.
¿Qué ocurre si la meta robots dice index y la cabecera dice noindex?
Se aplica la regla más restrictiva, así que la página no se indexa. La documentación de Google lo ilustra con max-snippet:50 y nosnippet, donde gana nosnippet.
¿Por qué no funciona mi noindex si lo tengo en la cabecera?
Las causas habituales son tres: la URL está bloqueada en robots.txt, la cabecera no llega porque otra capa (CDN, proxy) la elimina, o aún no se ha vuelto a rastrear. Empieza con curl -I y mira después la Inspección de URL.
¿Cuánto tarda Google en aplicar la cabecera?
Google no documenta un plazo. La regla se descubre cuando la URL se rastrea, así que depende de cuándo vuelva a pasar por ella. Para unavailable_after solo documenta que, tras la fecha, reduce considerablemente la frecuencia de rastreo.
¿Se puede combinar con data-nosnippet?
Son controles de ámbitos distintos. La cabecera, con nosnippet o max-snippet, afecta a toda la URL; data-nosnippet excluye solo un fragmento dentro de una página HTML. Si pones nosnippet en la cabecera, el atributo sobra en esa página.
Referencias y fuentes
Documentación consultada para este artículo.
- Robots Meta Tags Specifications Google Search Central
- Block Search indexing with noindex Google Search Central
- Introduction to robots.txt Google Search Central
- Apache Module mod_headers Apache HTTP Server
- Module ngx_http_headers_module nginx.org
- header() Manual de PHP
- X-Robots-Tag Sánchez Donate
- Robots Meta Tag y X-Robots-Tag: qué es y cómo usarlo Semrush