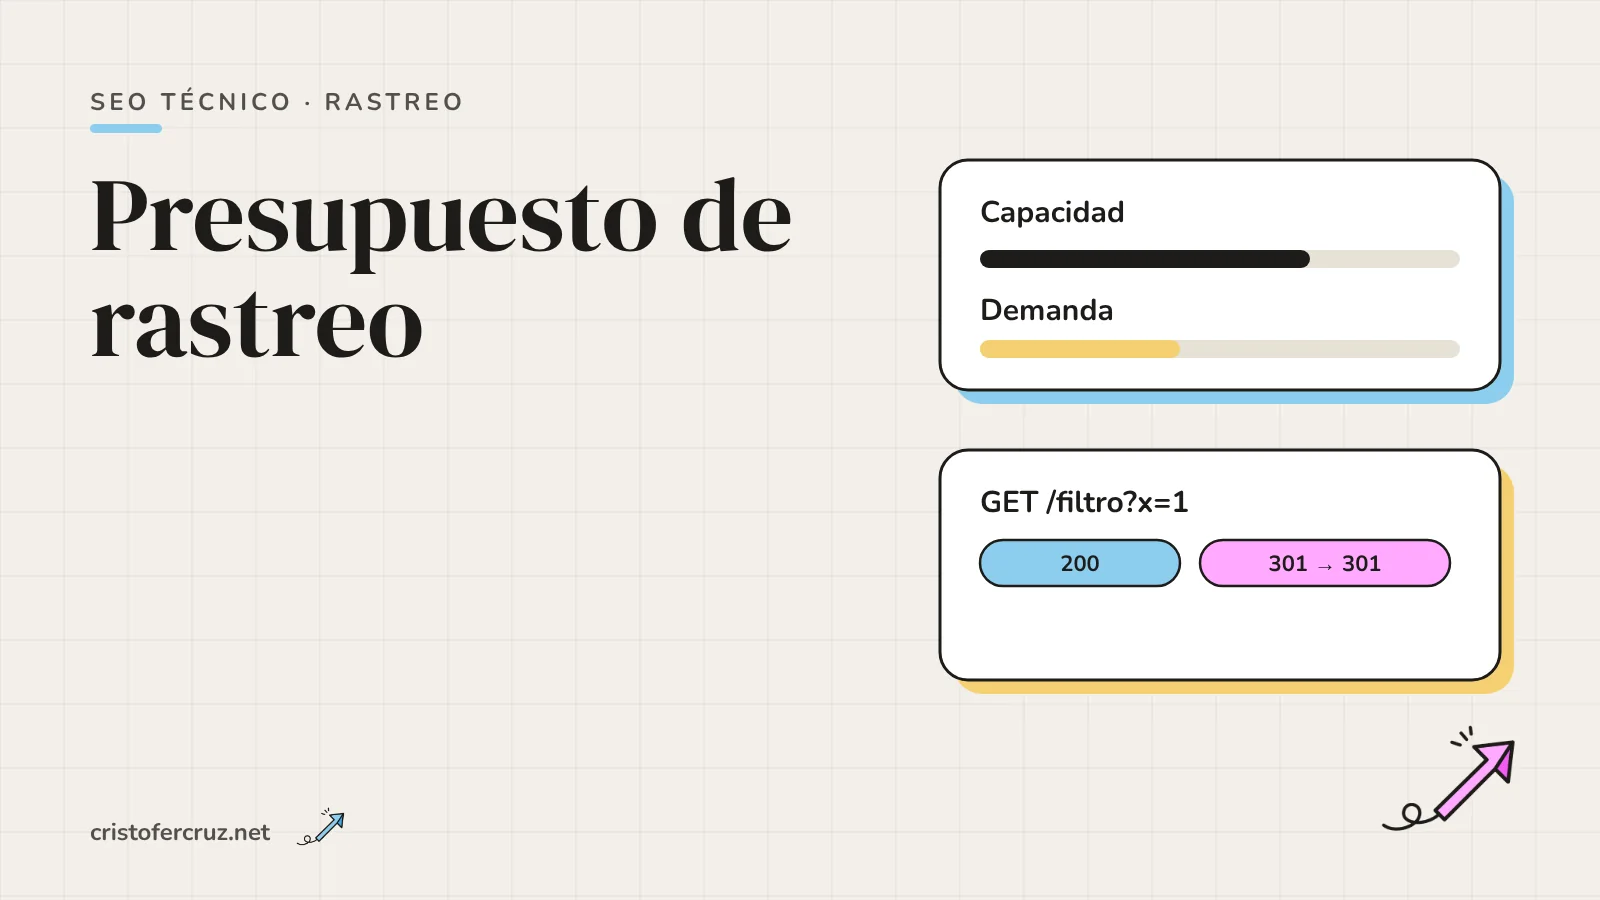
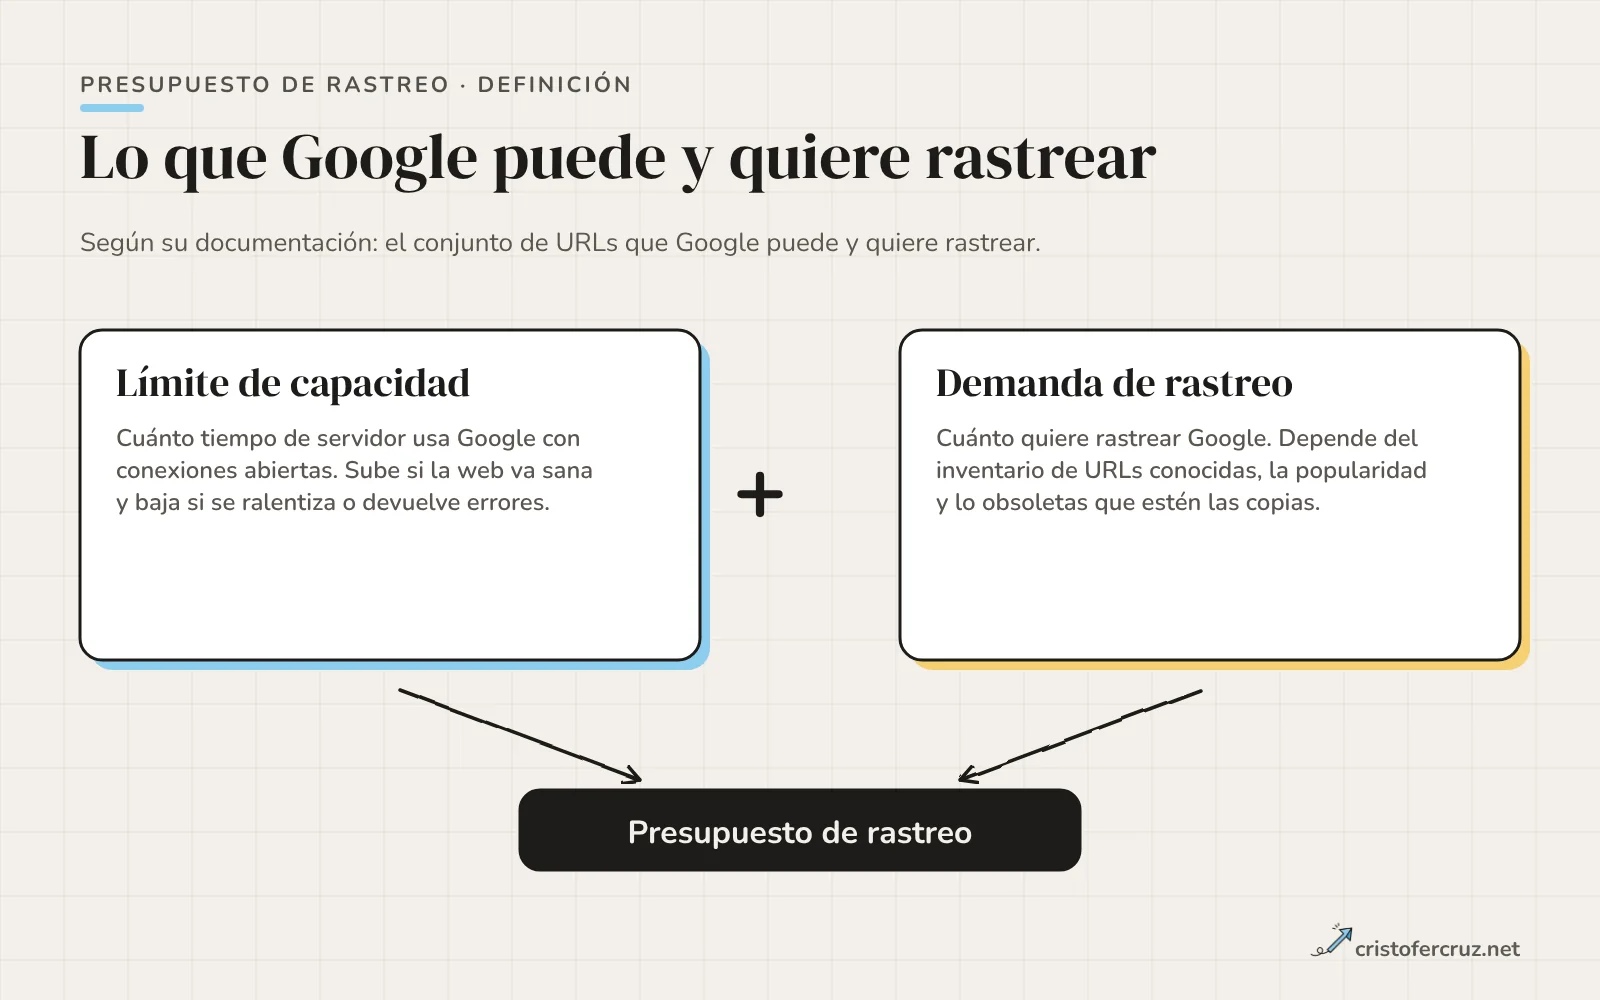
- Google define el presupuesto de rastreo como el conjunto de URLs que puede rastrear y quiere rastrear: límite de capacidad más demanda de rastreo.
- Su guía lo dirige a sitios de más de 1 millón de páginas con cambios semanales, a sitios de más de 10.000 con cambios diarios y a sitios con muchas URLs «Descubierta: actualmente sin indexar». Son estimaciones, no umbrales exactos.
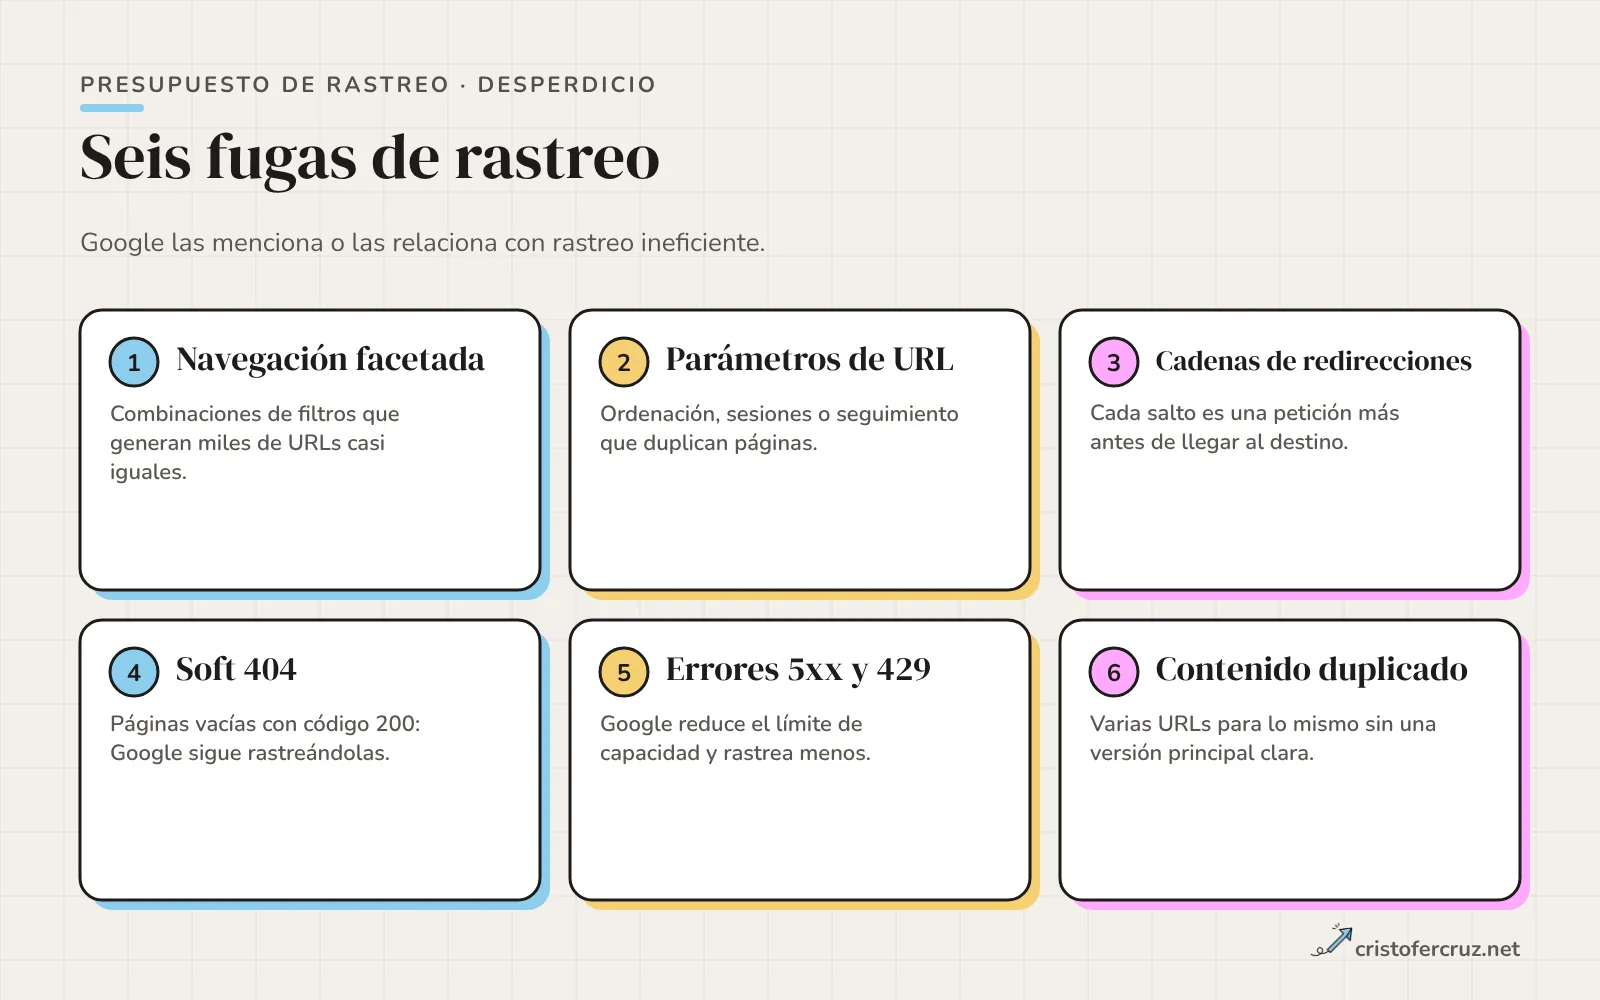
- Lo que más rastreo gasta: URLs facetadas y con parámetros, cadenas de redirecciones, soft 404, contenido duplicado y errores 5xx.
- La documentación de Google no presenta el presupuesto de rastreo como factor de ranking, y rastrear una página no garantiza indexarla.
- Se mide con el informe de estadísticas de rastreo de Search Console y, con más detalle, con los logs del servidor.
- En una web pequeña, como la mía, el presupuesto de rastreo no es el problema: casi siempre lo es la calidad o la indexación.
Cada vez que una web tarda en indexar contenido nuevo aparece la misma explicación: «es un problema de crawl budget». En la mayoría de los casos que he revisado no lo es. El presupuesto de rastreo es un concepto real y medible, pero Google lo plantea para un tipo concreto de sitio, y aplicarlo a una web de 60 URLs es buscar el problema en el sitio equivocado.
Este artículo parte de la documentación de Google para separar qué es, a quién afecta y qué no es, y después baja a lo práctico: qué desperdicia rastreo, cómo medirlo y en qué orden actuar. Incluye una sección sobre mi propia web, que es pequeña y lo demuestra.
Qué es el presupuesto de rastreo
La guía de Google para sitios grandes define el presupuesto de rastreo como el conjunto de URLs que Googlebot puede rastrear y quiere rastrear. Esa definición tiene dos mitades, y conviene tratarlas por separado porque se arreglan de formas distintas.
Límite de capacidad de rastreo
Es el tope de tiempo de servidor que Google está dispuesto a gastar en tu sitio: limita cuánto tiempo mantiene conexiones abiertas con tu servidor, según las conexiones en paralelo y su duración. Sube cuando el sitio responde rápido y estable, y baja cuando se ralentiza o devuelve errores. Es la mitad que controlas con infraestructura.
Demanda de rastreo
Es cuánto quiere rastrear Google. Depende del tamaño del sitio, de la frecuencia con la que cambia y de la calidad y relevancia de las páginas. La documentación señala tres factores principales: el inventario percibido (las URLs que Google conoce de tu sitio), la popularidad y la obsolescencia, es decir, cuánto hace que no se recrawlea una URL. Es la mitad que controlas con contenido y arquitectura.
Un detalle que se pasa por alto: aunque no llegues al límite de capacidad, una demanda baja también limita el rastreo. Un servidor holgado no hace que Google rastree más si no ve motivos para volver.
A quién le importa de verdad
Google es explícito sobre el público de esta guía y da tres perfiles, que él mismo califica de estimación aproximada y no de umbrales exactos.
| Perfil | Referencia de Google |
|---|---|
| Sitios muy grandes | Más de 1 millón de páginas únicas, con contenido que cambia con cierta frecuencia (una vez por semana) |
| Sitios medianos o grandes con cambios rápidos | Más de 10.000 páginas únicas, con contenido que cambia a diario |
| Sitios con muchas URLs sin indexar | Muchas URLs clasificadas en Search Console como «Descubierta: actualmente sin indexar» |
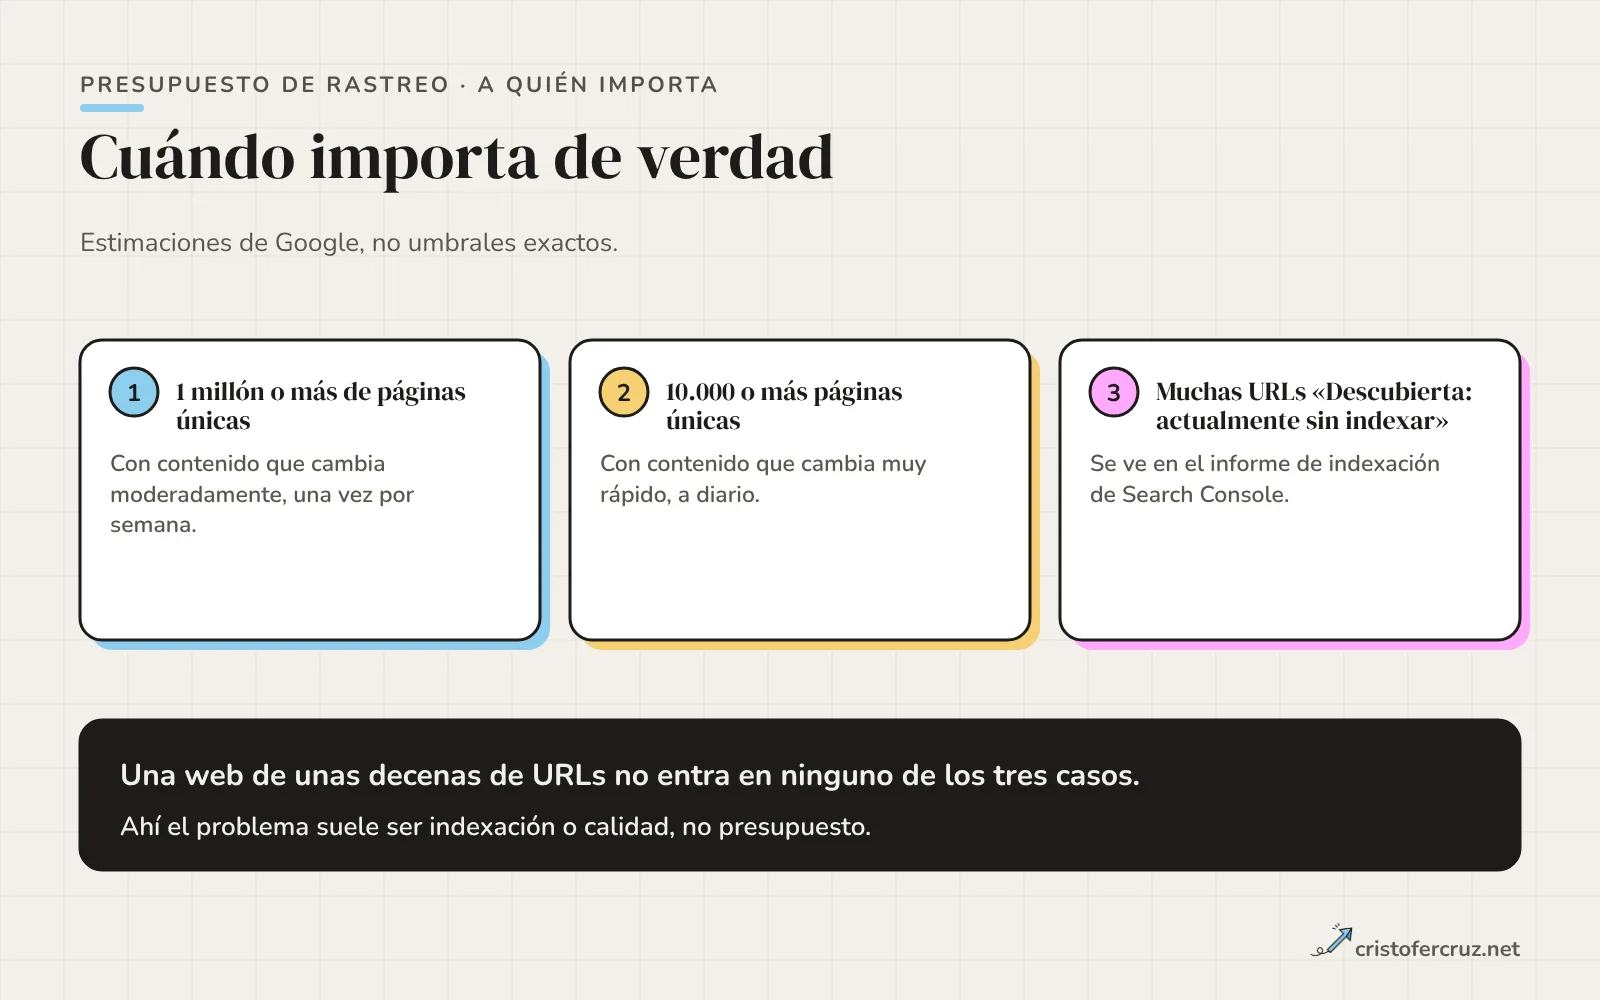
Los dos primeros son sitios como grandes ecommerce, portales de anuncios, medios o marketplaces. El tercero es el más útil como señal práctica: si tienes un volumen alto de URLs descubiertas y sin indexar, merece la pena mirar si el rastreo se está yendo a otro sitio. Si tienes pocas, no.
La propia página de ayuda del informe de estadísticas de rastreo dice algo en la misma línea: es un informe para usuarios avanzados y los sitios con menos de unas 1.000 páginas probablemente no lo necesitan. Es una pista de la escala a la que Google considera que esto empieza a importar.
Antes de hablar de presupuesto de rastreo en una web pequeña, descarta lo básico: que la URL se pueda rastrear, que no tenga noindex, que esté enlazada desde otras páginas y que el contenido aporte algo que ya no exista en el índice. Eso explica la mayoría de «no me indexa» que he visto.
Qué desperdicia presupuesto de rastreo
Desperdiciar presupuesto es dedicar rastreo a URLs que no deberían competir por él. La documentación de Google lista las palancas para reducirlo y los problemas aparecen siempre agrupados en seis familias.
URLs facetadas y parámetros
Una categoría con filtros por talla, color, precio y orden puede generar miles de combinaciones que muestran casi lo mismo. Cada una es una URL distinta que Google conoce y puede querer visitar. Lo mismo ocurre con parámetros de ordenación, identificadores de sesión o campañas que acaban enlazados internamente. La solución depende del caso: consolidar con canonical, no enlazar combinaciones sin valor o bloquearlas con robots.txt.
Redirecciones en cadena
Cada salto es una petición más. La guía de Google pide evitar las cadenas largas porque afectan negativamente al rastreo. Según su documentación de errores de red, Googlebot sigue por defecto hasta 10 saltos, así que una cadena corta no rompe nada, pero tampoco hay motivo para mantenerla: enlaza internamente al destino final.
Soft 404
Una página que dice «no encontrado» pero devuelve un 200 sigue en la cola. La guía lo dice sin rodeos: las soft 404 se seguirán rastreando y gastan presupuesto. Se detectan en el informe de indexación de páginas de Search Console.
Errores 5xx y lentitud
Los errores de servidor y las señales de límite de velocidad como el 429 hacen que Google baje el límite de capacidad y rastree menos. Según su documentación sobre errores HTTP, cuando el servidor vuelve a responder con 2xx el ritmo sube de forma gradual, no de golpe. Un pico de 503 en una migración tiene consecuencias que duran más que el pico.
Contenido duplicado y URLs obsoletas
Varias URLs para lo mismo diluyen la demanda y llenan el inventario; el canonical bien implementado ayuda a consolidarlas, aunque Google solo lo trata como pista. Para páginas eliminadas, un 404 o un 410 es una señal fuerte de no volver a rastrear esa URL. Google no olvida una URL que ya conoce, pero la visita cada vez menos.
Qué no es el presupuesto de rastreo
Aquí circulan más mitos que en cualquier otro tema de SEO técnico. Los cuatro que más veo, contrastados con la documentación:
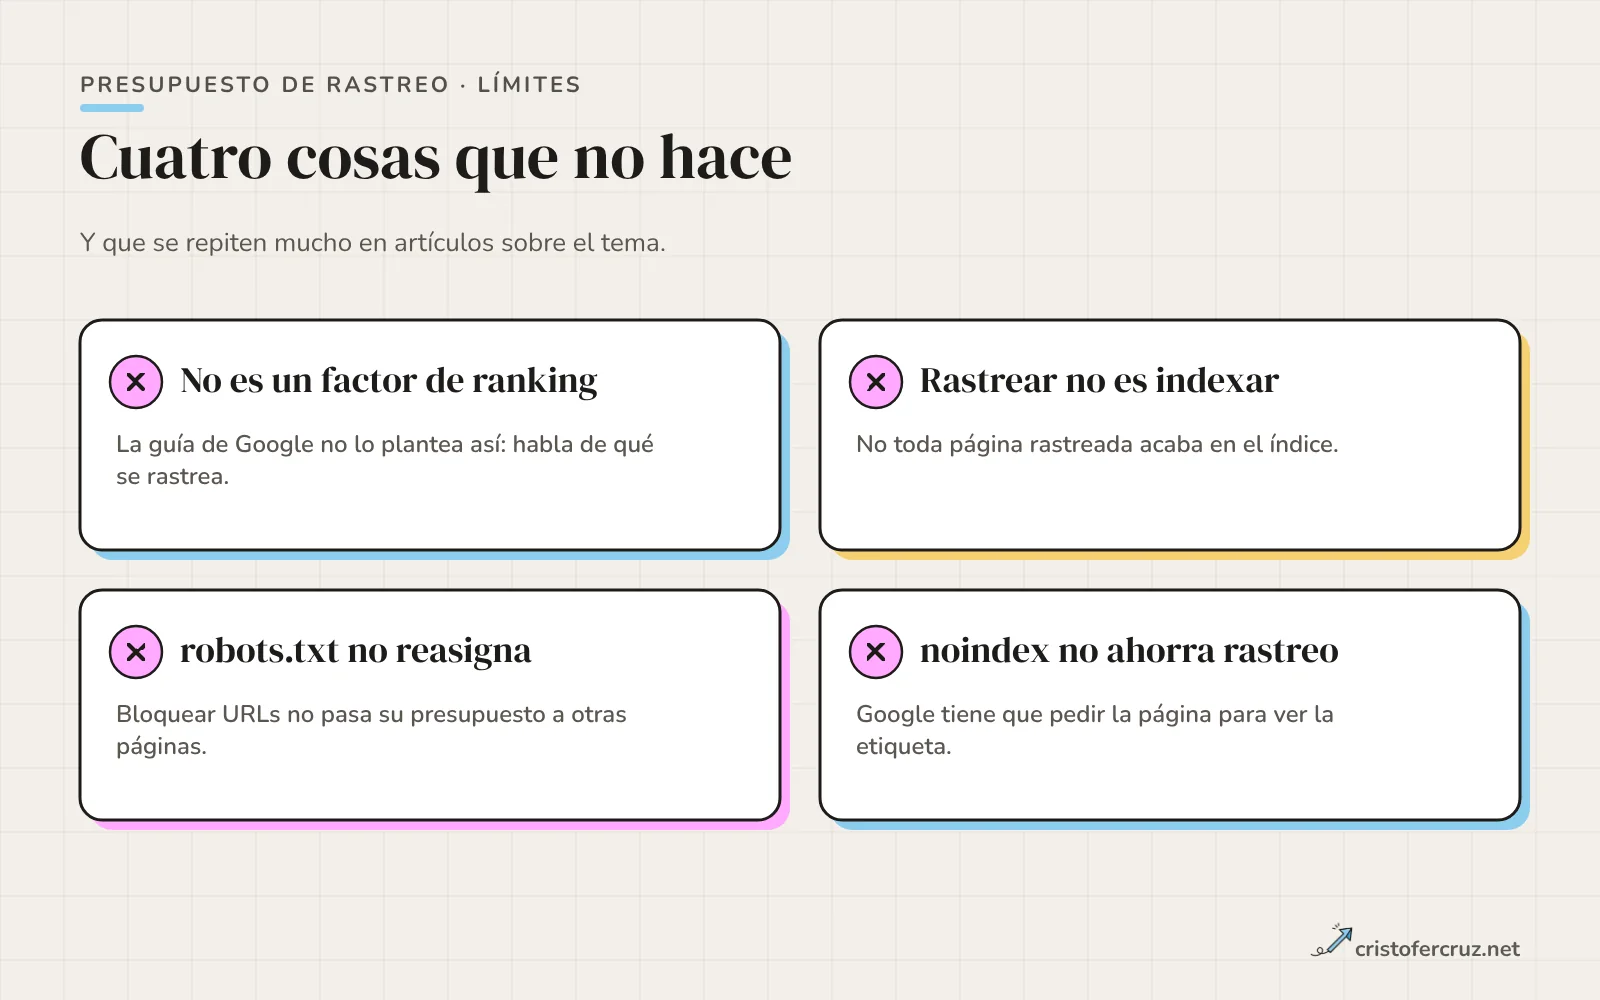
- No es un factor de ranking directo. La guía de Google no habla de posicionamiento: habla de qué URLs se rastrean y con qué frecuencia. Que una URL se rastree más no dice nada sobre en qué posición saldrá. Un matiz honesto: indirectamente, una página que no se rastrea no puede indexarse ni posicionar.
- Rastrear no es indexar. La propia guía recuerda que no todas las páginas rastreadas se indexan.
- Bloquear con robots.txt no regala presupuesto a otras páginas. Google advierte de que no reasignará el presupuesto liberado salvo que ya estés en el límite de capacidad de tu sitio.
- Noindex no ahorra rastreo. Google tiene que pedir la página para ver la etiqueta, y la sigue pidiendo. Con la cabecera X-Robots-Tag pasa igual: para leerla hay que rastrear la URL.
Tampoco se compra ni se pide. Las palancas son las que describe este artículo: un servidor sano y un inventario de URLs limpio.
Cómo responde Google a cada respuesta del servidor
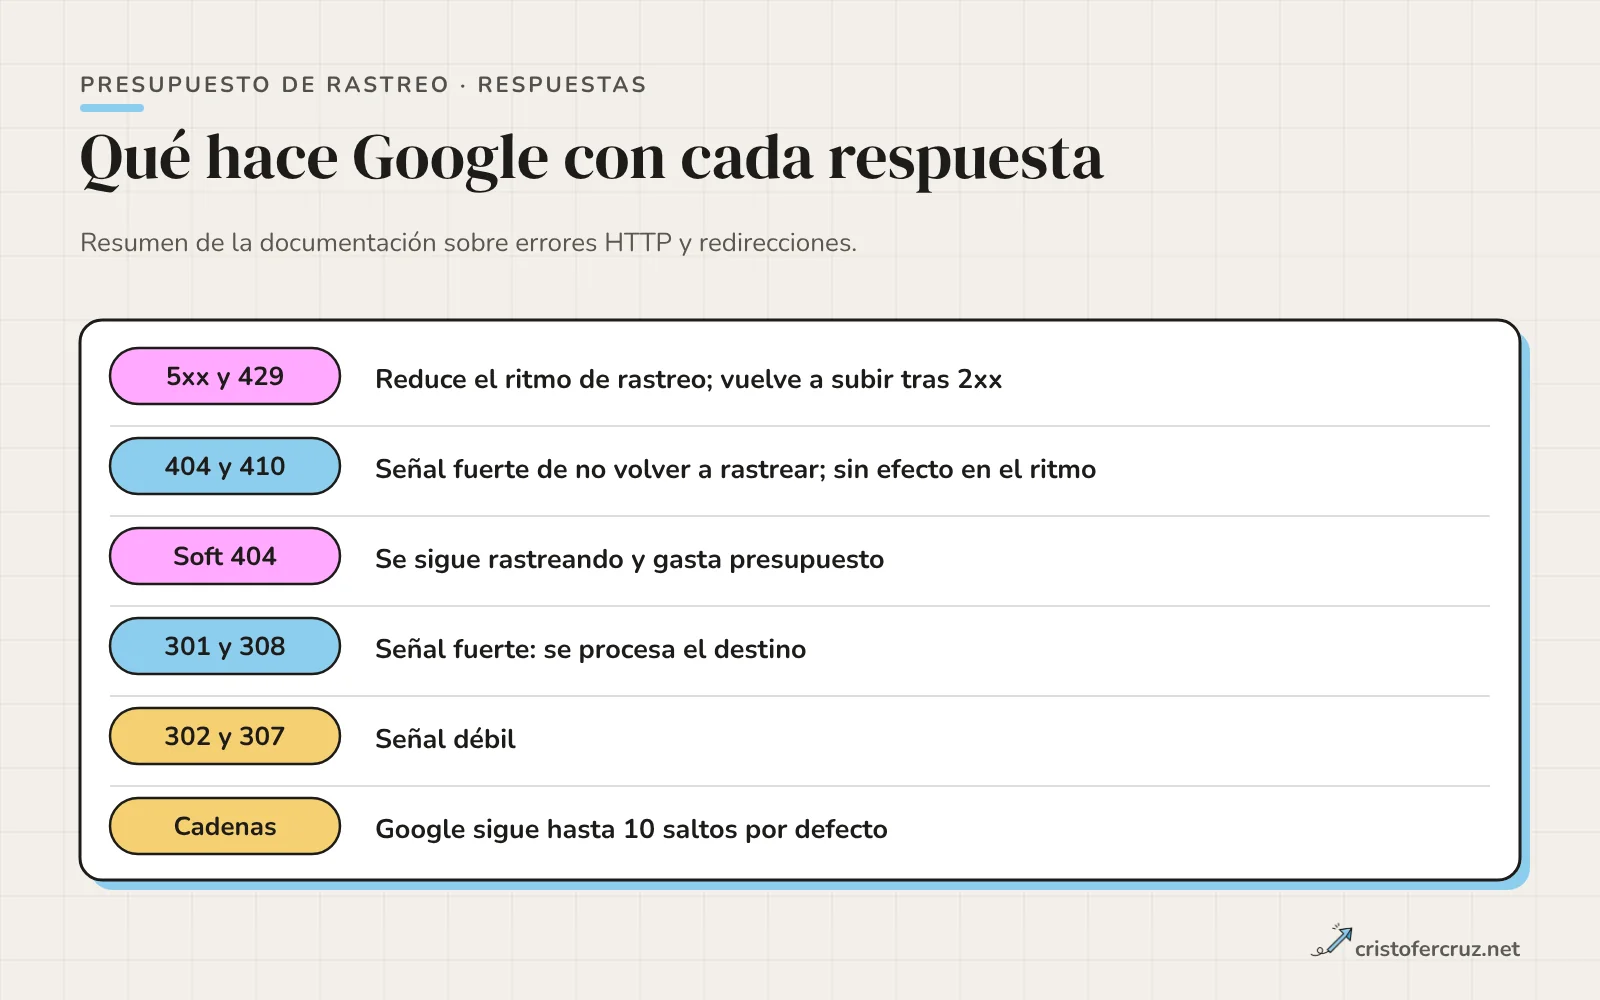
Los códigos de estado son la herramienta más directa para dirigir el rastreo. Resumido a partir de la documentación de errores HTTP y de la guía de presupuesto:
| Respuesta | Efecto en el rastreo |
|---|---|
| 5xx y 429 | Google reduce el ritmo; si el servidor vuelve a responder con 2xx, lo aumenta poco a poco |
| 404 y 410 | Señal fuerte de no rastrear de nuevo; no afectan al ritmo de rastreo |
| Soft 404 | Se siguen rastreando y gastan presupuesto |
| 301 y 308 | Señal fuerte de que el destino es el que debe procesarse |
| 302 y 307 | Señal débil |
| 401 y 403 | No sirven para limitar el rastreo según Google |
La última fila es un clásico: devolver 403 a Googlebot para «ahorrar rastreo» no funciona como mecanismo de control.
Cómo medir el presupuesto de rastreo
No existe un número llamado «mi crawl budget» en ninguna herramienta de Google. Lo que se mide es cuánto, cómo y qué rastrea Googlebot, y de ahí se deduce si hay desperdicio.
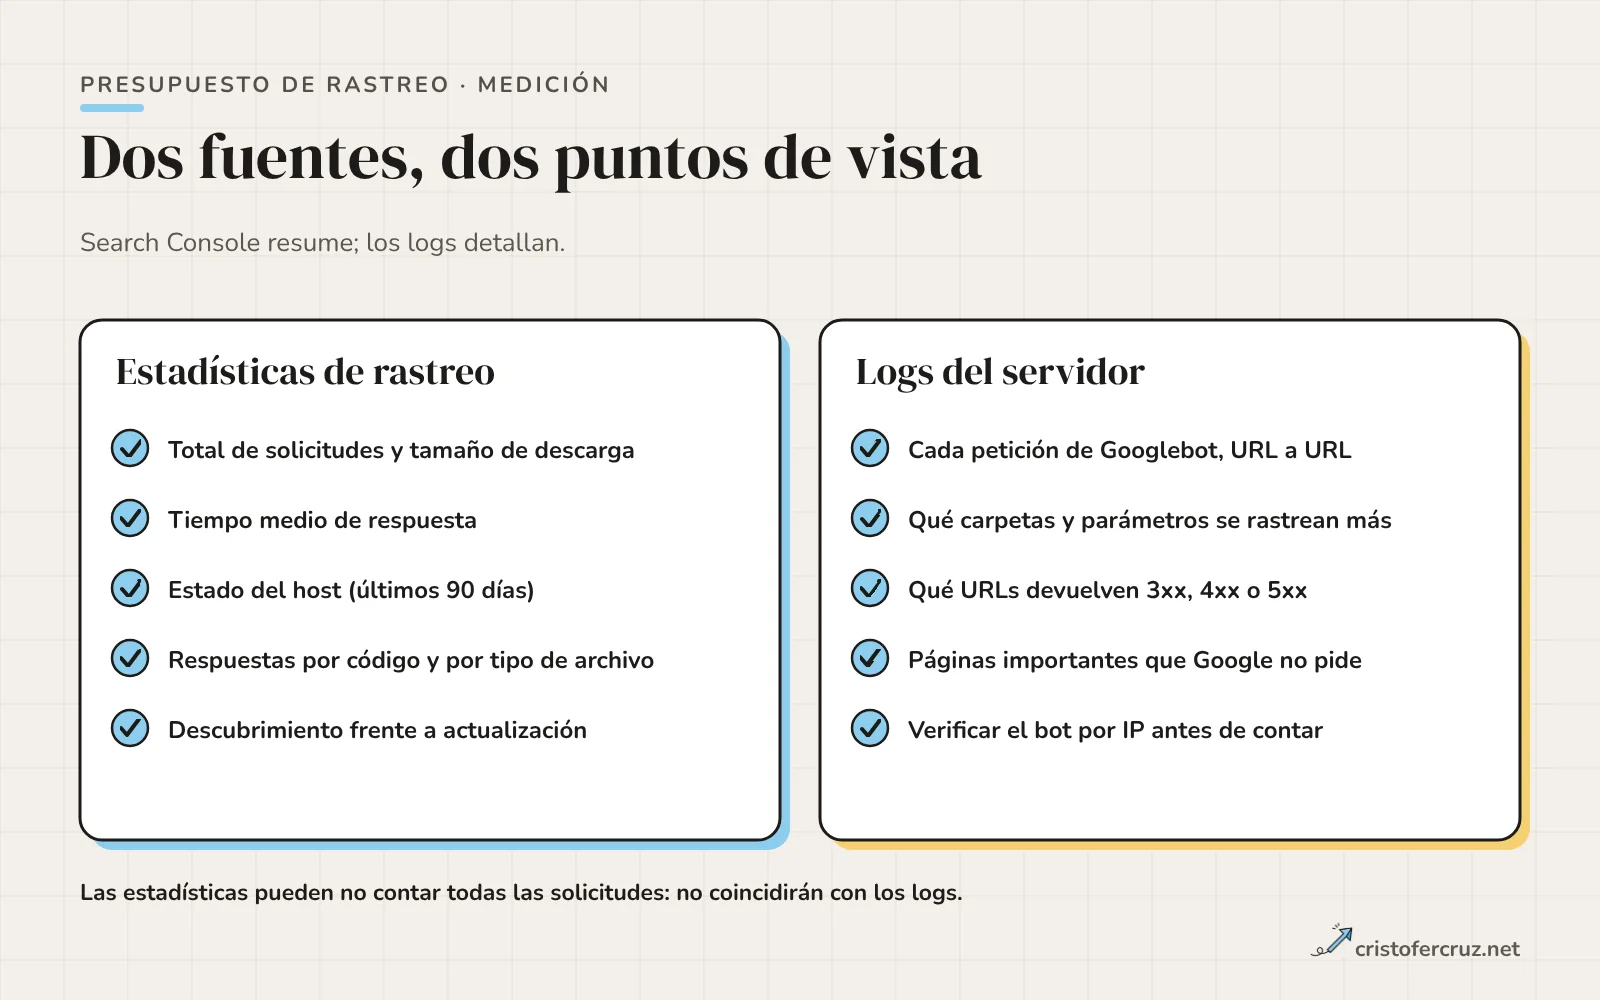
Estadísticas de rastreo de Search Console
Se abre desde Configuración, en Estadísticas de rastreo, y solo está disponible en propiedades de nivel raíz (de dominio o de prefijo de URL en la raíz). Muestra:
- Total de solicitudes de rastreo (incluidas las fallidas), tamaño total de descarga y tiempo medio de respuesta.
- Estado del host, con tres niveles según problemas de robots.txt, DNS y conectividad en los últimos 90 días.
- Respuestas agrupadas en buenas (200, redirecciones, 304), posiblemente buenas (404) y malas (5xx, otros 4xx, tiempos de espera, robots.txt no disponible).
- Tipo de archivo, finalidad (descubrimiento o actualización) y tipo de Googlebot.
Dos límites que Google reconoce: las redirecciones se cuentan como peticiones separadas y es posible que algunas solicitudes no se contabilicen, por lo que las cifras pueden no coincidir con tus logs.
Logs del servidor
Los logs son la única fuente que ve todas las peticiones, URL a URL. Con ellos respondes lo que Search Console no responde: qué carpetas se llevan más rastreo, si Googlebot pide URLs con parámetros, qué páginas importantes casi nunca visita. Si quieres montar ese análisis, tengo un artículo específico sobre cómo analizar logs para SEO y una herramienta en la web, el analizador de logs. Recuerda verificar que la petición es realmente de Googlebot y no un user-agent falsificado antes de sacar conclusiones.
Acciones priorizadas
En un sitio grande, este es el orden en el que yo trabajaría, de lo que más rastreo libera o protege a lo que menos.
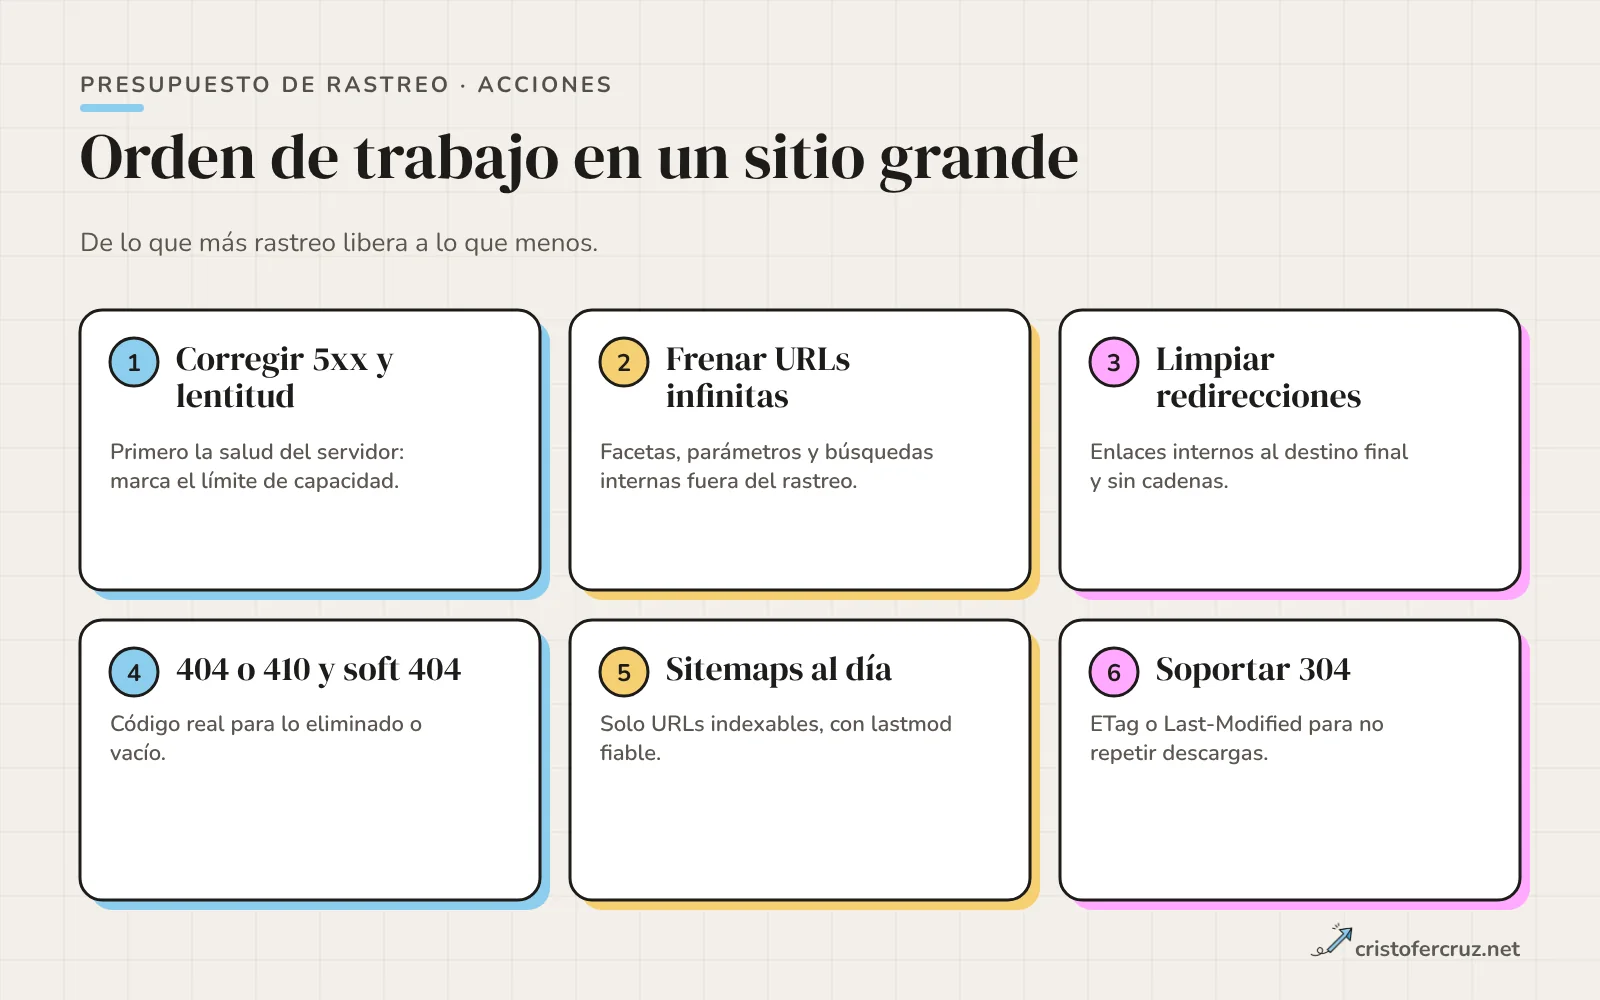
- Salud del servidor. Errores 5xx, 429 y tiempos de respuesta altos bajan el límite de capacidad. Si el servidor no aguanta, todo lo demás da igual.
- URLs infinitas. Facetas, parámetros y búsquedas internas que generan combinaciones sin valor. Decide caso por caso entre no enlazarlas, canonicalizarlas o bloquearlas con robots.txt.
- Redirecciones. Enlaces internos, sitemaps y canonicals apuntando a la URL final, sin cadenas.
- Códigos correctos. 404 o 410 para lo eliminado y para lo vacío; revisar las soft 404.
- Sitemaps limpios. Solo URLs indexables y
<lastmod>fiable, como detallo en la guía de sitemaps XML. La guía de Google recomienda incluirlo cuando hay contenido actualizado. - Soportar 304. Google recomienda acelerar las páginas y soportar respuestas 304 para no volver a descargar lo que no cambia. Lo explico en el artículo sobre caché y SEO.
Antes de bloquear una carpeta, mira en los logs cuánto rastreo se lleva realmente: si apenas aparece, bloquearla no resolverá nada.
Y una precaución sobre robots.txt: la guía de Google no recomienda usarlo para reasignar presupuesto de forma temporal. Úsalo para lo que de verdad no debe rastrearse, no para jugar con el reparto.
Cómo lo trato en mi web
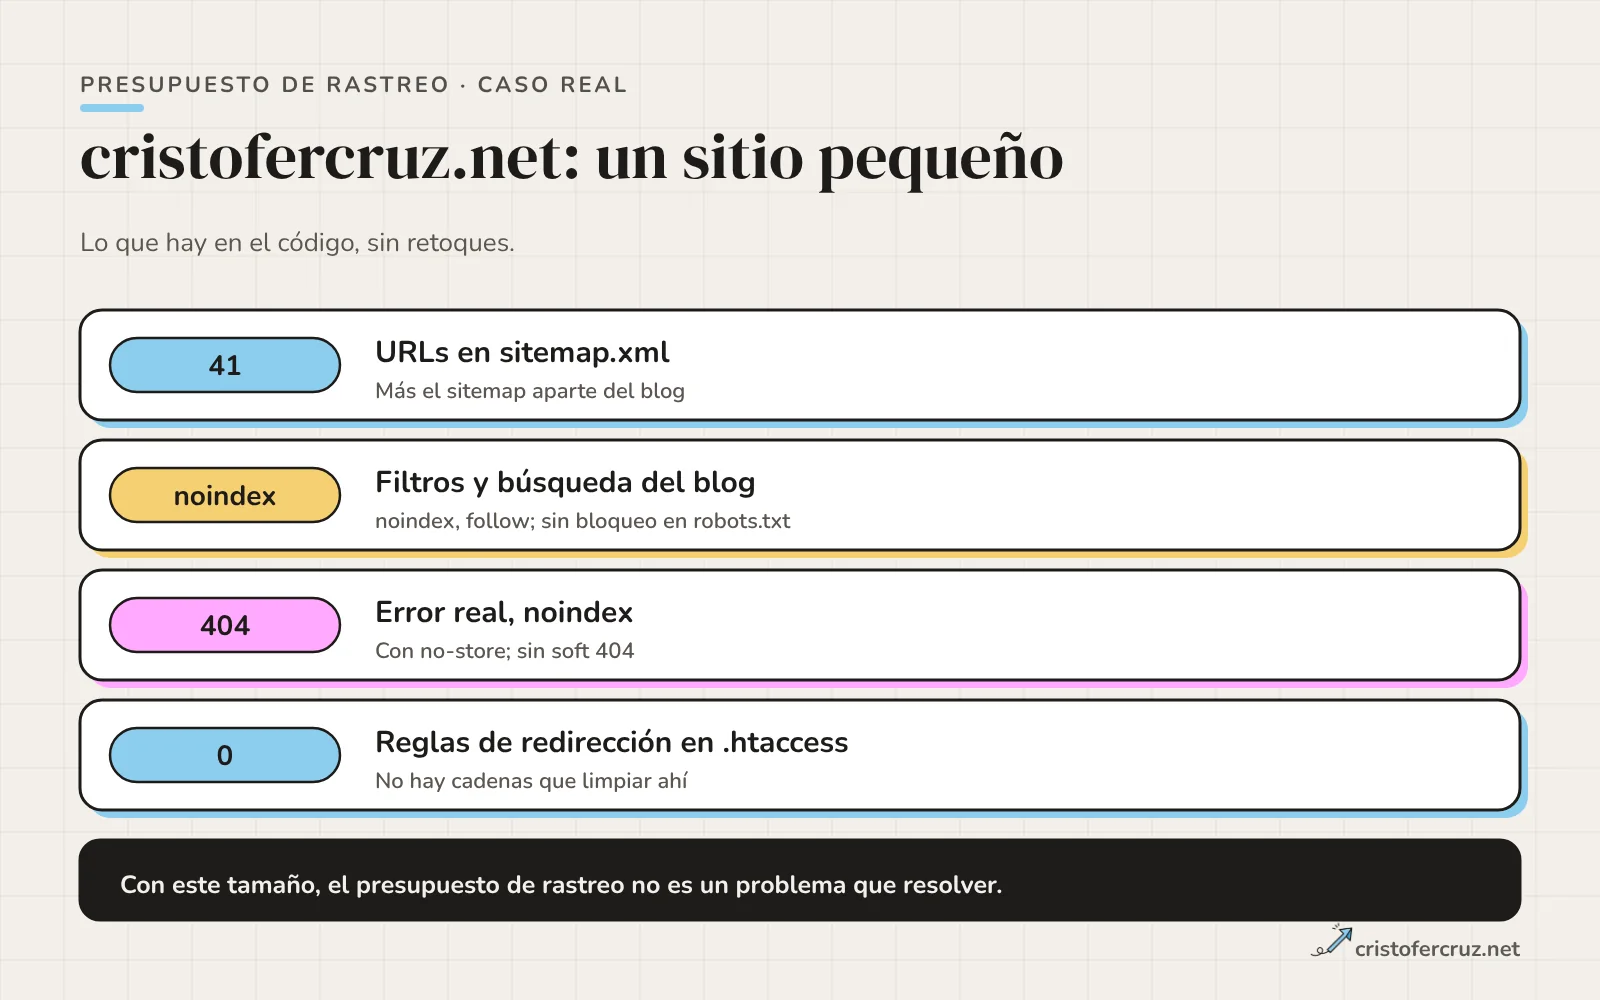
Mi web es pequeña, y eso cambia la conversación. Esto es lo que he comprobado leyendo su código, sin añadir nada que no esté.
| Aspecto | Qué hay hoy |
|---|---|
| Tamaño | sitemap.xml lista 41 URLs, y el blog tiene su propio sitemap (/blog/sitemap.php) con los artículos publicados |
| robots.txt | Bloquea carpetas internas (/includes/, /tools/, /tests/ y similares) y el procesado de formularios; deja accesibles CSS, JavaScript e imágenes; declara los dos sitemaps |
| Filtros y búsqueda del blog | Las URLs con ?categoria= o ?q= llevan noindex, follow y su canonical apunta al listado; no están bloqueadas en robots.txt a propósito |
| Errores 404 | Respuesta 404 real, con noindex y Cache-Control: no-store |
| Redirecciones | El .htaccess no define reglas de redirección 301; no hay cadenas que limpiar ahí |
| Sitemap y lastmod | Solo 10 de las 41 URLs de sitemap.xml llevan lastmod y el sitemap del blog no lo incluye: es una mejora pendiente, no un problema de rastreo |
Lo que implica el caso de los filtros del blog es un buen ejemplo del matiz de antes: con noindex, Google sigue pidiendo esas URLs para ver la etiqueta, así que no ahorro rastreo con ellas. A mi escala da exactamente igual, pero en un catálogo de miles de filtros sería la decisión equivocada y habría que plantear otra salida.
Lo que no puedo decirte es cuánto rastrea Googlebot mi web: no he medido sus estadísticas de rastreo para este artículo ni analizado logs, y no te daré cifras que no he comprobado. Con unas decenas de URLs, la conclusión razonable es que el presupuesto de rastreo no es un problema que resolver aquí.
Cómo auditarlo paso a paso
- Dimensiona el sitio. Cuenta URLs únicas indexables y compáralas con los tres perfiles de Google. Si estás muy lejos, para aquí y revisa indexación y calidad.
- Abre las estadísticas de rastreo. Mira la tendencia de solicitudes, el tiempo medio de respuesta y el porcentaje de respuestas malas.
- Revisa el informe de indexación. Cuantas más URLs «Descubierta: actualmente sin indexar» y soft 404, más sentido tiene seguir.
- Cruza con logs. Agrupa por carpeta y por parámetro y busca dónde se va el rastreo y qué páginas clave faltan.
- Rastrea tu propia web. Con un crawler, busca cadenas de redirecciones, canonicals a URLs con redirección y URLs con parámetros enlazadas internamente. Si el sitio se apoya en JavaScript, depura qué ve Google al renderizar antes de culpar al presupuesto.
- Corrige, espera y vuelve a medir. Los cambios de rastreo tardan semanas en verse; no juzgues a los dos días.
Si tu sitio encaja en los perfiles grandes y quieres que lo revise con datos de logs, esto entra en una auditoría SEO técnica; si quieres acompañamiento continuo, en la consultoría SEO. Cuando el rastreo se va a facetas y parámetros por cómo está montada la web, el arreglo es de arquitectura web SEO.
Preguntas frecuentes
¿Qué es el presupuesto de rastreo o crawl budget?
Según Google, el conjunto de URLs de tu sitio que puede rastrear y quiere rastrear. Combina el límite de capacidad de rastreo, que depende de tu servidor, y la demanda de rastreo, que depende de cuánto le interesa tu contenido.
¿Mi web tiene un problema de presupuesto de rastreo?
Probablemente no si tiene menos de unas pocas miles de URLs. Google dirige su guía a sitios de más de 1 millón de páginas con cambios semanales y de más de 10.000 con cambios diarios, además de sitios con muchas URLs descubiertas sin indexar. Son estimaciones.
¿El presupuesto de rastreo es un factor de posicionamiento?
La documentación de Google no lo plantea como tal: trata de qué se rastrea, no de dónde se posiciona. Lo que sí es cierto es que una URL que no se rastrea no puede indexarse ni posicionar.
¿Cómo veo mi presupuesto de rastreo en Search Console?
No aparece como una cifra. Se deduce del informe de estadísticas de rastreo (Configuración, Estadísticas de rastreo): solicitudes totales, tiempo de respuesta, estado del host y desglose por código de respuesta y tipo de archivo.
¿Bloquear URLs en robots.txt mejora el rastreo del resto?
Evita que Google rastree esas URLs, pero Google avisa de que no traslada el presupuesto liberado a otras páginas salvo que tu sitio ya esté en su límite de capacidad. No lo uses como palanca de reparto.
¿Sirve noindex para ahorrar presupuesto de rastreo?
No. Google necesita pedir la página para leer la etiqueta noindex, de modo que el rastreo se produce igualmente. Para que no se rastree hay que cortar los enlaces o bloquear con robots.txt, según el caso.
¿Los errores 404 gastan presupuesto?
Poco: según Google, un 404 es una señal fuerte para no volver a rastrear esa URL y no afecta al ritmo de rastreo. Las que sí lo gastan son las soft 404, que devuelven 200 y se siguen visitando.
Referencias y fuentes
Documentación consultada para este artículo.
- Guía de gestión del presupuesto de rastreo para sitios grandes Google Search Central
- Informe de estadísticas de rastreo Ayuda de Search Console
- Cómo afectan a Google Search los códigos de estado HTTP y los errores de red Google Search Central
- What Crawl Budget Means for Googlebot Google Search Central Blog
- Crawling December: Faceted navigation Google Search Central Blog