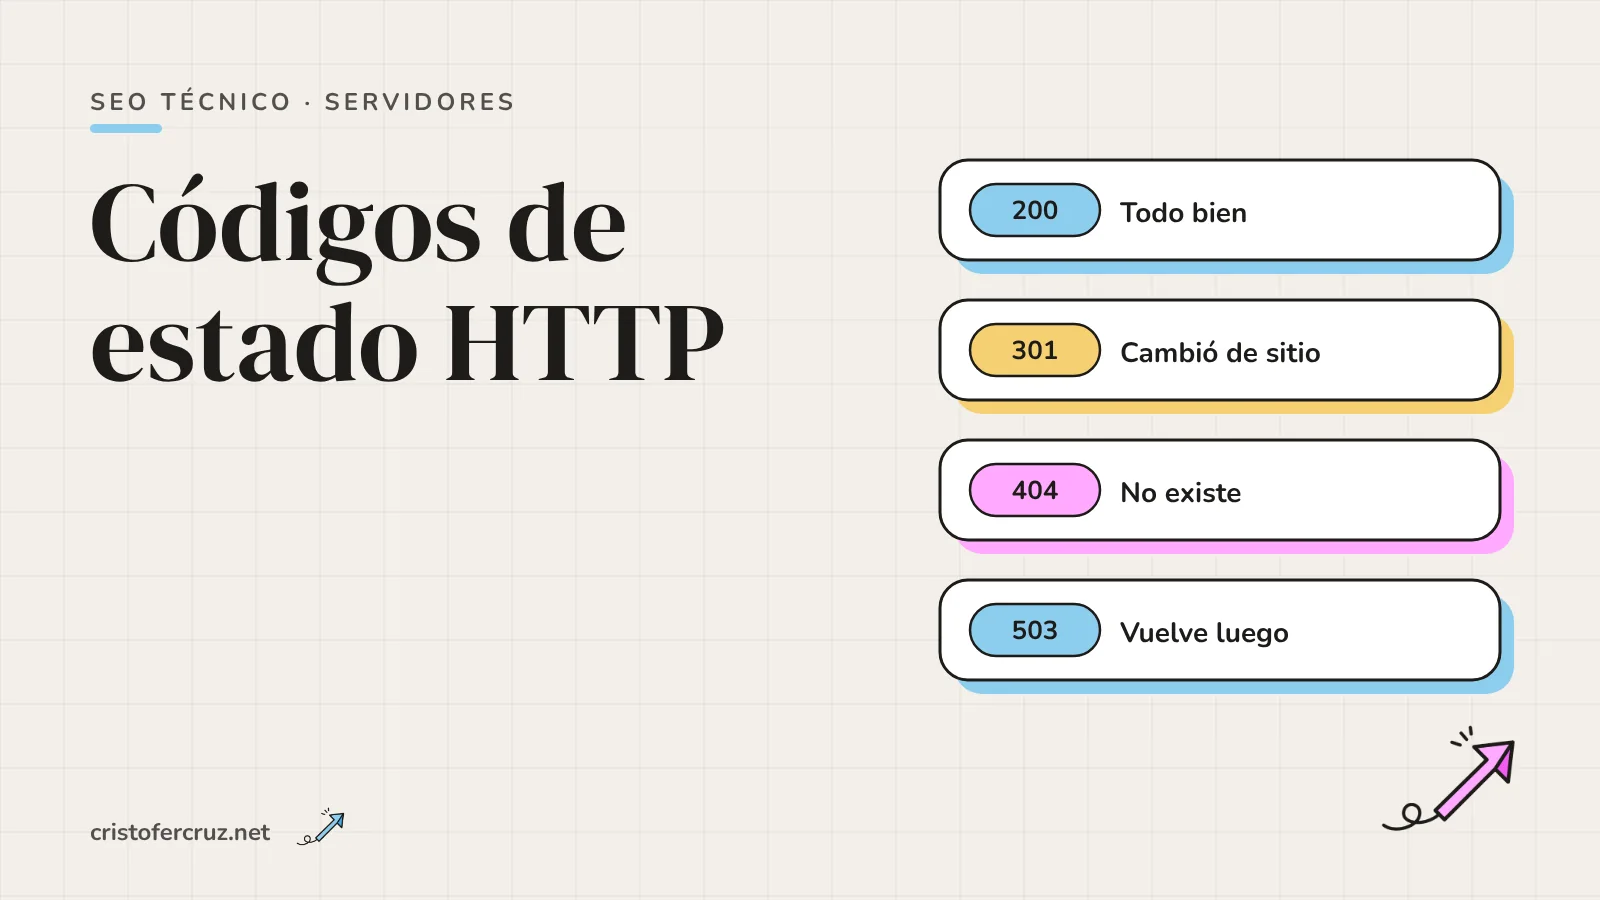
- Según la documentación de Google, los errores 404 no afectan al rendimiento de tu sitio en búsqueda: una URL que no debe existir puede seguir devolviendo 404 sin que pase nada.
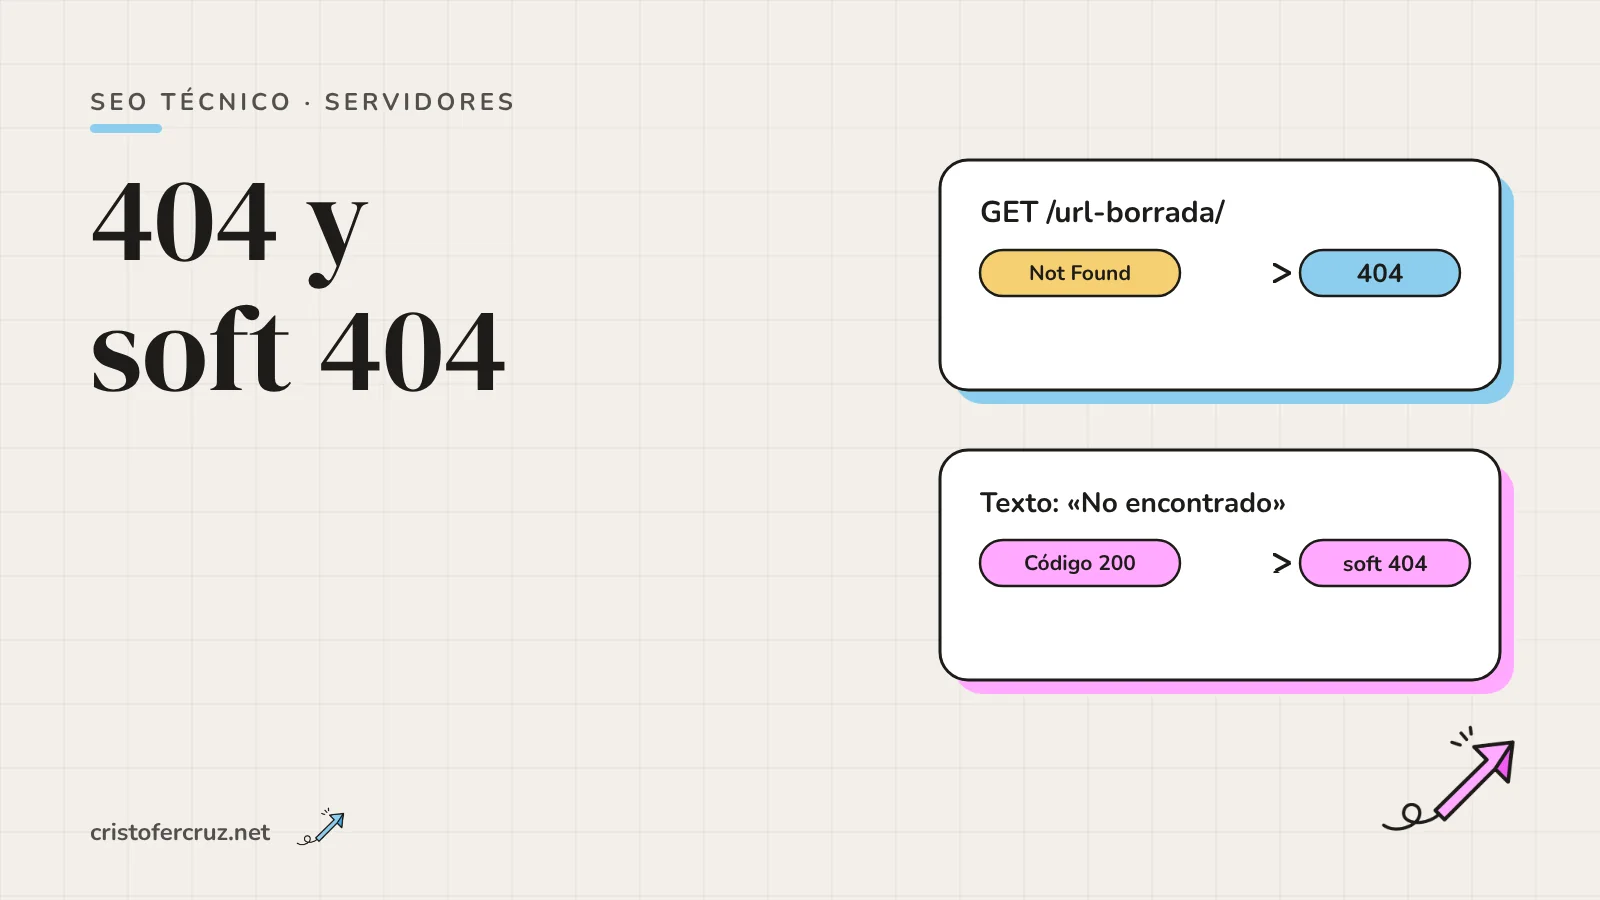
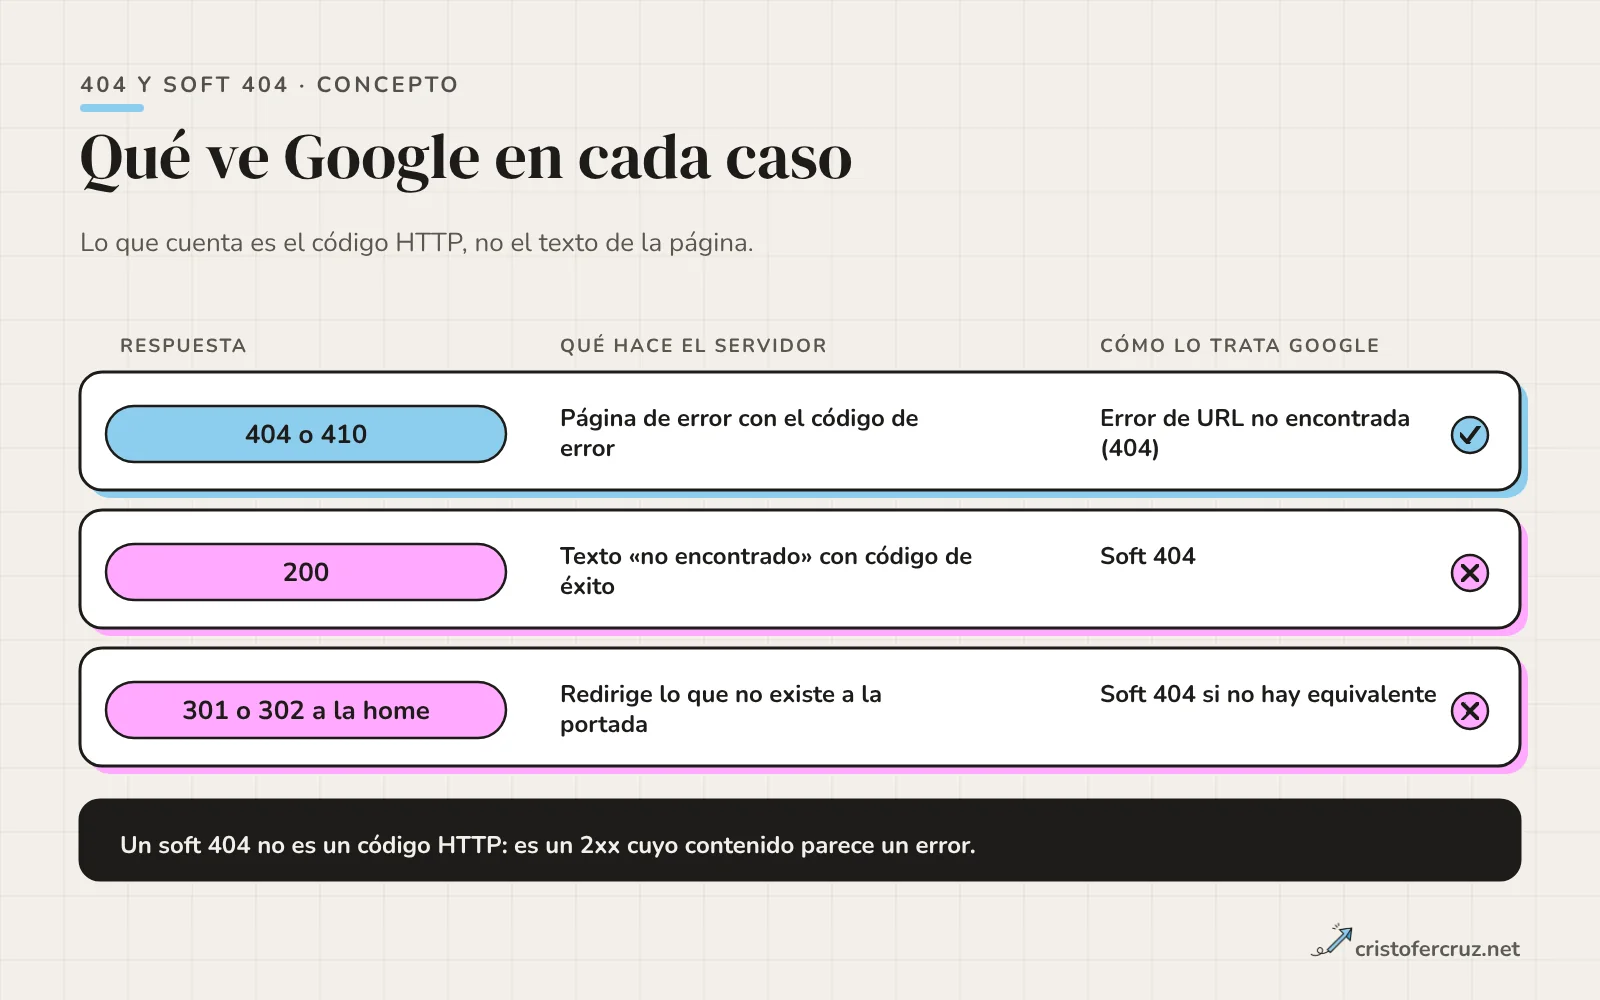
- Un soft 404 no es un código HTTP: es una respuesta 2xx cuyo contenido parece un error. Search Console lo marca aparte y Google sigue rastreándolo, con el gasto de presupuesto que eso supone.
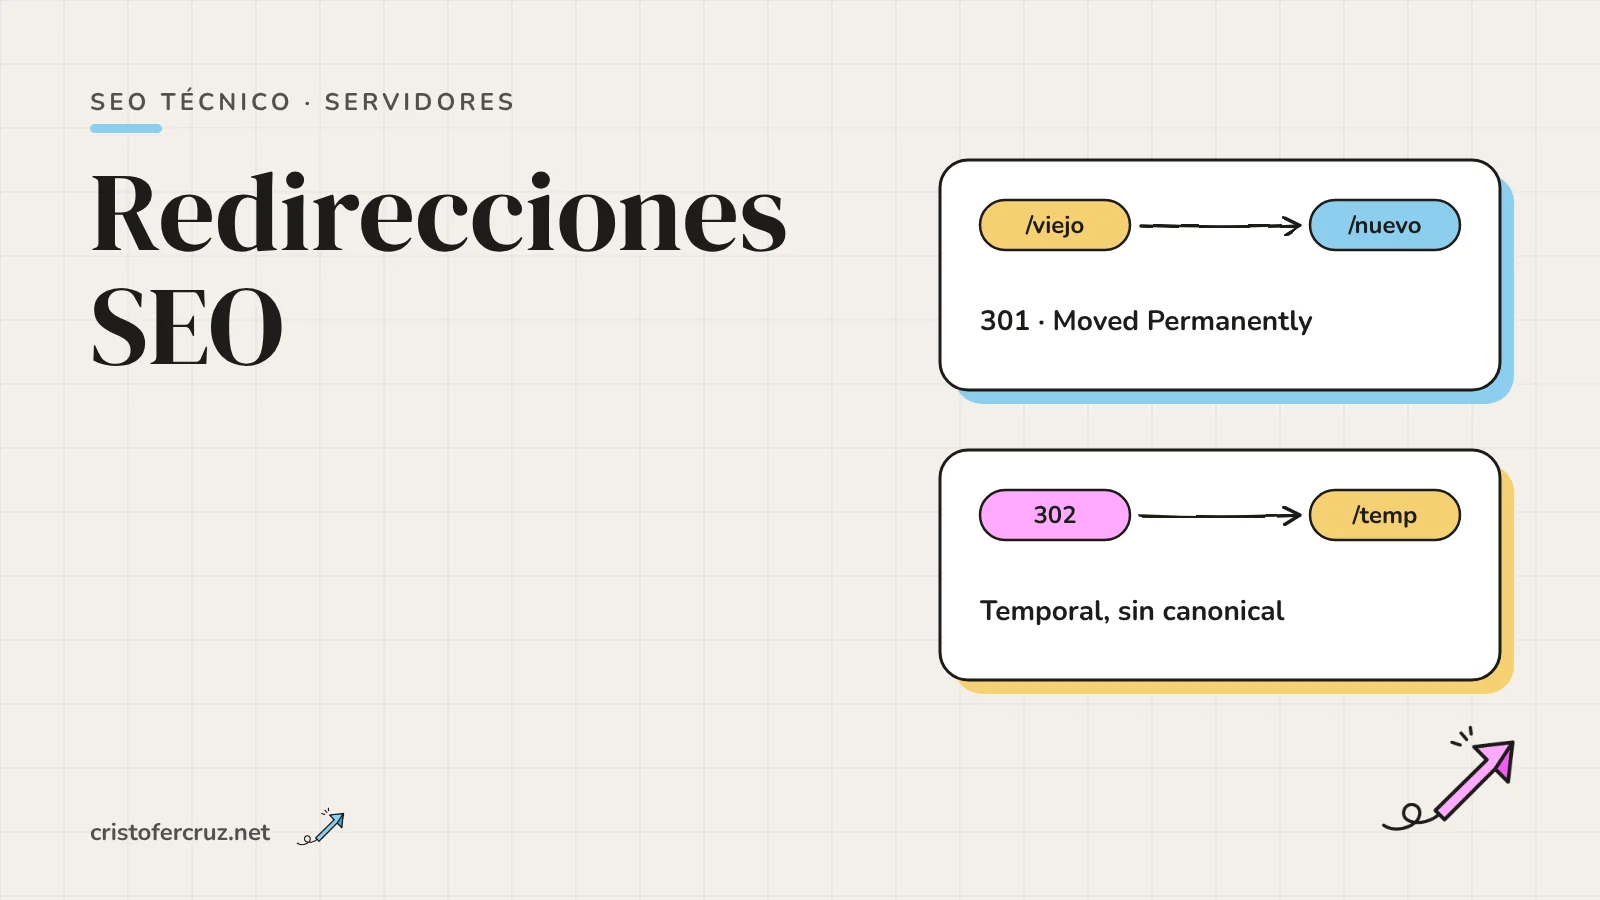
- Google trata 404 y 410 igual. La decisión real es otra: si hay una página equivalente, 301 a ella; si no la hay, 404 o 410.
- Redirigir todo lo que no existe a la home es el origen más habitual de soft 404 y Google lo desaconseja de forma explícita.
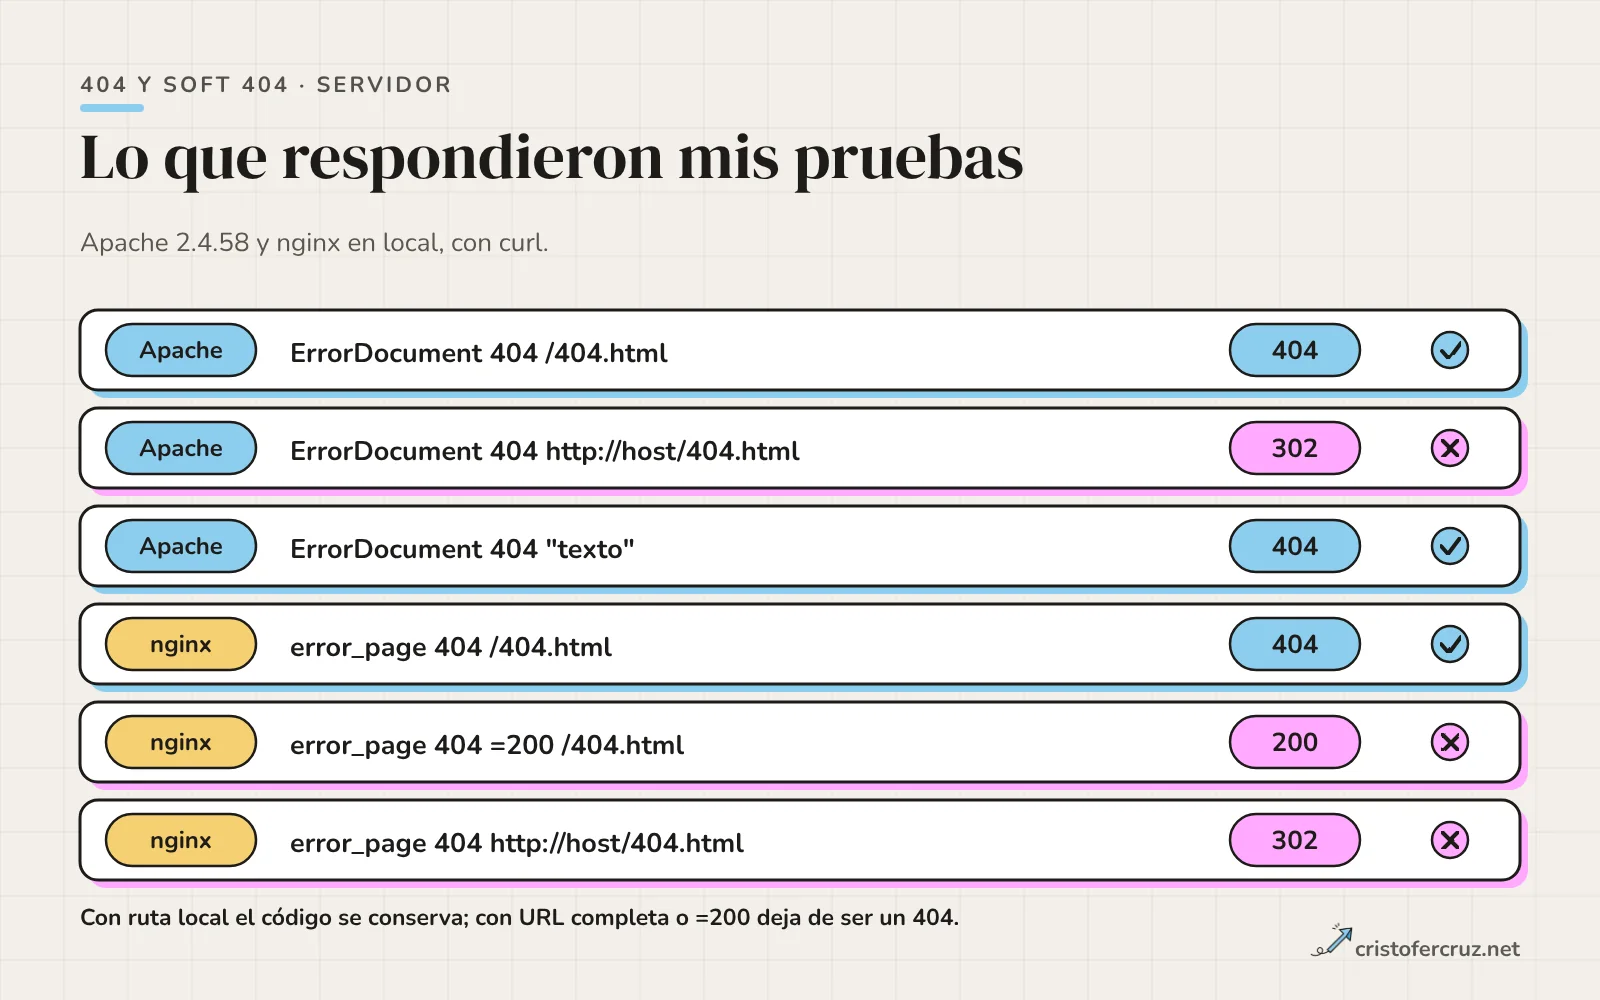
- En mis pruebas con Apache y nginx, una página de error con ruta local conserva el 404; con URL completa en
ErrorDocumento con=200en nginx deja de serlo. - Se audita con una petición
curl -Ia una URL inventada, el informe de indexación, un rastreo y los logs.
Hay dos errores que se mezclan en casi todas las guías sobre el tema. El primero es creer que cada 404 de Search Console es una urgencia que tira el posicionamiento. El segundo, el contrario y más caro, es arreglar «los 404» redirigiéndolos todos a la home o dándoles una página bonita con código 200, que es precisamente lo que genera los soft 404.
Aquí separo lo que Google documenta de lo que se repite por costumbre: cuándo un 404 es lo correcto, cuándo hay que redirigir, cómo se produce un soft 404 y cómo se comporta de verdad el servidor. Incluyo mis pruebas con Apache y nginx y lo que he encontrado leyendo la página 404 de mi propia web.
Qué es un 404 y qué es un soft 404
Un 404 (Not Found) es la respuesta del servidor que dice que esa URL no existe. Pertenece a la familia de errores 4xx del cliente y es una de las respuestas que explico en la guía de códigos de respuesta del servidor. Que el visitante vea o no una página bonita es independiente: lo que lee Googlebot es el código de la primera línea.
Un soft 404 es lo contrario: el servidor responde con éxito (200, normalmente), pero el contenido es un aviso de «no encontrado», una página vacía o un listado sin nada. Google lo describe en su ayuda de Search Console como una página que «devuelve un mensaje de no encontrado amigable pero no un código 404». Es «soft» porque el error no está en el protocolo, solo en el texto.
| Caso | Código | Cómo lo clasifica Google |
|---|---|---|
| URL inexistente con página de error | 404 | Error 404. No se procesa ni se indexa |
| URL retirada a propósito | 410 | Se trata igual que el 404 |
| Página «no encontrado» con código de éxito | 200 | Soft 404 en Search Console |
| URL inexistente redirigida a la home | 301 o 302 | Google lo cita como práctica a evitar, porque confunde el rastreo |
| Servidor caído o con fallo | 5xx | Otro problema distinto, que trato en errores 500 y SEO |
Qué efecto tienen en el SEO según Google
La respuesta corta de la documentación es tranquilizadora: «los errores 404 no afectarán al rendimiento de tu sitio en búsqueda» y puedes ignorarlos cuando esas URLs no deben existir. Lo que no dice es que sean gratis siempre; dice que, por sí mismos, no penalizan.
Lo que sí documenta sobre el funcionamiento es esto: Google no usa el contenido de las URLs que devuelven 4xx. Si una URL que estaba indexada empieza a devolver 404, se retira del índice con el tiempo; si Google se encuentra un 404 nuevo, no lo procesa; y la frecuencia de rastreo de esa URL baja de forma gradual. Para el presupuesto de rastreo, su guía lo resume diciendo que un 404 es una señal fuerte de no volver a rastrear esa URL, mientras que los soft 404 «se seguirán rastreando y gastarán presupuesto». Lo desarrollo en el artículo sobre presupuesto de rastreo.
De ahí salen los efectos reales, que son indirectos:
- Una página con tráfico o enlaces que pasa a 404 sin redirección pierde esa entrada de forma definitiva. No es una penalización: es que la URL ya no existe.
- Un soft 404 mantiene viva una URL sin valor en la cola de rastreo y mezcla el informe de indexación.
- Los enlaces internos rotos empeoran la experiencia y desperdician clics, algo que no depende de Google.
Conviene desconfiar de quien afirma que los 404 «bajan posiciones» o que la tasa de rebote tras un 404 es un factor de ranking. No he encontrado nada en la documentación de Google que lo respalde.
404 frente a 410
El 410 (Gone) dice que la URL se retiró a propósito y que no va a volver. En la teoría HTTP es más específico que el 404. En la práctica, Google lo resuelve en una frase: «actualmente Google trata los 410 igual que los 404». Y en su documentación sobre códigos de estado, todos los 4xx salvo el 429 se tratan igual.
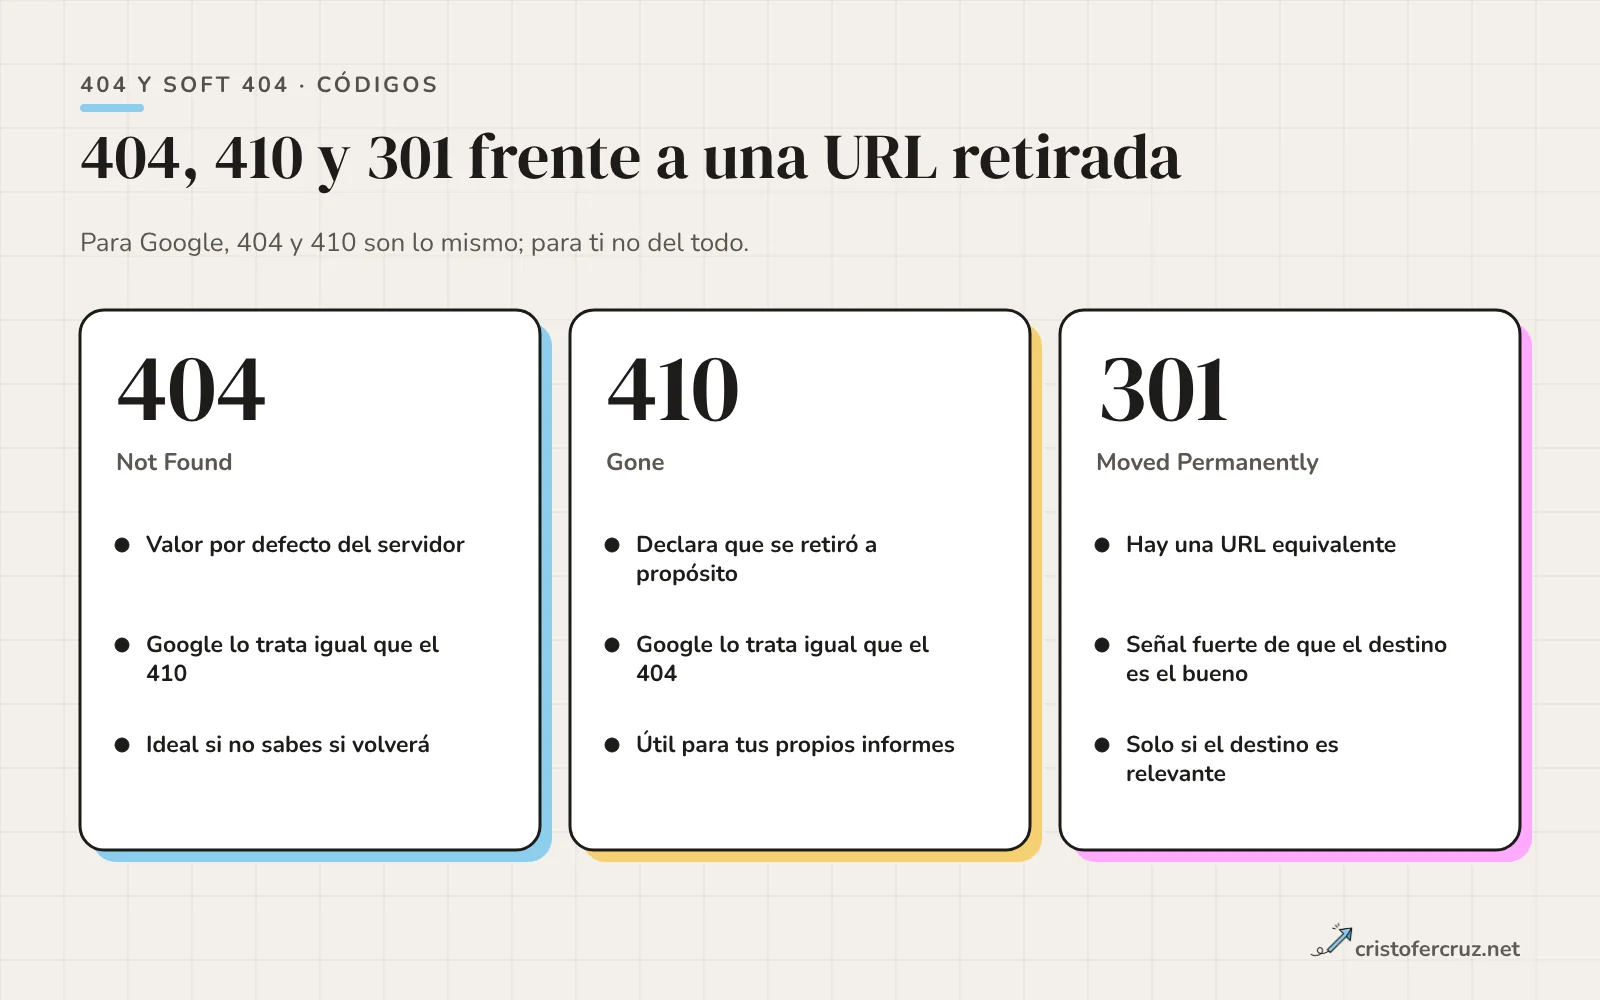
Eso deja el 410 como una cuestión de higiene propia. Tiene sentido si quieres distinguir, en tus informes y logs, las URLs que retiraste tú de las que no existen por error o por enlaces mal escritos. Hoy no lo uso en mi web. No esperes que acelere la desindexación; Google no documenta que lo haga. Y no uses otros 4xx como sustituto: 401 y 403 no son la forma de decir «no existe» y no modifican el ritmo de rastreo.
Un detalle que se olvida: no bloquees los 404 en robots.txt pensando que así «se quitan» del informe. La ayuda de Google lo desaconseja junto con la redirección a la home, porque impide que entienda la estructura de tu sitio, y además un bloqueo impide que Googlebot vea el 404.
Cuándo dejar el 404 y cuándo redirigir
La regla que aplico tiene tres preguntas. Primera: ¿existe ahora una página que cubra la misma intención? Entonces, 301 a esa página. Segunda: si no existe y la retiraste para siempre, 404 o 410 con una buena página de error. Tercera: si la URL debería existir pero está vacía, el problema no es el código, es el contenido.
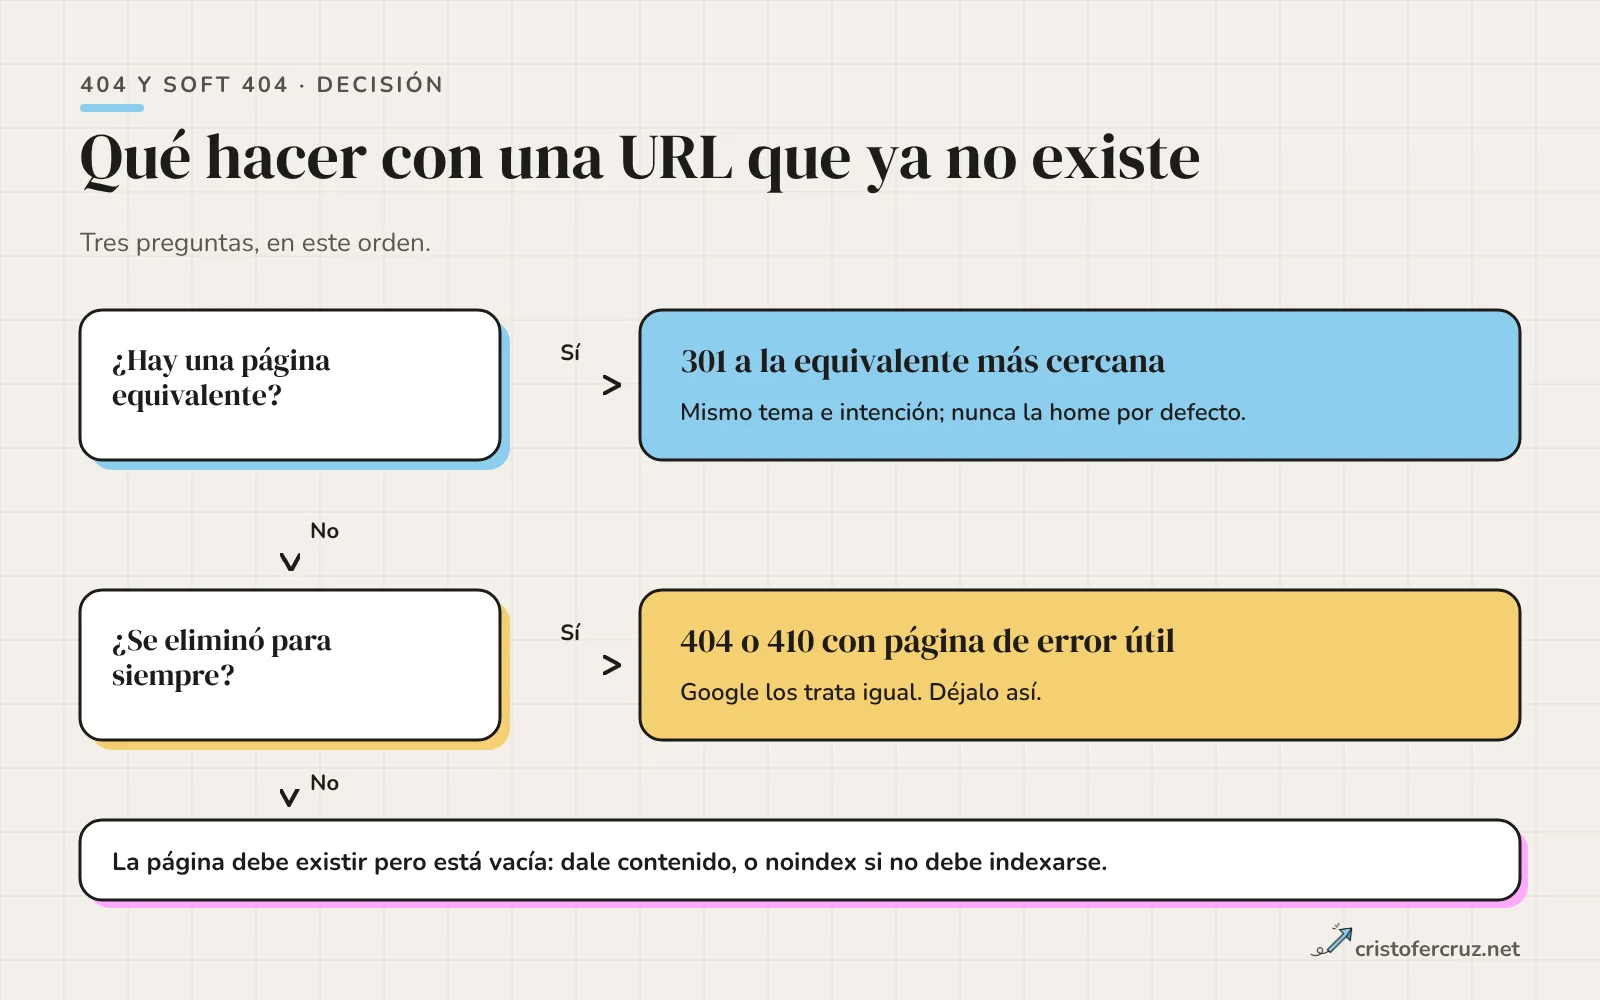
La ayuda de Google sobre el informe «No se encuentra (404)» lo plantea igual: los 404 no son necesariamente un problema si la página se eliminó sin sustituto, y si se movió hay que usar una redirección 301 a la nueva ubicación. Los casos en los que sí compensa redirigir son los que tienen valor acumulado:
- URLs con tráfico orgánico reciente en Search Console o en analítica.
- URLs con backlinks de dominios relevantes, que se localizan en tu herramienta de enlaces.
- Páginas migradas, renombradas o fusionadas, donde el equivalente es evidente.
- Errores de escritura frecuentes en enlaces externos, que Google recomienda mapear a la página correcta.
«Equivalente» es la palabra importante. Un 301 de un producto descatalogado a su categoría tiene sentido; un 301 de un artículo antiguo a la portada no cubre la misma intención y es justo lo que la documentación presenta como práctica a evitar. El 301 es una señal fuerte de que el destino es el que hay que procesar, y esa señal solo debería enviarse cuando es verdad. Los tipos de redirección y sus matices están en tipos de redirecciones para SEO.
Antes de redirigir un lote de URLs, ordena por tráfico y por enlaces entrantes. Lo normal es que unas pocas URLs concentren la mayor parte del valor; el resto de la cola puede quedarse en 404 sin consecuencias.
Causas de soft 404 y cómo evitarlas
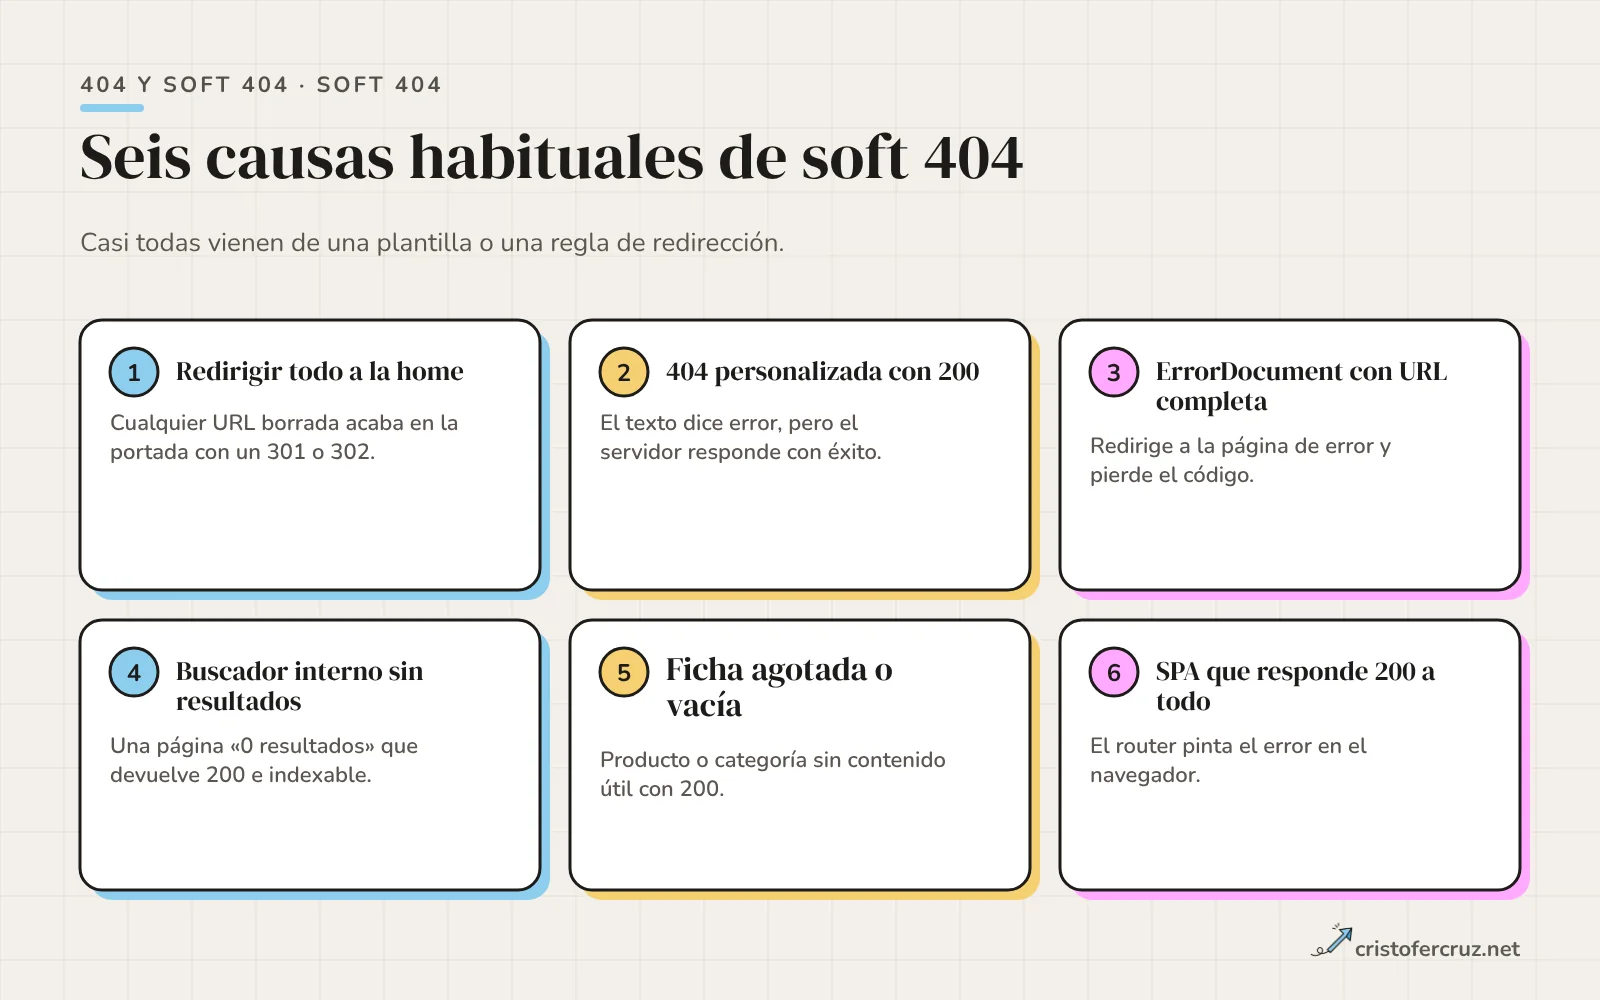
Casi todos los soft 404 salen de una plantilla o de una regla de redirección. Estas son las seis causas habituales.
Redirigir todo a la home
Es la «solución» más repetida tras una migración o una limpieza: cualquier URL que no existe va a la portada con un 301 o un 302. Para el usuario es confuso, porque pidió una cosa y ve otra; para Google, es un error que la documentación nombra expresamente. Si no hay equivalente, la respuesta correcta es el 404.
Una página 404 personalizada que responde 200
El clásico. Alguien diseña una página de error estupenda y el servidor la sirve como una página normal. Se ve perfecta y es un soft 404 en toda regla. La causa suele ser una regla de reescritura que manda todo lo desconocido a una plantilla sin fijar el código, o un error_page ... =200 en nginx. En la sección siguiente enseño los resultados de mis pruebas.
Buscador interno y listados sin resultados
Una URL de búsqueda interna con cero resultados y código 200 es un caso intermedio: la página existe y funciona, pero no tiene contenido útil. Hay dos salidas aceptables: que esas URLs no sean indexables (noindex, o que ni se enlacen) o, si la lista vacía no tiene sentido como URL, que devuelvan 404. No he visto documentación de Google que prescriba una de las dos para este caso concreto; lo que sí documenta es que añadir noindex a las páginas de error es una vía válida cuando no se puede cambiar el código.
Fichas vacías y aplicaciones de una sola página
Una ficha de producto agotada con solo un título, o una categoría sin productos, puede leerse como soft 404 por falta de contenido. La ayuda de Google propone añadir contenido útil si la página no está realmente «no encontrada». En una SPA que responde 200 a todo, Google propone redirigir con JavaScript a una URL que devuelva 404 en servidor, o añadir noindex a las páginas de error; esto lo trato con detalle en el artículo de JavaScript y SEO.
Si tu web ha acumulado cientos de soft 404 tras un cambio grande y el tráfico se ha resentido, ese diagnóstico entra en lo que hago en recuperación de caídas de tráfico: primero se separa qué es ruido del informe y qué es pérdida real de URLs con valor.
Cómo configurar la página de error en el servidor
El requisito es siempre el mismo: la página de error se muestra al usuario y el código que recibe el cliente sigue siendo 404. He probado de verdad las variantes más habituales, con Apache 2.4.58 y nginx 1.24.0 en local, y con curl contra una URL que no existe.
| Servidor | Configuración | Código que recibe el cliente |
|---|---|---|
| Apache | ErrorDocument 404 /404.html | 404 |
| Apache | ErrorDocument 404 http://127.0.0.1:8437/404.html | 302, con Location a la página de error |
| Apache | ErrorDocument 404 "Pagina no encontrada" | 404 |
| nginx | error_page 404 /404.html; | 404 |
| nginx | error_page 404 =200 /404.html; | 200 |
| nginx | error_page 404 http://127.0.0.1:8337/404.html; | 302, con Location a la página de error |
La lectura es directa. Con una ruta local (empieza por /), el servidor entrega el contenido de la página de error y mantiene el 404. Con una URL completa, Apache y nginx responden con una redirección 302 a esa URL, y la página final devolverá 200: el cliente ya no ve un 404, ve un 302 seguido de un 200, que es un soft 404 fabricado por configuración. La documentación de Apache describe la distinción entre ruta local y URL externa, aunque no detalla el código de la redirección; el 302 es lo que observé yo.
Los fragmentos mínimos que dejé funcionando:
# Apache (.htaccess o configuración del sitio)
ErrorDocument 404 /404.html

# nginx
server {
    error_page 404 /404.html;
    location = /404.html { internal; }
}
Lo que no he probado es la combinación con PHP: en estas pruebas la página de error era un HTML estático, no un script que fije su propio código. En una aplicación con rutas propias (WordPress, un framework) el código de estado lo decide la aplicación, y ahí hay que mirar la respuesta real, no la configuración.
Una página 404 que sirva a la persona
Con el código correcto, la página de error es un asunto de usuario, no de ranking. Lo que incluyo cuando la diseño:
- El mismo diseño y menú que el resto de la web, para que el visitante no sienta que salió del sitio.
- Una frase clara que diga que la dirección no existe o ha cambiado, sin culpar al usuario.
- Un buscador interno y enlaces a las secciones principales.
- Un enlace a contacto, por si el enlace roto venía de un correo o de otra web.
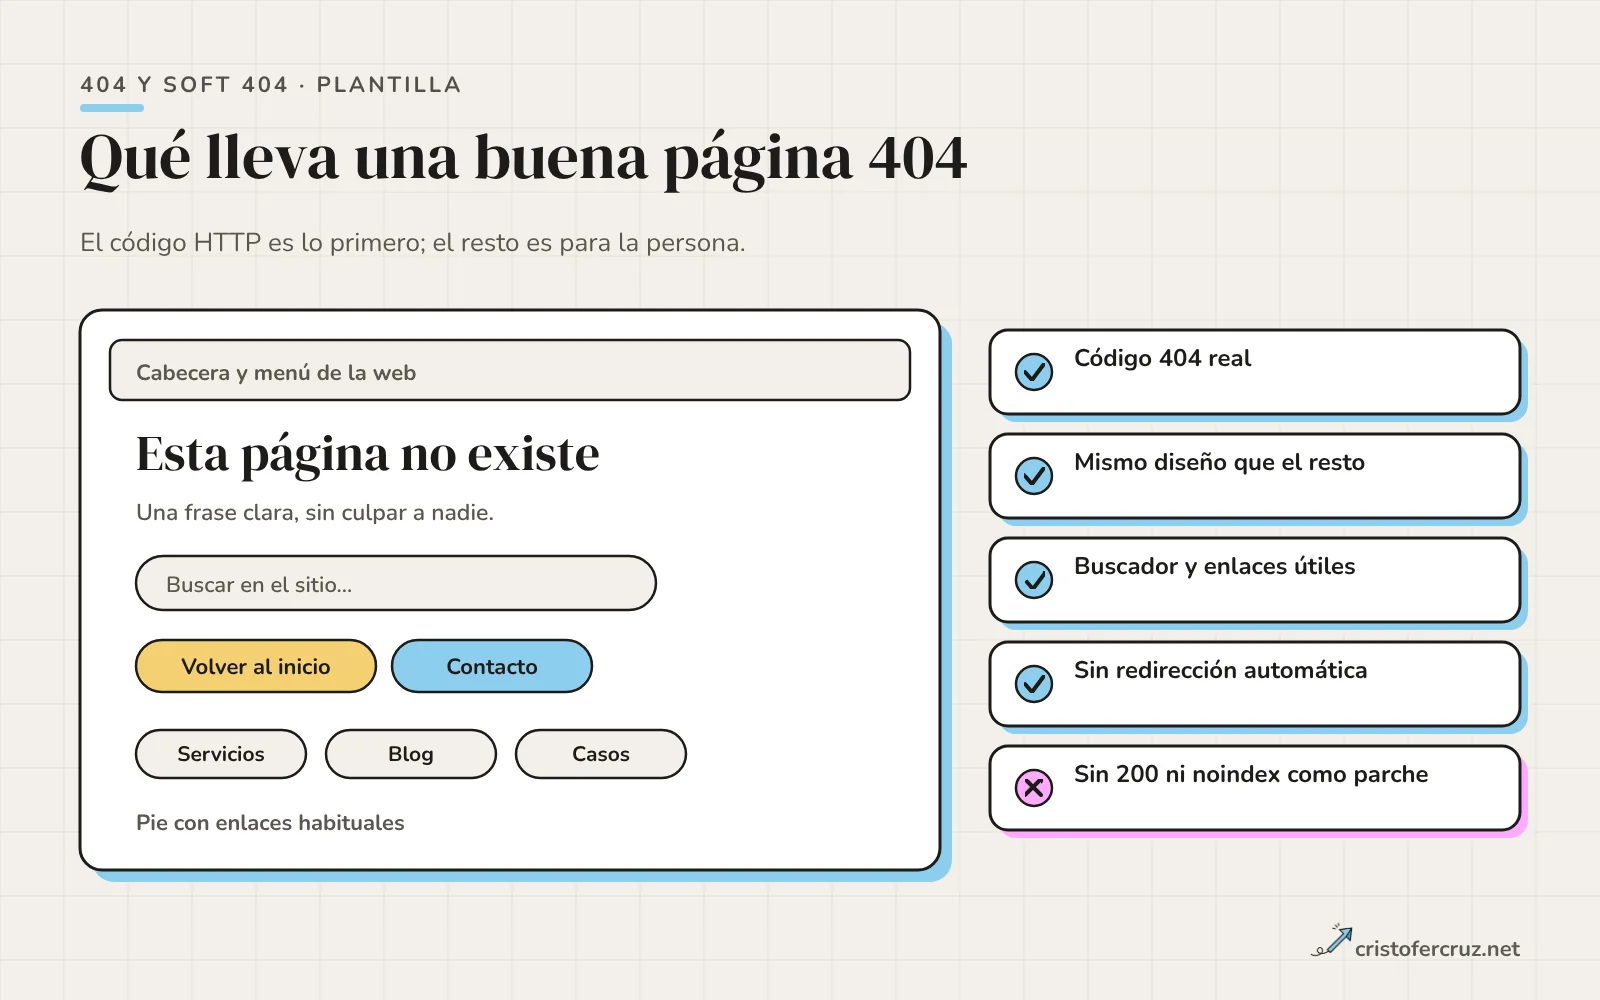
No hace falta que la página lleve noindex si el código es un 404 real. Google no usa el contenido de las URLs 4xx, así que una etiqueta o cabecera de indexación en esa respuesta no cambia lo que hace con ella. El noindex sí tiene su lugar donde no puedes controlar el código, como en la SPA que citaba antes. Tampoco hace falta un canonical en la página de error, y conviene que no apunte a la home.
Cómo trato los 404 en mi web
Esta sección solo recoge lo que he comprobado leyendo el código de cristofercruz.net y haciendo peticiones curl a mi servidor local.
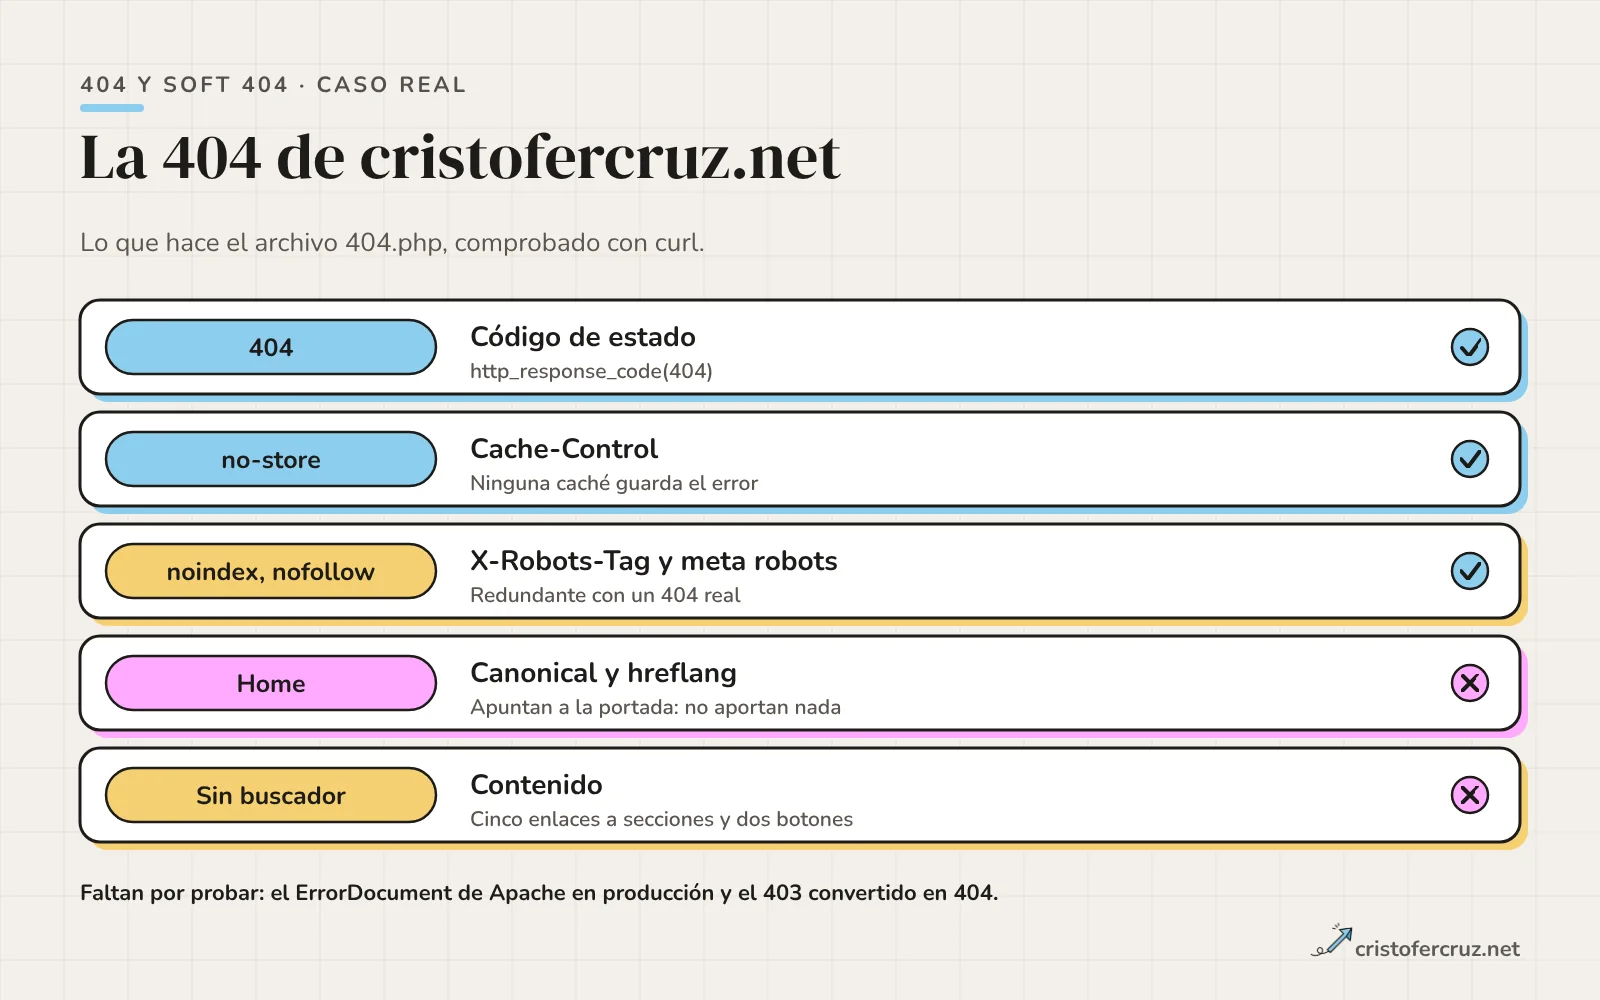
El archivo 404.php fija el código con http_response_code(404), envía Cache-Control: no-store y X-Robots-Tag: noindex, nofollow, y repite el noindex, nofollow en la metaetiqueta robots. Pedido directamente a /404.php, el servidor devuelve HTTP/1.1 404 Not Found con esas dos cabeceras. El .htaccess contiene ErrorDocument 404 /404.php con ruta local, que según mis pruebas con Apache es la forma de conservar el código, y también ErrorDocument 403 /404.php.
Hay tres matices que he encontrado y que no son un problema grave, pero sí mejorables:
- La plantilla declara como
canonicaly comohreflang(es-ES y x-default) la portada. Ya lo señalé en el artículo de canonicals: con un 404 real es improbable que cause nada, pero no aporta y lo quitaría. - El
noindexen cabecera y en meta es redundante con un 404 real, por lo que explicaba arriba. No hace daño. - La página no tiene buscador: ofrece cinco enlaces (Servicios, Casos de éxito, Sobre mí, Herramientas y Blog) y dos botones (inicio y contacto).
Hay otros dos comportamientos que he visto en el código. El listado del blog con una búsqueda sin resultados devuelve 200, con noindex, follow y canonical al listado sin parámetros; es decir, no es un soft 404 que se deje indexar, aunque no he podido mirar si Search Console lo clasifica como tal. Y la plantilla de los artículos devuelve 404 con un texto plano («Artículo no disponible.») cuando el artículo no está publicado o tiene fecha futura, sin usar la plantilla de error de la web.
Lo que no he podido comprobar: el servidor local de PHP no aplica el .htaccess y responde con la portada a cualquier URL inexistente, así que no he visto el 404 de una URL inventada tal como lo ve Googlebot en producción. Tampoco he probado qué código sale cuando un 403 se convierte en 404.php; por la lógica del archivo debería ser un 404, pero no lo he verificado. Ni he revisado el informe de indexación de esta web para este artículo.
Cómo encontrar los 404 y los soft 404
Ninguna fuente lo ve todo, así que combino cuatro:
- Informe de indexación de Search Console. Muestra las URLs con motivo «No se encuentra (404)» y «Soft 404». La ayuda de Google indica que una URL puede haberse descubierto por un enlace de otra página o porque existió y se eliminó. Para un soft 404, la inspección de URL en vivo enseña cómo renderiza Google la página.
- Un rastreador (crawler). Detecta enlaces internos y URLs del sitemap XML que apuntan a un 404, que son los más baratos de arreglar: se corrige el enlace o se saca la URL del sitemap.
- Los logs del servidor. Dicen qué URLs inexistentes pide Googlebot y con qué frecuencia; el método está en análisis de logs SEO.
- Una herramienta de backlinks. Identifica enlaces externos que llegan a un 404 y que merecen un 301.
Un informe lleno de 404 externos (enlaces mal escritos de terceros, bots que buscan /wp-login.php) es normal y no requiere acción. Prioriza los que reciben tráfico, enlaces entrantes o enlaces internos propios.
Cómo auditar 404 y soft 404 paso a paso
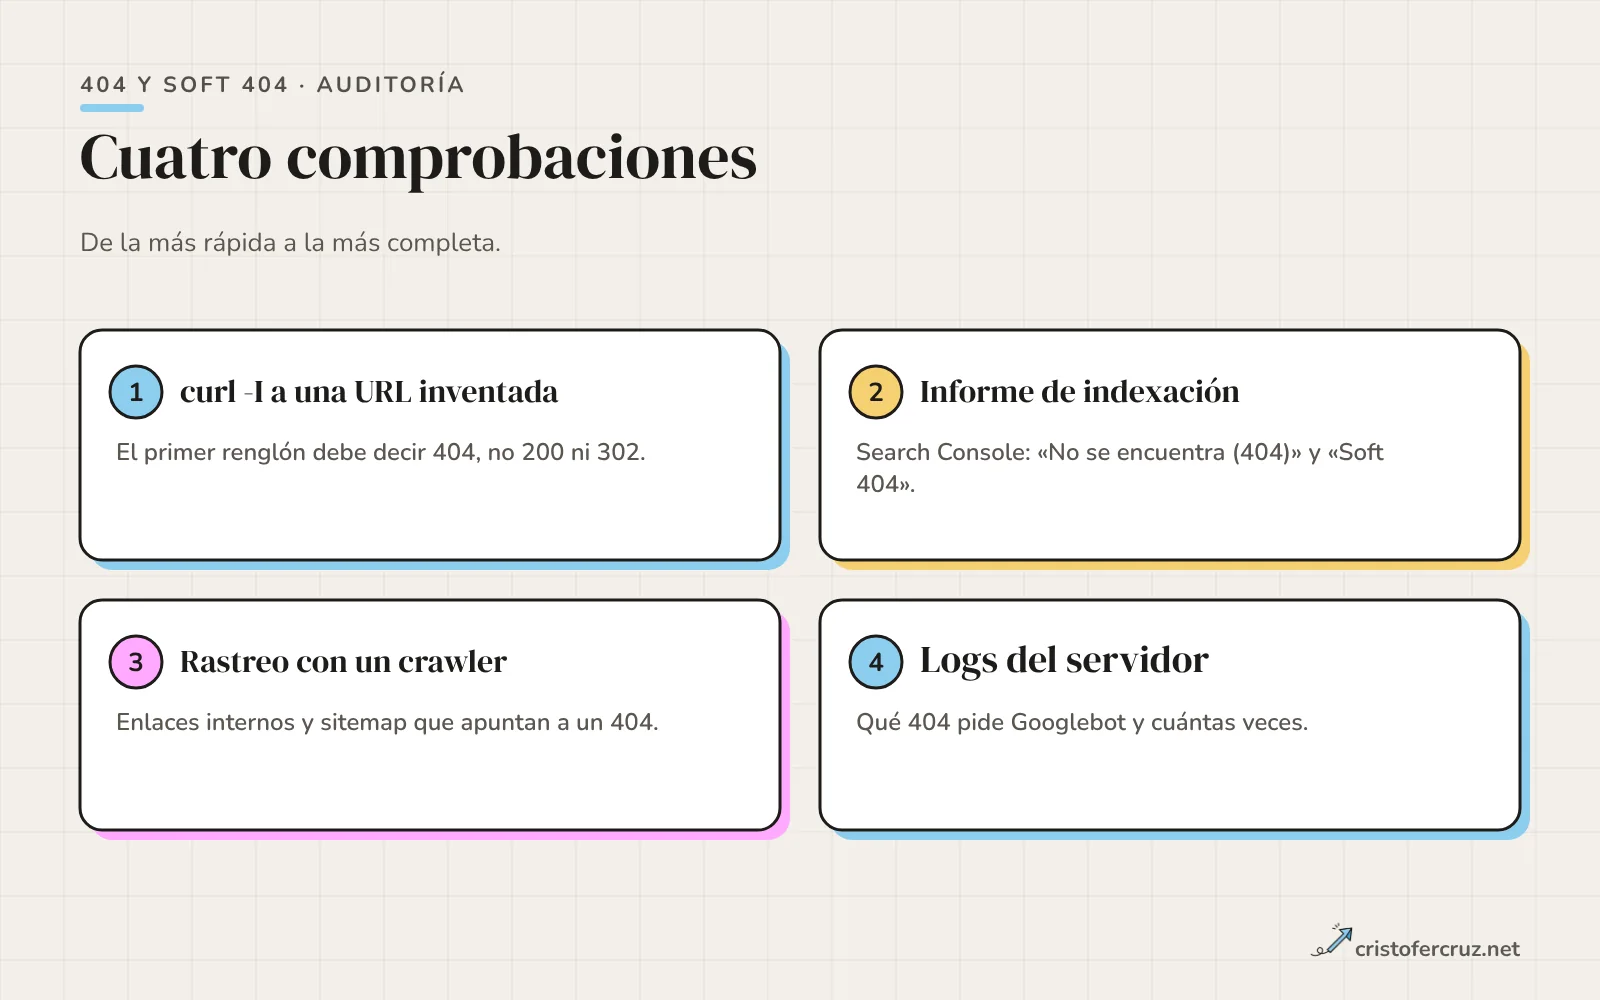
1. Una URL inventada con curl
curl -sI https://tudominio.com/una-url-que-no-existe-xyz/ | head -1
curl -s -o /dev/null -w '%{http_code} %{redirect_url}\n' https://tudominio.com/una-url-que-no-existe-xyz/
Debes ver 404 y la columna de redirección vacía. Si ves 200, tienes un soft 404 de manual; si ves 301 o 302, estás redirigiendo lo inexistente. Repite con una URL inventada dentro de cada sección (blog, productos, idiomas), porque cada una puede tener su propia lógica.
2. Informe de indexación
Abre los motivos 404 y Soft 404, exporta las URLs y cruza con tráfico y enlaces. Las que tienen valor van a un 301 a su equivalente; el resto se queda como está.
3. Rastreo y sitemap
Lanza un rastreo y filtra por respuestas 4xx. Todo enlace interno a un 404 se corrige en el origen, y toda URL del sitemap con 404 sale del sitemap.
4. Logs
Filtra las peticiones de Googlebot con código 404 y ordénalas por frecuencia. Si repite siempre las mismas, mira de dónde vienen: probablemente un enlace roto interno o externo que merece corrección.
Si prefieres que lo revise yo con tus datos reales, es una de las comprobaciones de una auditoría SEO.
Preguntas frecuentes
¿Los errores 404 perjudican el SEO?
Según la ayuda de Google, los 404 no afectan al rendimiento de tu sitio en búsqueda. Lo que sí tiene efecto es perder la URL: si tenía tráfico o enlaces y no la redirigiste, esa entrada desaparece.
¿Qué es un soft 404?
Una página que devuelve un código de éxito (normalmente 200) pero cuyo contenido parece un error: «no encontrado», vacía o sin resultados. Search Console la clasifica como soft 404 aparte de los 404 reales.
¿Es mejor un 404 o un 410?
Para Google, da igual: trata los 410 igual que los 404. Usa el 410 si quieres distinguir en tus informes lo que retiraste a propósito, pero no esperes una desindexación más rápida porque no está documentada.
¿Debo redirigir todos los 404 a la home?
No. La documentación de Google desaconseja redirigir a la home lo que no existe. Redirige con un 301 solo cuando haya una página equivalente; si no la hay, deja el 404.
¿Mi página 404 necesita noindex?
No si devuelve un 404 real, porque Google no usa el contenido de las URLs 4xx. Es útil si no puedes cambiar el código, por ejemplo en una SPA, donde Google propone redirigir a una URL con 404 o añadir noindex.
¿Los 404 gastan presupuesto de rastreo?
Poco: Google los considera una señal fuerte para no rastrear la URL de nuevo y la frecuencia baja con el tiempo. Los soft 404, en cambio, se siguen rastreando y gastan presupuesto.
¿Cómo sé si mi página de error devuelve 404 de verdad?
Pide con curl -I una URL inventada y mira la primera línea. Si no dice 404, no basta con mirar el navegador: la página puede verse como un error y responder 200.
Referencias y fuentes
Documentación consultada para este artículo.
- 404 (Page Not Found) errors Google Search Console Help
- Page indexing report Google Search Console Help
- HTTP status codes, and network and DNS errors Google Search Central
- Managing crawl budget for large sites Google Search Central
- JavaScript SEO basics Google Search Central
- Custom Error Responses Apache HTTP Server 2.4
- ¿Cómo identificar y corregir errores Soft 404? AIOSEO
- Cómo encontrar y solucionar errores 404 Neil Patel