- El código de estado es lo primero que lee un rastreador: decide si procesa el contenido, sigue una redirección, retira la URL o baja el ritmo. El texto de la página no lo cambia.
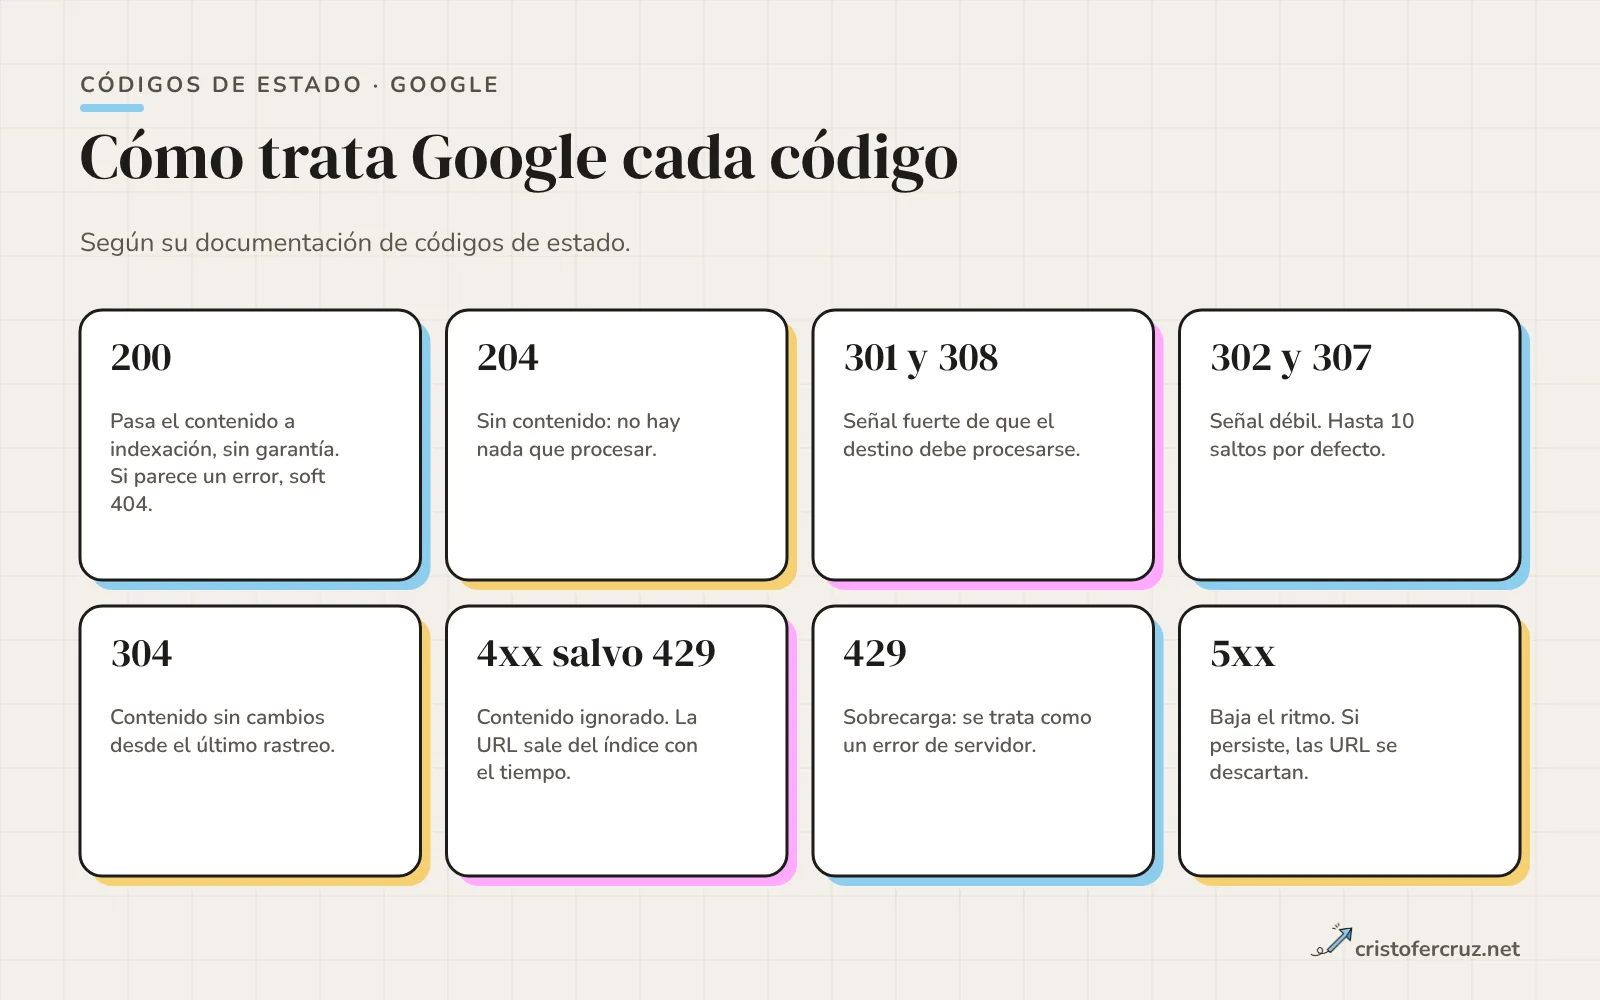
- Para Google, 301 y 308 son una señal fuerte, 302 y 307 una señal débil; todos los 4xx salvo el 429 se tratan como «contenido inexistente»; y el 429 y los 5xx hacen que el rastreo baje de ritmo.
- Un 200 que enseña un mensaje de error es un soft 404. Un 401 o un 403 no sirven para limitar el rastreo, y Google lo dice expresamente.
- El 304 solo existe si el servidor envía
ETagoLast-Modifiedy el cliente los devuelve: es la respuesta que ahorra descargas. - Para una pausa urgente, 503 o 429 con
Retry-After, durante horas o uno o dos días, no más. - Se comprueba con
curl -I, DevTools, Inspección de URL y logs, en ese orden. Yo he probado las respuestas con nginx y Apache reales y las menciono aquí.
La mayoría de las guías de códigos HTTP para SEO se quedan en una lista de seis o siete números con una frase cada uno. Lo que casi nunca cuentan es qué cambia en la práctica: qué hace Google con un 204, por qué un 403 no frena a Googlebot, cuándo un 304 se convierte en ahorro de rastreo o por qué un 200 con el texto «no encontrado» es un problema de código y no de redacción.
Este es el artículo de referencia de la serie sobre servidores. Repaso las cinco familias, la tabla de cómo trata Google cada código (con su documentación oficial al lado), los casos que más confusión generan, las cabeceras que acompañan a cada respuesta y los resultados de las pruebas que hice con servidores reales. Para los temas con artículo propio resumo y enlazo en lugar de repetir.
Qué son los códigos de estado y cómo se leen
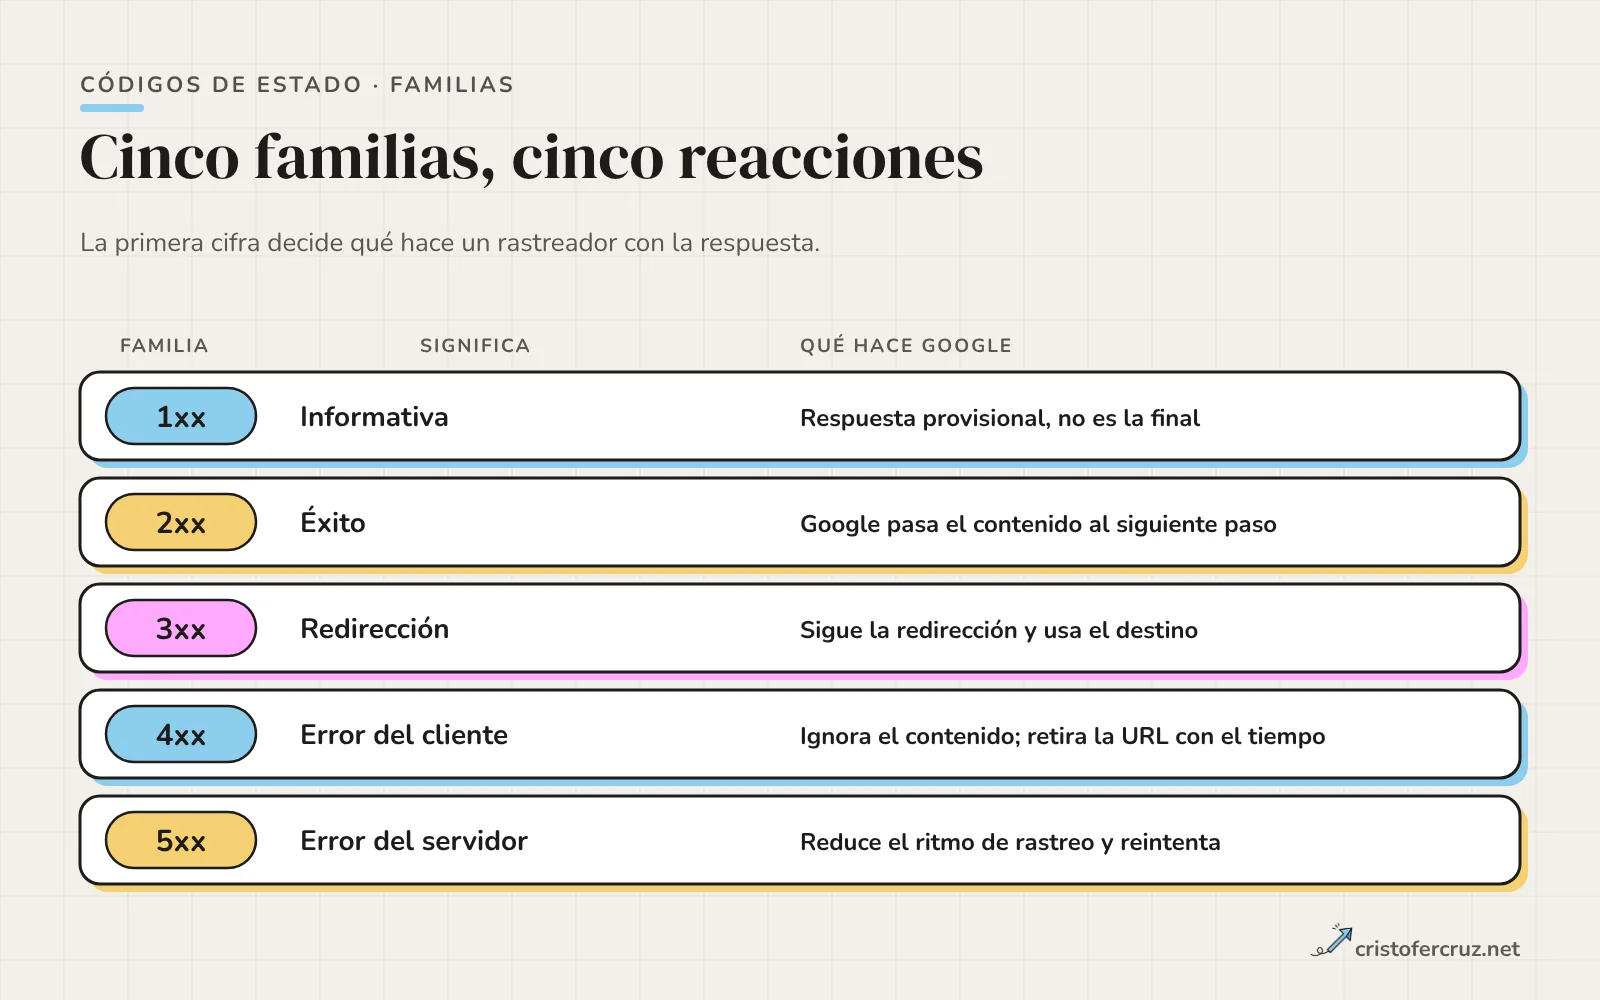
Un código de estado es el número de tres cifras con el que el servidor empieza su respuesta: HTTP/1.1 200 OK. La primera cifra marca la familia y el resto concreta. Esa clasificación procede del estándar HTTP (RFC 9110), y MDN la resume así: 1xx informativa, 2xx éxito, 3xx redirección, 4xx error del cliente y 5xx error del servidor.
El texto que acompaña al número («OK», «Not Found») es orientativo. Lo que interpreta un rastreador es el número. Por eso una página con el titular «Error 404» y un 200 en la cabecera es, para Google, una página que responde con éxito.
Lo que ves en el navegador no siempre es lo que recibió el rastreador: los navegadores siguen redirecciones sin enseñártelas y cachean respuestas. Para saber qué se respondió de verdad hay que mirar la cabecera, como explico en la sección de verificación.
Cómo trata Google cada código
Google documenta el comportamiento de sus rastreadores por código en «HTTP status codes, network and DNS errors» (Search Central) y en la página equivalente de su infraestructura de rastreo. Esta tabla resume lo que dicen, sin añadir nada que no esté ahí.
| Código | Qué hace Google según su documentación |
|---|---|
| 200 | Pasa el contenido recibido al siguiente paso. Un 2xx no garantiza la indexación; si el contenido parece un error, Search Console muestra un soft 404. |
| 201, 202 | El 202 se trata esperando un tiempo limitado antes de pasar lo recibido. |
| 204 | No hay contenido, así que no hay nada que procesar. |
| 301, 308 | Señal fuerte de que el destino debe procesarse. Se ignora el contenido de la URL que redirige. |
| 302, 307 | Señal débil. Hasta 10 saltos por defecto en los rastreadores de Google. |
| 304 | El contenido no ha cambiado desde el último rastreo. Puede recalcular señales, pero no afecta a la indexación. |
| 400, 401, 403, 404, 410, 411 | Se trata como contenido inexistente. Las URL nuevas con 404 no se procesan, y las ya indexadas se retiran con el tiempo. |
| 429 | Se trata como señal de sobrecarga del servidor, igual que un error de servidor. |
| 500, 502, 503 | El rastreo baja de ritmo; las URL indexadas se conservan un tiempo y se descartan si el error persiste. Cuando vuelve el 2xx, el ritmo sube de forma gradual. |
Dos aclaraciones sobre lo que esa documentación no dice. No indica cuántos días tarda una URL con error en salir del índice, y la página de códigos no menciona el 405 ni la cabecera Retry-After; esta última aparece en la guía para reducir el ritmo de rastreo, que cito más abajo. Tampoco encontré en esas páginas ninguna mención al 1xx.
2xx: el 200, el 204 y el 200 con contenido de error
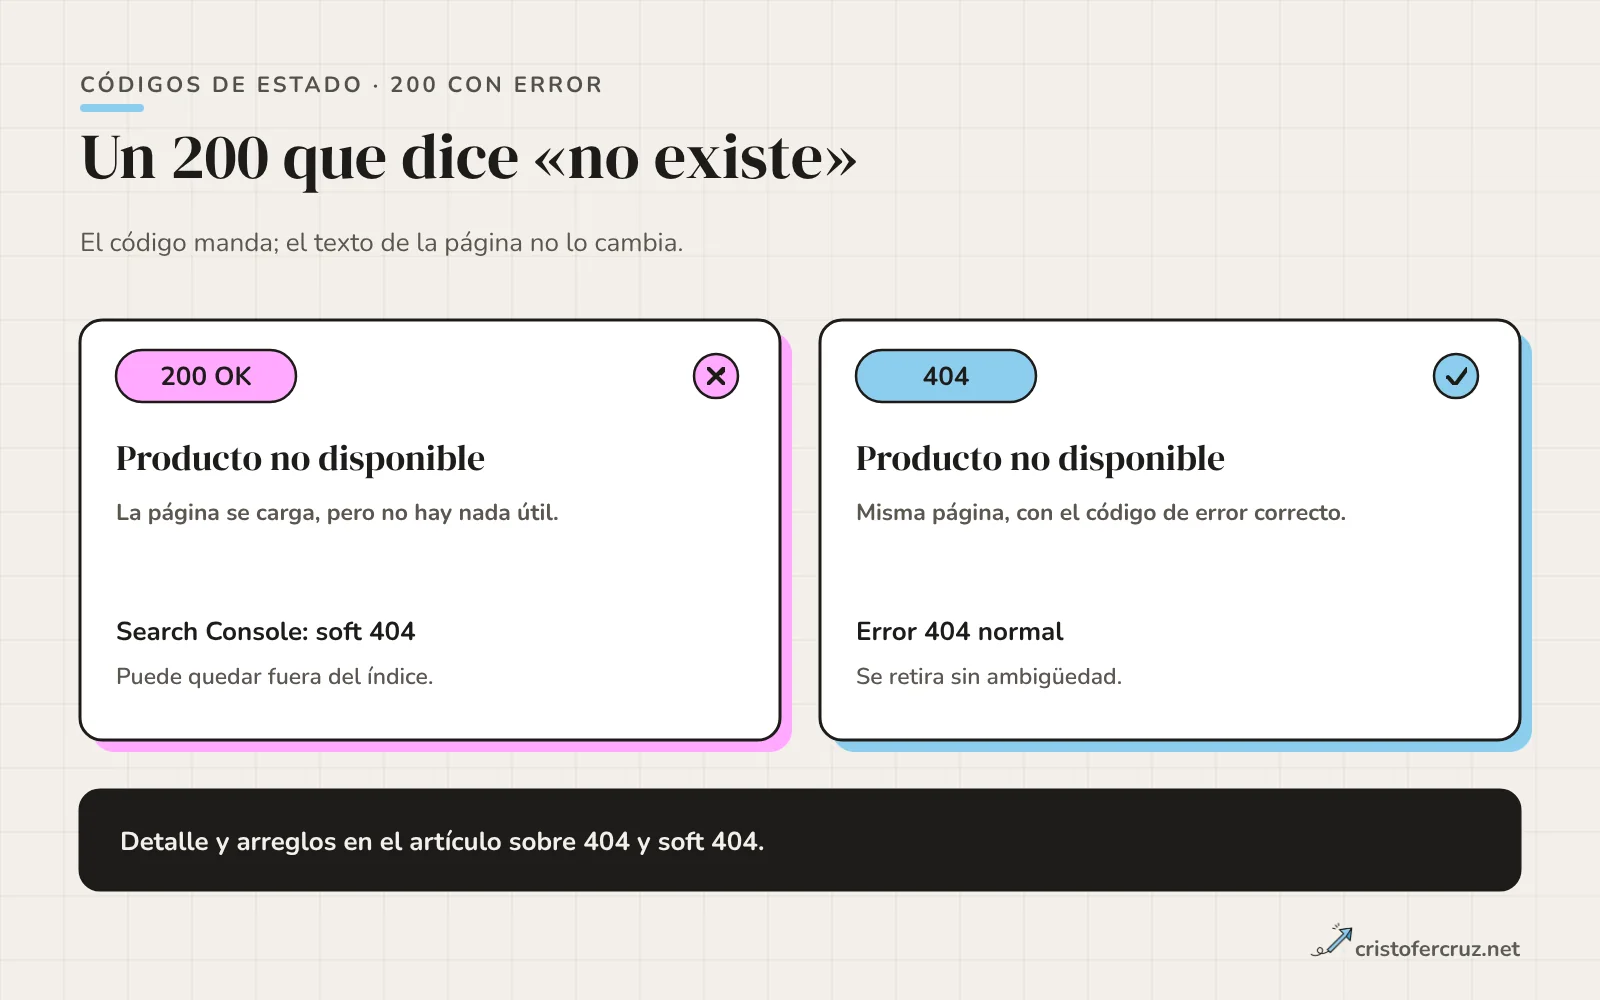
El 200 es el código que quieres en toda página indexable, pero que lo devuelva el servidor no te asegura nada. Google lo dice con todas las letras: un 2xx no garantiza la indexación. Y si el cuerpo parece un error, una página vacía o un mensaje de «no disponible», Search Console lo marca como soft 404.
El caso típico: la plantilla de «producto agotado» o «sin resultados» que sigue respondiendo 200. A la persona le llega el aviso; al rastreador, una respuesta de éxito con contenido que parece un error. Resolverlo es cuestión de código, no de texto: o la página tiene contenido útil, o responde con 404 o 410, o se saca del índice con noindex. Los arreglos concretos, las causas y la configuración de la página de error están en el artículo sobre 404 y soft 404.
El 204 y las respuestas sin cuerpo
El 204 está pensado para respuestas que no devuelven contenido, como una API que confirma un guardado. MDN lo define como «no hay contenido que enviar, pero las cabeceras son útiles». Para Google no hay nada que procesar, así que una página que deba posicionar nunca debería responder 204. Si ves uno en una URL de contenido, es un fallo de la aplicación o de una regla de servidor, y conviene tratarlo igual que una página vacía.
3xx: redirecciones y lo que Google hace con ellas
Con las redirecciones, Google distingue dos intensidades: 301 y 308 como señal fuerte de que el destino es el que debe procesarse, 302 y 307 como señal débil. El contenido de la URL que redirige se ignora y se usa el de la final, con un máximo por defecto de 10 saltos. La diferencia entre 301 y 308 (y entre 302 y 307) es de método HTTP: los segundos obligan a repetir el mismo método, algo que a Google no le cambia la interpretación pero sí a otros clientes, como los formularios.
No voy a repetir aquí la elección entre ellas, las cadenas, los bucles o el mapa de redirecciones de una migración: eso está en el artículo sobre redirecciones 301, 302, 307 y 308. Una nota sobre las redirecciones que no son un código: el meta refresh se resuelve en el HTML, no en la cabecera, y por eso no sustituye a un 301 aunque el navegador haga lo mismo.
304: la respuesta que ahorra descargas
El 304 no es un error ni una redirección: es el servidor diciendo «lo que tienes sigue valiendo». Funciona con un intercambio en dos pasos. El cliente pide el recurso con una cabecera condicional (If-None-Match con el ETag que recibió, o If-Modified-Since con la fecha). Si no ha cambiado, el servidor responde 304 sin cuerpo; si cambió, responde 200 con el contenido nuevo.
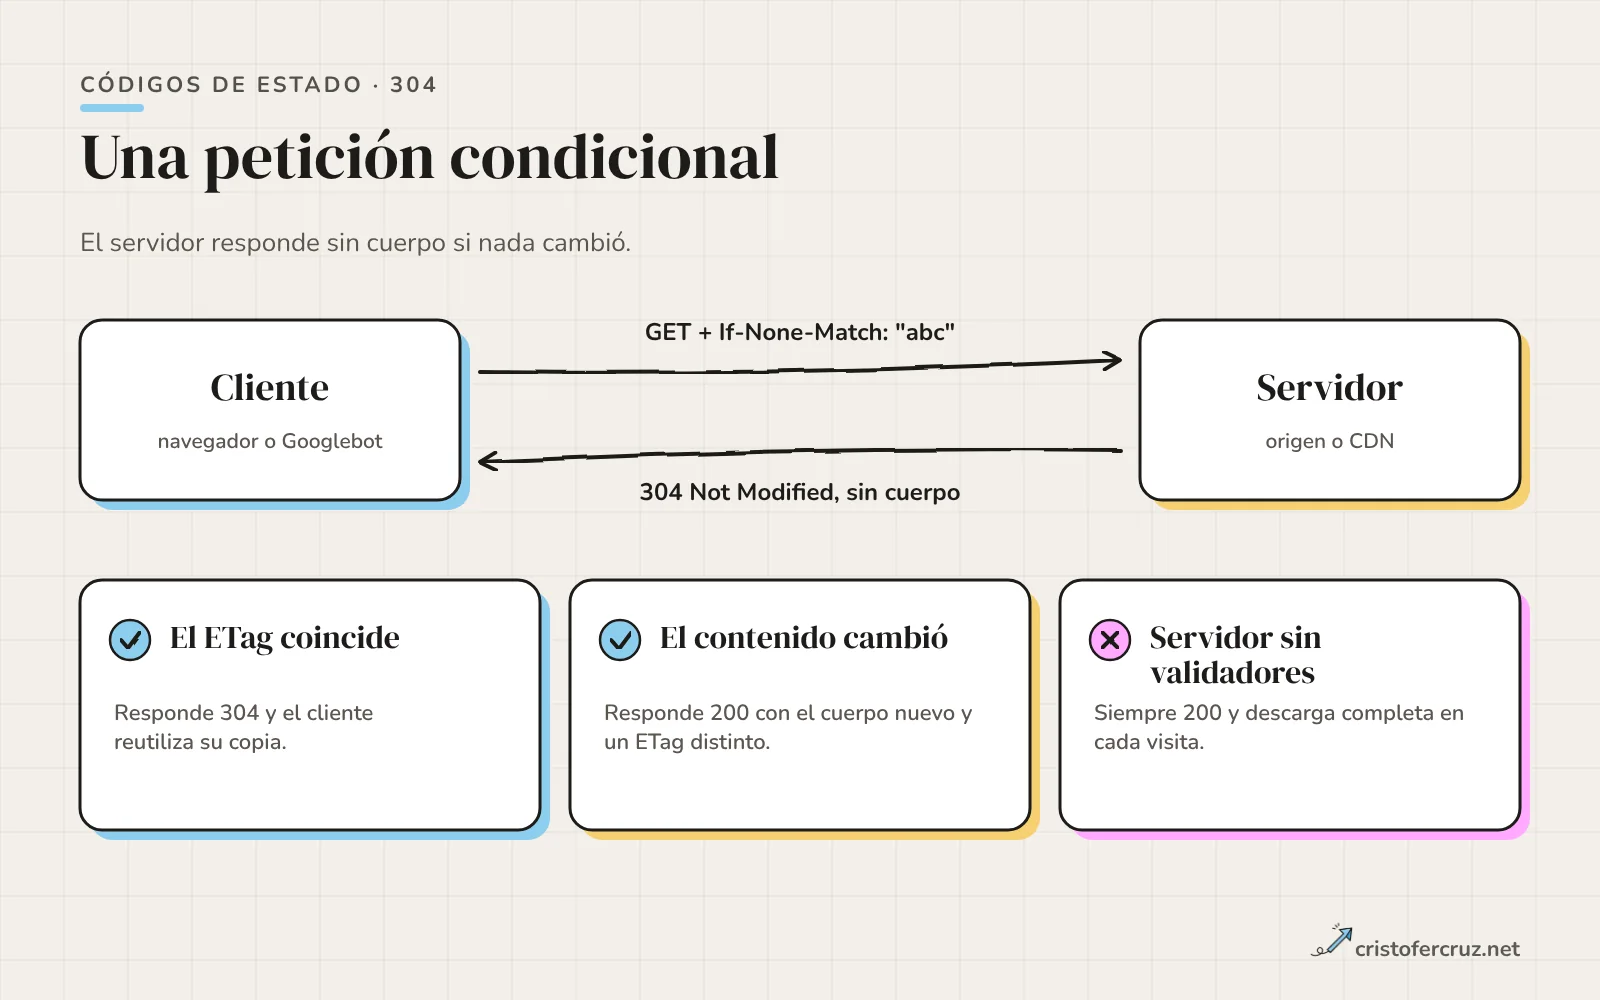
Para Google, el 304 significa que el contenido no ha cambiado desde el último rastreo, y la documentación añade que no afecta a la indexación. Para el servidor significa menos bytes enviados. Para que ocurra, el servidor tiene que enviar validadores y atender las cabeceras condicionales; con páginas generadas por PHP o por un CMS, eso no sucede por defecto. Qué validadores usa Googlebot, cómo combinarlos con Cache-Control y qué errores de caché dañan al SEO está en caché HTTP y Googlebot.
En mi prueba con nginx, una petición con el ETag correcto devolvió 304 Not Modified sin cuerpo; con un ETag distinto devolvió 200. Con Apache pasó lo mismo sobre un robots.txt estático. Lo que no he probado es cómo se comporta Googlebot con ese 304 en una web real.
4xx: 401, 403, 404, 410 y por qué no frenan al rastreador
Todos los 4xx, salvo el 429, reciben el mismo trato: Google no usa el contenido que devuelven y, si la URL estaba indexada, la va retirando. Esto tiene una consecuencia que desmonta una idea muy extendida: bloquear a Googlebot con 401 o 403 no reduce el rastreo. La documentación lo dice sin rodeos: no uses 401 ni 403 para limitar el ritmo.
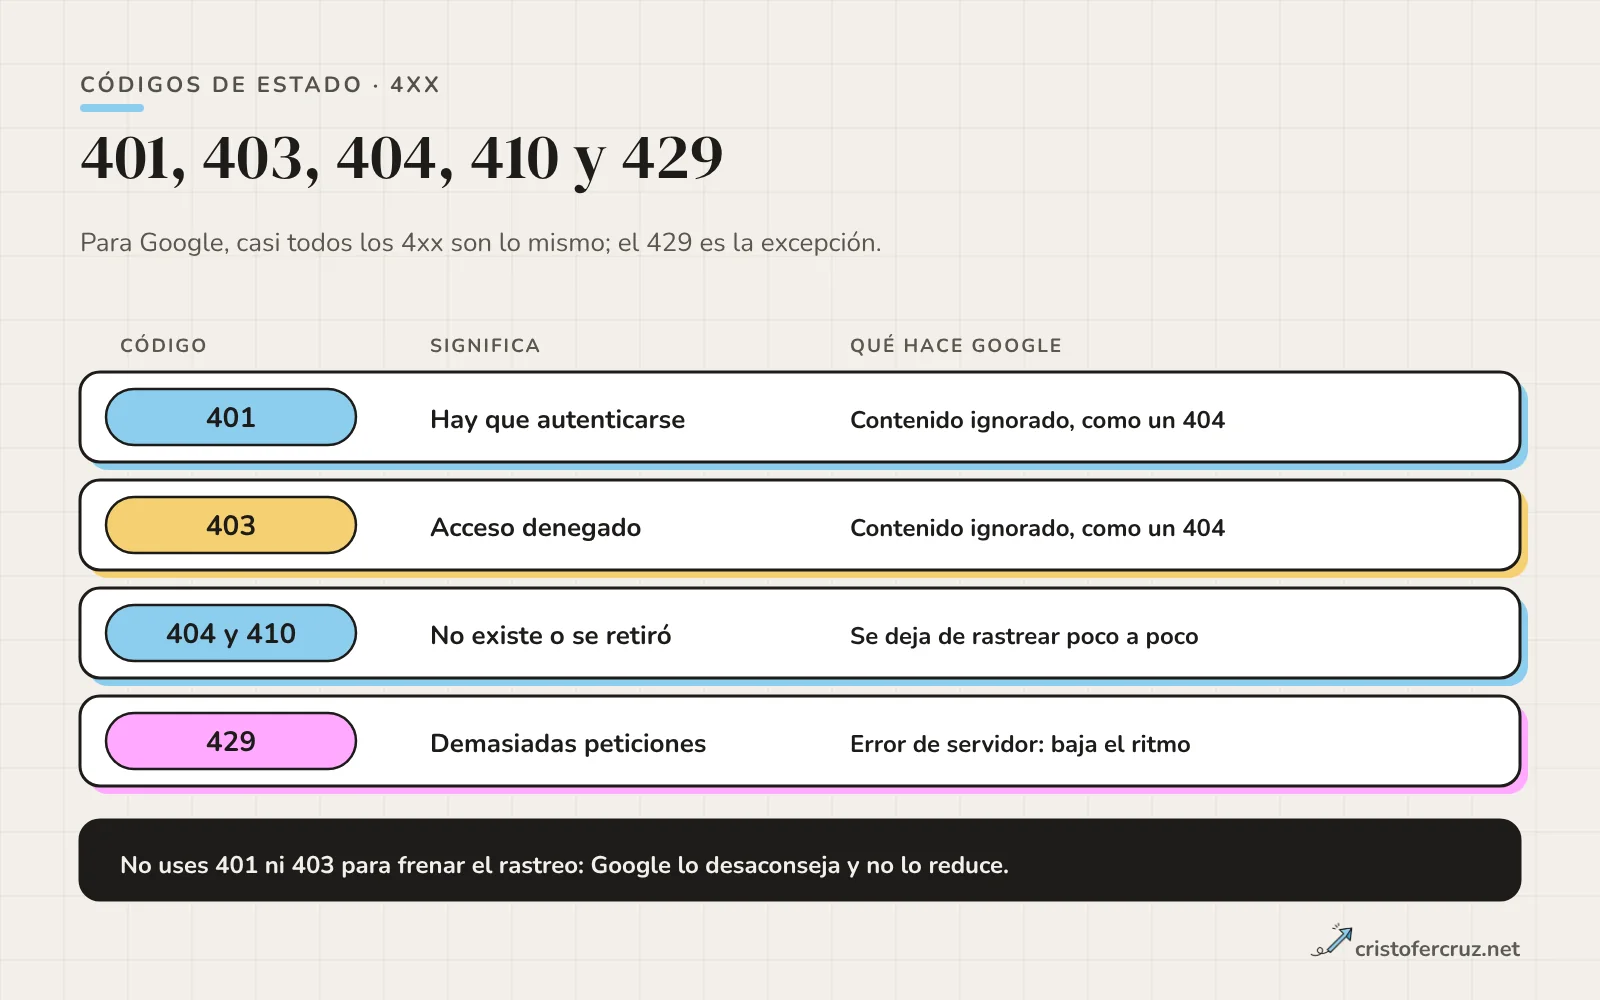
| Código | Significado (MDN) | Cuándo lo uso |
|---|---|---|
| 401 | El cliente debe autenticarse; semánticamente, «no autenticado». | Áreas privadas con login real, entornos de preproducción protegidos por contraseña. |
| 403 | El servidor conoce al cliente y se niega a servir el recurso. | Carpetas internas y archivos que no deben salir. |
| 404 | No se ha encontrado el recurso. | Por defecto para URL que no existen. |
| 410 | Eliminado de forma permanente, sin dirección de reenvío. | Contenido retirado a propósito. Google lo trata como un 404. |
| 405 | El método existe pero este recurso no lo admite. | Un endpoint que solo acepta POST y recibe un GET. |
| 451 | No disponible por motivos legales. | Bloqueos por orden legal. No lo he visto citado en la documentación de Google. |
Entre 404 y 410, Google no distingue. La elección es tuya y de tus informes: un 410 deja claro que la retirada fue intencionada. El detalle, con cuándo redirigir en lugar de dejar el error, está en el artículo de 404 y soft 404.
Un caso especial: el 4xx en robots.txt
El archivo robots.txt tiene sus propias reglas, y aquí el código importa mucho. Google trata los 4xx (salvo el 429) como si el archivo no existiera, así que rastrea sin restricciones. Un 5xx sostenido en robots.txt es más serio: Google deja de rastrear durante las primeras 12 horas, usa la última versión válida hasta 30 días y después actúa como si no hubiera archivo si el sitio está disponible. Todo el detalle está en el artículo de robots.txt.
429 y 5xx: cuando el servidor pide calma
Los errores 5xx y el 429 tienen el mismo efecto: Google reduce temporalmente el ritmo de rastreo. Las URL indexadas se mantienen un tiempo y, si el error persiste, se descartan. Para el 500, la documentación indica que la bajada del ritmo es proporcional al número de URL que fallan. Cuando vuelve el 2xx, el ritmo sube de forma gradual.
Ese mecanismo se puede usar a propósito. La guía de Google para reducir el rastreo recomienda un 500, 503 o 429 en lugar de un 200 durante un periodo corto, de un par de horas a uno o dos días, y avisa de que no es una solución a largo plazo: si los mismos códigos se mantienen varios días en una URL, esa URL puede salir del índice. El efecto afecta a todo el hostname.
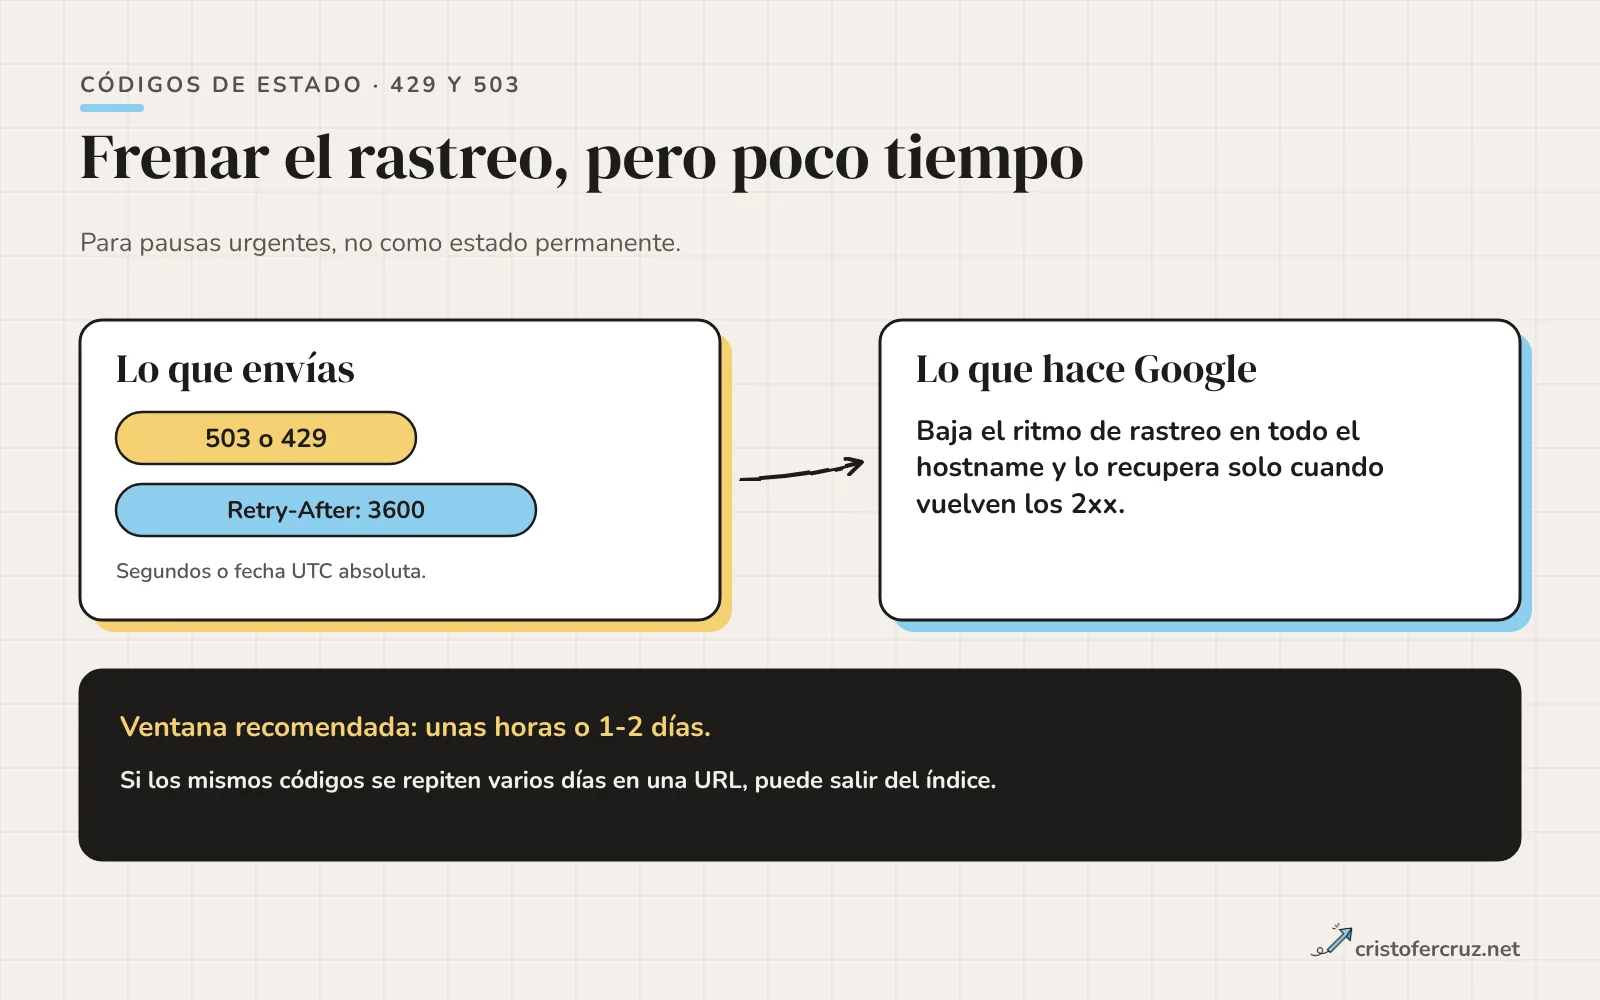
La cabecera Retry-After acompaña al 503 y al 429. Según Google, indica cuándo reintentar con un número de segundos o con una fecha UTC absoluta. Yo uso segundos, porque no dependo del reloj del servidor. Cómo montar una página de mantenimiento correcta, qué distingue un 500 de un 502 o un 504 y cómo actuar cuando los 5xx aparecen por sorpresa lo tienes en el artículo sobre errores 5xx y el 503 de mantenimiento. Si lo que te preocupa es cuánto rastrea Google tu sitio, el presupuesto de rastreo es el sitio donde mirar.
Cabeceras que acompañan al código
El código rara vez viaja solo. Varias cabeceras completan su significado, y un código correcto con la cabecera equivocada falla igual de mal.
| Cabecera | Va con | Para qué sirve |
|---|---|---|
Location | 301, 302, 303, 307, 308 | La URL de destino de la redirección. |
Retry-After | 429, 503 | Cuándo reintentar: segundos o fecha. |
ETag y Last-Modified | 200 y 304 | Validadores para las peticiones condicionales. |
Cache-Control | Cualquiera | Cuánto se puede reutilizar la respuesta. MDN recomienda no cachear los 503, que son una condición temporal. |
WWW-Authenticate | 401 | El esquema de autenticación esperado. |
Allow | 405 | Los métodos que sí admite el recurso. |
X-Robots-Tag | Cualquiera que llegue a indexación | Directivas de indexación por cabecera. |
La última merece una aclaración: la cabecera X-Robots-Tag solo se lee si el rastreador llega a la respuesta. En un 404 o un 5xx, Google ya ignora el contenido; no está documentado que la cabecera aporte algo ahí. Úsala en páginas que respondan 200 y no deban indexarse.
Tabla de referencia: qué código para qué situación
Esta es la tabla que consulto cuando reviso una web. No lista todos los códigos del estándar, solo los que acaban teniendo consecuencias en SEO.
| Situación | Código | Qué evitar |
|---|---|---|
| Página normal indexable | 200 | 200 en páginas vacías o de error. |
| URL cambia para siempre | 301 (o 308) | 302 «provisional» que se queda años. |
| Cambio temporal real | 302 (o 307) | Usarlo en migraciones definitivas. |
| Recurso sin cambios | 304 (con ETag o Last-Modified) | No enviar validadores y servir siempre 200. |
| Contenido que nunca existió | 404 | Redirigir todo a la home. |
| Contenido retirado a propósito | 410 o 404 | 200 con el texto «ya no está». |
| Área privada | 401 o 403 | Esperar que reduzca el rastreo. |
| Pausa urgente de rastreo | 503 o 429 con Retry-After | Mantenerlo más de uno o dos días. |
| Fallo del servidor | 500 (o 503 si es temporal) | Dejar que un 5xx se prolongue sin vigilancia. |
Cuando dudes entre dos códigos, pregúntate qué debe hacer el rastreador con esa URL dentro de un mes: indexarla, sustituirla por otra, retirarla o volver a pasar. El código correcto es el que expresa esa decisión.
Lo que probé en un laboratorio
Para no limitarme a repetir documentación, levanté un nginx 1.24.0 con una ruta por código y lo consulté con curl. Los resultados, tal como salieron, con la redirección apuntando a una página estática del propio laboratorio:
| Ruta | Respuesta | Observación |
|---|---|---|
/204 | 204 No Content | Sin cuerpo. |
/301 y /308 | 301 y 308 | Con Location hacia la página de destino. |
/302 y /307 | 302 y 307 | Igual, con Location. |
/401 | 401 | Con WWW-Authenticate: Basic realm="privado". |
/429 | 429 Too Many Requests | Con Retry-After: 120. |
/503 | 503 | Con Retry-After: 3600. |
| Fichero estático con ETag | 304 | Con If-None-Match igual al ETag; con otro valor, 200. |
| POST a un fichero estático | 405 | nginx rechaza el método por defecto. |
La comprobación que más me interesaba era la del soft 404. En el mismo nginx, una ruta que sirve con try_files una página que dice «no existe» devolvió 200, mientras que una ruta que no encuentra nada devolvió 404. El servidor no se inventa el código por mucho que el HTML hable de errores: lo decide la configuración. Es la prueba más simple de que un soft 404 es un problema de servidor o de plantilla.
$ curl -s -o /dev/null -w '%{http_code}\n' -H 'If-None-Match: "6ac6debe-3d"' http://127.0.0.1:8372/pagina.html
304
$ curl -s -o /dev/null -w '%{http_code}\n' -H 'If-None-Match: "otro"' http://127.0.0.1:8372/pagina.html
200
No probé cómo reacciona Googlebot a ninguno de estos códigos. Lo que digo sobre Google viene de su documentación; lo que digo sobre los servidores, de estas pruebas.
Cómo trato los códigos en mi web
Hice curl a mi web en local y lo contrasté con el código del sitio (.htaccess, 404.php, send.php, robots.txt). Hay una advertencia previa: en local la sirvo con el servidor integrado de PHP (php -S), que no aplica el .htaccess. Lo que sale de ahí no es lo que hará mi hosting.
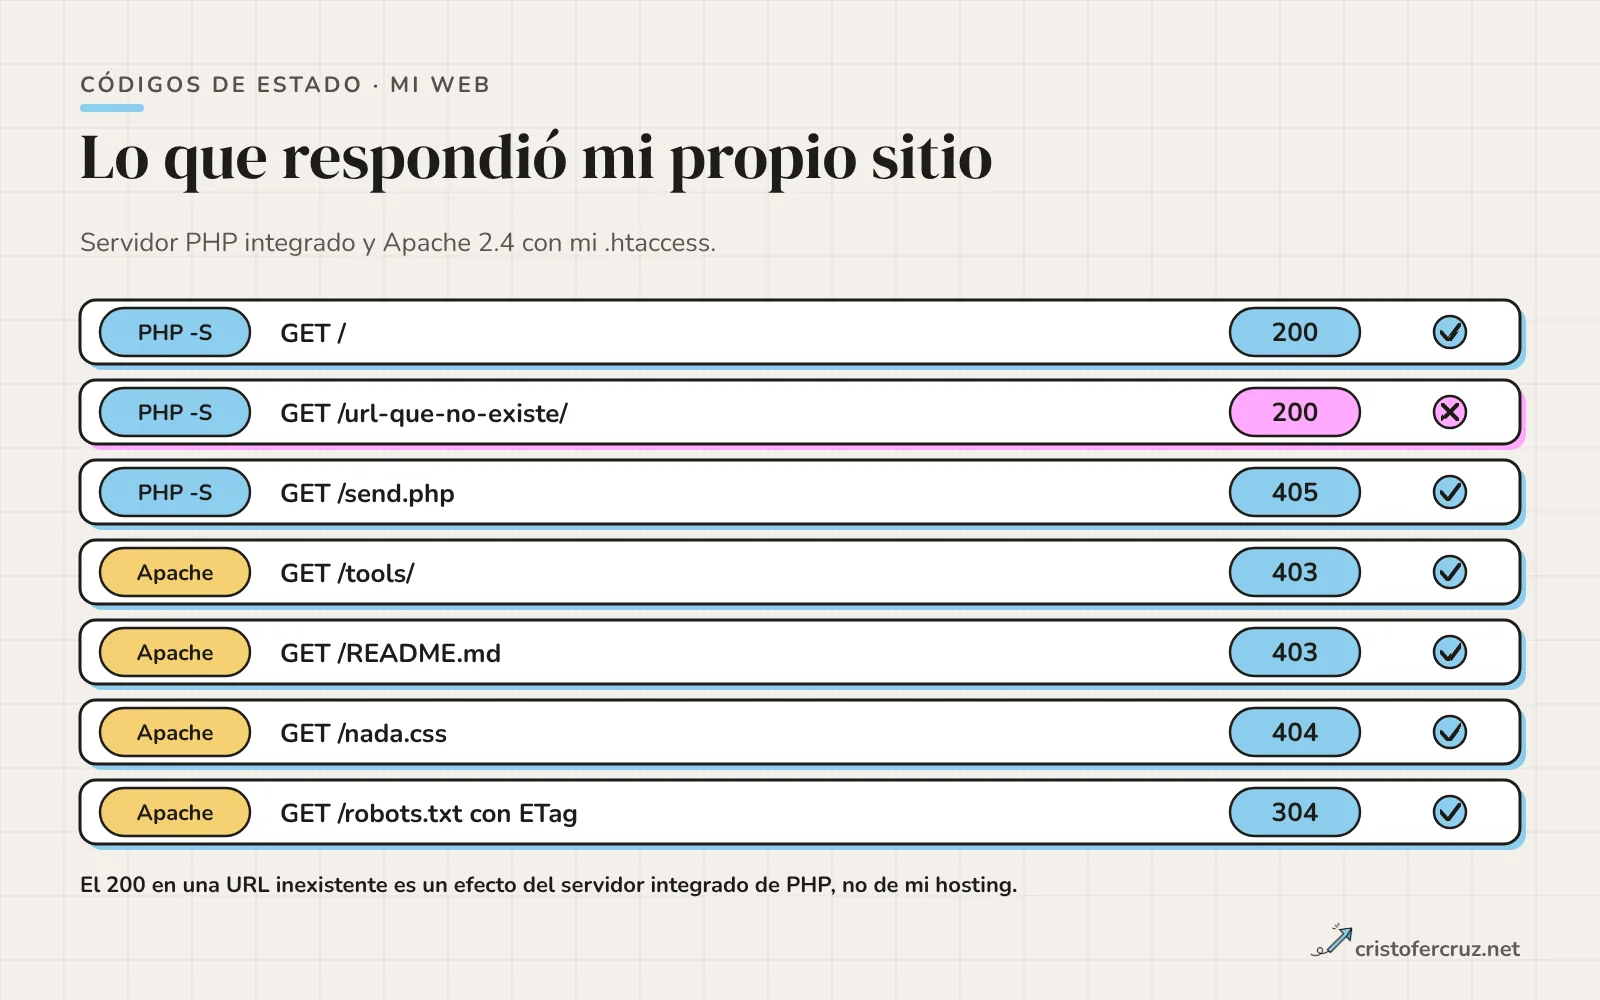
Con el servidor integrado de PHP:
| Petición | Código | Lectura |
|---|---|---|
GET / | 200 | La portada. |
GET /url-que-no-existe/ | 200 | Devolvió la portada: ante una ruta inexistente, el servidor integrado cae al index.php. |
GET /blog/ | 200 | Con Cache-Control: no-cache. |
GET /blog/nope/ | 200 | Devolvió el listado del blog, por la misma razón. |
GET /send.php | 405 | Con Allow: GET, POST, X-Robots-Tag: noindex, nofollow y Cache-Control: no-store. |
GET /404.php | 404 | El script fuerza el 404 con http_response_code(404). |
GET /nada.css | 404 | El servidor integrado responde 404 para archivos con extensión que no existen. |
Lo importante de esa tabla es la segunda fila. Si mirases mi web en local y vieses un 200 en una URL inventada, pensarías que tengo un problema de soft 404. No lo es: es un comportamiento de php -S. Para saber qué hace mi servidor de verdad hay que probar contra el servidor de producción, y eso no lo he hecho aquí.
Para acercarme, arranqué un Apache 2.4.58 apuntando a la carpeta del sitio, con mi .htaccess activo y sin PHP. Resultados: /tools/ y /.git/config devolvieron 403 (reglas RewriteRule … [F]), /README.md devolvió 403 (el FilesMatch con Require all denied), /includes/ y /assets/ devolvieron 403 (Options -Indexes sin índice), /nada.css devolvió 404 y /robots.txt con su ETag devolvió 304. No pude comprobar cómo se ve la página 404 con PHP, así que lo que sigue es lo que dice el código, no una prueba.
- El
.htaccessdeclaraErrorDocument 404 /404.phpyErrorDocument 403 /404.php. El script404.phpenvíahttp_response_code(404),Cache-Control: no-storeyX-Robots-Tag: noindex, nofollow. Por el código, un 403 debería acabar mostrándose como 404, pero no lo he verificado. - Las redirecciones del formulario usan 303 hacia una página de resultado (
send.php?resultado=1). Está bloqueada enrobots.txty envíanoindex. Como Google no puede rastrear lo que robots.txt bloquea, esa cabecera no la va a leer; es una redundancia inofensiva. - El sitio no define
ErrorDocument 500ni 503, ni una página de mantenimiento. Lo que se vea ante un fallo lo decide el hosting. - Las páginas PHP no envían
ETagniLast-Modified(lo comprobé en/): no hay 304 posible en el HTML dinámico, y sí en los estáticos servidos por Apache.
Cómo comprobar los códigos
El orden que sigo va de lo más cercano al servidor a lo más cercano a Google.
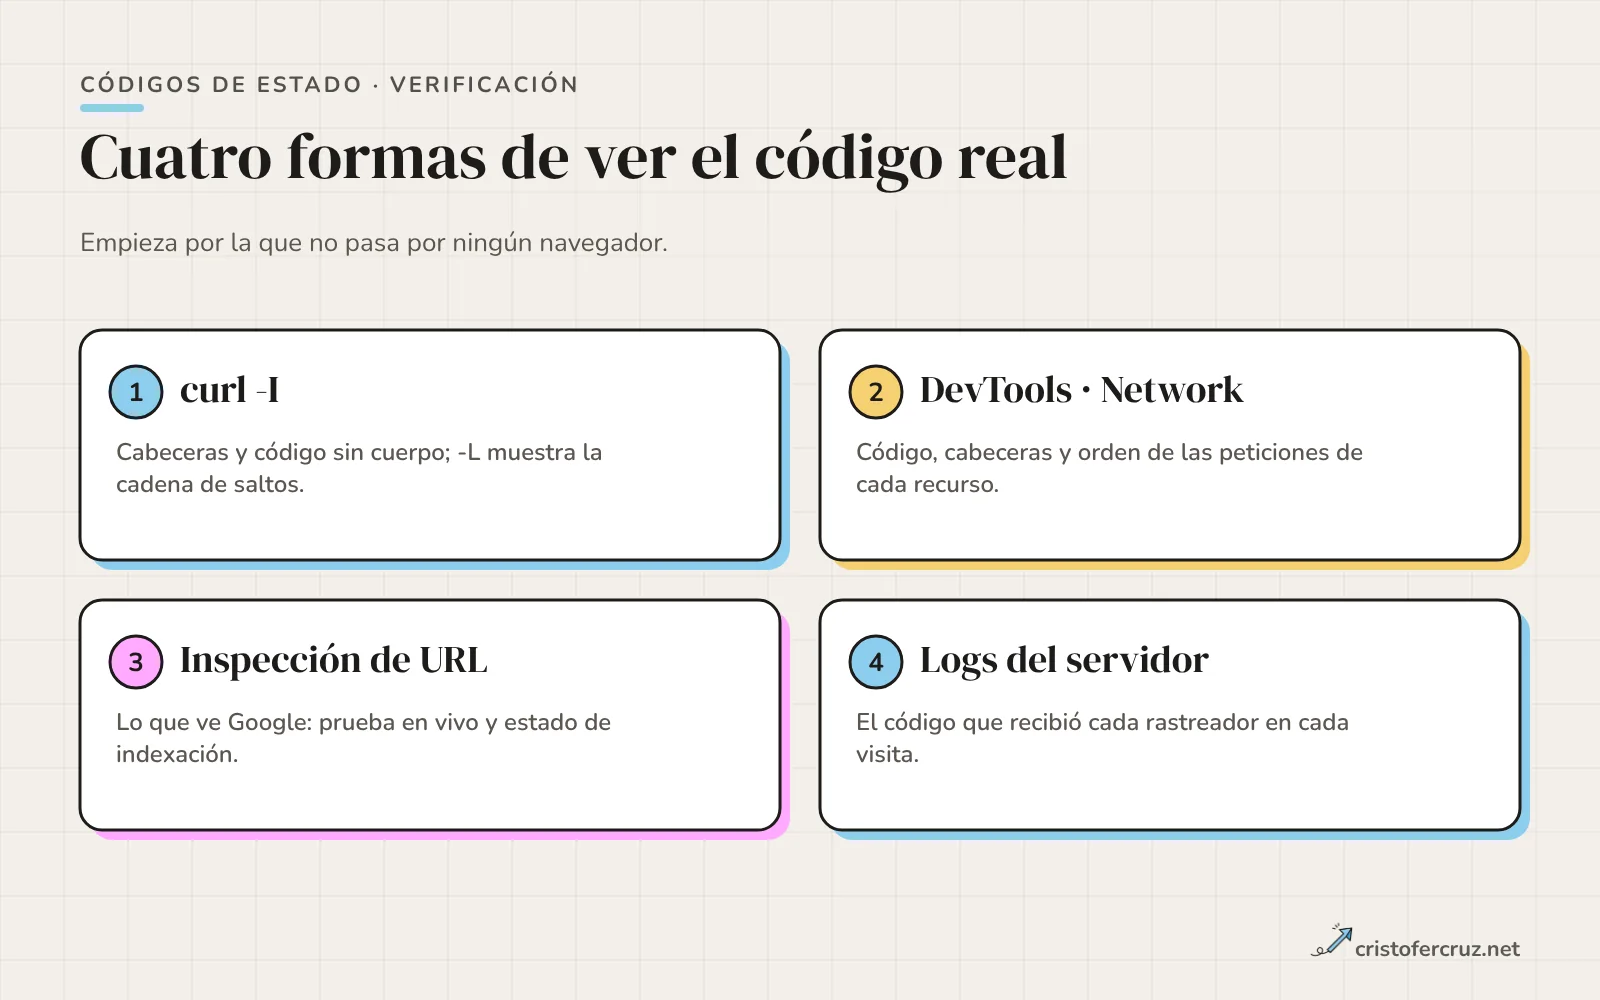
- curl.
curl -sI URLmuestra la cabecera sin descargar el cuerpo. Con-Lsigue las redirecciones; con-w '%{http_code} %{redirect_url}\n' -o /dev/nullimprimes solo el código y el destino. Cuidado con una trampa:-Iusa HEAD, y hay servidores que responden distinto a HEAD y a GET. - DevTools, pestaña Network. Filtra por documento y mira el código y las cabeceras. Activa «Preservar registro» para no perder las redirecciones.
- Inspección de URL en Search Console. La prueba en vivo enseña lo que obtiene Google, incluido el código. Según la documentación de Google, las herramientas de inspección no siguen redirecciones.
- Logs del servidor. Es el único sitio donde ves lo que recibió cada rastreador en cada visita, con su código. En el artículo de análisis de logs explico cómo extraer los 4xx y 5xx de Googlebot con grep y awk.
Los rastreadores de escritorio (Screaming Frog y similares) revisan miles de URL de una vez, pero consultan como un cliente cualquiera: no dicen qué vio Google.
Errores que veo con más frecuencia
- Un 200 en las URL que no existen, porque la aplicación o una regla de reescritura entrega una plantilla a todo.
- Redirigir todos los 404 a la portada. Google puede tratarlo como soft 404.
- Un 302 que lleva años donde debería haber un 301.
- Usar 403 para frenar bots o 401 para «ocultar» contenido, esperando que baje el rastreo.
- Una página de mantenimiento con 200 en lugar de 503.
- Mezclar código y cabecera: un 503 cacheado, un 301 sin
Locationo un 405 sinAllow.
Sacar de los logs, una vez al mes, el recuento de códigos por rastreador: un salto en el porcentaje de 3xx, 4xx o 5xx suele apuntar a un despliegue o a una regla nueva.
Preguntas frecuentes
¿Qué códigos de estado importan más para el SEO?
200, 301, 302, 304, 404, 410, 429, 500 y 503. Con ellos se explica casi todo lo que Google documenta sobre indexación, redirección, retirada de URL y ritmo de rastreo. Los demás (204, 401, 403, 405) importan por casos concretos.
¿Un 403 impide que Google rastree mi página?
Google trata el 403 como los demás 4xx: ignora el contenido y retira la URL con el tiempo. Pero la documentación advierte de que no se use para limitar el ritmo de rastreo. Para impedir rastreo, lo que se usa es robots.txt; para impedir indexación, noindex.
¿Qué diferencia hay entre 404 y 410 para Google?
Ninguna en el tratamiento: ambos se consideran contenido inexistente. El 410 comunica que la retirada es intencionada, útil para tus propios informes.
¿Qué es un soft 404?
Una URL que devuelve un 2xx pero cuyo contenido parece un error, está vacío o muestra un mensaje de no disponible. Search Console lo señala como soft 404. Se corrige con el código adecuado o con contenido real.
¿Cuánto tarda Google en quitar una URL que devuelve 404?
La documentación habla de «gradualmente» y no da un plazo. Si necesitas retirarla antes, existe la herramienta de eliminación de URL en Search Console para una retirada temporal; no sustituye al código correcto.
¿Cuánto tiempo puedo devolver un 503 sin riesgo?
Google propone una pausa de unas horas o de uno o dos días, y avisa de que si los mismos códigos se mantienen varios días en una URL, puede salir del índice. No da un número más preciso.
¿Un 304 mejora el posicionamiento?
No directamente: según Google, no afecta a la indexación. Reduce la transferencia, y en servidores con mucho rastreo ese ahorro puede ser apreciable, pero no es un factor de ranking.
Referencias y fuentes
- HTTP status codes, network and DNS errors, and how they affect Google Search Google Search Central
- How HTTP status codes affect Google's crawlers Google Crawling infrastructure
- Reduce the Googlebot crawl rate Google Crawling infrastructure
- How Google interprets the robots.txt specification Google Search Central
- HTTP response status codes MDN Web Docs
- RFC 9110: HTTP Semantics IETF