- «Caché» en SEO son cuatro cosas distintas: la del navegador, la del servidor o CDN, la de Googlebot y la antigua copia en caché de Google, que ya no existe.
- Googlebot solo soporta caché heurística con ETag y Last-Modified; no toma decisiones a partir de
max-age. - La regla práctica: HTML con
no-cachey validadores, y recursos estáticos con nombre versionado ymax-age=31536000, immutable. - La caché no posiciona por sí sola, pero afecta a la velocidad en visitas repetidas, al rastreo y a que Google vea la versión correcta de la página.
- Los errores caros son servir contenido viejo tras publicar, cachear errores 404 o 5xx y usar
no-storeen todo. - Se audita con
curl -I, DevTools y el informe de estadísticas de rastreo, en ese orden.
Cuando alguien busca «caché SEO» le pueden estar preguntando tres cosas distintas: cómo ver la copia en caché de una página en Google, cómo configurar la caché para que la web cargue rápido o qué hace Googlebot con las cabeceras de caché. Casi todo lo que se publica sobre el tema mezcla las tres y se queda en la definición o en una lista de plugins.
En este artículo las separo y me centro en lo que sí se puede decidir y comprobar: qué cabeceras enviar, qué dice Google que soporta, qué errores de caché he visto estropear un SEO bien trabajado y cómo lo tengo yo configurado en cristofercruz.net, con sus límites.
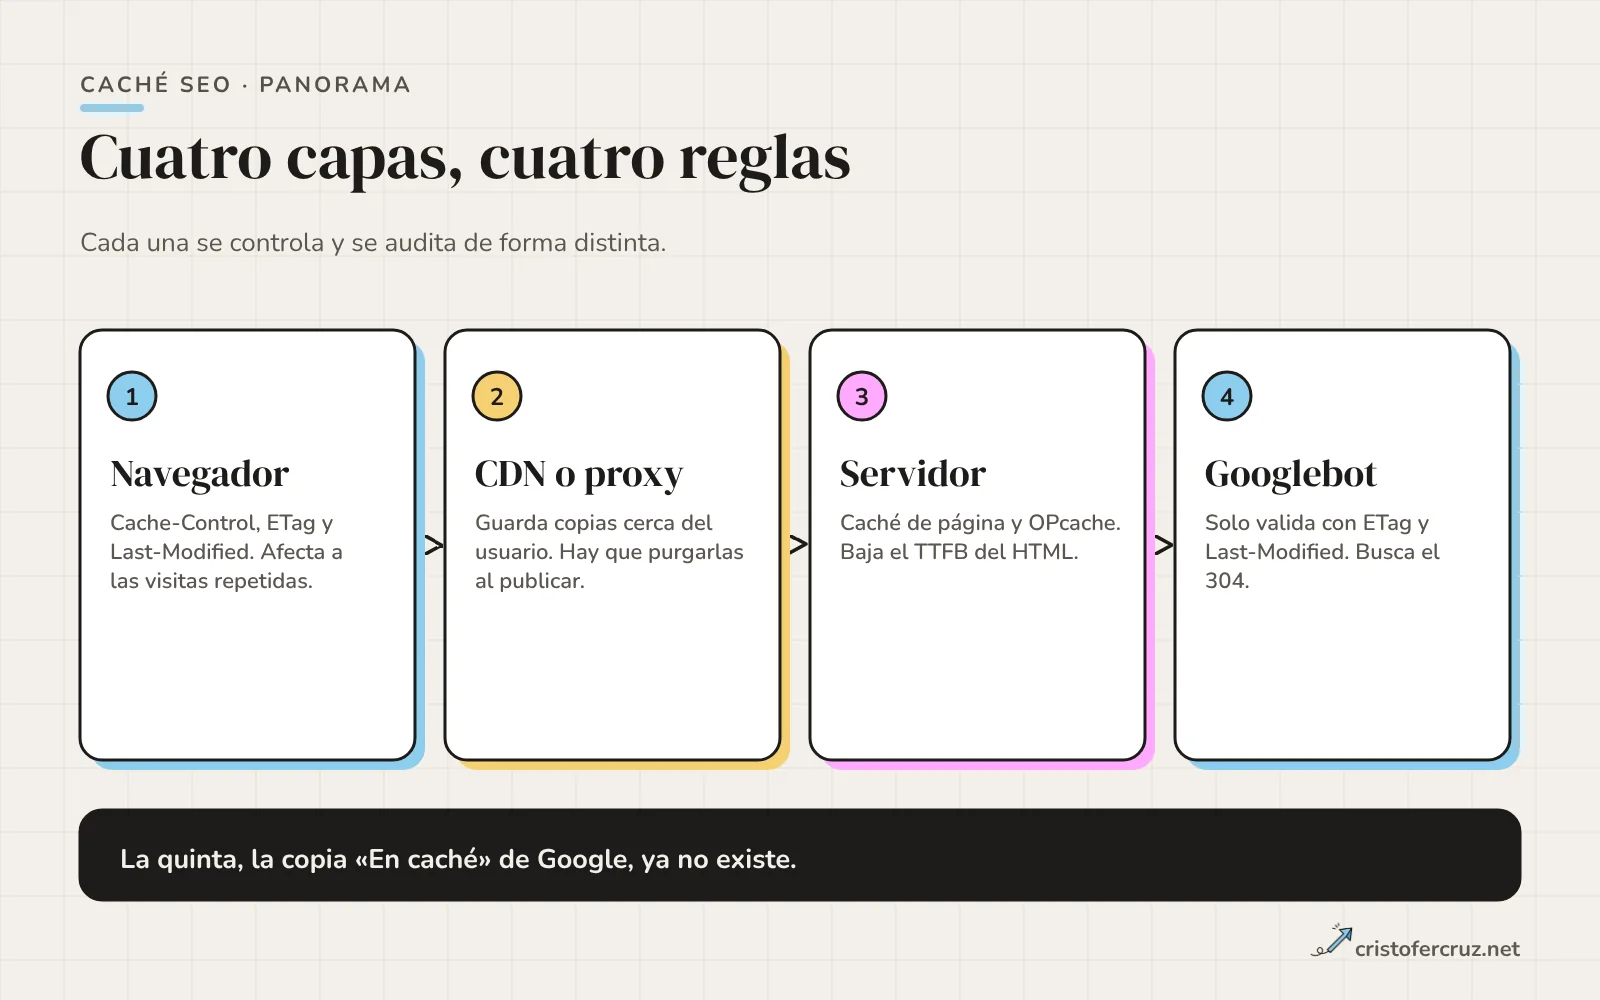
Qué es la caché en SEO y qué capas hay
La caché es una copia guardada de una respuesta para no tener que generarla o descargarla otra vez. Lo que cambia es dónde se guarda esa copia y quién decide cuándo caduca. Para SEO importan cuatro sitios.
| Capa | Quién la controla | Qué afecta |
|---|---|---|
| Navegador | Tus cabeceras Cache-Control, ETag y Last-Modified | Velocidad en visitas repetidas y recursos que se descargan de nuevo |
| Servidor y CDN | Tu configuración de servidor, plugin de caché o CDN | TTFB, carga del servidor y qué versión de la página se sirve |
| Googlebot | Google, a partir de ETag y Last-Modified | Cuántas peticiones se resuelven con un 304 en lugar de descargar de nuevo |
| Copia en caché de Google | Nadie: Google la retiró | Nada. Hoy no hay forma oficial de ver esa copia |
Lo importante es no mezclar capas al diagnosticar. Un max-age largo no cambia nada para Googlebot, y un 304 correcto no acelera la carga de un usuario que ya tiene el archivo guardado.
Cómo funciona la caché HTTP: Cache-Control, ETag y 304
La caché HTTP se apoya en dos mecanismos que conviene distinguir: la frescura, que dice durante cuánto tiempo una copia se puede reutilizar sin preguntar, y la validación, que permite preguntar al servidor si la copia sigue siendo válida sin descargarla entera.
La frescura la marca Cache-Control: max-age=N (segundos). La validación usa un identificador: el servidor responde con un ETag o un Last-Modified, y la siguiente vez el cliente lo devuelve en If-None-Match o If-Modified-Since. Si el contenido no ha cambiado, el servidor contesta 304 Not Modified sin cuerpo.
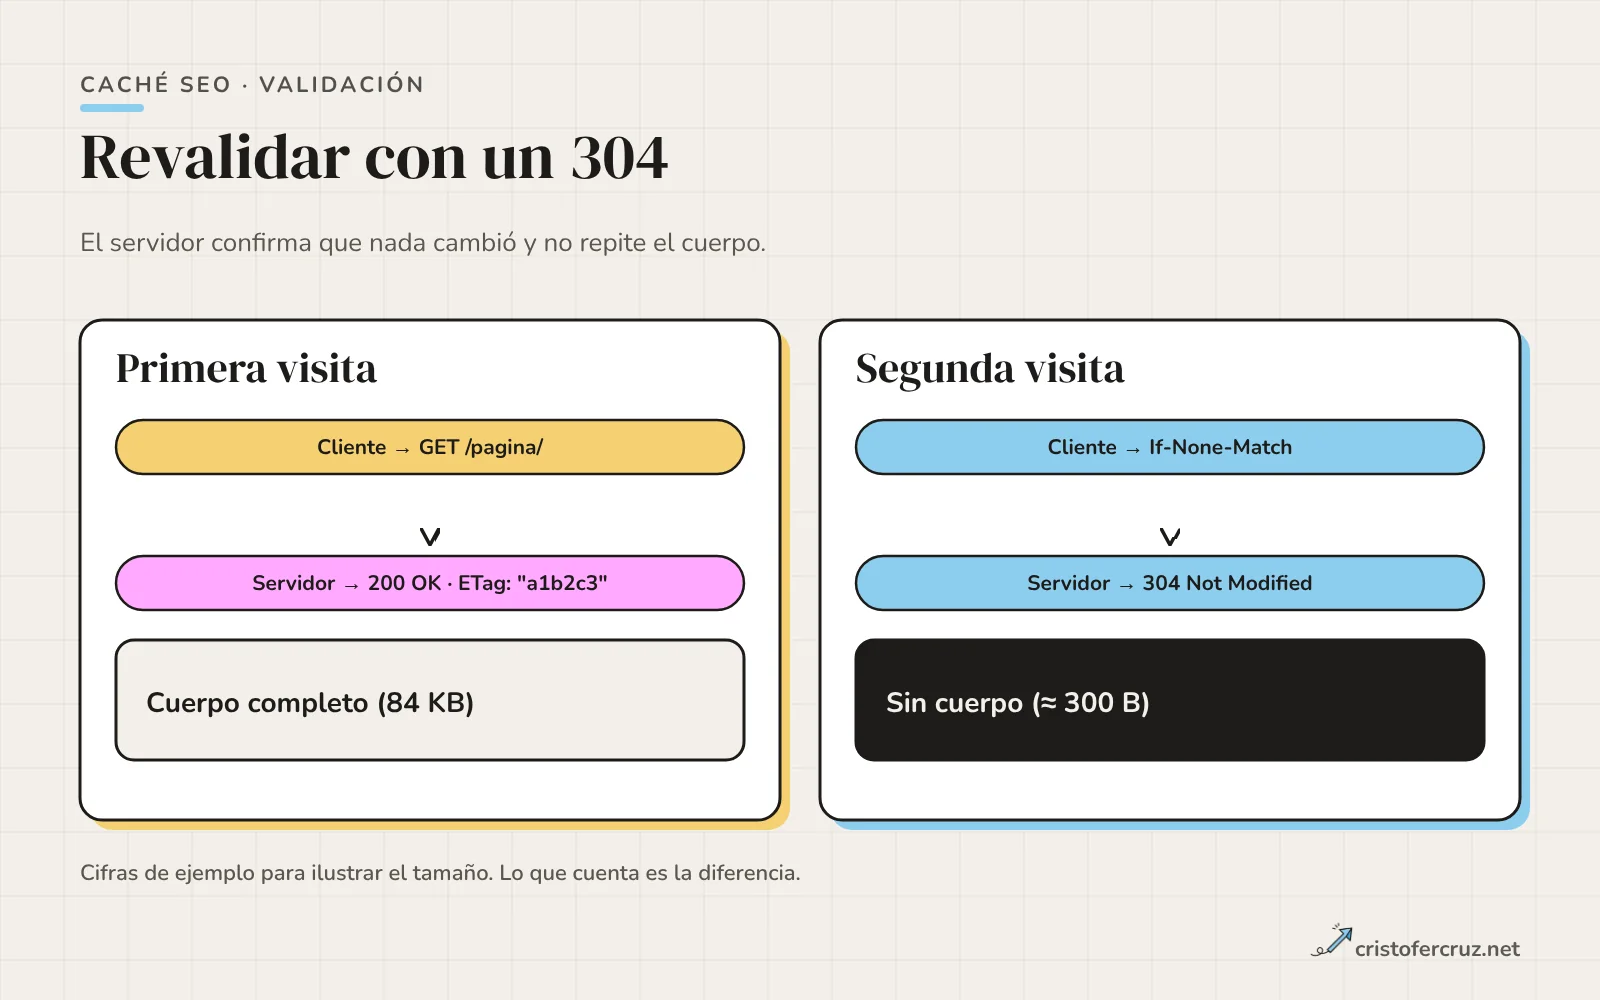
Si no envías ninguna directiva de frescura pero sí Last-Modified, los navegadores aplican caché heurística: estiman una frescura a partir de la antigüedad del archivo (el estándar sugiere en torno al 10 % del tiempo transcurrido desde esa fecha). Es un comportamiento legítimo, pero impredecible, y por eso prefiero declarar siempre la política.
Directivas de Cache-Control que uso de verdad
Hay muchas directivas; en la práctica manejo seis. Las que más se confunden son no-cache y no-store.
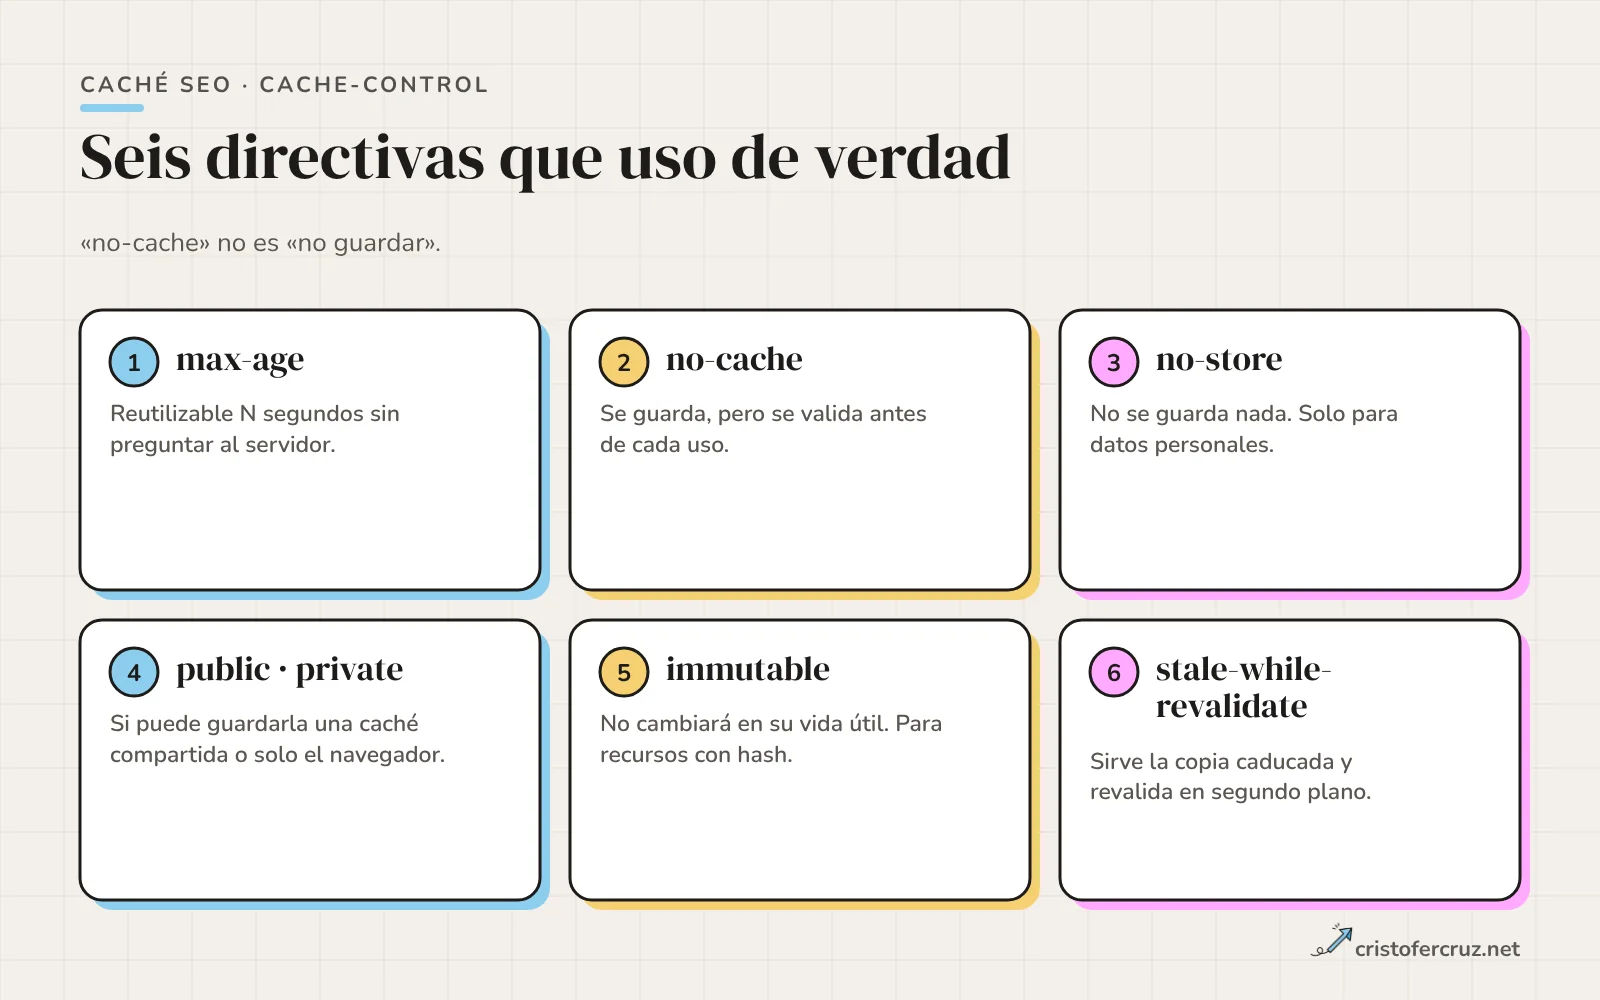
max-age=N: la copia es reutilizable N segundos sin consultar al servidor.no-cache: se puede guardar, pero hay que validar con el servidor antes de cada uso. Es lo que quiero para el HTML.no-store: no se guarda nada. Sirve para respuestas con datos personales; usarlo en toda la web desperdicia la caché y puede impedir la caché de ida y vuelta del navegador (bfcache).publicyprivate: si una caché compartida (CDN, proxy) puede guardar la respuesta o solo el navegador del usuario.immutable: indica que el archivo no cambiará durante su vida útil. No todos los navegadores lo aprovechan, pero no estorba en recursos con nombre versionado.stale-while-revalidate=N: permite servir una copia caducada mientras se revalida en segundo plano.
Si solo vas a recordar una regla: el nombre del archivo debe cambiar cuando cambia su contenido. Con esa condición puedes darle un año de caché sin riesgo. Sin ella, cada max-age largo es una apuesta contra tu propio despliegue.
Qué soporta Googlebot: solo ETag y Last-Modified
Aquí está la parte que más se repite mal. Google documenta que su infraestructura de rastreo soporta caché heurística según el estándar HTTP, y concretamente a través de ETag con If-None-Match y de Last-Modified con If-Modified-Since. Las demás directivas de caché no se soportan. Entre ambos validadores, Google recomienda ETag, porque evita los problemas de formato de fecha de Last-Modified.
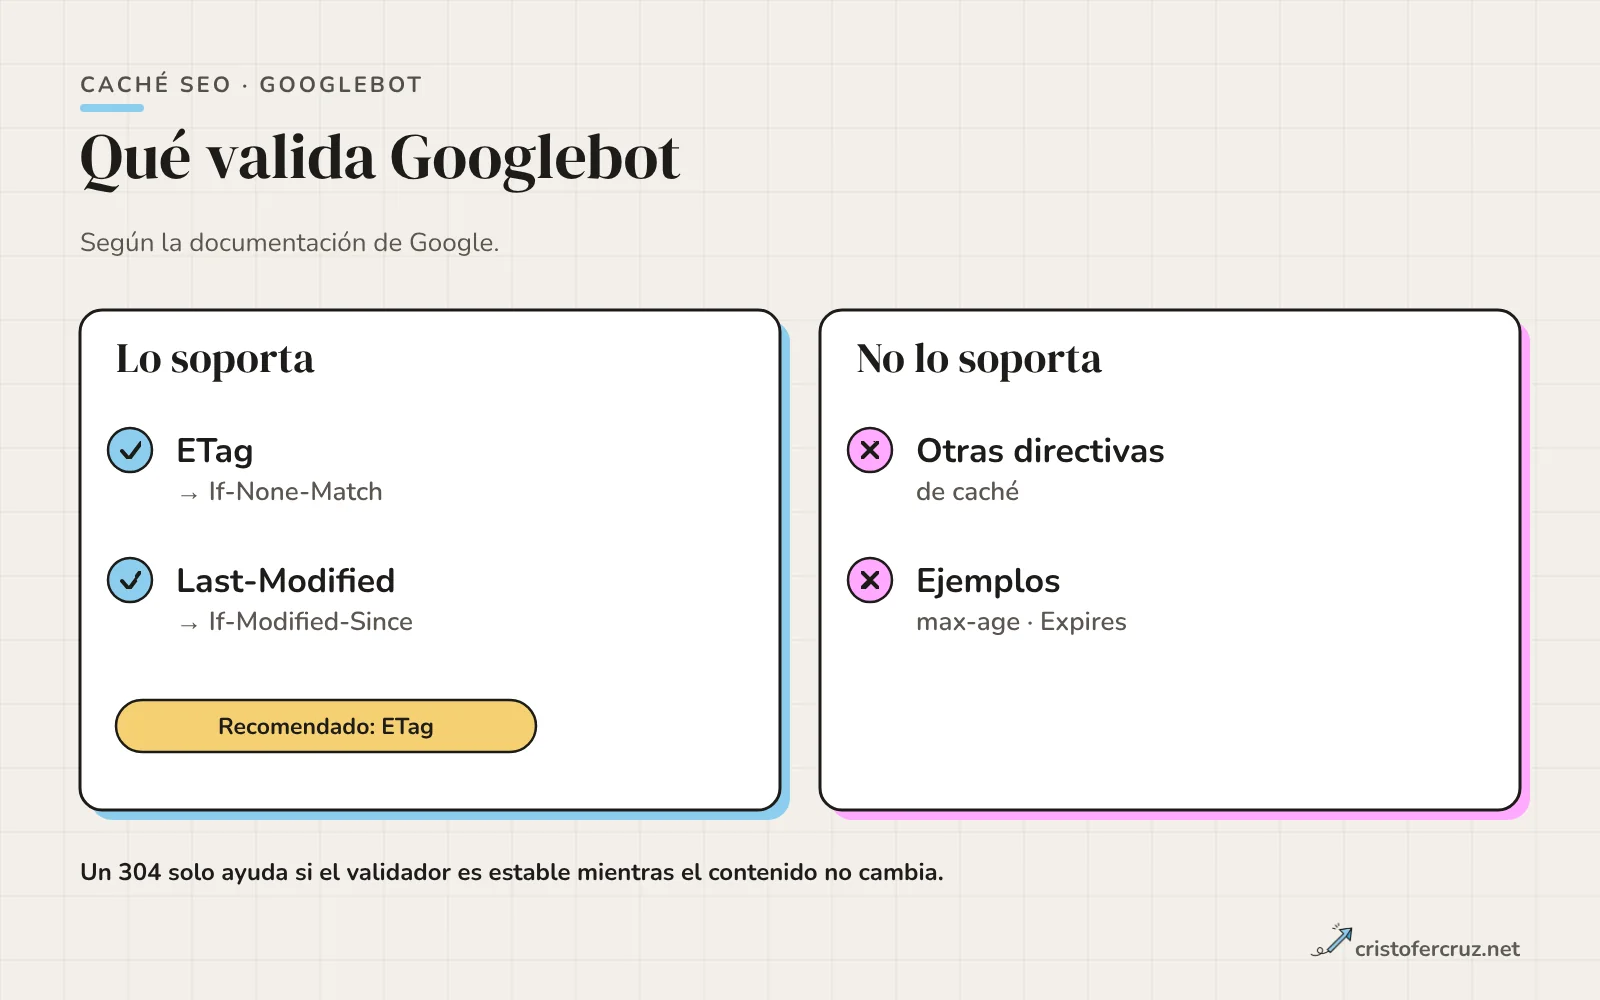
Hay otro dato que justifica prestarle atención. Google contó en 2024 que el porcentaje de descargas de Googlebot que podían cachearse bajó de aproximadamente el 0,026 % al 0,017 %: la mayoría de servidores no devuelven validadores o devuelven 200 sin necesidad. Si tu web responde con un 200 completo a cada visita de Googlebot, estás gastando ancho de banda tuyo y presupuesto de rastreo de Google en descargar lo mismo.
Lo que me interesa de esto es lo práctico:
- Un sitio pequeño no va a ver una mejora de posiciones por devolver 304. El beneficio es de eficiencia, y se nota sobre todo en sitios grandes o con servidores justos.
- El 304 solo ayuda si es honesto: si el validador cambia en cada petición (por ejemplo, un
ETagque incluye la hora de generación), nunca habrá coincidencia. - Si publicas un cambio y el servidor sigue devolviendo 304 con un validador antiguo, Google puede seguir con la versión vieja. Es el error que más me preocupa en configuraciones con caché agresiva.
Las estadísticas de rastreo de Search Console tienen un desglose por tipo de respuesta que incluye «No modificado (304)». Es la forma más directa de ver qué parte de lo que pide Googlebot se resuelve con validación.
Caché, rendimiento y Core Web Vitals
La caché no cambia el ranking por sí misma, pero sí influye en lo que mide la velocidad. Hay dos matices que suelen pasarse por alto.
El primero es que Lighthouse mide con caché vacía. Una nota de laboratorio no refleja lo que ocurre en una segunda visita, que es donde la caché de navegador marca la diferencia. Los datos de campo de CrUX sí incluyen usuarios que repiten, así que un buen versionado de recursos mejora el campo aunque no se vea en el laboratorio.
El segundo es que la caché de servidor afecta sobre todo al TTFB. Un HTML que se genera con PHP y base de datos en cada petición puede tardar cientos de milisegundos; una página servida desde caché de página, decenas. Ese tiempo se suma al LCP, como cuento en la guía de Core Web Vitals.
Lighthouse tiene una auditoría específica, Serve static assets with an efficient cache policy, que lista los recursos estáticos con una vida de caché corta. Es un buen punto de partida, con una advertencia: si el recurso no tiene nombre versionado, alargar su max-age sin más provoca el problema contrario.
Estrategia de caché por tipo de recurso
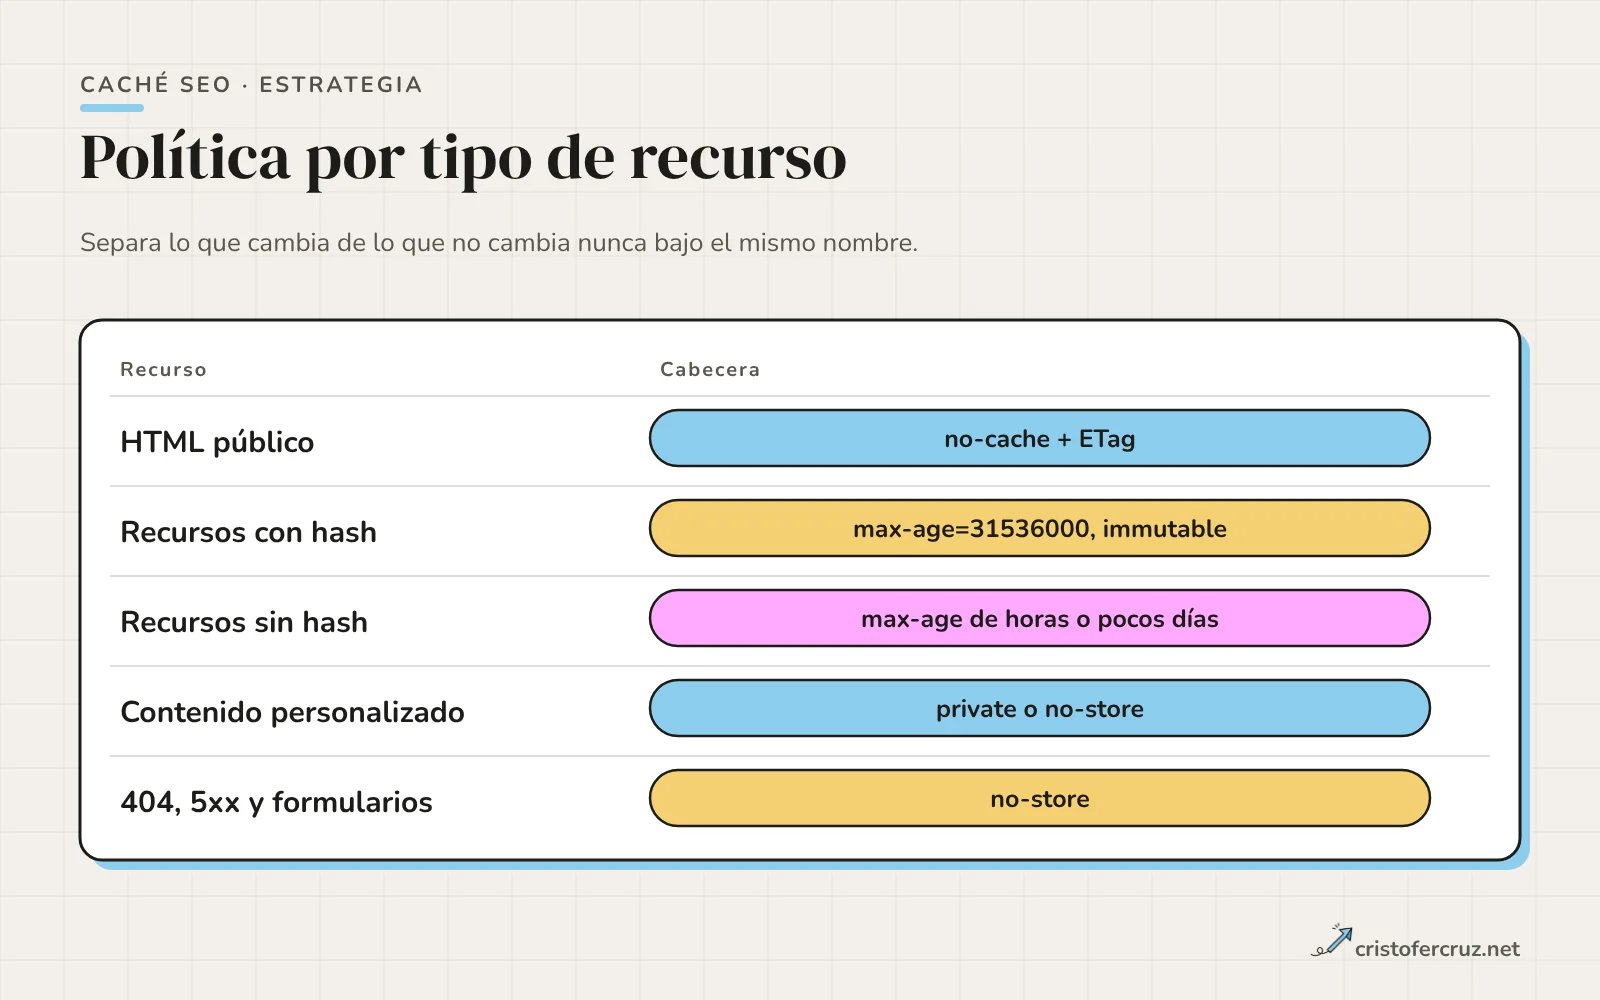
No hay una política única. Esta es la que aplico por defecto y que ajusto según el caso.
| Recurso | Política | Por qué |
|---|---|---|
| HTML público | no-cache + ETag o Last-Modified | Siempre se valida, y si no cambió, 304. Es lo único que Googlebot aprovecha |
| CSS, JS, fuentes e imágenes con hash en el nombre | public, max-age=31536000, immutable | Si cambia el contenido, cambia la URL |
| Recursos sin hash | max-age de horas o pocos días | Compromiso entre rendimiento y actualización |
| Contenido personalizado | private o no-store | Que no lo guarde una caché compartida |
| 404, 5xx y formularios | no-store | No quieres que un error puntual se quede guardado |
¿Se debe cachear el HTML?
Depende de dónde. En el navegador, yo prefiero no-cache: el HTML es lo que enlaza a todo lo demás y quiero que cada visita vea la versión actual, aprovechando el 304 cuando no cambió. En un servidor o CDN, cachear el HTML tiene mucho sentido si la página es igual para todos, porque baja el TTFB. El riesgo es que hay que invalidar la copia cada vez que publicas, y eso hay que automatizarlo.
Caché de servidor y CDN
La caché de servidor guarda la página ya generada para no ejecutar PHP y consultar la base de datos en cada visita. Un CDN hace lo mismo pero más cerca del usuario. Los dos comparten tres problemas que tienen consecuencias SEO.
El primero es qué se cachea por defecto. Cloudflare, por ejemplo, cachea por extensión de archivo y no guarda HTML ni JSON salvo que se lo pidas con una regla. Respeta las cabeceras de caché del origen si existen, y si no, aplica sus propios TTL por defecto según el código de respuesta. Conviene leer esa documentación antes de activar «cachear todo», sobre todo si hay cookies, carritos o áreas privadas.
El segundo es la invalidación. Si publicas o corriges una página y la copia de CDN sigue viva durante horas, Google puede rastrear la versión antigua y el usuario ve otra distinta de la que tú acabas de revisar. La purga debe ser parte del flujo de publicación, no una tarea manual.
El tercero es Vary. Vary: User-Agent multiplica las copias en caché, porque cada user agent distinto genera una entrada. Solo tiene sentido si sirves HTML distinto según dispositivo, y entonces es lo correcto; en cualquier otro caso, quítalo.
Errores de caché que perjudican al SEO
Estos son los que reviso primero en una auditoría. Ninguno es exótico, y varios conviven en la misma web.
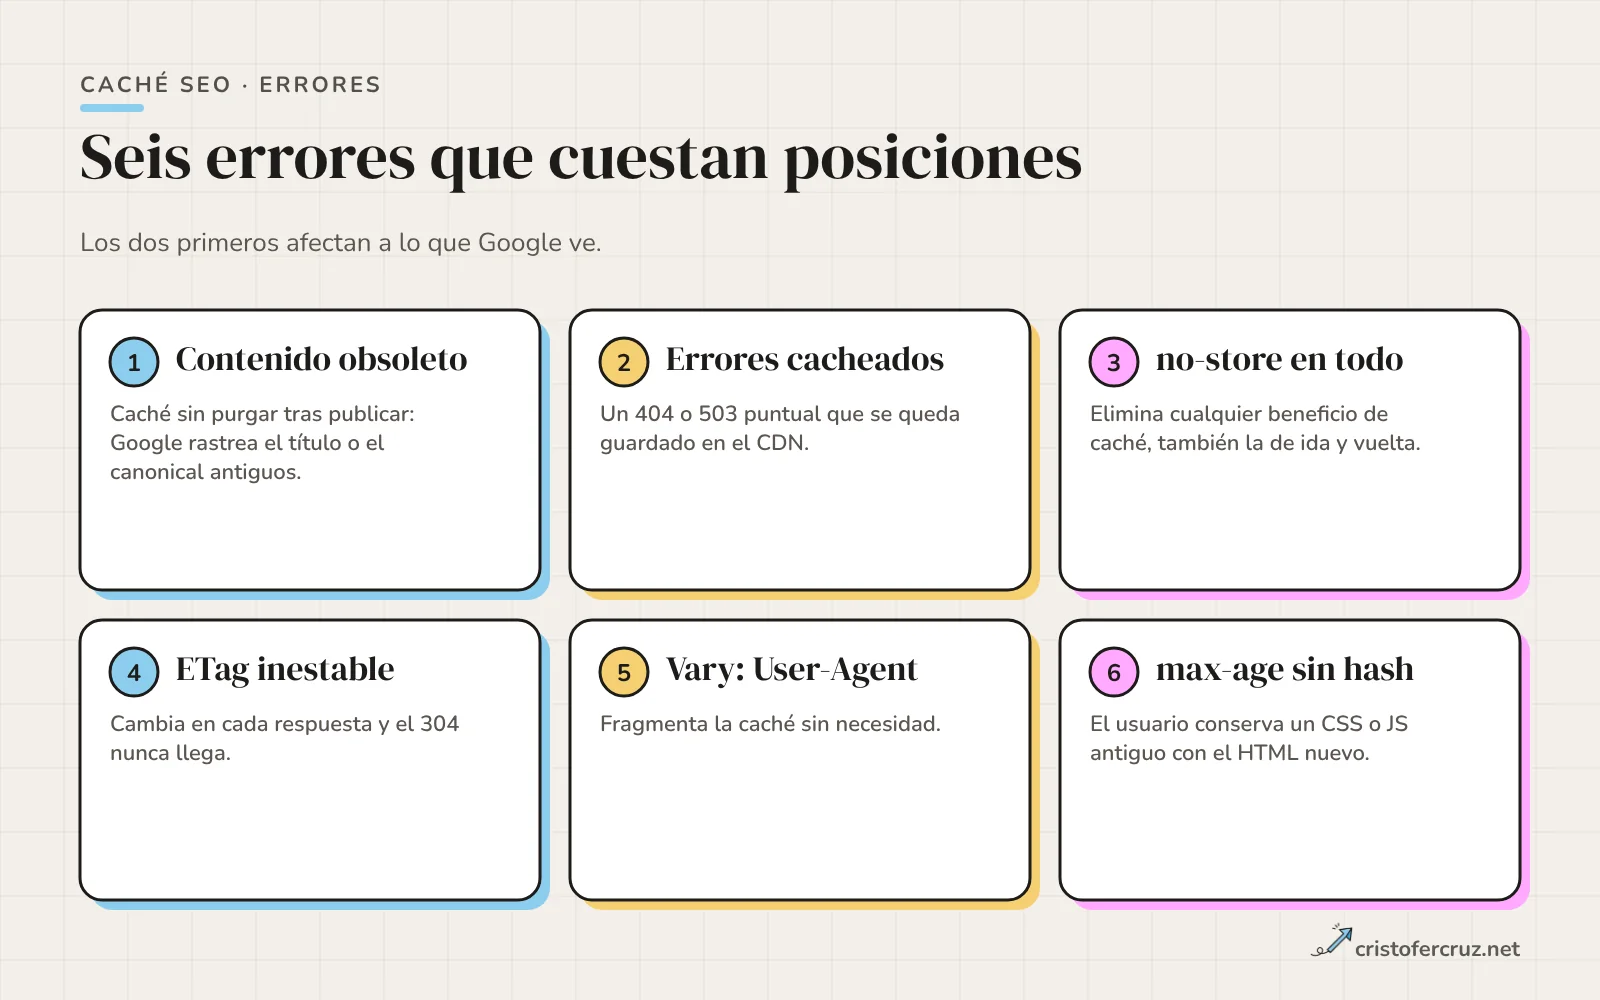
- Contenido obsoleto tras publicar. La caché de página o de CDN no se purga y Google rastrea la versión anterior, con el título, el canonical o el noindex antiguos.
- Cachear errores. Un 404 o un 503 puntual que se queda guardado en el CDN convierte un fallo de minutos en uno de horas, con URLs que Google deja de rastrear.
no-storeen todo. Se configura «por seguridad» y elimina cualquier beneficio de caché, incluida la de ida y vuelta del navegador.- ETag inestable. Si se calcula con datos que cambian en cada respuesta, el 304 no llega nunca y Googlebot descarga siempre el cuerpo completo.
- Vary: User-Agent sin necesidad. Fragmenta la caché sin ningún beneficio.
max-agelargo sin versionado. El usuario se queda con un CSS o un JS antiguo y el HTML nuevo se rompe. Con JavaScript pasa algo parecido en el renderizado de Google, que puede ignorar las cabeceras y ejecutar un script viejo; lo detallo en JavaScript SEO.
Hay un caso más que casi nadie considera: la caché del archivo robots.txt. Google puede mantenerlo en caché hasta 24 horas, así que si bloqueas o desbloqueas una sección por error, el arreglo no se aplica al instante.
Qué pasó con la «caché de Google»
Una parte de quienes buscan «caché SEO» quiere ver la copia que Google guardó de una página. Google retiró el enlace «En caché» de los resultados en 2024 y el operador cache: dejó de funcionar después, así que esa consulta ya no tiene una respuesta oficial. Lo que hago ahora, según lo que necesite comprobar:
- Cómo ve Google la página hoy: Inspección de URL en Search Console, con la prueba en vivo y la captura de la página renderizada.
- Cómo era una página en el pasado: Wayback Machine, que Google enlaza en «Acerca de este resultado» en algunos resultados.
- Si Google tiene indexada la versión nueva: la fecha de último rastreo y el canonical elegido, también en Inspección de URL.
Ninguna de estas es una copia en caché en sentido estricto, pero responden a la pregunta que había detrás: qué ve Google de mi página.
Cómo gestiono la caché en mi web
Prefiero enseñar mi propio caso que uno inventado. Esta es la configuración de cristofercruz.net, que está hecha en PHP sin CMS y se despliega por archivos.
Recursos versionados: un año e immutable
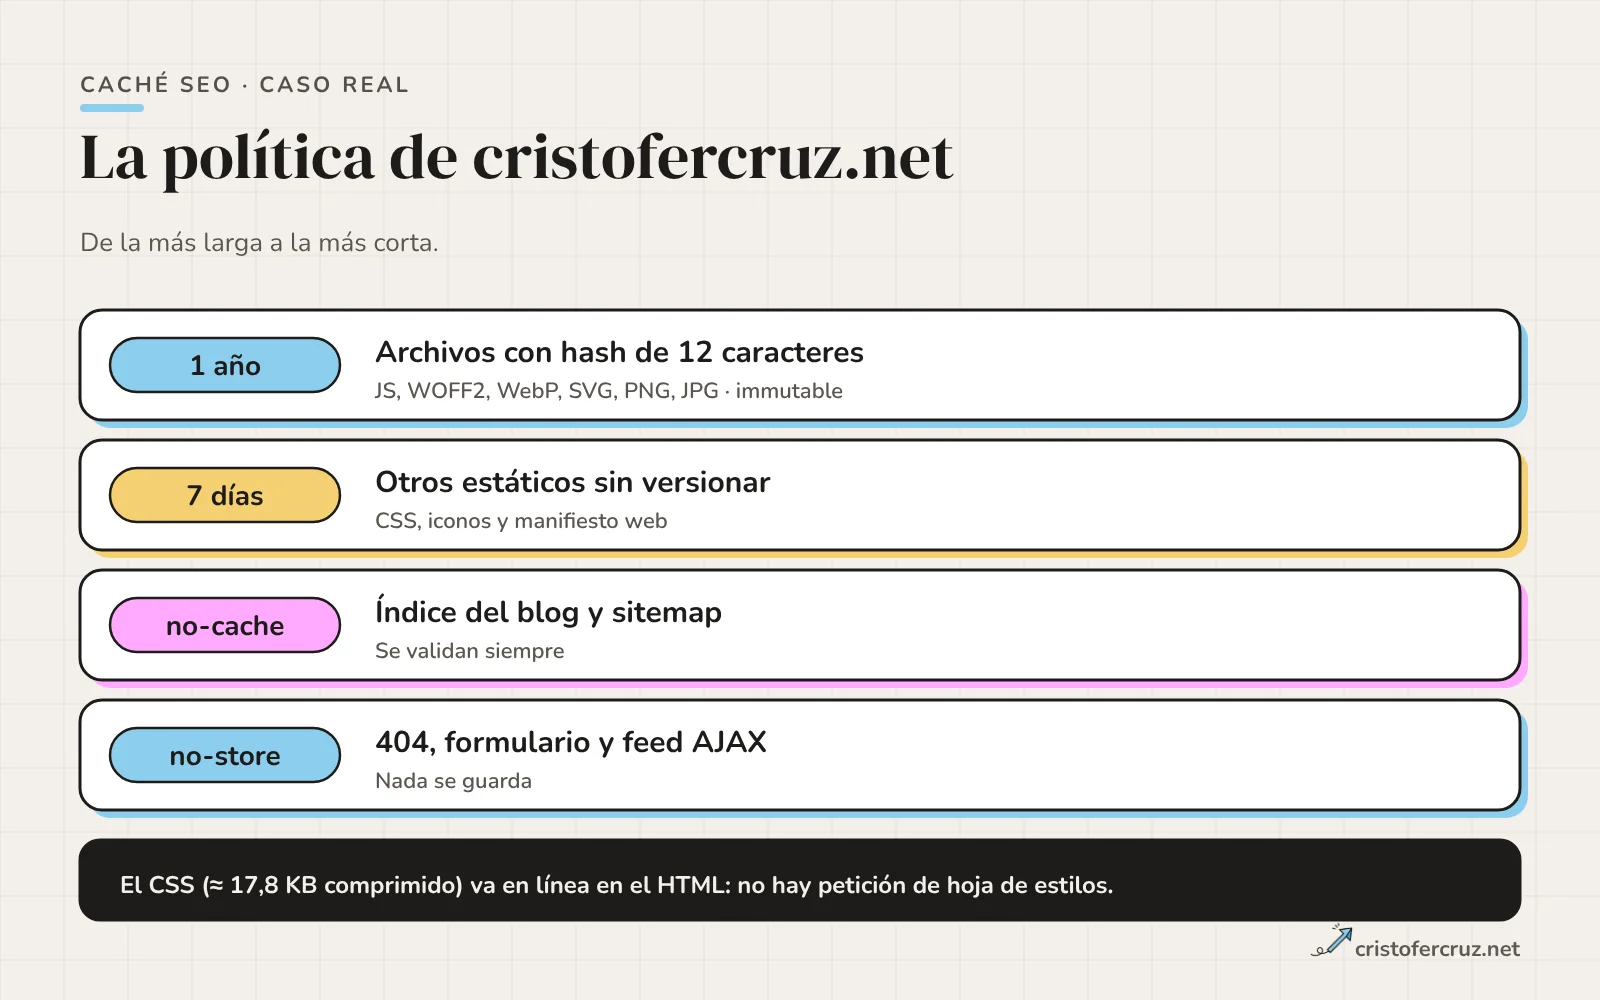
Cada vez que despliego, un script de construcción (tools/build-assets.py) copia los recursos a assets/cache/ con un hash de 12 caracteres calculado sobre su contenido, por ejemplo dm-serif-display-400.fdf61e20fd2c.woff2. Un manifiesto (assets-manifest.json) relaciona el nombre original con el versionado, y una función de PHP, asset(), escribe en el HTML siempre la URL con hash. En .htaccess, los archivos que encajan con ese patrón (JS, WOFF2, WebP, SVG, PNG y JPG) reciben:
Cache-Control: public, max-age=31536000, immutableSi cambio una imagen, cambia su hash, cambia su URL y el navegador la descarga de nuevo. Si no la toco, nadie la vuelve a pedir en un año. El resto del proceso con imágenes lo cuento en la guía de optimización de imágenes SEO.
El resto de estáticos: siete días
Para cualquier otro archivo con extensión estática (CSS, JS, fuentes, imágenes, iconos y el manifiesto web) aplico una regla más prudente: public, max-age=604800, siete días. Es el suelo para lo que no está versionado.
HTML y CSS en línea
El CSS del sitio pesa unos 97 KB minificado, unos 17,8 KB comprimido, y va incrustado en el propio HTML. Esto evita una petición bloqueante y simplifica la caché de la hoja de estilos, a costa de que ese peso viaja con cada página. Es una decisión consciente para un sitio con pocas plantillas y no la recomendaría igual para uno con muchas.
Las páginas son PHP. La compresión (mod_deflate) está activa para HTML, CSS, JS, JSON, XML y SVG.
Páginas dinámicas: no-cache y no-store
El índice del blog y el sitemap del blog envían Cache-Control: no-cache, porque listan artículos y cambian cada vez que publico. La página 404, el endpoint del formulario de contacto y el feed AJAX del blog envían no-store, porque no quiero que ninguna caché guarde un error ni una respuesta de formulario.
Lo que no hago, o no he verificado
Para ser justo con lo que dice el resto del artículo, estos son los límites de mi configuración:
- PHP no emite
ETagniLast-Modifieden las páginas dinámicas. Lo que llegue en producción depende del servidor, y es lo primero que compruebo concurl -I. - La regla de un año solo reconoce los formatos que enumeré antes; si algún día versiono CSS o iconos, tendré que ampliarla.
- No tengo cache de página en servidor: cada visita ejecuta PHP. Con el volumen de este sitio no me ha hecho falta, pero es la siguiente mejora si el TTFB se resiente.
Cómo auditar la caché paso a paso
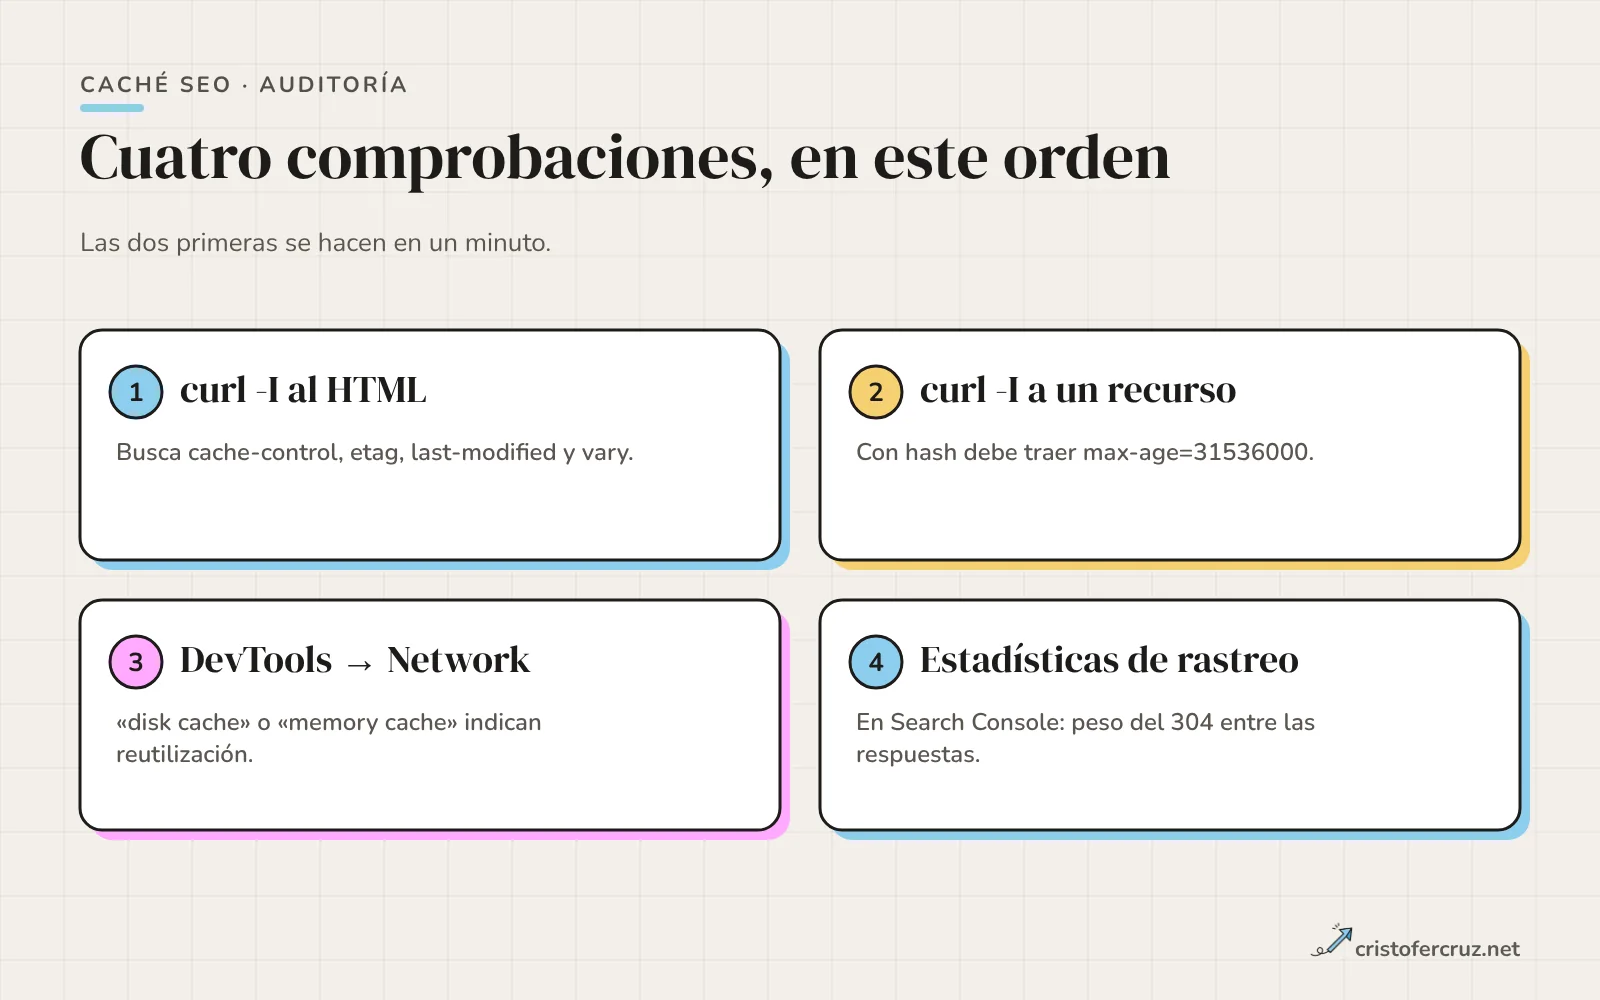
No hace falta ninguna herramienta de pago. Este es mi orden de trabajo.
1. Cabeceras con curl
Primero el HTML y luego un recurso estático:
curl -sI https://tudominio.com/pagina/
curl -sI https://tudominio.com/assets/cache/archivo.hash.webp
Busca cache-control, etag, last-modified y vary. En el HTML espero ver no-cache (o una política de CDN explícita) y un validador. En el recurso con hash espero max-age=31536000.
2. Comprobar que el 304 funciona
Copia el valor de etag y repite la petición con él:
curl -sI -H 'If-None-Match: "valor-del-etag"' https://tudominio.com/pagina/Debe devolver 304 Not Modified. Si devuelve 200, el servidor no está validando y Googlebot recibirá siempre el cuerpo completo.
3. DevTools
En la pestaña Network, recarga normal y observa la columna de tamaño: «disk cache» o «memory cache» indican que el navegador reutilizó el archivo. Si ves los mismos recursos descargándose en cada recarga, la política es demasiado corta o falta el versionado.
4. Estadísticas de rastreo
En Search Console, dentro de Ajustes, el informe de estadísticas de rastreo muestra las peticiones por tipo de respuesta. Si el 304 es una fracción minúscula en un sitio que cambia poco, tienes margen para mejorar la validación. Para verlo URL a URL, el análisis de logs del servidor te dice qué códigos recibe Googlebot de verdad.
Por dónde empezar
Si tuviera que ordenar el trabajo en una web que no sabe qué tiene, haría esto:
- Pasar
curl -Ia una página, una imagen, un CSS y un JS, y apuntar qué cabeceras salen. - Versionar los recursos estáticos con hash en el nombre, antes de tocar ningún
max-age. - Subir el
max-agede los recursos versionados a un año conimmutable. - Poner el HTML en
no-cachey asegurarse de que devuelveETagoLast-Modifiedy un 304 real. - Si hay CDN o caché de página, automatizar la purga en la publicación y excluir 404, 5xx y áreas privadas.
- Volver a mirar el informe de estadísticas de rastreo y las auditorías de Lighthouse pasadas dos semanas.
Si quieres que lo revise en tu web con datos reales, forma parte de lo que reviso en una auditoría SEO.
Preguntas frecuentes
¿Qué es la caché en SEO?
Es el conjunto de copias guardadas de tus páginas y recursos en el navegador, en el servidor o CDN y en el rastreo de Googlebot. Para SEO importa porque afecta a la velocidad de carga, a la eficiencia del rastreo y a qué versión de la página ve Google.
¿La caché influye en el posicionamiento?
No como señal directa. Influye de forma indirecta: una buena caché reduce el TTFB y acelera las visitas repetidas, y una mala puede hacer que Google vea una versión antigua de la página. Google no ha publicado un peso concreto para esto.
¿Googlebot respeta Cache-Control?
Según la documentación de Google, su rastreador soporta caché heurística mediante ETag con If-None-Match y Last-Modified con If-Modified-Since, y no soporta otras directivas de caché. Por eso los validadores importan más que max-age para el rastreo.
¿Cómo veo la caché de Google ahora que el operador cache: ya no existe?
No hay una copia oficial. Para ver cómo renderiza Google tu página usa la prueba en vivo de Inspección de URL en Search Console, y para ver versiones antiguas, Wayback Machine.
¿Es mejor ETag o Last-Modified?
Google recomienda ETag, porque evita problemas con el formato de fecha de Last-Modified. Lo importante es que el valor sea estable mientras el contenido no cambie, y que cambie cuando cambie.
¿Cuánto debe durar el max-age?
Un año (31536000) para recursos con hash en el nombre, porque su URL cambia al cambiar el contenido. Para recursos sin versionar, horas o pocos días. Para el HTML, no-cache con validadores.
¿Puede la caché provocar problemas de indexación?
Sí, de dos maneras: sirviendo a Googlebot una versión antigua tras publicar, o guardando un error 404 o 5xx que debería ser temporal. Se evita purgando la caché al publicar y excluyendo los errores de la caché compartida.
Referencias y fuentes
Documentación consultada para este artículo.
- Crawling December: HTTP caching Google Search Central
- Overview of Google crawlers and fetchers Google Search Central
- Google clarifies how Google’s crawlers handle cache control headers Search Engine Land
- Caché HTTP MDN Web Docs
- Prevenir peticiones de red innecesarias con la caché HTTP web.dev · Google
- Serve static assets with an efficient cache policy Chrome for Developers · Lighthouse
- Default cache behavior Cloudflare Docs
- Cómo interpreta Google las especificaciones de robots.txt Google Search Central
- Caché en el SEO Sánchez Donate