- Un CDN no posiciona por sí mismo: acorta el camino de lo que cachea, descarga al servidor y aguanta picos. Para el SEO cambia el TTFB, la disponibilidad y quién decide qué recibe Googlebot.
- La ubicación del servidor es una señal entre varias y, con CDN, «no es definitiva». Para el SEO internacional mandan el dominio, las URLs y hreflang.
- El riesgo más caro es el bloqueo: una regla de bots o un rate limit puede devolver 403, 429 o 503 a Googlebot sin que nadie lo vea en el navegador.
- Un CDN que cachea sin criterio guarda 404, 5xx y cookies: en mi laboratorio siguió sirviendo un 404 y un 503 cuando el origen ya daba 200.
- Las imágenes en
cdn.tudominio.comson otro host, con su propio robots.txt y su propia propiedad en Search Console. - Se audita con
curl -Idos veces, comparando borde y origen, y con la inspección de URL en vivo.
La mayoría de guías sobre «CDN y SEO» concluyen lo mismo: más velocidad, más posiciones. Casi ninguna explica los tres problemas que aparecen cuando el CDN está mal puesto: Googlebot bloqueado por una capa de seguridad, errores guardados en caché y URLs de imágenes repartidas por hosts que nadie revisa.
Separo aquí lo que un CDN hace de verdad, lo que Google documenta sobre IP, hosting y rastreo, y lo que reproduje en un laboratorio local con nginx y Apache. Las cabeceras de caché están en el artículo sobre caché SEO; aquí solo lo que cambia al poner un CDN delante.
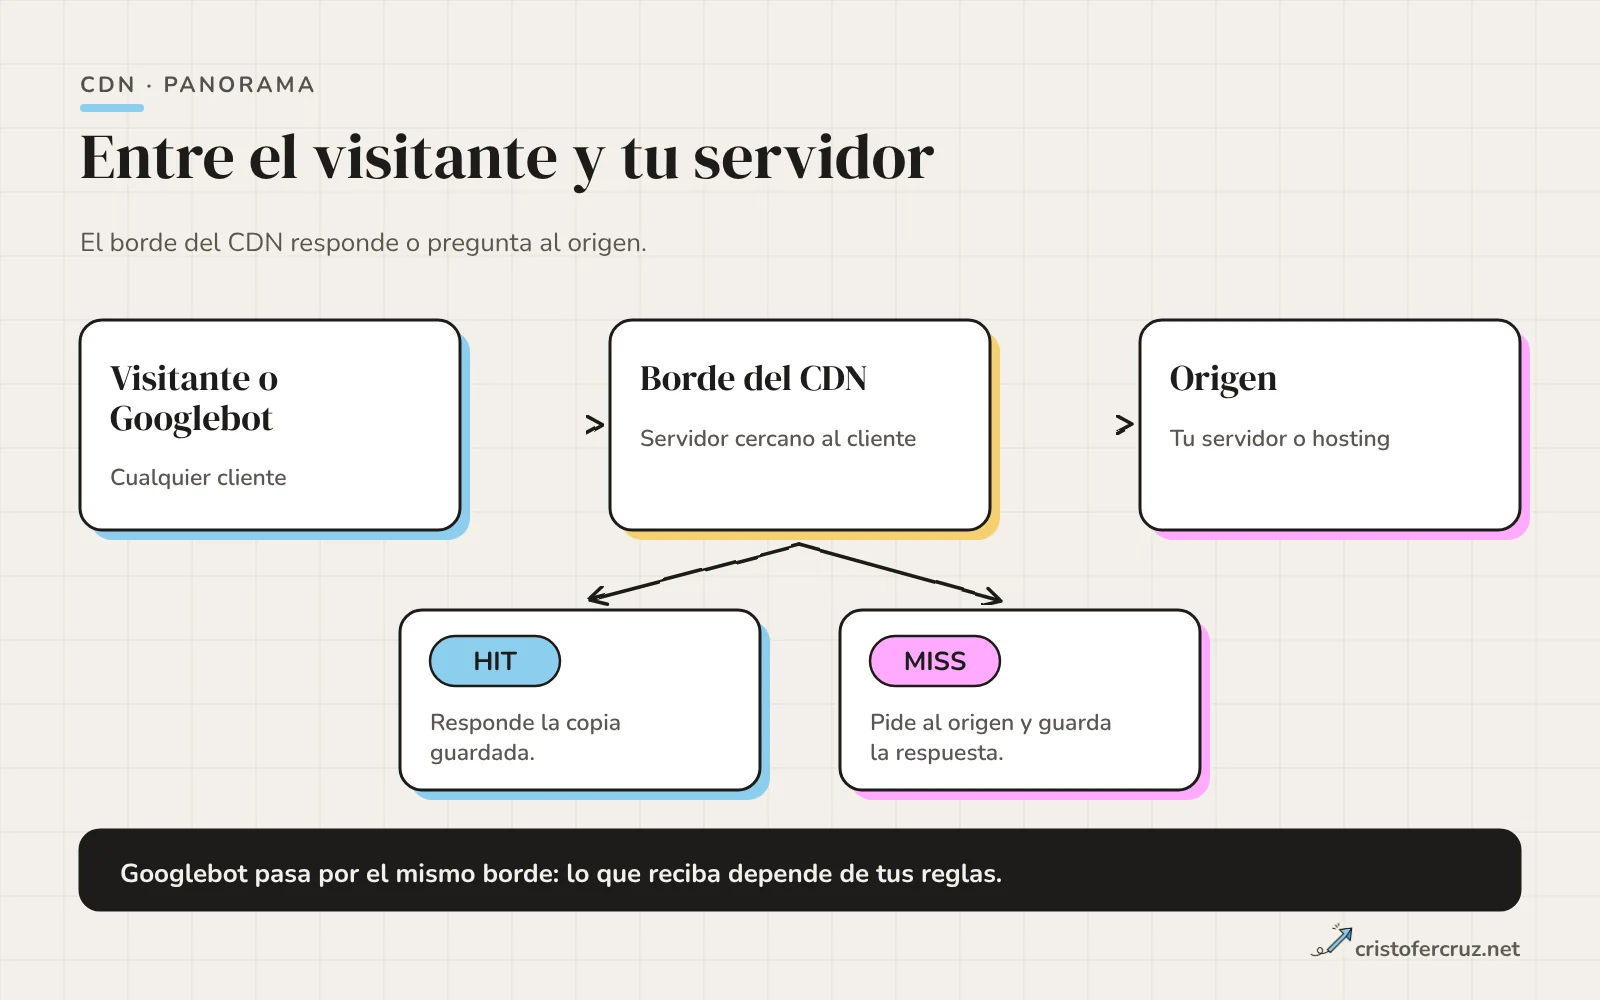
Qué hace un CDN y qué no hace por tu SEO
MDN lo define como un grupo de servidores repartidos por muchas ubicaciones que guardan copias de los datos para responder desde el más cercano al usuario. En la práctica hay tres cosas bajo el mismo nombre: la caché de respuestas, el proxy que recibe todas las peticiones (y por eso puede filtrarlas) y, a menudo, un paquete de seguridad con WAF, límites de tasa y detección de bots.
| Función del CDN | Qué cambia para el SEO | Qué no cambia |
|---|---|---|
| Caché en el borde | Menos TTFB en lo cacheado; menos carga en el origen | La URL, el contenido y el canonical siguen siendo los tuyos |
| Proxy delante del origen | El CDN decide qué respuesta recibe Googlebot y puede devolver sus propios errores | Google no distingue «CDN» de «servidor»: ve una respuesta HTTP |
| WAF y bots | Puede filtrar rastreadores legítimos si las reglas son estrictas | Googlebot no tiene un trato especial salvo el que tú configures |
| Optimización de imágenes | Cambia formatos y URLs | Las imágenes se siguen indexando por su URL |
No arregla un HTML lento que no se cachea, no mejora el CLS ni el INP y no da ninguna señal de ranking por sí mismo: es infraestructura, y el SEO se beneficia de rebote.
TTFB, Core Web Vitals y disponibilidad
La mejora medible está en el TTFB de lo que el borde responde sin viajar hasta el origen. web.dev lo mide desde que empieza la navegación hasta que llega el primer byte, y da una guía aproximada: bueno hasta 0,8 segundos, malo por encima de 1,8. También aclara que el TTFB no es un Core Web Vital: importa porque alimenta el LCP, que sí lo es. Cómo encaja en el LCP y el resto de métricas lo explico en su artículo.
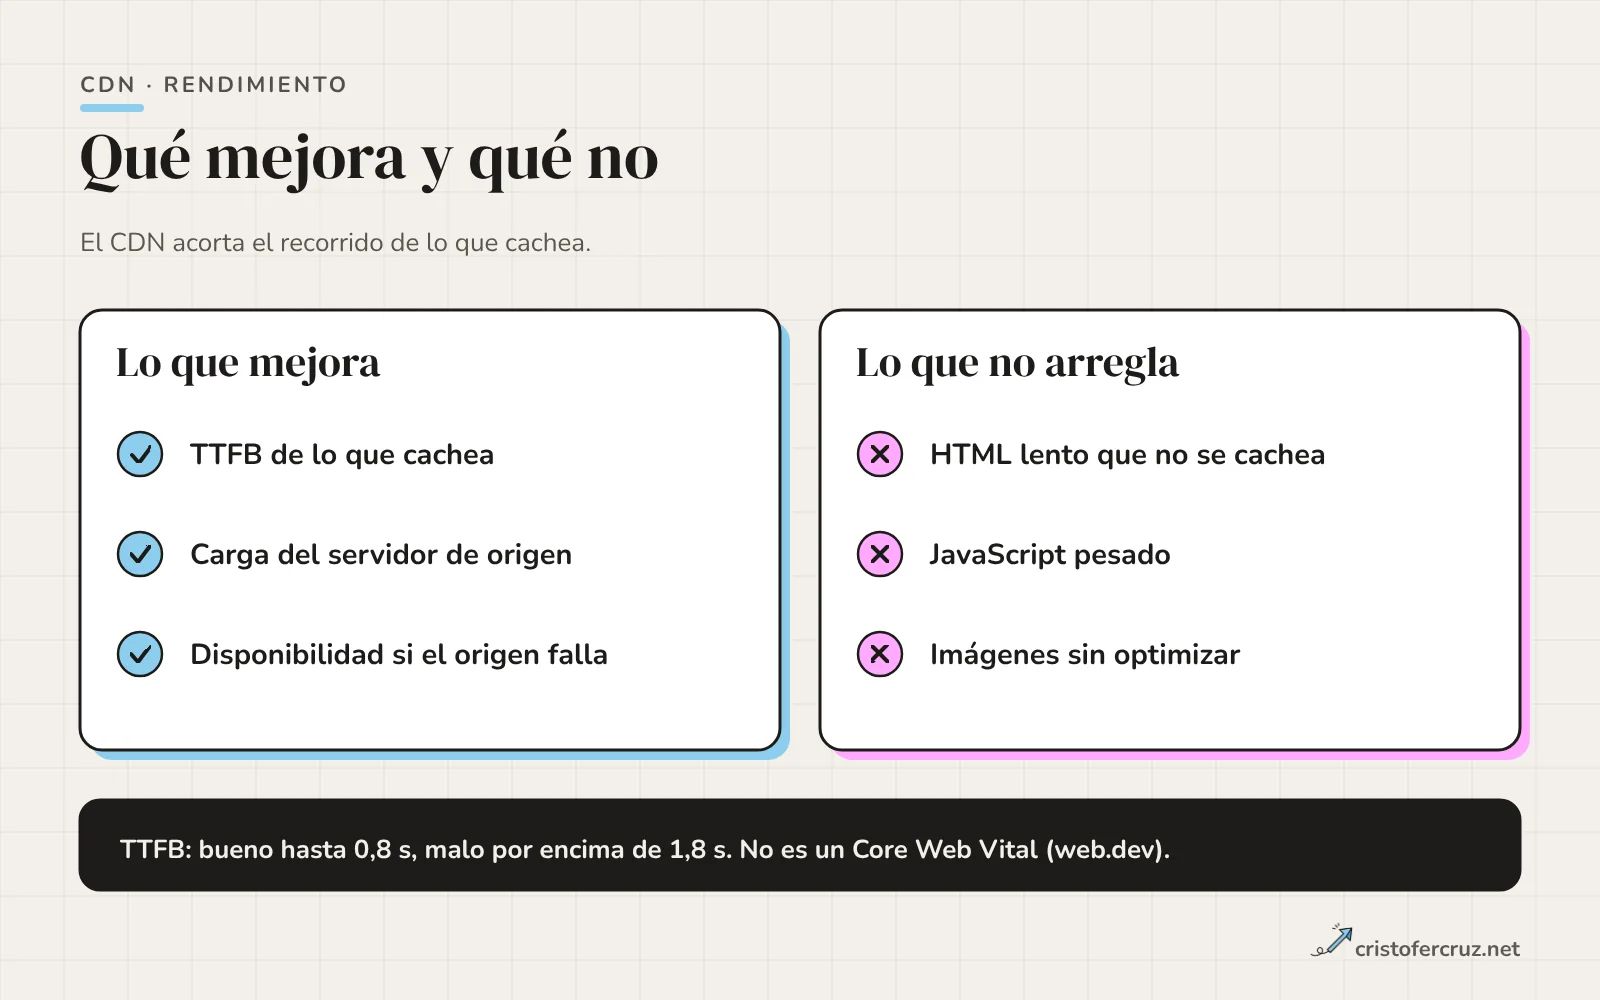
Un matiz que se olvida: si el HTML no se cachea (Cloudflare no cachea HTML ni JSON por defecto), el borde solo reenvía la petición y el TTFB depende de tu origen, con un salto más. El CDN ayuda al HTML cuando lo cacheas con una regla explícita, y ahí aparecen la purga y las cookies.
La segunda ventaja es la disponibilidad. En el laboratorio configuré el borde con proxy_cache_use_stale para que sirviera la copia caducada si el origen devolvía un 5xx. Con un TTL de 3 segundos para forzar la caducidad y el origen caído, la página que ya estaba en caché respondió 200 con estado STALE y la que nunca se había pedido recibió el 503. Es lo que MDN describe para stale-if-error: reutilizar una respuesta caducada cuando el servidor genera un error. Cloudflare documenta que su soporte es limitado y solo cubre errores 5xx; mira el de tu proveedor. Para el lado del origen, el artículo sobre errores 500 explica qué hace Google cuando los 5xx llegan a su rastreador.
IP, hosting y geolocalización: qué dice Google
La pregunta típica es si un CDN cambia el «país» de tu web a ojos de Google. La documentación sobre sitios multirregionales dice que la ubicación del servidor suele estar cerca de los usuarios y que puede ser una señal sobre la audiencia a la que te diriges, una entre varias. Sobre los CDN es explícita: algunos sitios usan redes de distribución y pueden estar alojados en otro lugar, de modo que no es una señal definitiva.
Lo que Google recomienda es otra cosa. Los dominios de país (ccTLD) dan una señal fuerte de audiencia; la geolocalización «no es una ciencia exacta»; ignora etiquetas como geo.position o distribution; y, sobre adaptar el contenido por IP, avisa de que no lo hagas porque ese análisis es difícil y poco fiable.
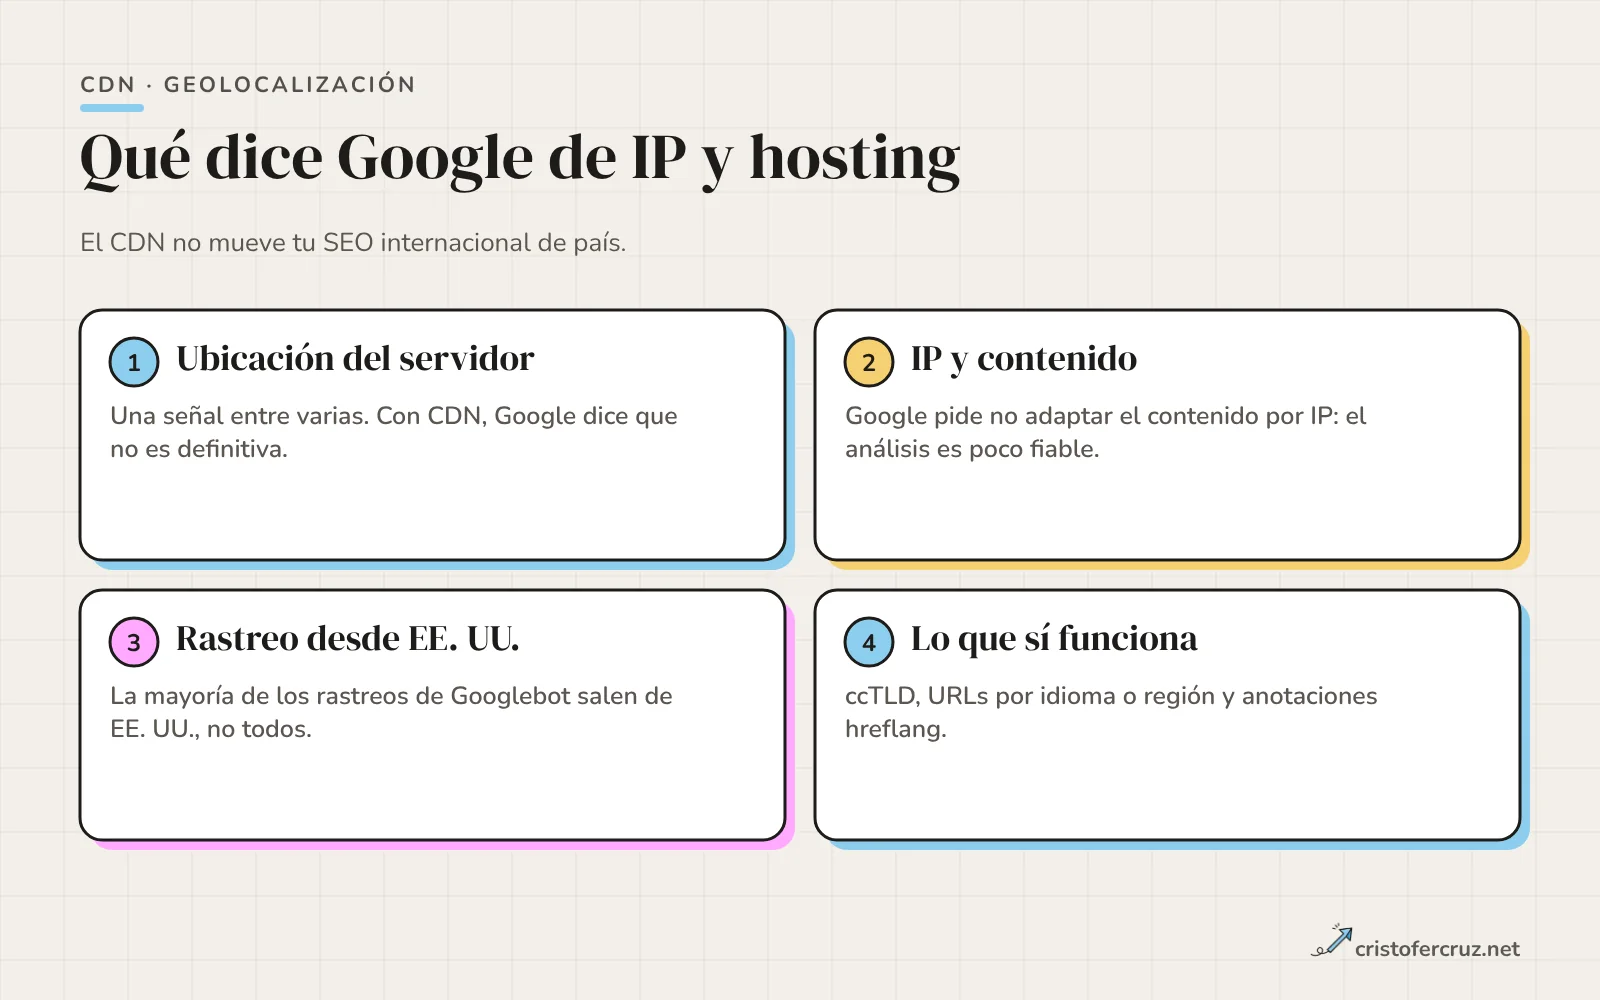
Hay una consecuencia práctica para quien tiene CDN con geo-reglas. Google indica que la mayoría de sus rastreos, aunque no todos, salen de IPs de Estados Unidos y que no varía la ubicación para detectar variantes del sitio. Su guía de páginas adaptadas por localización añade que el rastreador no envía Accept-Language y que, si bloqueas a ciertos países, debes tratar a Googlebot como a cualquier visitante del país desde el que parece llegar. Si una regla del CDN redirige o bloquea según la IP, Googlebot puede ver una sola variante o ninguna. La salida documentada: URLs separadas por idioma o región, anotadas con hreflang, no redirecciones por IP.
Un CDN no mueve tu SEO internacional; lo que puede estropearlo son las reglas que le pongas encima.
Googlebot, WAF y protección contra bots
Aquí es donde un problema puede pasar desapercibido más tiempo, porque el sitio se ve perfecto en el navegador. Una regla de «bots» o un límite de peticiones puede devolver a Googlebot un 403, un 429 o un reto (CAPTCHA, comprobación de JavaScript). Si el código es un 403, un 429 o un 503, Google lo documenta como lo que es; con un reto, no he encontrado documentación sobre cómo lo trata.
Qué consecuencias documenta Google
Según la página sobre Googlebot, bloquearlo afecta a Search, Discover y todas sus funciones. En la guía para reducir el ritmo de rastreo, Google indica que 500, 503 o 429 bajan el ritmo en todo el host y que no conviene mantenerlos más de uno o dos días: si Googlebot los ve en la misma URL durante varios días, esa URL puede salir del índice. La documentación de robots.txt añade que no uses 401 ni 403 para limitar el rastreo. El tratamiento de cada código está en el artículo sobre códigos de respuesta.
Verificar a Googlebot con los rangos oficiales
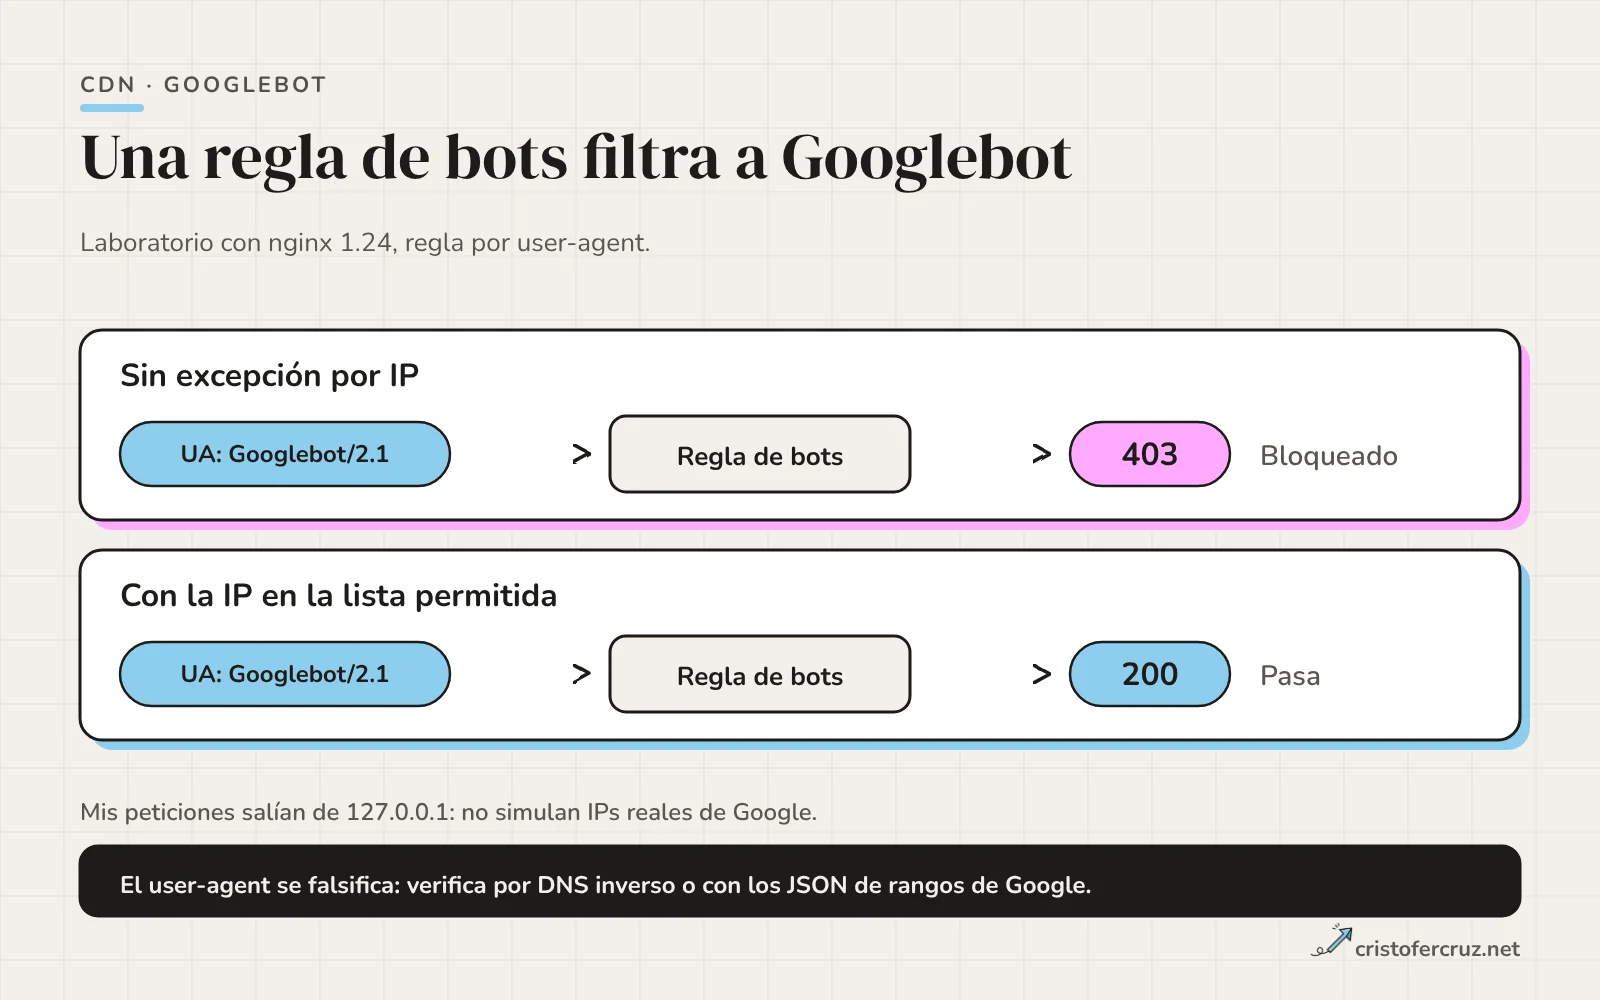
El user-agent se falsifica, así que ninguna regla seria debería basarse solo en él. Google documenta dos métodos: DNS inverso de la IP, comprobar que el dominio es googlebot.com, google.com o googleusercontent.com y repetir el DNS directo; o comparar la IP con sus ficheros JSON de rangos. Los de rastreadores habituales, donde está Googlebot, están en https://developers.google.com/static/crawling/ipranges/common-crawlers.json. La página no indica cada cuánto se actualizan, así que si los copias a una lista blanca del WAF, automatiza la descarga. Google anunció en marzo de 2026 una nueva ubicación para esos ficheros; no pude leer el cuerpo del anuncio, así que usa las URLs de la página de verificación vigente. El método paso a paso está en el artículo sobre logs.
Lo que probé: una regla por user-agent
Monté un nginx 1.24 con una regla que devuelve 403 a los user-agents que contienen «bot», «curl» o «python», salvo si la IP está en una lista permitida. Mis peticiones salían todas de 127.0.0.1, así que no puedo simular IPs reales de Google; lo que sí muestra es el efecto de la regla:
| Petición | Regla sin excepción por IP | Regla con la IP en lista permitida |
|---|---|---|
user-agent Googlebot/2.1 | 403 | 200 |
user-agent curl | 403 | 200 |
| user-agent de Chrome | 200 | no probado |
Cloudflare, que es el que mejor documenta estos puntos, indica que los bots verificados quedaron históricamente fuera de las configuraciones de bots por defecto en todos los planes. Su página de Bot Fight Mode, en cambio, avisa de que no se puede saltar ni con reglas WAF personalizadas ni con Page Rules, y no menciona a Googlebot ni a los bots verificados, así que no sé cómo lo trata y no lo afirmo. Si la usas en un sitio que vive de Google, es de lo primero que revisaría; con otros proveedores, mismo criterio, y confirma con una inspección de URL en vivo.
Caché de HTML frente a estáticos en el borde
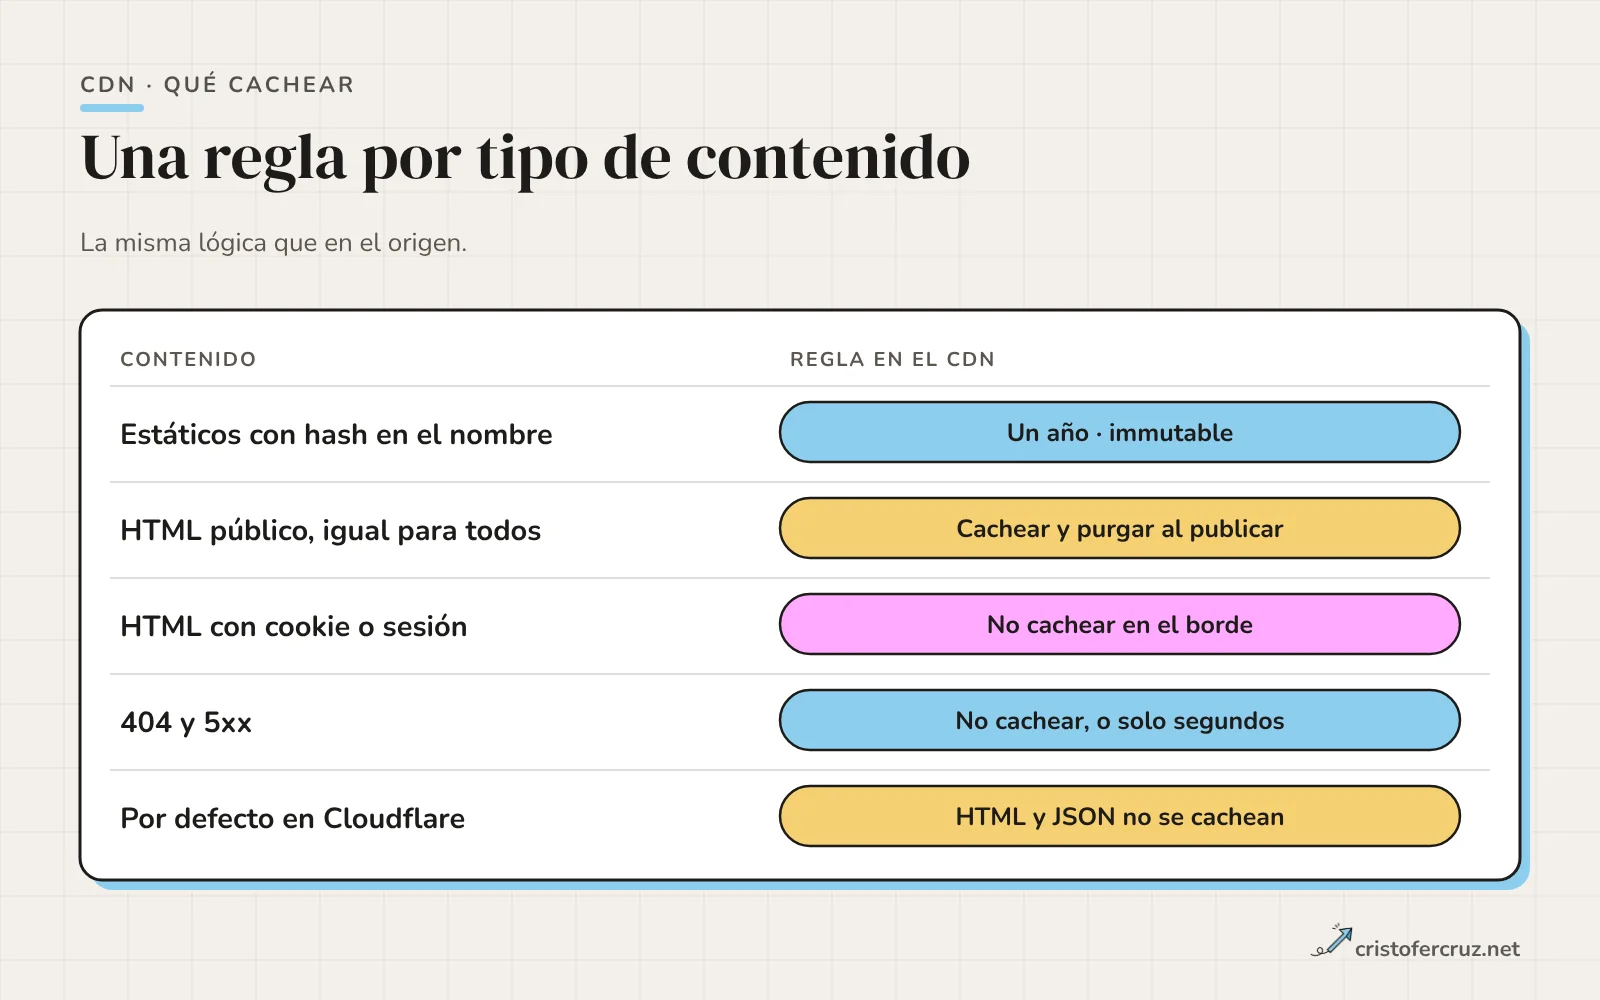
Lo que un CDN cachea por defecto depende del proveedor. Cloudflare lo documenta con precisión: cachea según la extensión del archivo y no según el tipo MIME, no cachea HTML ni JSON por defecto, no guarda respuestas con Set-Cookie, y respeta Cache-Control del origen: no cachea private, no-store, no-cache ni max-age=0, y sí public con un max-age mayor de cero. Sin cabecera de caché, aplica TTL por código de estado: 120 minutos para 200, 206 y 301; 20 para 302 y 303; 3 para 404 y 410; el resto no se cachea.
Mi criterio:
- Los estáticos con hash en el nombre se cachean un año: su URL cambia al cambiar el contenido.
- El HTML público idéntico para todos se puede cachear en el borde si la purga está automatizada y excluyes 404 y 5xx. Si no, déjalo en validación (
no-cachecon ETag) y cachea solo los estáticos. - El HTML con cookie, sesión o precios personalizados no se cachea en una caché compartida. MDN lo dice así: una caché compartida guarda una respuesta y la reutiliza con varios usuarios, y por eso conviene evitar contenido personalizado en ella.
Purga e invalidación al publicar
Cachear HTML sin purgar es la forma más rápida de que Google rastree un título, un canonical o un noindex antiguos. Cloudflare ofrece purga por URL (que recomienda como método principal), por etiqueta, por hostname, por prefijo y completa, y limita su frecuencia según el plan: las operaciones de hostname, etiqueta, prefijo y purga total son 5 por minuto en Free y 5 por segundo en Pro, y las purgas por URL, 800 por segundo en Free. Una respuesta 200 a la petición de purga no confirma que se haya expulsado nada: la propia documentación sugiere pedir el recurso después y comprobar que CF-Cache-Status ya no es HIT.
En el laboratorio cambié una página en el origen con el borde en TTL de diez minutos: el origen devolvía «Pagina v2» y el borde seguía con la versión anterior. La purga debe formar parte del flujo de publicación, y la comprobación posterior (una petición y mirar el estado de caché) debería automatizarse igual.
Cabeceras en el CDN: Cache-Control, Vary y ETag
Al CDN le llegan tus cabeceras y decide qué hacer con ellas. Hay tres detalles que me parecen los más relevantes, y los trato más breve que en el artículo de caché para no repetirme:
s-maxage: según MDN, define cuánto tiempo es fresca la respuesta en una caché compartida, la ignoran las privadas y anula amax-ageen las compartidas. Permite tener una duración para el CDN y otra para el navegador.immutable: Cloudflare documenta que no tiene efecto en cachés públicas como la suya y que solo cambia el comportamiento del navegador.Vary: Cloudflare documenta que, por defecto, no considera los valores de Vary para decidir qué cachear, salvo con ajustes concretos o para imágenes yaccept-encoding. Cada CDN lo trata a su manera y por esoVary: User-Agentes una mala idea casi siempre.
Probé el último caso con nginx: una respuesta con Vary: User-Agent pedida con dos user-agents distintos, alternados. Resultado: MISS, MISS, HIT, HIT. Cada user-agent tiene su copia, así que con cientos de user-agents distintos, la caché se fragmenta. Es el comportamiento de nginx 1.24 con su configuración básica, no una regla general.
También comprobé que el borde puede contestar el 304: pedí un CSS con If-None-Match y el ETag recibido, y respondió 304 Not Modified con X-Cache-Status: HIT; el log del origen registró una sola petición a ese archivo. Googlebot soporta ETag con If-None-Match según la documentación de Google (ya desarrollada en el artículo de caché), de modo que un ETag estable en el origen permite que el 304 salga del borde.
HTTPS y certificados con un CDN delante
Con CDN hay dos tramos: visitante a borde y borde a origen. Si el CDN termina el TLS, el certificado que ve Googlebot es el del borde. El fallo clásico aparece cuando el origen fuerza HTTPS con una redirección y el borde le habla en HTTP sin avisarle del esquema original: el origen redirige, el visitante vuelve al borde y vuelta a empezar.
Lo reproduje con dos nginx: un origen que redirige a HTTPS si no recibe X-Forwarded-Proto: https, y un borde con certificado autofirmado que no enviaba esa cabecera:
$ curl -skL --max-redirs 5 -o /dev/null https://127.0.0.1:8386/pagina/
exit=47   (301 → https://127.0.0.1:8386/pagina/ en bucle)
El código de salida 47 de curl significa que superó el máximo de redirecciones. Al añadir proxy_set_header X-Forwarded-Proto $scheme; en el borde, el mismo origen respondió 200. Cada proveedor resuelve esto con su propio ajuste de cifrado entre borde y origen, que no he probado. Mi regla es probar con curl -IL las cuatro variantes de protocolo y host (http y https, con y sin www), y que todas terminen en una sola URL con 200.
Imágenes en el CDN: dominio propio, subdominio o dominio del proveedor
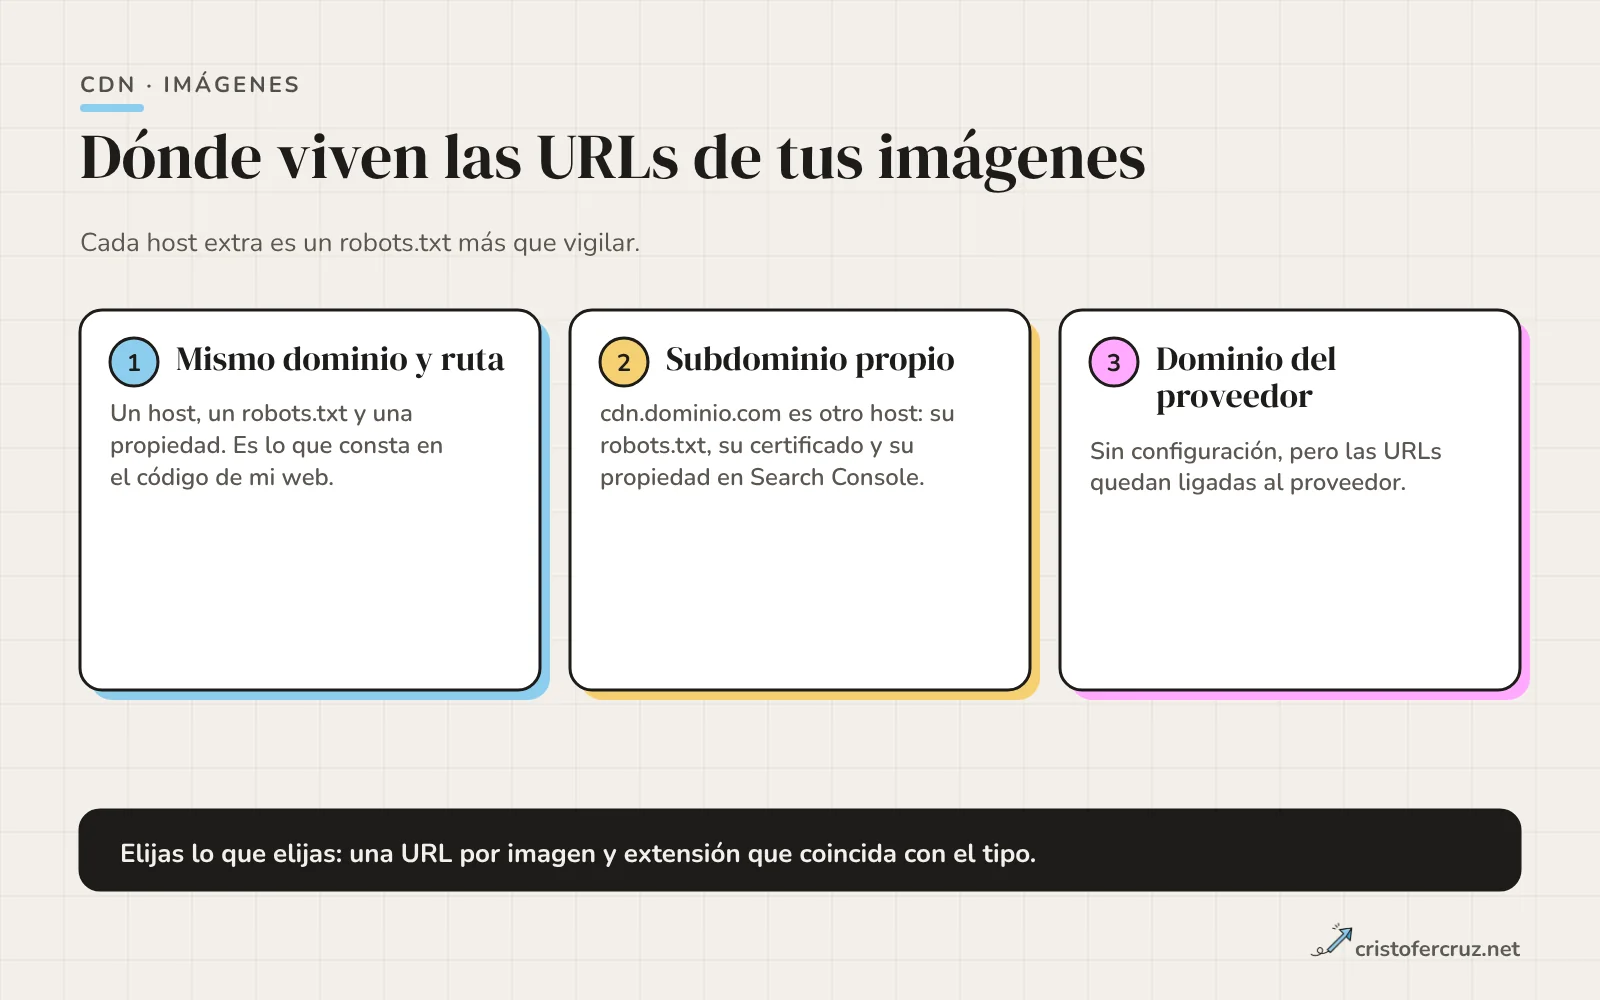
Servir imágenes desde otro host es lo más habitual de un CDN, y Google lo admite con condiciones: permite URLs de otros dominios en los sitemaps de imágenes y recomienda verificar la propiedad del dominio del CDN en Search Console para que informe de errores de rastreo. También pide referenciar cada imagen siempre con la misma URL, para reutilizarla sin pedirla de nuevo, y que la extensión coincida con el tipo de archivo. El resto (formatos, alt, sitemaps) está en la guía de optimización de imágenes.
| Opción | Ventaja | Coste |
|---|---|---|
Mismo dominio y ruta (/assets/) | Un solo host, un robots.txt, una propiedad | Todo el tráfico de estáticos pasa por tu host |
Subdominio propio (cdn.tudominio.com) | Tus URLs, migrables entre proveedores | Es otro host: su robots.txt, su certificado, su propiedad en Search Console |
| Dominio del proveedor | Cero configuración | URLs ligadas al proveedor y imposibles de mover sin cambiar todas las referencias |
Dos reglas de Google pesan aquí. Un robots.txt solo vale para el host, protocolo y puerto donde está: si el subdominio del CDN hereda un Disallow: / de una plantilla, tus imágenes no se rastrearán y tu dominio principal no avisará (más en el artículo sobre subdominios). Y el hotlinking: Google documenta una vía para impedir que Google Images enlace tu imagen en línea, comprobar el referrer y, si la petición viene de un dominio de Google, responder 200 o 204; no lo considera cloaking ni provoca acciones manuales. Cualquier otro bloqueo por referrer que alcance a Googlebot es cosa tuya.
Search Engine Journal recogió que Google recomendó alojar recursos en otro hostname, como un CDN o un subdominio, para aliviar el crawl budget. No pude leer el original de Google, así que es un dato de segunda mano; en un sitio pequeño no me parece razón para complicar la estructura.
Errores típicos al poner un CDN
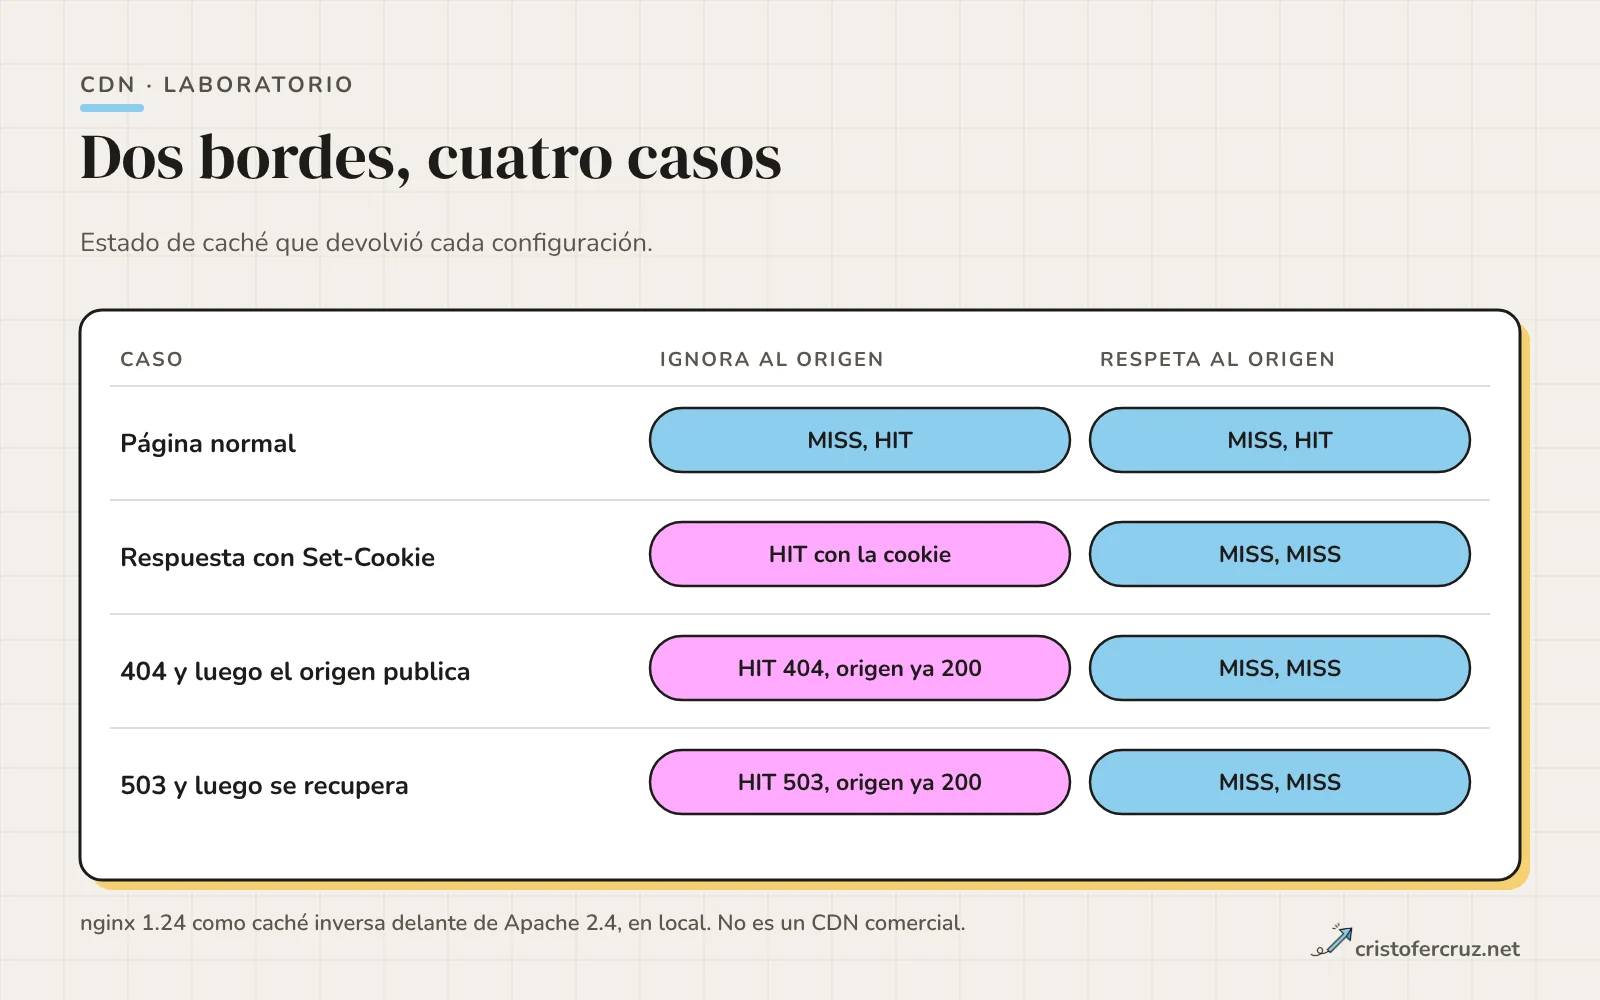
Hice la prueba que más me interesaba: dos configuraciones de borde delante del mismo origen Apache 2.4 (nginx 1.24 como caché inversa, todo en local, no un CDN comercial). La primera cachea todo diez minutos e ignora Set-Cookie y Cache-Control; la segunda guarda solo 200 y 301 y respeta al origen.
| Caso | Ignora las cabeceras del origen | Respeta al origen |
|---|---|---|
| Página normal, dos peticiones | MISS, HIT | MISS, HIT |
Respuesta con Set-Cookie | MISS, HIT: la cookie salió también en la copia | MISS, MISS: no se guarda |
| 404 y después el origen publica la página | HIT con 404, aunque el origen ya daba 200 | MISS, MISS |
| 503 y después el origen se recupera | HIT con 503, aunque el origen ya daba 200 | MISS, MISS, y luego 200 |
La configuración respetuosa es corta. Con nginx, el núcleo es no activar proxy_ignore_headers para Set-Cookie y Cache-Control y limitar los códigos que se guardan:
proxy_cache b;
proxy_cache_valid 200 301 10m;
proxy_cache_use_stale error timeout http_503 updating;
add_header X-Cache-Status $upstream_cache_status always;
Otros dos fallos, que no reproduje:
- Cachear 404 y 5xx. Cloudflare, por ejemplo, cachea 404 y 410 tres minutos por defecto. Revisa el TTL de los errores en tu proveedor y si puedes ajustarlo.
- Retos en vez de contenido. Una página de «comprobando tu navegador» devuelta con 200 puede acabar siendo, para Google, una página sin contenido útil (un soft 404). No he encontrado documentación sobre cómo trata Google los retos; la prevención es la del apartado de Googlebot.
Cómo lo tengo en mi web
He buscado en el código de cristofercruz.net las referencias a CDN y estos son los hechos que constan en el repositorio:
- No hay ninguna referencia a Cloudflare, Fastly, Akamai, CloudFront ni Bunny en el
.htaccess, elREADME, elrobots.txtni en las plantillas deincludes/. - La única mención de un CDN en código es de terceros: la herramienta de GeoGrid (
/herramientas/geogrid-seo-local/) carga Leaflet 1.9.4, CSS y JS, desdecdnjs.cloudflare.com, sin atributointegrity. Es una librería externa, no el CDN de la web. - Las imágenes, las fuentes y los scripts propios se sirven desde el mismo dominio, con nombres con hash de 12 caracteres y las reglas de caché del
.htaccess(siete días para estáticos normales, un año conimmutablepara los versionados). No hay un subdominiocdn., así que hay un solo robots.txt. - La página 404 envía
Cache-Control: no-store, que es lo que querría que respetara cualquier caché intermedia. - Los scripts de analítica y publicidad (Google Tag Manager, Clarity, Hotjar y otros) cargan desde los hosts de cada servicio. No son un CDN mío.
Lo que hay delante del servidor (DNS, proxy, hosting) no se lee en el código, y por eso no lo afirmo aquí. En mi artículo de Core Web Vitals describo la web con Cloudflare delante; es un dato de infraestructura que no sale del repositorio, y lo dejo fuera de lo que verifico en esta guía. Tampoco he medido el TTFB del origen frente al del borde, ni tengo logs del CDN; si algún día los saco, lo añadiré con cifras.
Cómo auditar un CDN paso a paso
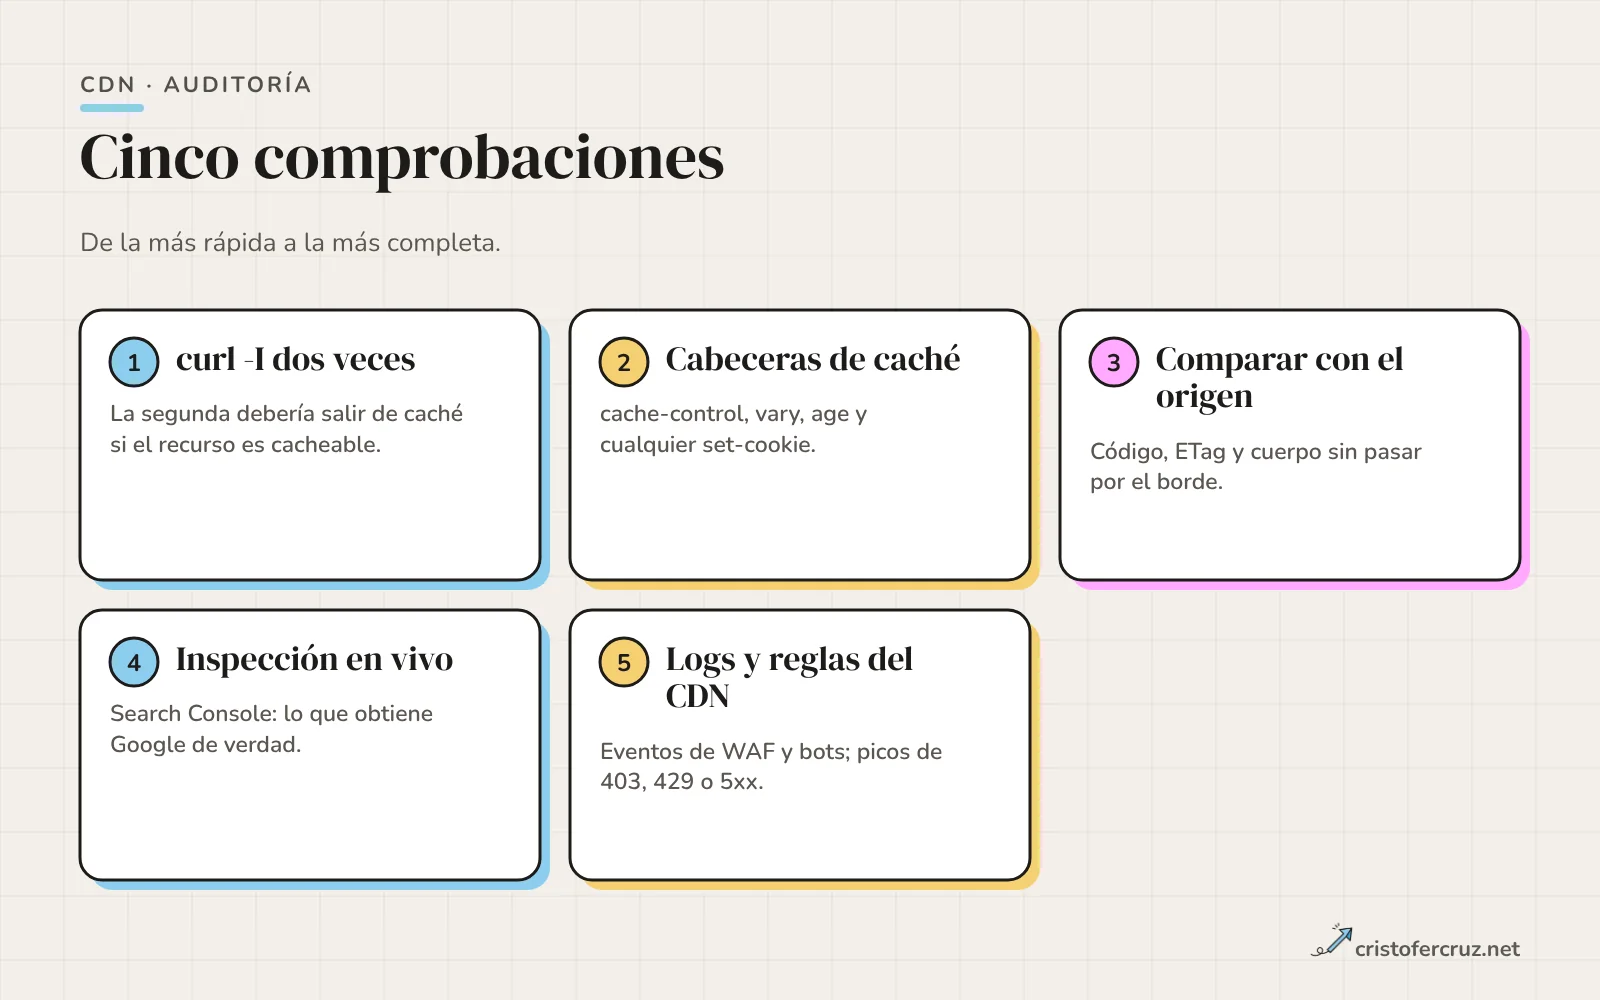
- Dos peticiones con
curl. La segunda debería mostrar un acierto de caché si el recurso es cacheable:
En Cloudflare, el campo escurl -sI https://tudominio.com/assets/estilo.css | grep -iE "^(HTTP|cache-control|age|etag|vary|set-cookie|server|via)|cache" curl -sI https://tudominio.com/assets/estilo.css | grep -iE "cache"cf-cache-status:HIT(servido desde caché),MISS(cacheable, pero no estaba),EXPIRED,DYNAMIC(no cacheable según el borde),BYPASS,REVALIDATED,UPDATINGySTALE. Otros proveedores usan nombres distintos (x-cachees habitual); consulta su documentación. - Lee las cabeceras. En el HTML busca
cache-control,varyy cualquierset-cookie. Una cookie en una página «pública» suele ser la razón de que no se cachee o, peor, de que se cachee con ella. - Compara con el origen. Si puedes pedir al origen sin pasar por el borde (otro hostname, o su IP con la cabecera
Host), compara código, ETag y cuerpo. - Inspección de URL en vivo. La prueba en vivo de Search Console muestra si Google pudo obtener la página y el código HTTP: es lo más cercano a ver tu CDN con los ojos de Googlebot. Un
curl -A Googlebotsolo prueba el user-agent, no la IP: detecta reglas por UA, pero no descarta bloqueos por IP. - Logs y reglas del CDN. Revisa los eventos del WAF y de bots filtrando por Googlebot verificado y, en Search Console, las estadísticas de rastreo: picos de 5xx, 403 o 429. El log del origen subestima el rastreo cuando el CDN responde desde caché.
Si el CDN forma parte de un problema de rastreo o rendimiento que no consigues aislar, entra en una auditoría SEO; y para decidir proveedor y política de caché, lo planteo en una consultoría SEO.
Por dónde empezaría en una web con CDN:
- Pedir dos veces el HTML y un estático y anotar el estado de caché de cada uno.
- Comprobar que el HTML con cookie o sesión no se guarda y que 404 y 5xx no se cachean más de unos segundos.
- Revisar las reglas de bots y límites de tasa y confirmar que Googlebot, verificado por IP, queda exento.
- Automatizar la purga al publicar y comprobar después que el estado ya no es
HIT. - Si hay un host de imágenes, verificarlo en Search Console y revisar su robots.txt.
Preguntas frecuentes
¿Un CDN mejora el SEO?
No como señal directa. Mejora el TTFB de lo que cachea y la disponibilidad; mal configurado, puede bloquear a Googlebot o servir errores guardados.
¿Un CDN cambia la geolocalización de mi web para Google?
Según Google, la ubicación del servidor es una señal entre varias, y con CDN no es definitiva. Para el SEO internacional, las señales documentadas son el dominio (ccTLD), la estructura de URLs y hreflang, y no conviene adaptar el contenido por IP.
¿Tengo que permitir las IP de Googlebot en el CDN?
Si tienes reglas de bots o límites estrictos, sí conviene eximir a Googlebot verificado. Verifícalo por DNS inverso o con los ficheros JSON de rangos de Google, y automatiza la descarga porque la página no indica cada cuánto se actualizan.
¿Es mejor cdn.tudominio.com o el dominio del proveedor?
Un subdominio propio mantiene tus URLs y te permite cambiar de proveedor, pero es otro host con su robots.txt y su propiedad en Search Console. El dominio del proveedor no requiere configuración, a costa de ligar tus URLs de imagen a él.
¿Cómo sé si una respuesta viene del CDN o del origen?
Con curl -I dos veces y las cabeceras de caché del proveedor (cf-cache-status en Cloudflare). La segunda debería salir de caché si el recurso es cacheable.
¿Qué pasa si el CDN devuelve un reto o CAPTCHA a Googlebot?
No he encontrado documentación de Google sobre cómo trata los retos, y una página de comprobación servida con 200 se parece a un soft 404. Si el CDN devuelve 403, 429 o 503, Google lo documenta como error y 429 y 503 reducen el ritmo de rastreo. Exime a Googlebot verificado y prueba con la inspección de URL en vivo.
Referencias y fuentes
Documentación consultada para este artículo.
- Verify requests from Google crawlers and fetchers Google Search Central
- New Location for the Google Crawlers' IP Range Files Google Search Central Blog
- Managing multi-regional and multilingual sites Google Search Central
- How Google crawls locale-adaptive pages Google Search Central
- What is Googlebot Google Search Central
- Reduce the Googlebot crawl rate Google Search Central
- How Google interprets the robots.txt specification Google Search Central
- Google Image SEO best practices Google Search Central
- Default cache behavior Cloudflare Docs
- Cache-Control directives Cloudflare Docs
- Cloudflare cache responses Cloudflare Docs
- Purge cache Cloudflare Docs
- Verified bots Cloudflare Docs
- Bot Fight Mode Cloudflare Docs
- Cache-Control MDN Web Docs
- CDN MDN Web Docs
- Time to First Byte (TTFB) web.dev
- Google: host resources on a different hostname to save crawl budget Search Engine Journal