- Según Google, los 5xx y el 429 hacen que sus rastreadores reduzcan el ritmo; si el servidor vuelve a dar 2xx, lo suben poco a poco. Las URL indexadas que fallan de forma persistente acaban saliendo del índice, pero Google no dice en cuántos días.
- Un 500 puntual no hace daño. Los que cuestan son los que se repiten sobre las mismas URL durante días, los que afectan a muchas URL a la vez y los que afectan a
robots.txt. - Para parar el rastreo unas horas o un par de días, Google recomienda un 503 con
Retry-Aftery no un 200 con un cartel de «volvemos pronto». Lo he montado y probado en Apache y en nginx. - Un 5xx en
robots.txtdetiene el rastreo de todo el sitio durante las primeras 12 horas y, si dura, entran los 30 días de la última copia buena. - Los detectas en Search Console (informe de páginas y estadísticas de rastreo) y, con más detalle, en el log del servidor. Un
awkde una línea saca los 5xx de Googlebot. - La causa casi siempre está en PHP, la base de datos, la memoria, un plugin o el tiempo de espera entre el proxy y la aplicación, no en Google.
Un error 500 no tiene un efecto fijo en el SEO. Depende de cuántas URL afecta, cuánto dura, si toca el robots.txt y qué responde el servidor mientras se arregla. Google documenta el mecanismo general y deja sin cifra lo que más preocupa: cuánto tiempo hace falta para que una URL caiga del índice.
Aquí separo lo que está documentado de lo que no, explico las diferencias entre 500, 502, 503 y 504, monto una página de mantenimiento correcta con 503 (probada con Apache y nginx reales, con curl), saco 5xx de un log de ejemplo con grep y awk y cuento lo que he comprobado sobre cómo se comporta mi propia web cuando algo falla.
Qué hace Google con los 5xx
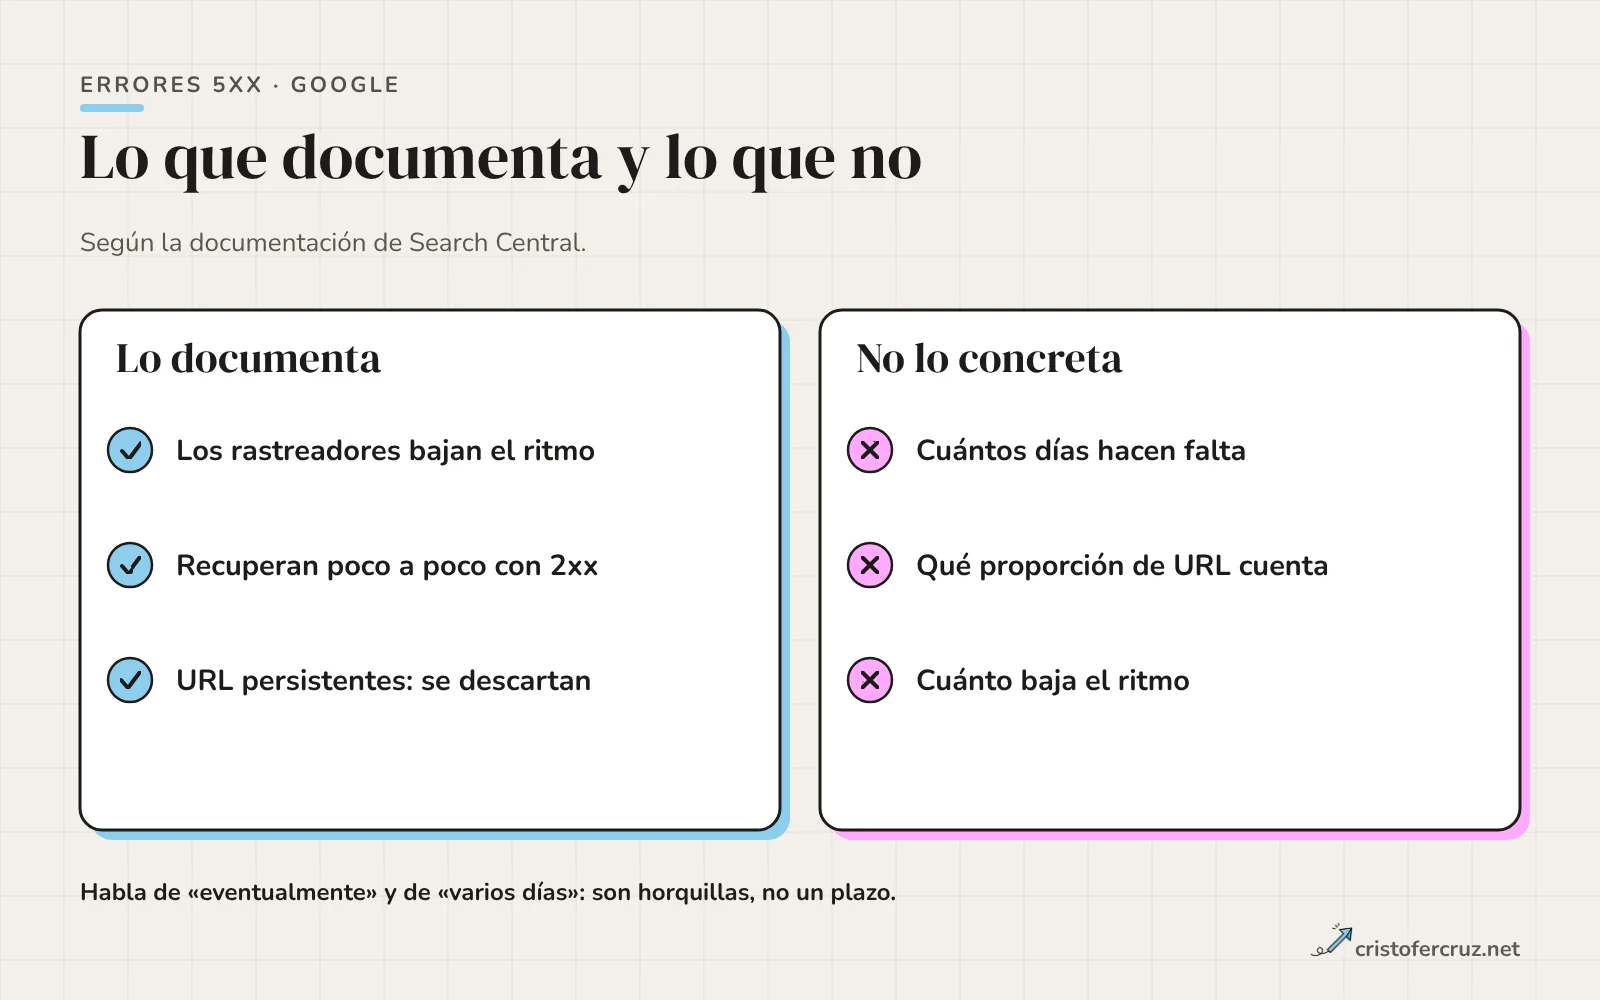
La documentación de Google sobre códigos de estado resume el comportamiento en tres frases. Los errores 5xx y el 429 hacen que los rastreadores bajen el ritmo temporalmente. Las URL ya indexadas se conservan en el índice, pero con el tiempo se descartan si el error persiste. Y cuando el servidor vuelve a responder con 2xx, Google aumenta el ritmo de forma gradual.
De ahí salen dos consecuencias prácticas. Un fallo breve cuesta rastreo, no posiciones: durante unas horas Google visita menos y tarda más en ver los cambios. Y un fallo largo sobre las mismas URL termina en desindexación. Para cuándo, la página de Google sobre cómo reducir el rastreo habla de «varios días» en la misma URL, y la de pausa de un negocio online pide que la desactivación completa del sitio dure «unos pocos días como máximo». Son horquillas, no un plazo garantizado, y no he encontrado ninguna cifra oficial más precisa.
| Situación | Qué documenta Google | Qué no documenta |
|---|---|---|
| 5xx o 429 en rastreo | El rastreador baja el ritmo; recupera de forma gradual con 2xx | Cuánto baja y cuánto tarda en recuperar |
| URL indexada con 5xx persistente | Se conserva en el índice y «con el tiempo» se descarta | El número de días o de intentos fallidos |
| 500, 503 o 429 a propósito | Sirve para reducir el rastreo unas horas o 1-2 días | Qué pasa si el valor de Retry-After es mayor que su ventana |
5xx en robots.txt | 12 horas sin rastreo, luego última copia buena hasta 30 días | Cuándo reintenta dentro de esos plazos |
Esto conecta con el presupuesto de rastreo: los 5xx bajan el límite de capacidad que Google se pone con tu servidor. Si tu web tiene pocas páginas, el efecto es más una molestia que un riesgo; si tiene cientos de miles, un servidor que falla a menudo ralentiza todo el descubrimiento.
500, 502, 503 y 504: qué significa cada uno
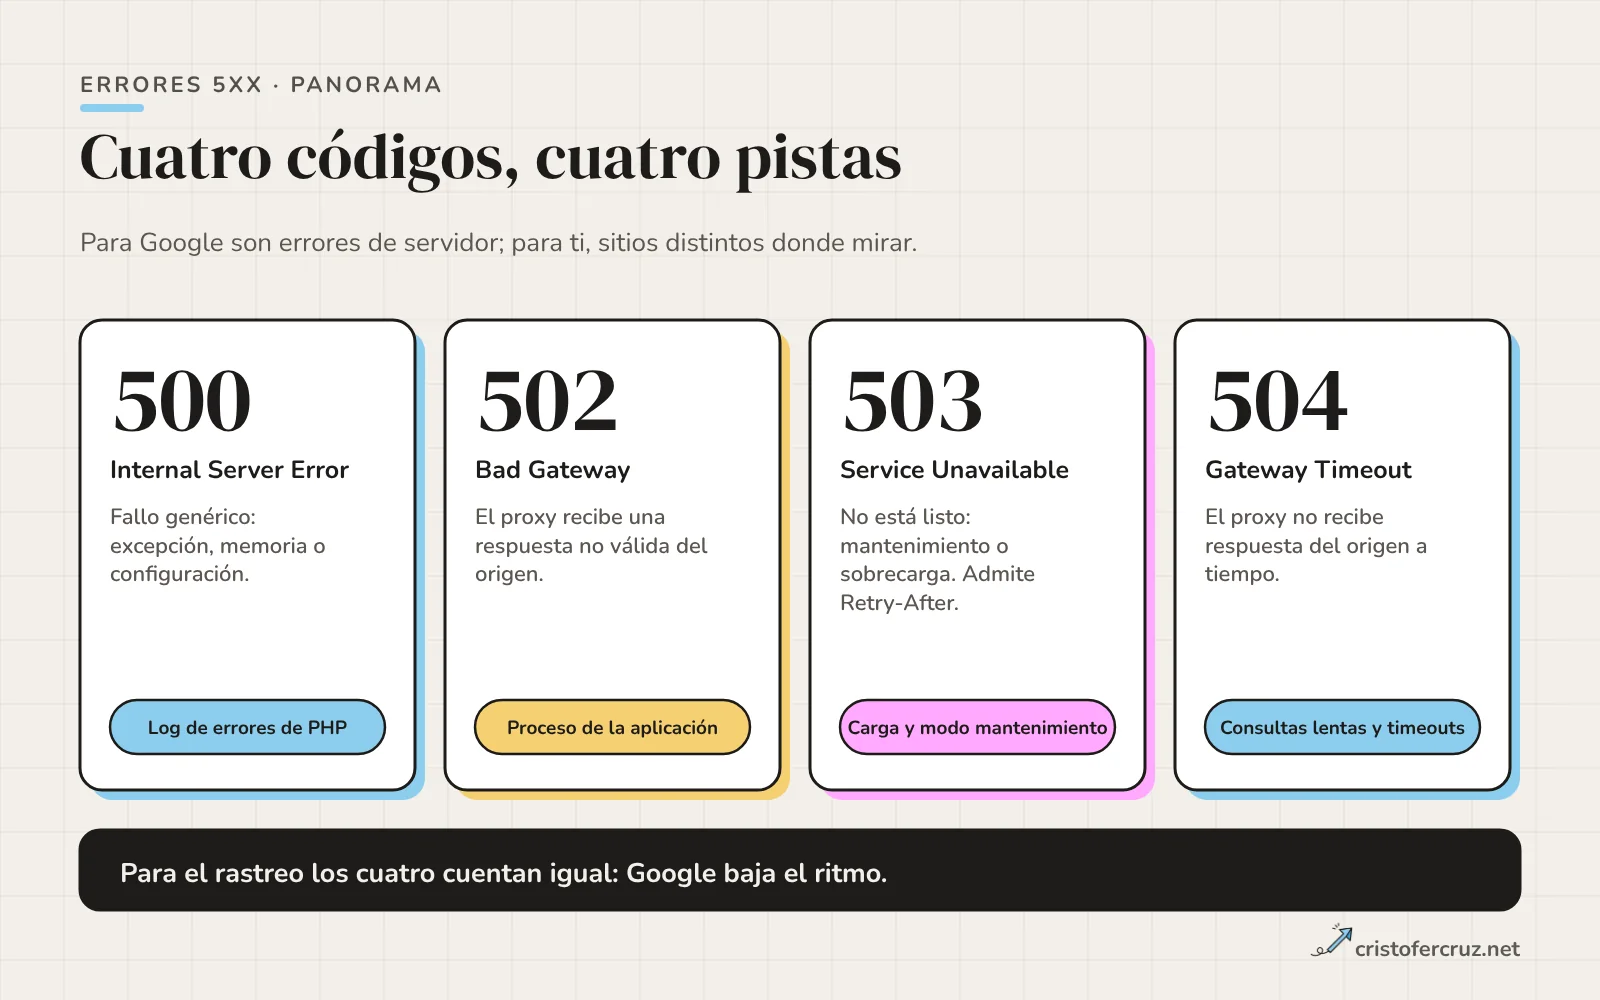
Para Google los cuatro son errores de servidor y reciben el mismo trato general. Para quien arregla el problema son cuatro pistas distintas. La lista completa de códigos de respuesta la tienes en su propio artículo; estos cuatro son los que aparecen cuando algo se rompe.
| Código | Qué indica | Dónde mirar primero |
|---|---|---|
| 500 Internal Server Error | Respuesta genérica: el servidor encontró una condición inesperada y no pudo atender la petición | El log de errores de PHP o de la aplicación |
| 502 Bad Gateway | Un proxy o gateway recibió una respuesta no válida del servidor de origen | Si el proceso de la aplicación está vivo (PHP-FPM, Node, etc.) |
| 503 Service Unavailable | El servidor no está listo para atender la petición: mantenimiento o sobrecarga | Carga del servidor, límites de procesos, modo mantenimiento activo |
| 504 Gateway Timeout | El gateway no recibió respuesta del origen a tiempo | Consultas lentas, procesos colgados y el timeout del proxy |
La diferencia entre 502 y 504 la resume bien MDN: con un 502 el gateway sí recibió algo del origen pero no era válido, y con un 504 no recibió ninguna respuesta HTTP dentro del tiempo límite. En una prueba con nginx de proxy lo vi tal cual: con el origen apagado, la petición devolvió un 502 y el log de errores decía «connect() failed (111: Connection refused) while connecting to upstream»; con un origen que tardaba seis segundos y un proxy_read_timeout de dos, devolvió un 504 a los 2,0 segundos y el log decía «upstream timed out».
Cuánto tarda en doler
La respuesta corta es que depende y que Google no da una cifra. Lo que sí ordena el riesgo es cuántas URL afecta el error (un 500 en una página de servicio no es un 503 en todo el sitio), si cae siempre sobre las mismas URL durante días y si toca robots.txt, que es el caso con plazos documentados. Un 5xx que se repite en una URL es una señal ambigua: puede ser temporal o permanente. Un 404 o un 410 dicen con más claridad que el contenido no existe, y para elegir entre ellos está el artículo sobre 404 y soft 404.
Una trampa al diagnosticar: la inspección de URL en vivo puede salir bien aunque el rastreo real fallara. La ayuda de Search Console lo recoge: estos errores pueden ser temporales, y la prueba en vivo puede funcionar cuando el intento de Google no lo hizo. Que hoy funcione no explica el pico de ayer; para eso está el log.
Un 5xx en robots.txt: el caso más serio
Si Google no consigue leer robots.txt porque devuelve un 5xx, no sabe qué tiene permitido, y la documentación define qué hace. Los plazos son concretos.
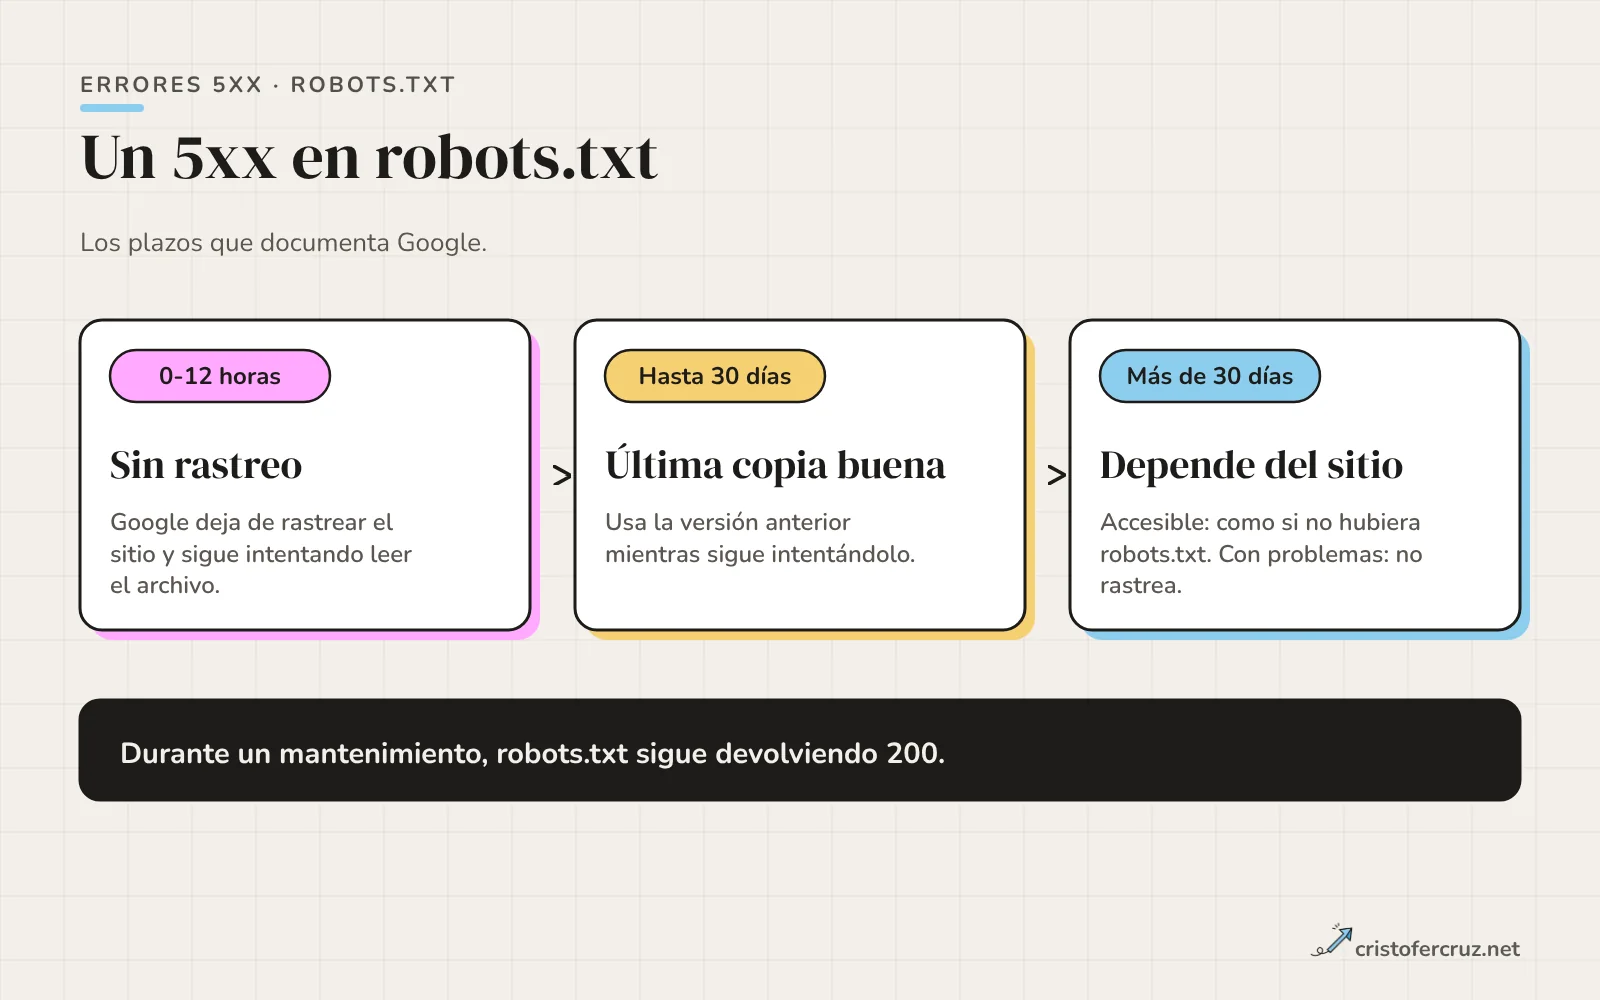
- Primeras 12 horas. Google deja de rastrear el sitio, pero sigue intentando leer el archivo.
- Hasta 30 días. Si no consigue una versión nueva, usa la última copia buena mientras sigue intentándolo. Si no tenía ninguna copia, asume que no hay restricciones.
- Más de 30 días. Si la web está accesible con normalidad, Google actúa como si no hubiera
robots.txt. Si la web tiene problemas de disponibilidad, deja de rastrearla y pide el archivo de vez en cuando.
Dos detalles que se pasan por alto. El primero: un 4xx en robots.txt (salvo el 429), como un 403, un 404 o un 410, no se trata como error de servidor, sino como si el archivo no existiera, y Google rastrea sin restricciones. El segundo: Google puede guardar el archivo más de 24 horas si no consigue actualizarlo, por ejemplo con timeouts o 5xx. Todo lo demás sobre el archivo está en el artículo de robots.txt.
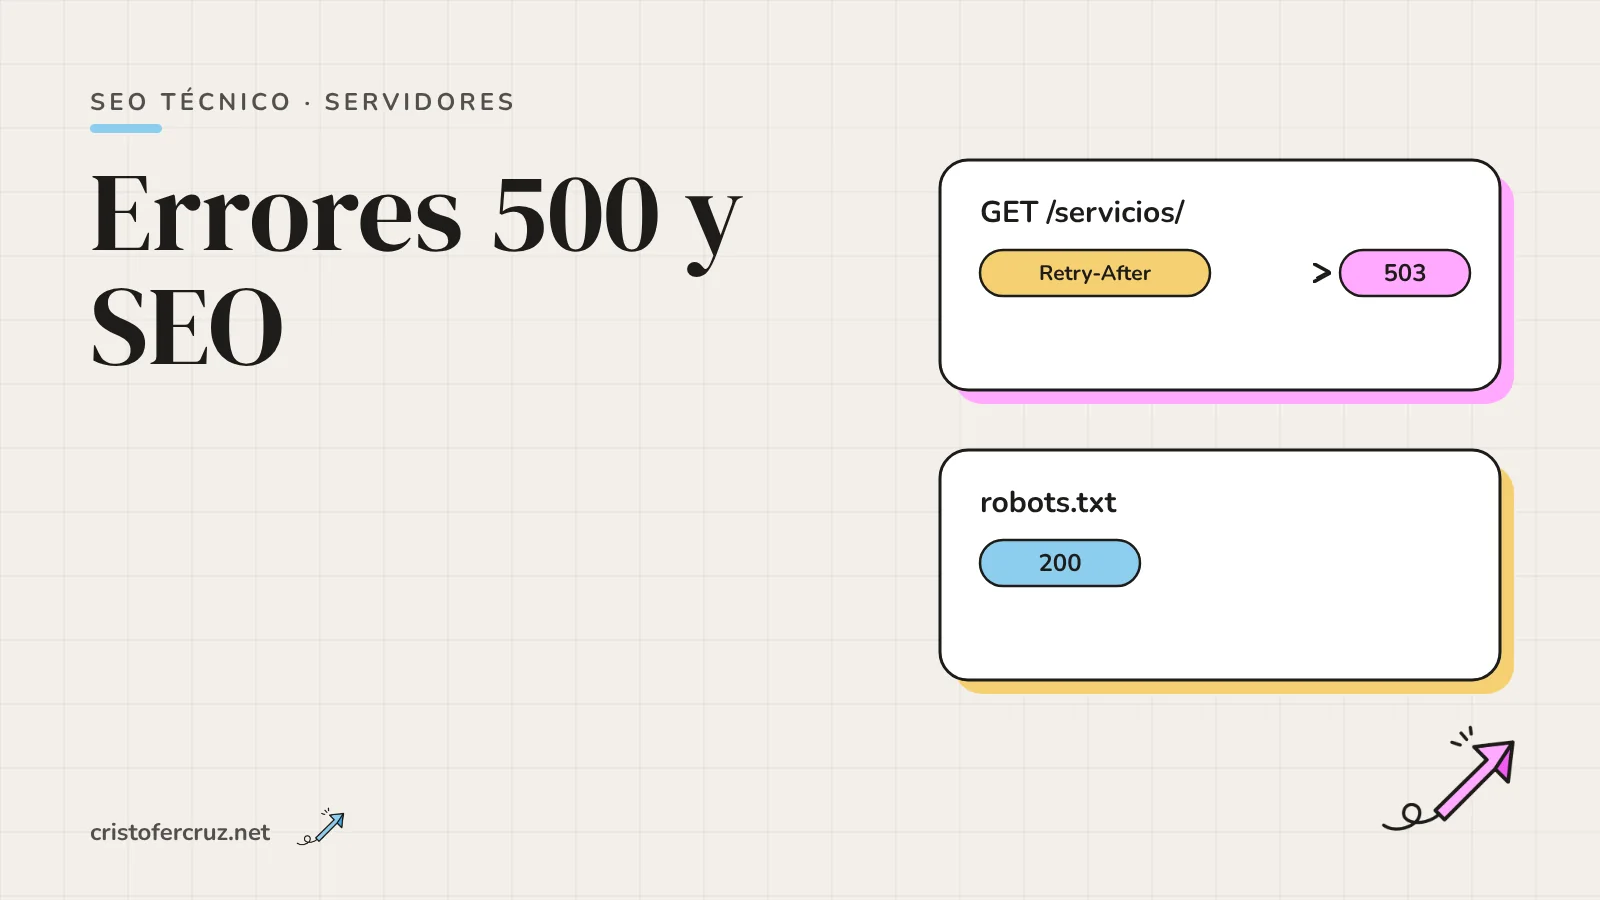
La regla de despliegue es clara: en mantenimiento, robots.txt tiene que seguir devolviendo 200. La guía de Google para pausar un negocio online lo dice sin rodeos: no devuelvas un 503 en robots.txt porque bloquea todo el rastreo.
503 con Retry-After para mantenimiento
Si vas a dejar el sitio fuera de servicio un rato, la opción que recomienda Google para cierres urgentes de uno o dos días es una página informativa con estado 503 en lugar del contenido. Además propone enviar Retry-After con una fecha o una duración aproximadas, servir la página en HTML estático con el CSS en línea y comprobar la respuesta con curl. Evita 403, 404, 410, noindex y un robots.txt que bloquee todo, porque pueden sacar las URL de Search. Antes de nada, la guía prefiere mantener el sitio en línea con la funcionalidad limitada (sin carrito y con un aviso) si es posible. Y avisa de lo que pasa si el 503 dura: con 503 Google no puede refrescar títulos, descripciones ni datos estructurados, y la recuperación tras una desactivación larga no tiene plazo fijo.
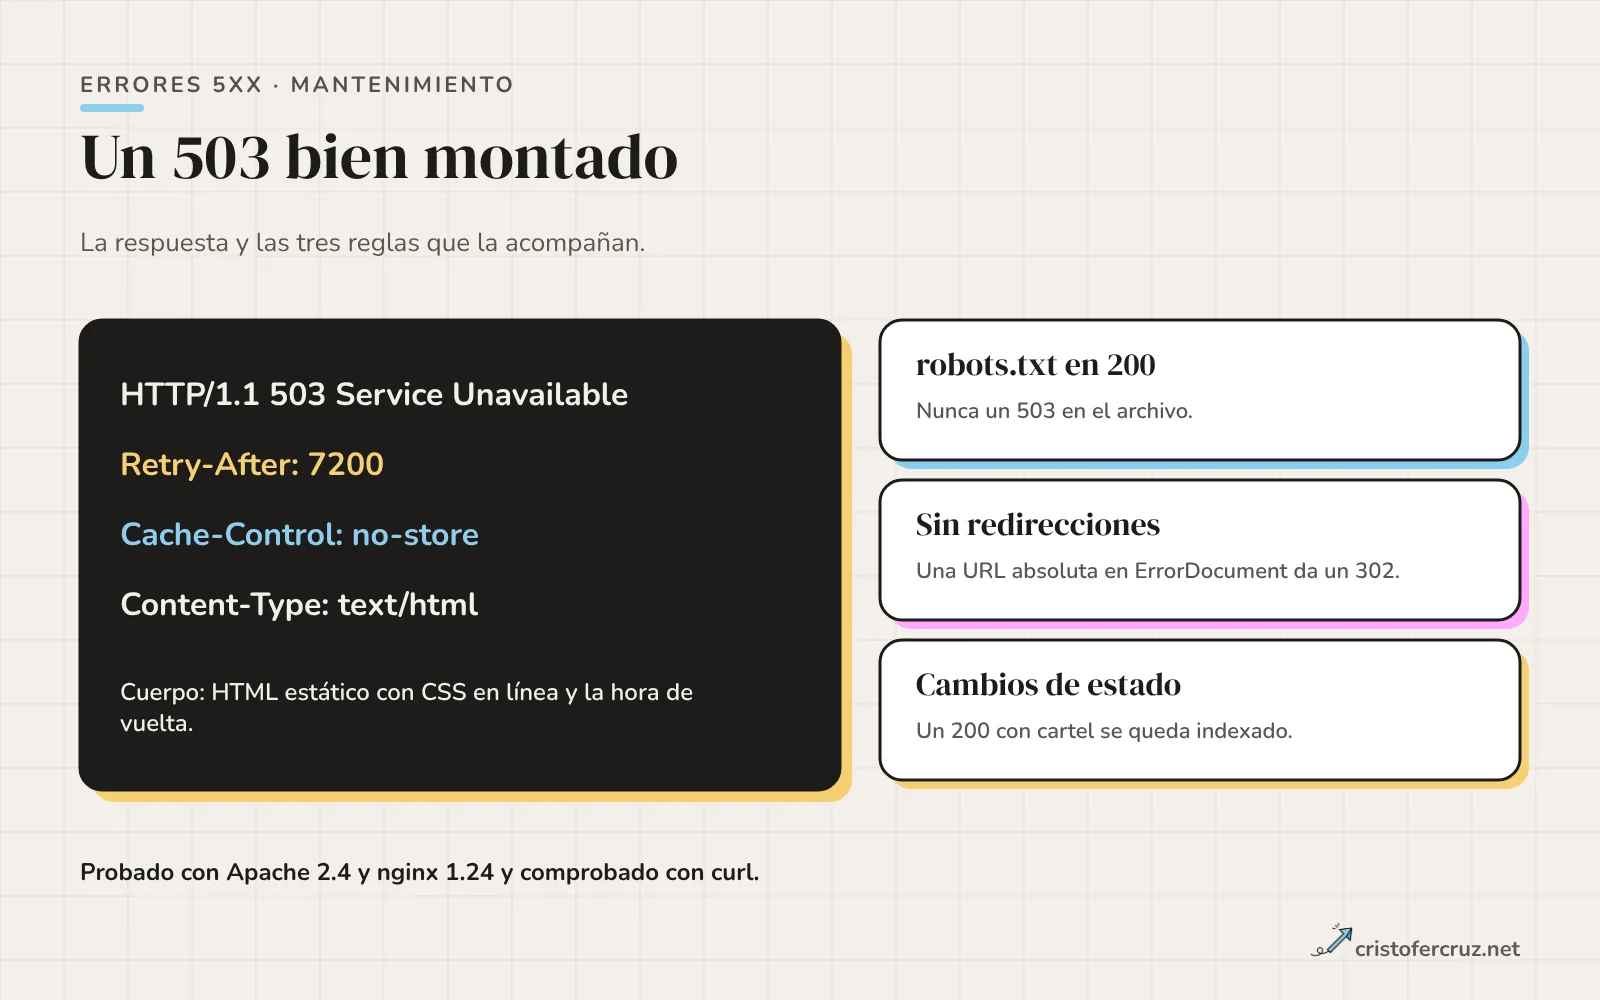
La cabecera Retry-After admite dos formatos según MDN: una fecha HTTP o un número entero de segundos. Yo uso segundos porque no dependo del reloj del servidor. Estas dos configuraciones las he arrancado de verdad y probado con curl: un fichero .mantenimiento en la raíz activa el modo; borrarlo lo desactiva.
Apache 2.4
RewriteEngine On
RewriteCond %{DOCUMENT_ROOT}/.mantenimiento -f
RewriteCond %{REQUEST_URI} !^/mantenimiento\.html$
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteRule ^ - [R=503,L]

ErrorDocument 503 /mantenimiento.html
Header always set Retry-After "7200" "expr=%{REQUEST_STATUS} == 503"
Header always set Cache-Control "no-store" "expr=%{REQUEST_STATUS} == 503"
Resultado con curl -i a /servicios/ con el modo activo: HTTP/1.1 503 Service Unavailable, Retry-After: 7200, Cache-Control: no-store y el HTML de mantenimiento en el cuerpo. /robots.txt devolvió 200, un POST a la portada también devolvió 503 y, al borrar el fichero, volvió el 200. Dos observaciones de la prueba: /mantenimiento.html pedida directamente respondió 200, y si pones en ErrorDocument una URL absoluta (http://…/mantenimiento.html) Apache no sirve el 503, sino que redirige con un 302 a esa dirección. Esa es la forma más común de estropear un mantenimiento.
nginx
error_page 503 @mantenimiento;

location / {
    if (-f $document_root/.mantenimiento) { return 503; }
    try_files $uri $uri/ =404;
}
location = /robots.txt { }
location = /mantenimiento.html { internal; }
location @mantenimiento {
    rewrite ^ /mantenimiento.html break;
    add_header Retry-After 7200 always;
    add_header Cache-Control "no-store" always;
}
Con nginx 1.24 el resultado fue el mismo: HTTP/1.1 503 Service Temporarily Unavailable (nginx usa ese texto, el código es el mismo), Retry-After: 7200, Cache-Control: no-store y el HTML de mantenimiento; /robots.txt siguió en 200 y, sin el fichero, la web volvió a responder 200. Con internal, pedir /mantenimiento.html directamente devolvió 404. Lo comprobé quitando always: el 503 salió sin Retry-After ni Cache-Control, así que no lo quites. No he probado estas reglas detrás de un CDN ni de un proxy inverso, que pueden cachear o reescribir el 503.
Prueba el 503 con curl -I antes de anunciar el mantenimiento y otra vez al terminar. Un error frecuente es una página «en mantenimiento» que responde 200 y se queda indexada con el cartel como contenido.
500 o 503: cuál devolver y cuándo
Un 500 es lo que sale cuando algo falla sin que tú lo hayas decidido. Un 503 es una respuesta que eliges, y por eso admite Retry-After y comunica que el problema es temporal. Si capturas un error de la aplicación (base de datos caída, dependencia externa que no responde) y puedes mostrar una página de error limpia, un 503 describe mejor la situación que un 500 genérico. La documentación de Google sobre cómo reducir el rastreo trata los tres casos (500, 503 y 429) como válidos para frenar a Googlebot, y menciona Retry-After para las respuestas 503 y 429.
| Caso | Qué devolvería | Motivo |
|---|---|---|
| Mantenimiento programado | 503 con Retry-After | Es lo que documenta Google para pausas cortas |
| Base de datos caída y la aplicación lo detecta | 503 con una página de error estática | Es temporal y el 500 no lo comunica |
| Excepción no controlada en una plantilla | 500 (y arreglar el código) | No es temporal ni elegido; hay que corregirlo |
| Un cliente concreto te satura | 429 | MDN recomienda 429, no 503, para limitar a un cliente |
| Contenido retirado a propósito | 404 o 410, no 5xx | Un 5xx dice «volveré», y no es el caso |
Causas habituales y errores intermitentes
MDN cita como causas típicas de un 500 la configuración incorrecta del servidor, la falta de memoria, las excepciones no controladas y los permisos de archivo erróneos. En un sitio PHP, de forma más concreta, las causas más habituales son estas:
- Un plugin o un tema que se actualiza y rompe algo (en WordPress, el clásico).
- Un
.htaccesscon una directiva que el servidor no admite. En Apache, un módulo que falta o una sintaxis incorrecta devuelve 500 en todas las páginas a la vez. - Agotamiento de memoria o de procesos de PHP bajo un pico de tráfico o de rastreo.
- Una consulta a la base de datos que se queda colgada, que el proxy convierte en 504.
- Un archivo de configuración o de datos que se corrompe al desplegar (mi prueba de más abajo).
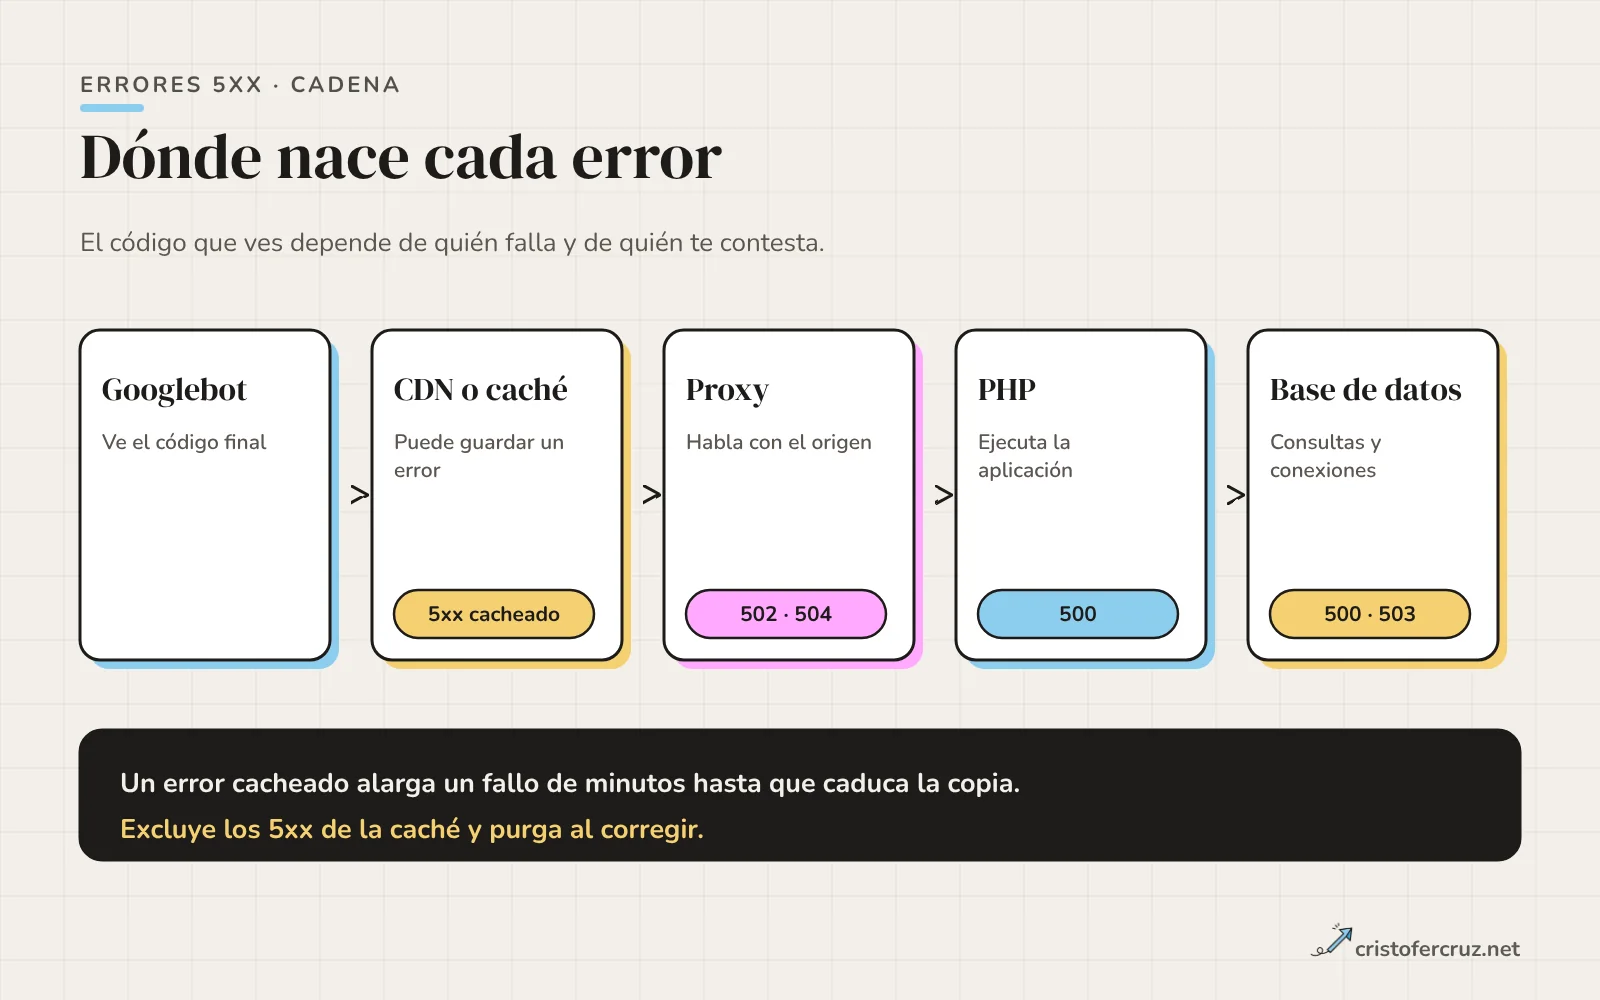
Los intermitentes son los más difíciles porque el que los ve no es el que los sufre. Cuando hay un CDN delante, el error puede aparecer solo en algunos puntos de presencia, o en el origen y no en el borde. Y hay un riesgo concreto: si la caché guarda la respuesta de error, un fallo de minutos se alarga hasta que caduque la copia. MDN lo advierte para el 503: normalmente no debería cachearse. El problema y la regla de excluir 5xx de la caché están en el artículo sobre caché.
Los picos de carga son la otra fuente habitual: un servidor justo que atiende a la vez una campaña, un rastreo de herramienta SEO y un bot agresivo acaba devolviendo 503 o 502. Mira de dónde viene el pico antes de comprar más servidor.
Cómo detectarlos
En Search Console
Dos informes distintos, para cosas distintas. El informe de indexación de páginas incluye el motivo «Error de servidor (5xx)» dentro de las páginas no indexadas, definido como que tu servidor devolvió un error de nivel 500 cuando se pidió la página. Te da las URL de ejemplo, pero no separa 500 de 503.
El informe de estadísticas de rastreo es el que ordena la gravedad. En «Estado del host» valora los últimos 90 días con tres niveles (sin problemas, problemas antiguos y problema reciente, si ocurrió en la última semana) y evalúa tres categorías: la obtención de robots.txt, la resolución DNS y la conectividad del servidor. Un 429 o 5xx en robots.txt cuenta como fallo. En «Respuestas de rastreo», los 5xx, los timeouts y los errores de red se agrupan como «malos». Dos límites que da la propia ayuda: solo está disponible para propiedades a nivel de raíz, y cuenta peticiones, no URL únicas.
En el log del servidor
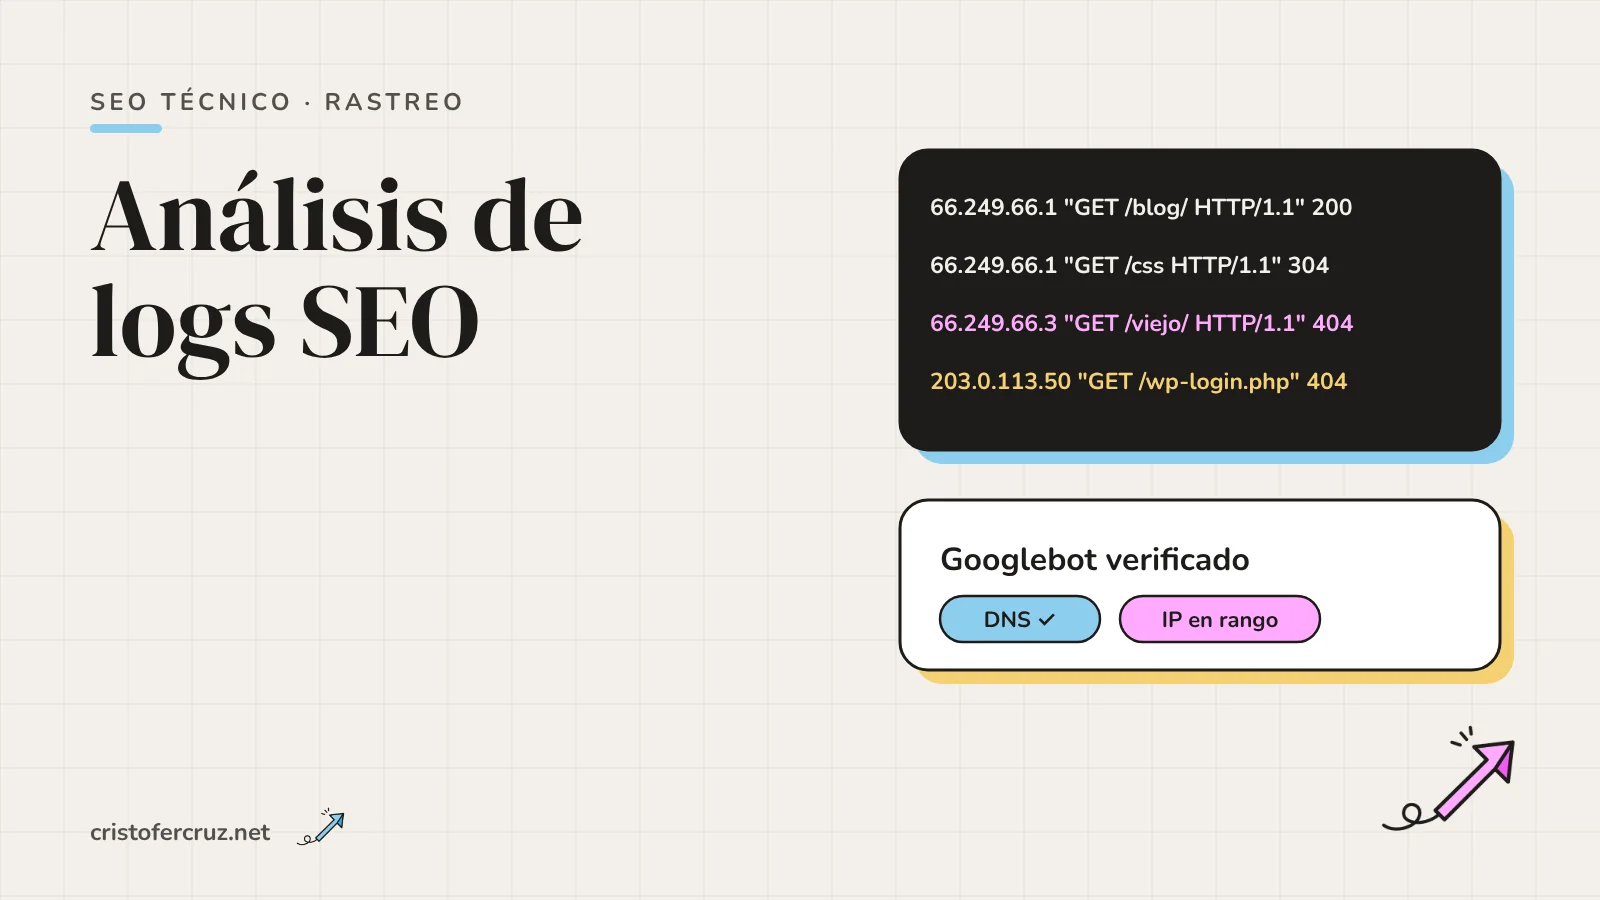
Search Console resume; el log te dice la hora exacta y la URL. Escribí un log de ejemplo de 20 líneas en formato combinado (datos inventados, dos días, una IP de usuario y una de Googlebot) y ejecuté sobre él estos comandos. Cómo conseguir el log, cómo verificar que el Googlebot es real y el resto del método están en el artículo de análisis de logs.
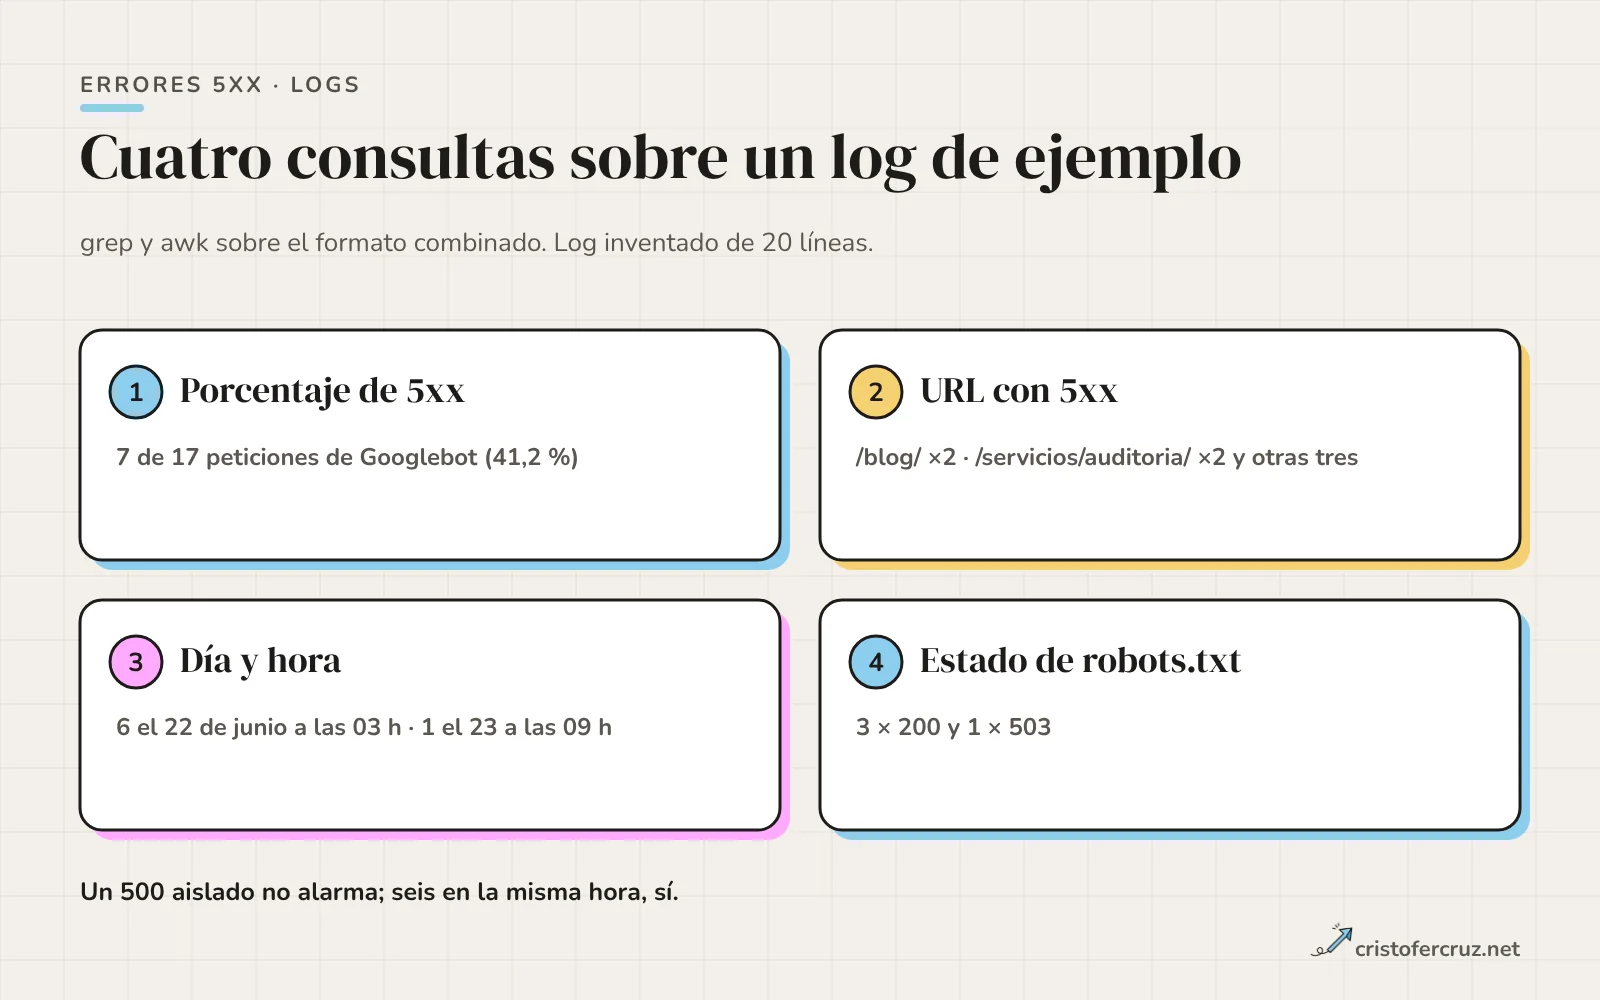
# Porcentaje de peticiones de Googlebot con 5xx
grep "Googlebot" access.log | awk '{t++; if ($9 ~ /^5/) e++} END {printf "%d de %d (%.1f%%)\n", e, t, e*100/t}'
# 7 de 17 (41.2%)

# URL con 5xx y cuántas veces
grep "Googlebot" access.log | awk '$9 ~ /^5/ {print $9, $7}' | sort | uniq -c | sort -rn
#   2 503 /blog/
#   2 500 /servicios/auditoria/
#   1 503 /servicios/consultoria/
#   1 503 /robots.txt
#   1 503 /blog/cache/

# Día y hora de los 5xx
grep "Googlebot" access.log | awk '$9 ~ /^5/ {split($4,a,":"); print substr(a[1],2) " " a[2] "h"}' | sort | uniq -c
#   6 22/Jun/2026 03h
#   1 23/Jun/2026 09h

# Qué responde robots.txt a Googlebot
grep "Googlebot" access.log | awk '$7=="/robots.txt" {print $9}' | sort | uniq -c
#   3 200
#   1 503
Cómo se lee ese ejemplo: seis 5xx concentrados en una franja de tres de la madrugada del primer día (la hora encaja con una tarea programada, aunque el log no lo demuestra) y un 500 suelto al día siguiente en una URL que ya había fallado. El 503 en robots.txt es el que más me importaría, porque encaja con el caso de las 12 horas. Un 500 aislado no es motivo de alarma; seis seguidos en la misma hora, sí.
Monitorización
Ni Search Console ni el log avisan a tiempo: el primero tarda y el segundo hay que leerlo. Un servicio externo que pida la portada, una página interior y robots.txt cada pocos minutos cubre ese hueco. No he comparado herramientas, así que no recomiendo ninguna; exige que compruebe el código de estado y que vigile robots.txt por separado.
Plan de actuación cuando aparecen 5xx
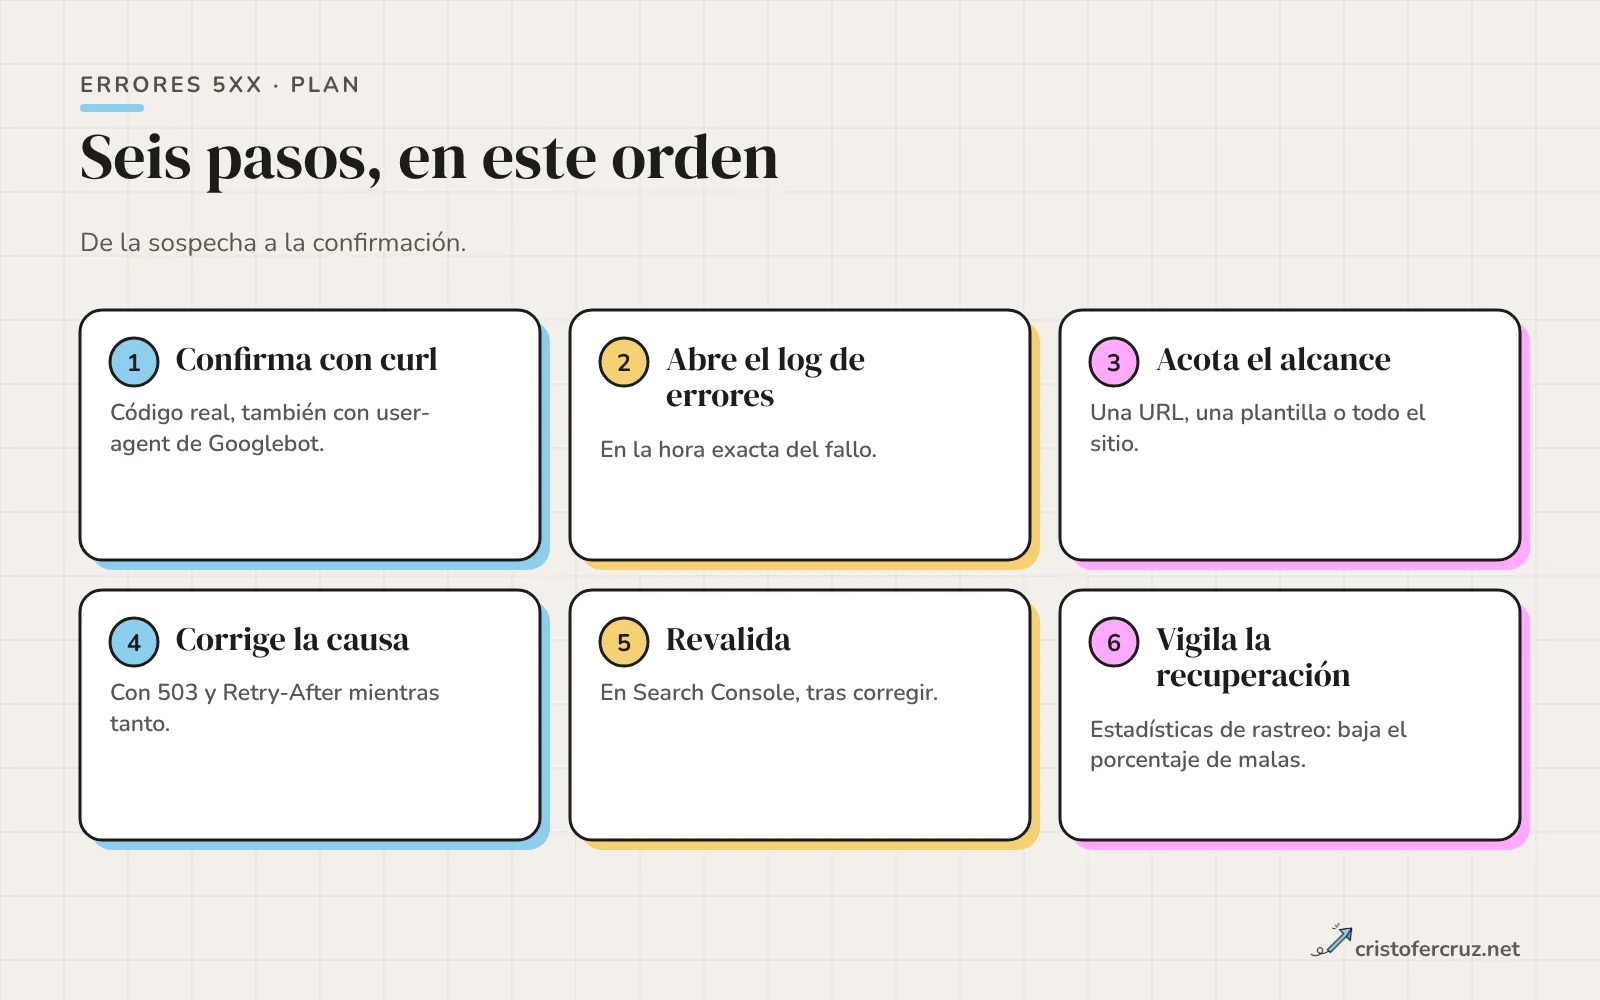
- Confirma el código real.
curl -I https://tudominio/url/y, si sospechas que solo falla para bots, repite con-A "Googlebot". Un navegador con caché puede enseñarte una página que el servidor no está sirviendo. - Abre el log de errores del servidor o de PHP en la hora exacta del fallo. El 500 genérico casi siempre tiene el mensaje real ahí.
- Acota el alcance. ¿Una URL, una plantilla, toda la web? ¿Solo bajo carga? ¿Solo a ciertas horas? La respuesta decide si es código, configuración o capacidad.
- Corrige la causa. Si necesitas tiempo, pon el 503 con
Retry-Afterde la sección anterior (conrobots.txten 200) y no un 200 con aviso. - Revalida. En el informe de indexación de páginas puedes pedir la validación del error una vez corregido. Si son pocas URL, la inspección de URL con «Solicitar indexación».
- Vigila la recuperación. En estadísticas de rastreo, el porcentaje de respuestas «malas» debería caer y el número de peticiones diarias volver a su nivel. Google dice que el ritmo vuelve de forma gradual: no esperes verlo recuperado al día siguiente.
Cómo trato los errores 500 en mi web
Esto es lo que consta leyendo el código de cristofercruz.net, y lo que no consta.
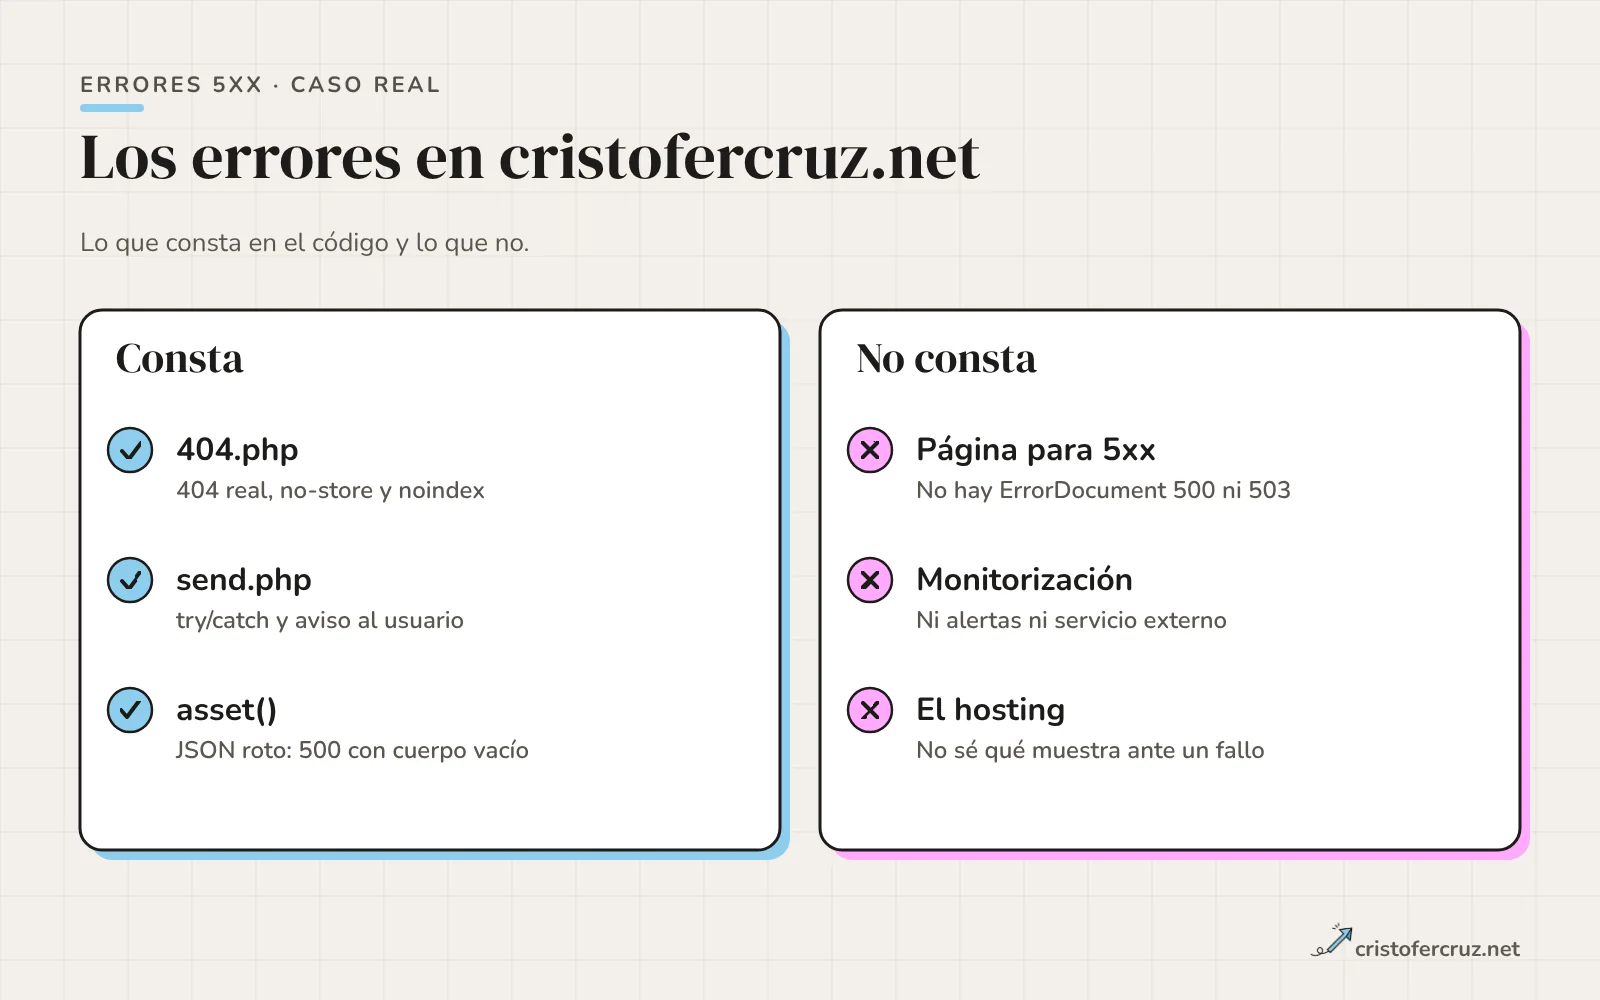
- 404. El
.htaccessdefineErrorDocument 404 /404.phpy también 403. La página404.phpenvía un 404 real,Cache-Control: no-storeynoindex, nofollow. - Sin página propia para 5xx. No hay
ErrorDocument 500ni 503. Si el servidor falla, lo que se vea lo decide el hosting. No tengo comprobado qué muestra. - Formulario de contacto.
send.phpenvuelve el envío con PHPMailer en untry/catchdeThrowable, anota en el log un mensaje de fallo sin datos personales y devuelve al usuario un aviso para reintentar o escribir por correo. Para estados de error usa 405, 403 y 400 en los casos previstos; el fallo de SMTP no genera un 5xx, sino un redireccionamiento 303 a una página de resultado con el mensaje. Esa página va connoindexysend.phpestá bloqueado enrobots.txt. - Un punto frágil que he comprobado. La función
asset()leeassets-manifest.jsonconJSON_THROW_ON_ERRORy sintry/catch, y varias plantillas leen sus datos igual. En una copia de las plantillas en mi entorno de pruebas, con el manifiesto roto, la portada devolvió unHTTP/1.0 500 Internal Server Errorcon el cuerpo vacío (servidor de PHP integrado condisplay_errorsdesactivado). En producción el resultado depende de la configuración del hosting, que no he podido ver. La lección práctica: un despliegue que corrompa ese JSON deja la web en 500 en todas las páginas a la vez. - Lo que no consta. No hay monitorización externa ni alertas definidas en el repositorio, ni un CDN, ni nada que cachee respuestas de error. No sé si el hosting reintenta, reinicia procesos o sirve una página propia.
Con esto, mi lista de pendientes es corta: una página de error estática con 503 para fallos controlados, un try/catch alrededor de la lectura del manifiesto de recursos y un monitor externo que vigile portada, una URL interior y robots.txt.
Cómo auditar los 5xx de cualquier sitio
- En Search Console, abre estadísticas de rastreo y mira el «Estado del host» y el porcentaje de respuestas «malas» en los últimos 90 días.
- En el informe de páginas, filtra el motivo «Error de servidor (5xx)» y exporta las URL.
- Pide el log de acceso y saca los 5xx de Googlebot por URL, día y hora con las consultas de arriba.
- Comprueba el
robots.txtconcurl -Iy confirma que responde 200 incluso cuando otras páginas fallan. - Revisa qué sirve el sitio cuando falla algo a propósito: simula un mantenimiento y comprueba que el estado es 503 y no 200.
- Mira si hay CDN o caché de página que guarde errores y cuánto tiempo.
Si el volumen de errores es alto o no encuentras la causa, entra de lleno en una auditoría técnica del servidor, porque suele mezclar hosting, aplicación y caché.
Preguntas frecuentes
¿Un error 500 perjudica el SEO?
Uno aislado, no. Según Google, los 5xx hacen que sus rastreadores bajen el ritmo temporalmente, y las URL indexadas que fallan de forma persistente acaban descartándose. Lo que cuesta es la repetición sobre las mismas URL durante días y el fallo en robots.txt.
¿Cuánto tiempo puede estar una web en 503 sin perder posiciones?
Google no da un plazo garantizado. Su documentación habla de 1-2 días para pausas con 503 y de «unos pocos días como máximo» para desactivar un sitio completo, con la advertencia de que la recuperación tras una desactivación larga no tiene fecha fija.
¿Es mejor un 500 o un 503 para mantenimiento?
Un 503 con Retry-After. Es el código que Google documenta para cierres temporales y admite indicar cuándo volver. El 500 es una respuesta genérica de fallo que no comunica que sea temporal.
¿Qué valor pongo en Retry-After?
La cabecera admite una fecha HTTP o un número de segundos, y Google recomienda una fecha o duración aproximada. Yo pondría la duración estimada del mantenimiento en segundos, por ejemplo 7200 para dos horas. Google no documenta qué hace si el valor es mayor de lo que espera.
¿Qué pasa si robots.txt devuelve un error 500?
Durante las primeras 12 horas Google deja de rastrear el sitio y sigue intentando leer el archivo. Después usa la última copia buena hasta 30 días. Pasado ese plazo, si la web está accesible actúa como si no hubiera robots.txt; si no, deja de rastrearla.
¿Por qué Search Console marca error de servidor si la URL carga bien?
Porque el error fue puntual o dependió del momento. La propia ayuda de Google indica que la prueba en vivo de inspección de URL puede funcionar aunque el rastreo real fallara. Revisa el log de esa hora y el estado del host en estadísticas de rastreo.
¿Hay que corregir una página con 5xx pidiendo la reindexación?
Primero se corrige la causa. Después, para pocas URL, usa la inspección de URL; para muchas, valida el error desde el informe de páginas de Search Console. Pedir validación sin arreglar la causa solo repite el fallo.
Fuentes
- Códigos de estado HTTP y su efecto en los rastreadores de Google Google Search Central
- Reducir la frecuencia de rastreo de Googlebot Google Search Central
- Pausar o desactivar temporalmente un negocio online Google Search Central
- Cómo interpreta Google las especificaciones de robots.txt Google Search Central
- Informe de estadísticas de rastreo Ayuda de Search Console
- Informe de indexación de páginas Ayuda de Search Console
- 503 Service Unavailable MDN
- Retry-After MDN