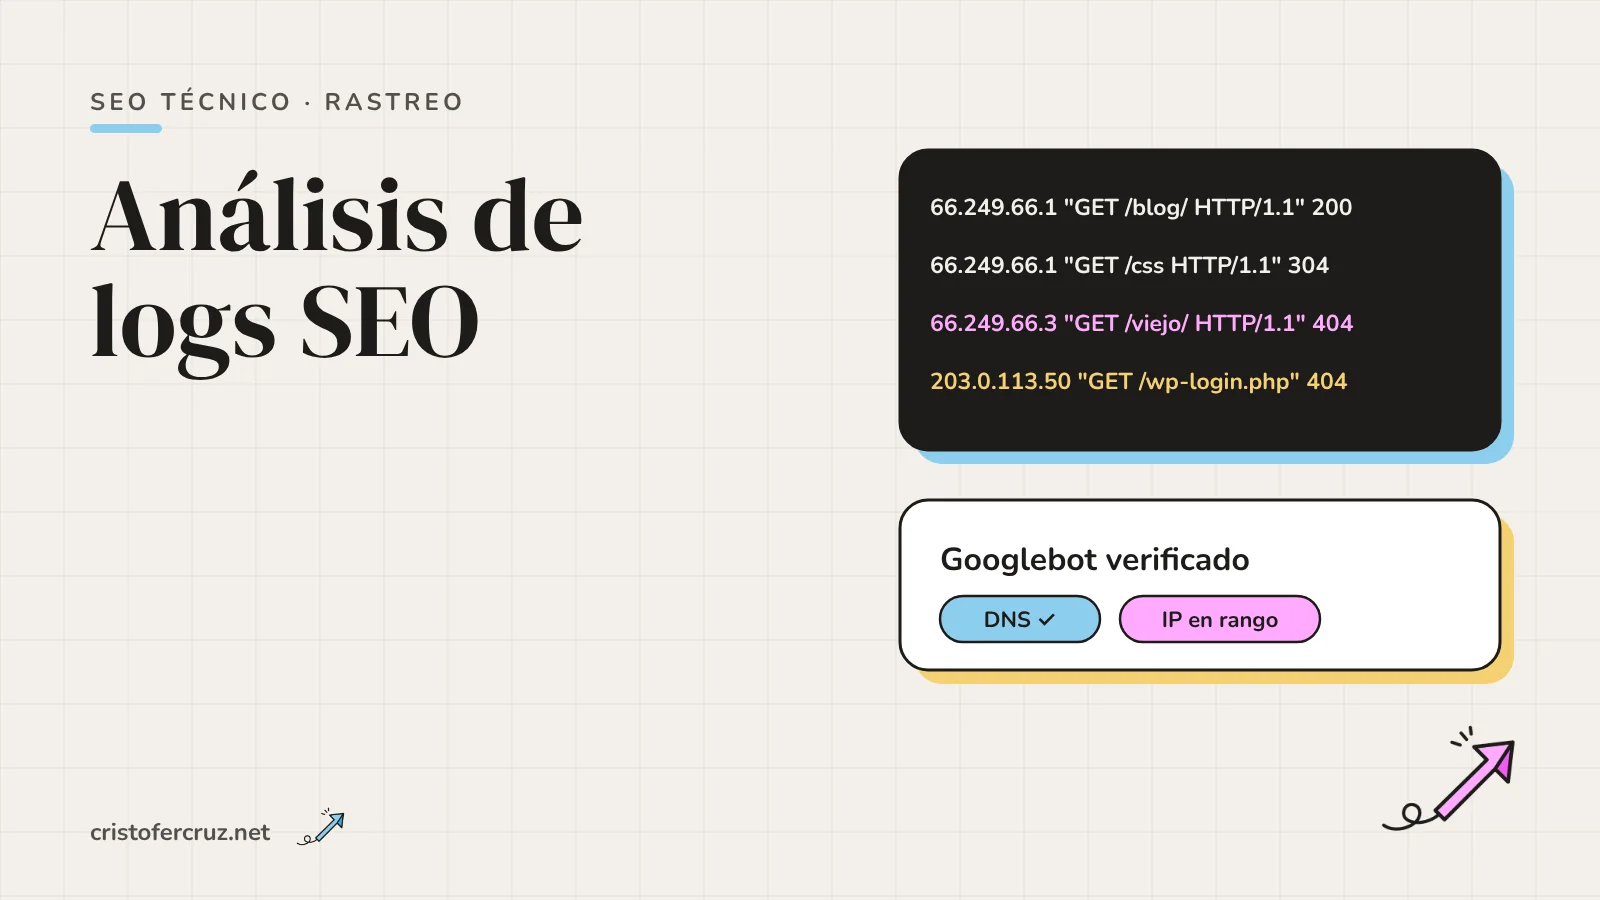
- El log de acceso del servidor es la única fuente que registra cada petición de Googlebot tal y como llegó; Search Console resume y muestra ejemplos, no todo.
- El user-agent se puede falsificar. Google documenta dos formas de verificar un rastreador: DNS inverso más DNS directo, o comparar la IP con sus ficheros JSON de rangos.
- Con el formato combinado de Apache y Nginx,
grepyawkbastan para sacar códigos de estado, URLs más rastreadas, parámetros y errores. - Cruzar las URLs rastreadas con el sitemap y el enlazado interno es la forma más directa de encontrar URLs huérfanas y rastreo desperdiciado.
- Los logs tienen límites: retención corta, CDN que sirve sin tocar el origen y ninguna información sobre qué indexa Google.
- Los bots de IA (GPTBot, ClaudeBot y otros) también aparecen en el log, y se verifican con las listas de IP que publican sus empresas.
Search Console te dice que Google rastrea tu web, pero no te enseña cada petición. Si quieres saber si Googlebot pierde el tiempo en filtros con parámetros, si sigue pidiendo una URL que da 404 desde hace meses o si el «Googlebot» que te llena el servidor es de Google, la respuesta está en el log de acceso. Es un fichero de texto, y casi nadie lo abre.
Aquí explico qué contiene cada línea, cómo comprobar que un rastreador es quien dice ser, qué preguntas responde y cómo se contestan con comandos que he ejecutado sobre un log de ejemplo, con sus límites. Al final, qué sé y qué no sé de los logs de mi propia web.
Qué es el análisis de logs SEO
El análisis de logs SEO (en inglés, log file analysis) consiste en leer los registros de acceso de tu servidor para ver qué peticiones hacen los rastreadores a tu web. Cada vez que alguien o algo pide una URL, el servidor anota una línea: quién, cuándo, qué pidió y qué respondió.
La diferencia con otras fuentes es de naturaleza. Un rastreador como Screaming Frog o Sitebulb simula cómo podría rastrear un bot. El informe de estadísticas de rastreo de Search Console resume lo que Google informa. El log registra lo que ocurrió en tu servidor, petición a petición. Google avisa en su propia ayuda de que los recuentos de ese informe pueden no coincidir con los de tus logs, porque algunas peticiones pueden no contarse, y de que las URL de ejemplo no son exhaustivas.
Esto encaja con el trabajo sobre crawl budget: sin logs puedes sospechar que Googlebot gasta peticiones en URLs que no te interesan; con ellos lo ves y lo cuantificas.
Anatomía de una línea de log
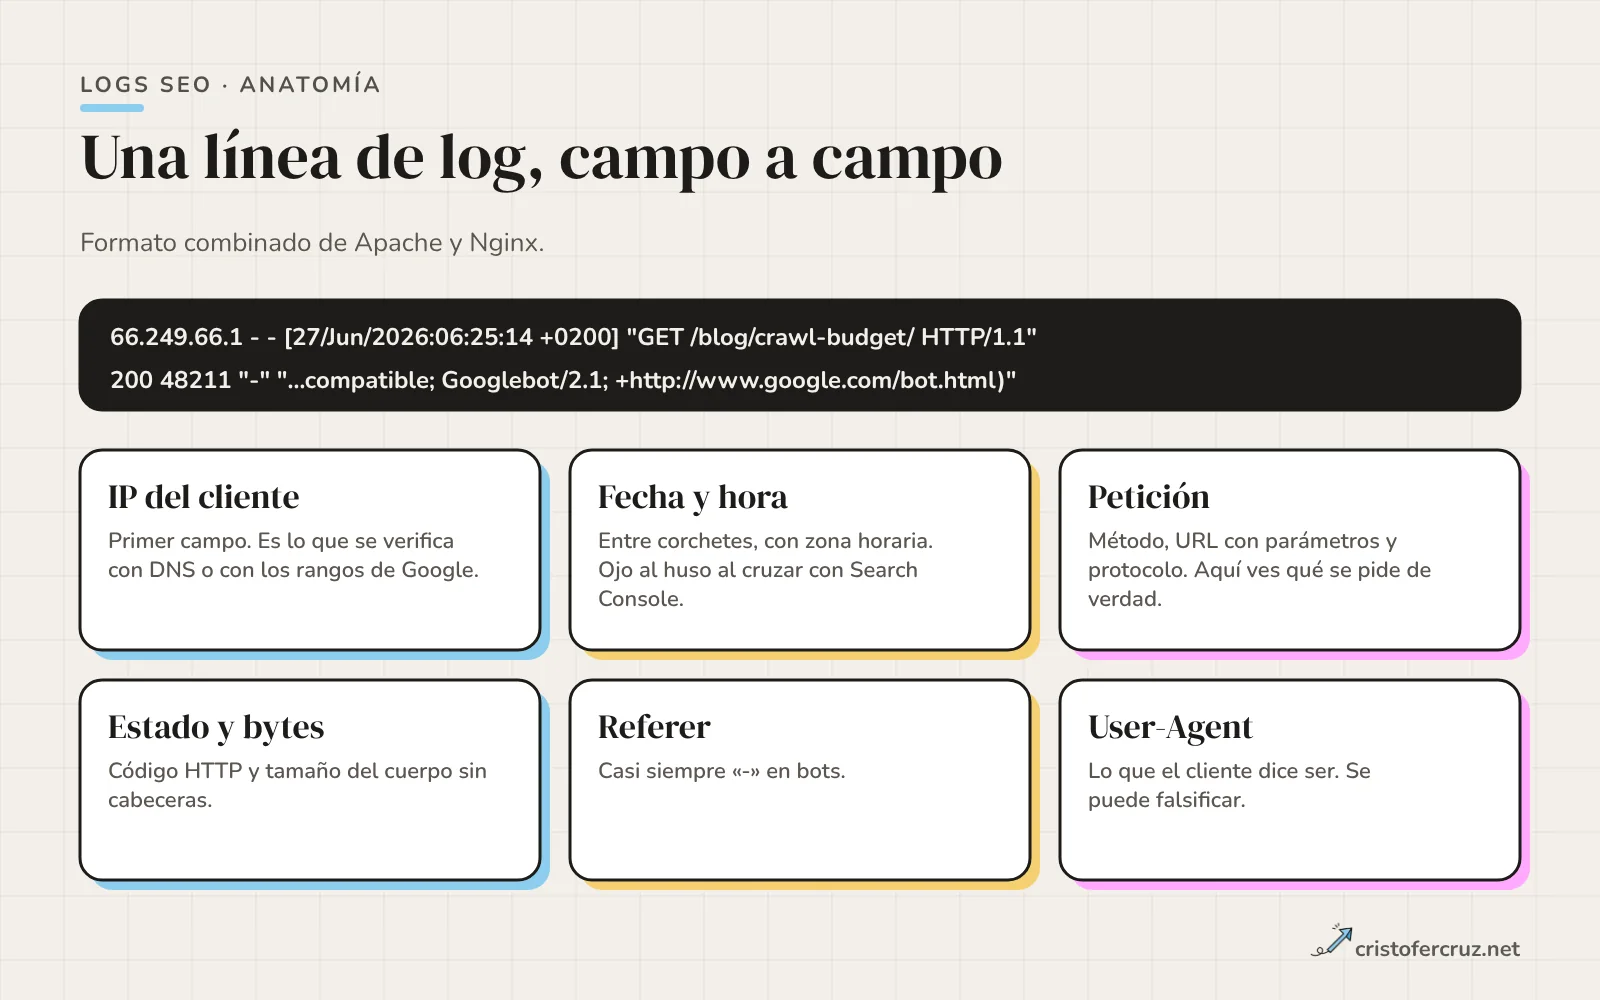
El formato más habitual es el combinado (combined). En Apache se define con LogFormat "%h %l %u %t \"%r\" %>s %b \"%{Referer}i\" \"%{User-agent}i\"" combined. En Nginx, combined es el formato predefinido y se usa cuando no indicas otro en access_log. Una línea de Googlebot en este formato se ve así:
66.249.66.1 - - [27/Jun/2026:06:25:14 +0200] "GET /blog/crawl-budget/ HTTP/1.1" 200 48211 "-" "Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0.0.0 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"| Campo | En la línea de ejemplo | Para qué sirve en SEO |
|---|---|---|
| IP del cliente | 66.249.66.1 | Verificar si el rastreador es real |
| Identidad y usuario | - - | Casi siempre vacíos (guion) en una web pública |
| Fecha y hora | [27/Jun/2026:06:25:14 +0200] | Frecuencia de rastreo y picos. Fíjate en la zona horaria |
| Petición | "GET /blog/crawl-budget/ HTTP/1.1" | URL exacta, con sus parámetros |
| Estado | 200 | Qué respondió el servidor: 200, 301, 304, 404, 5xx |
| Bytes | 48211 | Tamaño del cuerpo, sin cabeceras |
| Referer | "-" | En rastreadores suele ir vacío |
| User-agent | "…Googlebot/2.1…" | Qué dice ser el cliente. No es una prueba |
El user-agent de ese ejemplo es el de Googlebot Smartphone, el que alimenta la indexación mobile-first. Dos cautelas. La primera: la versión de Chrome del user-agent de Googlebot cambia con el tiempo; Google lo indica con un marcador Chrome/W.X.Y.Z y recomienda usar comodines al buscar en logs, así que busca Googlebot y no la cadena completa. La segunda: si tu servidor tiene un formato personalizado, o va detrás de un proxy que añade campos, las posiciones cambian. Mira siempre una línea antes de escribir un awk.
Cómo verificar que es Googlebot de verdad
Google es explícito: la cadena del user-agent HTTP puede falsificarse. En un log real hay scrapers, escáneres de vulnerabilidades y herramientas SEO que se presentan como Googlebot. Si no filtras por IP verificada, tus números de «rastreo de Google» incluyen tráfico que no lo es.
Verificación manual por DNS
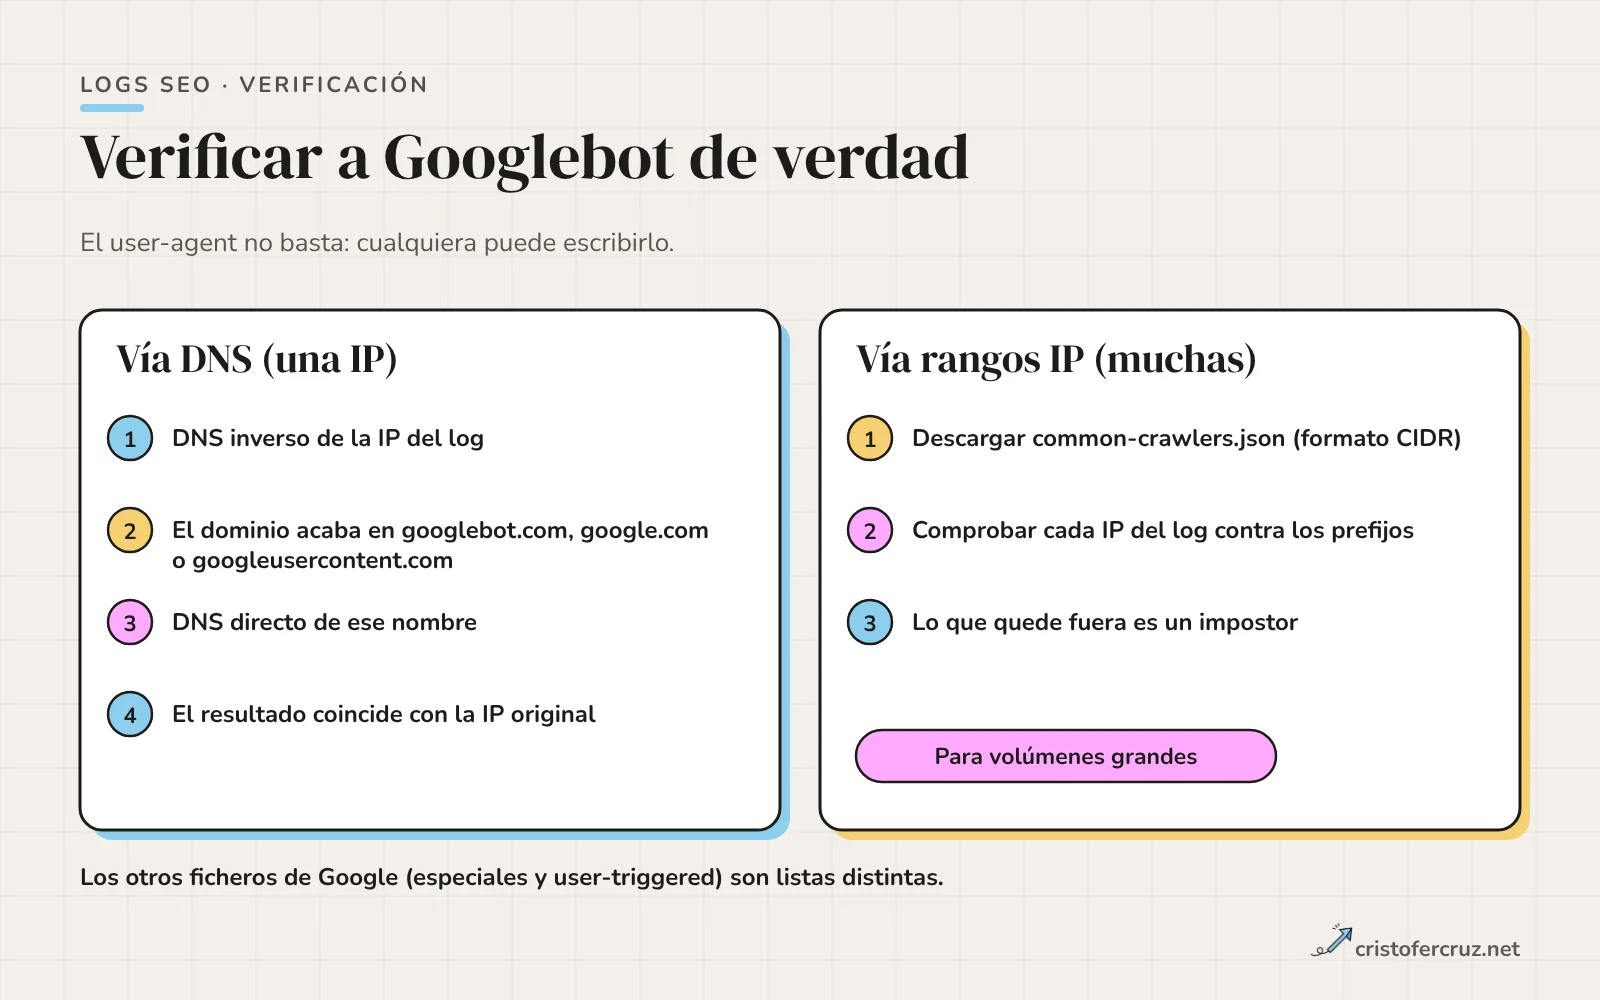
El procedimiento documentado por Google tiene cuatro pasos: hacer un DNS inverso de la IP del log, confirmar que el dominio devuelto pertenece a googlebot.com, google.com o googleusercontent.com, hacer un DNS directo de ese nombre y comprobar que el resultado coincide con la IP original. En un terminal con el comando host:
host 66.249.66.1
# el nombre devuelto debe terminar en googlebot.com
host nombre-devuelto
# la IP resultante debe ser 66.249.66.1
Para los rastreadores habituales, Google documenta nombres del tipo crawl-***-***-***-***.googlebot.com o geo-crawl-***-***-***-***.geo.googlebot.com. Los rastreadores de casos especiales aparecen como rate-limited-proxy-***-***-***-***.google.com y los fetchers lanzados por usuarios, con gae.googleusercontent.com o google-proxy-***-***-***-***.google.com. No he ejecutado estos comandos host sobre IP reales para este artículo: los reproduzco de la documentación.
Verificación por rangos IP
Con miles de líneas, hacer DNS por cada IP es inviable. Google publica ficheros JSON con sus rangos en formato CIDR en https://developers.google.com/static/crawling/ipranges/: common-crawlers.json (donde está Googlebot), special-crawlers.json, user-triggered-fetchers.json, user-triggered-fetchers-google.json y user-triggered-agents.json. Existe además una lista general en https://www.gstatic.com/ipranges/goog.json. La documentación no indica cada cuánto se actualizan los ficheros, así que descárgalos de nuevo cada vez que hagas un análisis.
El fichero tiene una clave creationTime y una lista prefixes con entradas ipv4Prefix o ipv6Prefix. Este script de Python (módulo estándar ipaddress) marca como falsa cualquier línea con «Googlebot» cuya IP no esté en esos rangos:
import ipaddress, json

redes = []
for p in json.load(open("common-crawlers.json"))["prefixes"]:
    redes.append(ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"]))

for linea in open("access.log"):
    if "Googlebot" not in linea:
        continue
    ip = ipaddress.ip_address(linea.split()[0])
    if not any(ip in r for r in redes):
        print("FALSO:", linea.split()[0], linea.split('"')[1])
Lo probé con un fichero de rangos de juguete (tres prefijos inventados) y un log de ejemplo con dos peticiones de una IP ajena que decía ser Googlebot: las marcó las dos y dejó pasar el resto. Con el JSON real de Google el resultado depende de tus datos.
Qué preguntas responden los logs
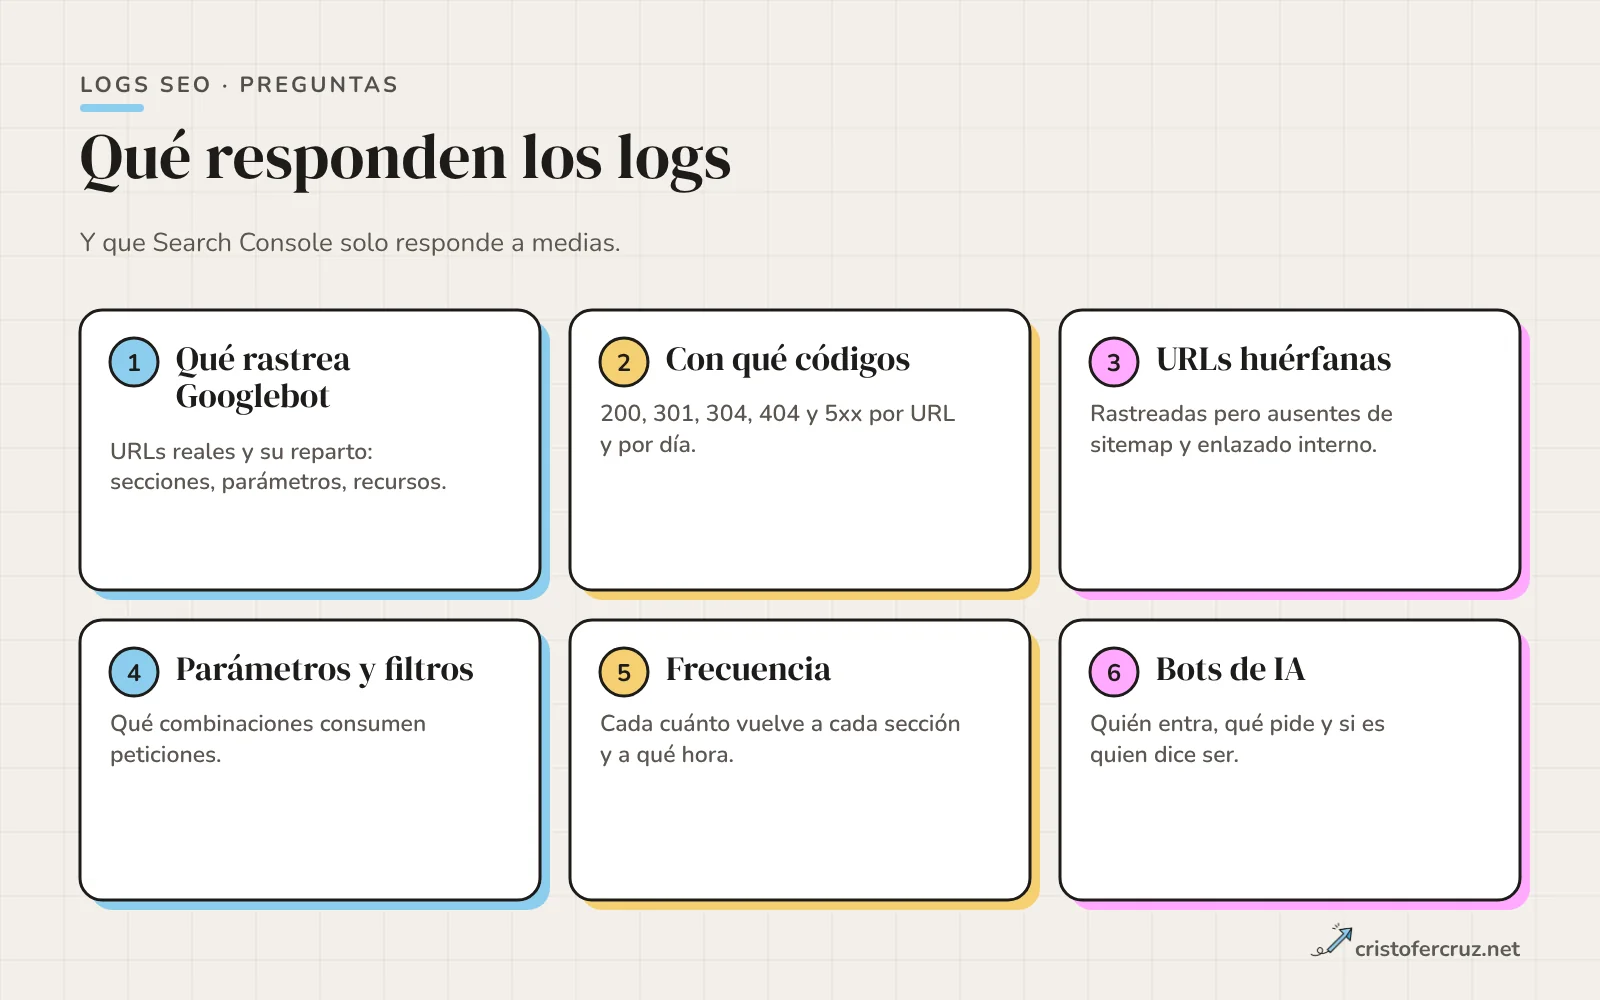
| Pregunta | Qué miras en el log | Qué decisión desencadena |
|---|---|---|
| ¿Qué rastrea Googlebot? | URLs más pedidas por secciones | Comprobar si el rastreo va a donde está el negocio |
| ¿Con qué códigos responde mi servidor? | Distribución de 200, 301, 304, 404 y 5xx | Corregir errores y cadenas de redirecciones |
| ¿Hay URLs huérfanas? | URLs rastreadas que no están en sitemap ni en el enlazado | Enlazarlas, redirigirlas o dejarlas morir |
| ¿Gasta rastreo en parámetros? | URLs con ? y sus combinaciones | Canonical, noindex o revisar el enlazado a filtros |
| ¿Cada cuánto vuelve? | Peticiones por día y por sección | Medir el efecto de un cambio o una migración |
| ¿Quién más me rastrea? | User-agents de bots de IA y otros | Decidir qué permitir en robots.txt |
Una aclaración sobre las URLs huérfanas: en un log solo ves las que Googlebot ha pedido, no las que existen y Google nunca ha visitado. Si Google pide una URL que ningún enlace interno apunta, la ha descubierto por un enlace externo, por un sitemap antiguo o porque la conoce de antes. Cualquiera de las tres es información útil.
Cómo obtener los logs
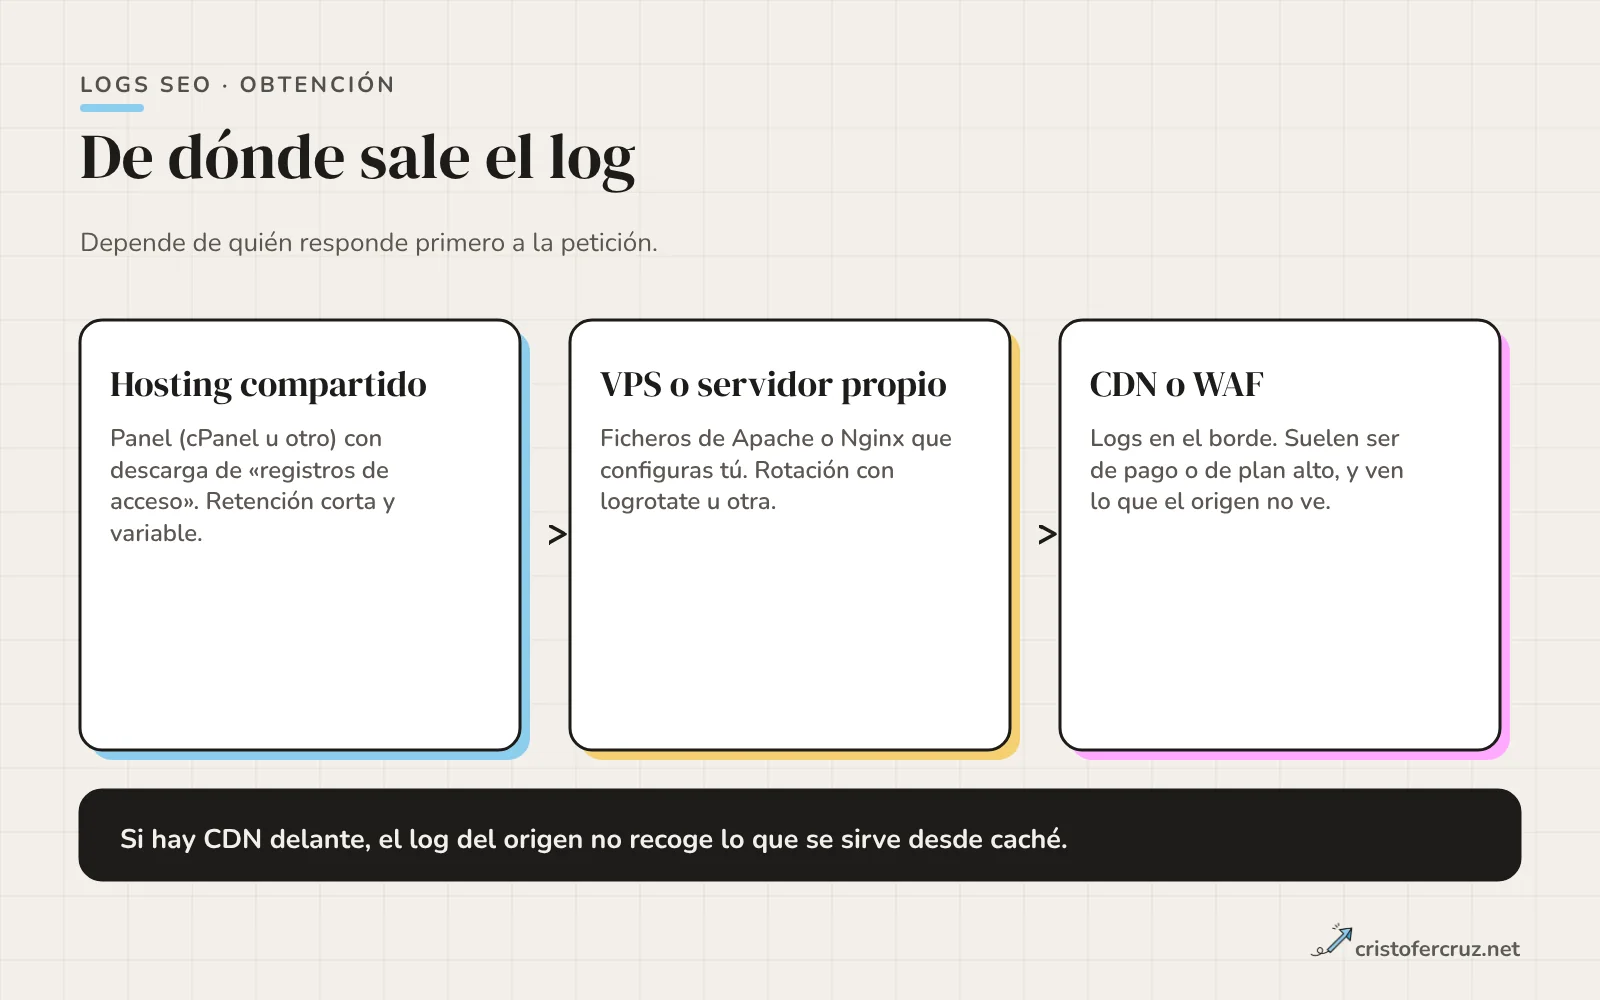
- Hosting compartido. Muchos paneles ofrecen descarga de los registros de acceso en bruto, a veces en un fichero comprimido por día. La retención varía de un proveedor a otro y no hay una norma: pregúntalo, o descarga el fichero cada semana.
- Servidor propio o VPS. Apache y Nginx escriben el log donde indique su configuración (
CustomLogen Apache,access_logen Nginx). La rotación y el borrado dependen de cómo lo hayas configurado. - CDN o WAF. Si hay un CDN delante, sus logs son los que ven todas las peticiones. Que los ofrezca y en qué plan depende del proveedor; compruébalo en su documentación.
Pide siempre al menos 30 días, y mejor 90, si el sitio es grande. Un día aislado no enseña patrones; la caída de rastreo tras una migración, por ejemplo, solo se ve comparando antes y después.
Herramientas para analizar logs
Hay tres niveles, y el sensato es empezar por el más sencillo que responda tu pregunta:
- Línea de comandos (
grep,awk,sort,uniq,comm). Gratis, rápida y suficiente para ficheros de cientos de miles de líneas y preguntas concretas. - Scripts propios en Python con pandas, o cargar el log en una base de datos o en BigQuery cuando hay millones de líneas y quieres cruzar con sitemap, Search Console o un rastreo.
- Herramientas dedicadas: Screaming Frog Log File Analyser, Semrush Log File Analyzer o plataformas de pago como Botify o JetOctopus. Aportan interfaz, segmentación y cruce con rastreos. No he comparado sus resultados entre sí, así que no te diré cuál es mejor.
Un análisis con grep y awk, paso a paso
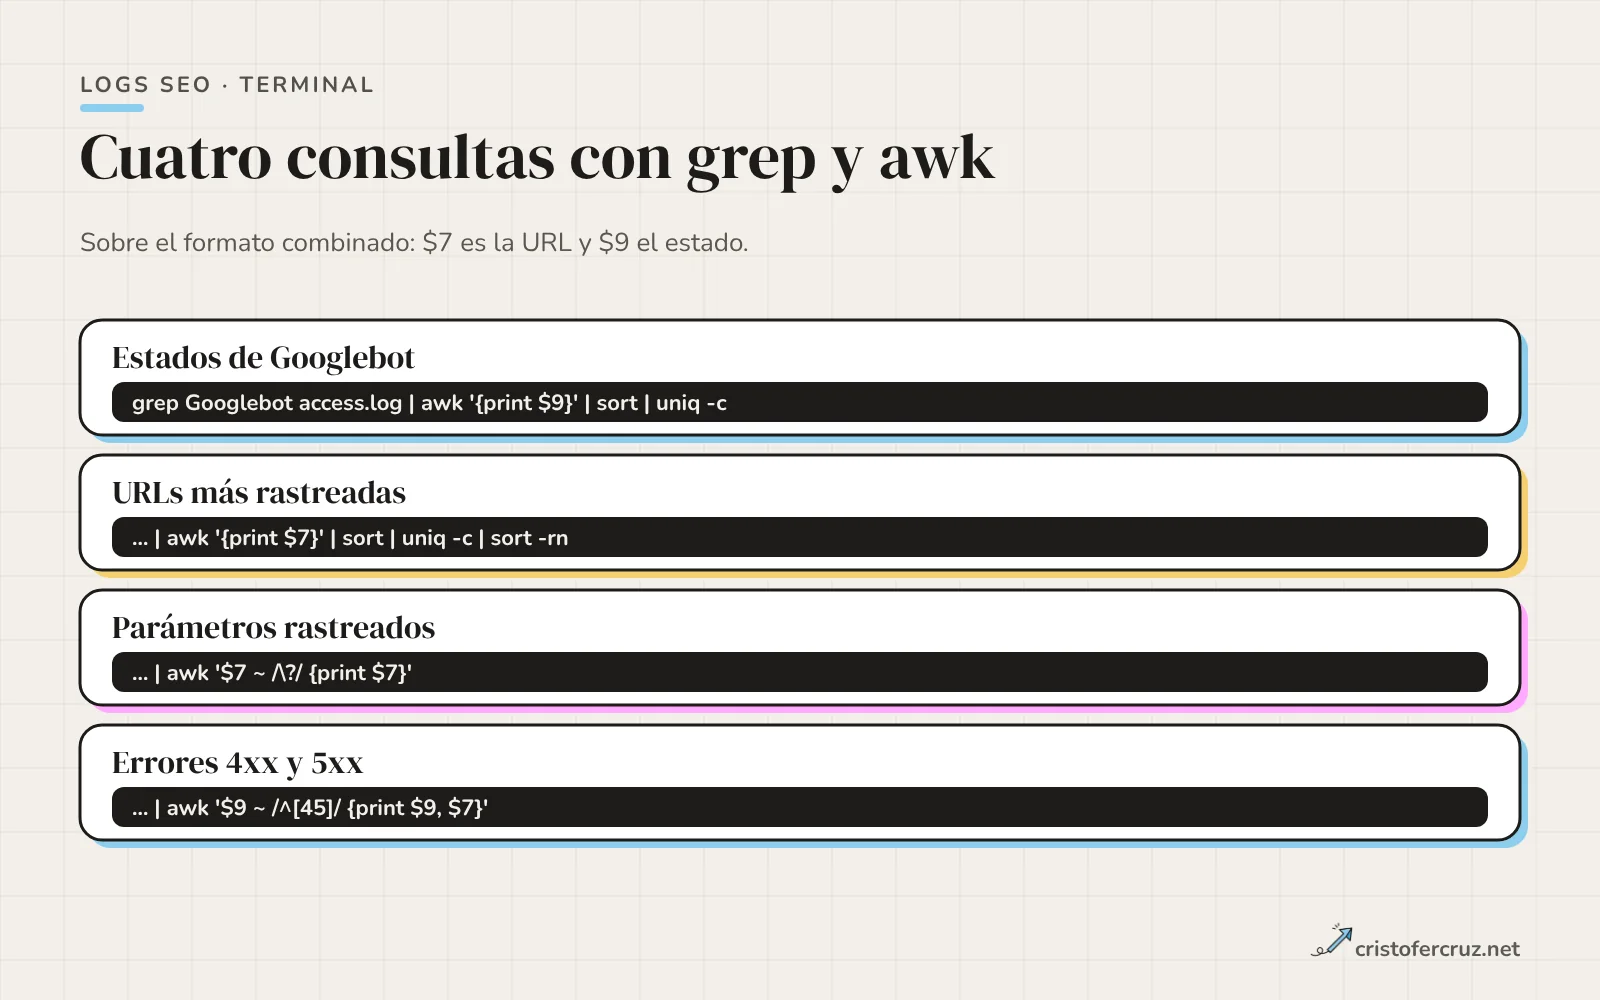
Generé un log de ejemplo de 16 líneas (datos inventados, con dos días, peticiones de Googlebot, una IP falsa, bots de IA y un usuario normal) y ejecuté todos los comandos sobre él. En el formato combinado, separando por espacios, $1 es la IP, $7 la URL y $9 el código de estado. Si tu formato es otro, ajusta las posiciones.
Códigos de estado que recibe Googlebot
grep "Googlebot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnResultado en mi log de ejemplo: 7 respuestas 200, 3 de 404, 1 de 500 y 1 de 304. En un log real, mira qué porcentaje no son 200 ni 304, y si el 304 aparece: significa que Googlebot está validando contra tu caché (más sobre eso en el artículo de caché y SEO).
URLs más rastreadas
grep "Googlebot" access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -20Agrupa por URL y ordena. Si las más pedidas son filtros, recursos o URLs que no te importan, ahí está el problema.
Parámetros rastreados
grep "Googlebot" access.log | awk '$7 ~ /\?/ {print $7}' | sort | uniq -c | sort -rnFiltra las URLs con interrogación. En mi ejemplo salen dos combinaciones de categoria y orden del listado del blog, cada una pedida una vez. En un sitio con cientos de combinaciones, este listado es el que justifica una decisión sobre canonical o enlazado.
Errores 4xx y 5xx
grep "Googlebot" access.log | awk '$9 ~ /^[45]/ {print $9, $7}' | sort | uniq -c | sort -rnEn el ejemplo: una URL antigua con 404 pedida dos días seguidos, una URL de WordPress inexistente con 404 y un 500 puntual en una página de servicio. Un 500 aislado no es un problema; los 5xx repetidos o concentrados en una franja horaria sí.
Frecuencia por día y IP que dicen ser Googlebot
grep "Googlebot" access.log | awk '{split($4,a,":"); print substr(a[1],2)}' | sort | uniq -c
grep "Googlebot" access.log | awk '{print $1}' | sort | uniq -c | sort -rn
El primero cuenta peticiones por día (extrae la fecha del campo $4); el segundo cuenta por IP. La lista de IP es la que pasas por el método de verificación: en mi ejemplo, una de las cinco no estaba en los rangos.
URLs rastreadas que no están en el sitemap
grep "Googlebot" access.log | awk '$9==200 {print $7}' | sort -u > rastreadas.txt
sort sitemap_urls.txt -o sitemap_urls.txt
comm -13 sitemap_urls.txt rastreadas.txt
Necesitas un sitemap_urls.txt con las rutas del sitemap (solo la ruta, igual que en el log). comm -13 deja las líneas que solo están en el segundo fichero: lo que Googlebot pidió con 200 y no figura en el sitemap. En el ejemplo salieron las dos combinaciones de filtros y una landing antigua sin enlaces. Que una URL no esté en el sitemap no la convierte en huérfana: cruza el resultado con tu enlazado interno antes de decidir.
Verifica las IP antes de sacar conclusiones. Un «Googlebot» falso que pide 5.000 URLs de filtros te hará diagnosticar un problema de rastreo que no existe.
Bots de IA en los logs
El log muestra algo que Search Console no cubre: quién más rastrea tu web. Las empresas de IA documentan sus agentes y varias publican las IP que usan.
| Bot | Empresa | Qué hace según su documentación |
|---|---|---|
| GPTBot | OpenAI | Rastrea contenido que puede usarse para entrenar modelos generativos |
| OAI-SearchBot | OpenAI | Para las funciones de búsqueda de ChatGPT |
| ChatGPT-User | OpenAI | Se activa por acciones de usuarios en ChatGPT y GPTs; no se usa para rastreo automático |
| ClaudeBot | Anthropic | Recoge contenido web que puede servir como datos de entrenamiento |
| Claude-User | Anthropic | Accede a webs cuando un usuario pregunta algo a Claude |
| Claude-SearchBot | Anthropic | Rastrea para mejorar la calidad de los resultados de búsqueda |
OpenAI publica listas de IP en openai.com/gptbot.json, openai.com/searchbot.json y openai.com/chatgpt-user.json; Anthropic, en claude.com/crawling/bots.json. Se aplica el mismo principio que con Google: el user-agent no basta. Para contarlos en tu log:
grep -E -o "GPTBot|ClaudeBot|OAI-SearchBot|ChatGPT-User|Claude-User|Claude-SearchBot" access.log | sort | uniq -cAnthropic advierte además de que bloquear sus IP puede no funcionar de forma persistente y recomienda robots.txt para gestionar el acceso. Qué permitir o bloquear es una decisión de negocio; el log te dice cuánto te piden y qué. Para el posicionamiento en respuestas de IA tienes este otro artículo.
Límites del análisis de logs
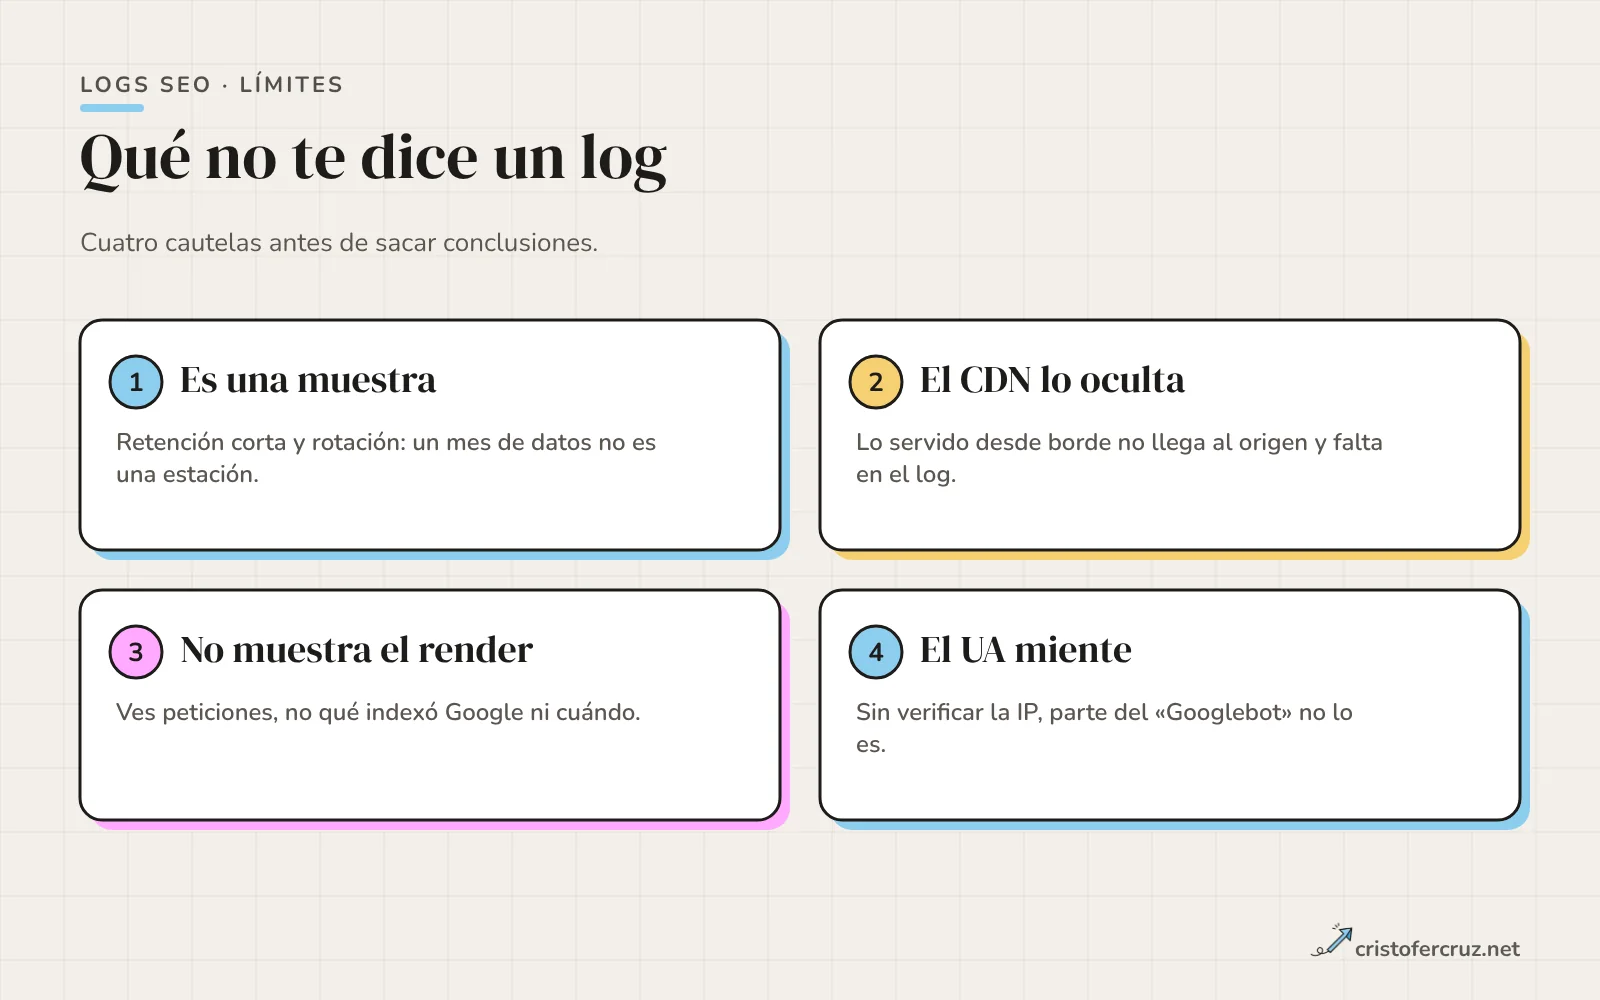
- Muestra temporal. Si el hosting rota o borra los logs, lo que tienes es una ventana corta. Evita sacar tendencias de una semana.
- CDN y caché. Si un CDN responde desde su borde, esa petición no llega al servidor de origen y no queda en su log. Un log de origen con CDN delante subestima el rastreo. Además, la IP que ves puede ser la del CDN y no la del cliente, salvo que el servidor esté configurado para registrar la cabecera con la IP original. Es un punto que debes confirmar con tu infraestructura.
- Peticiones, no indexación. Que Googlebot pida una URL no significa que la indexe. El formato combinado tampoco registra las cabeceras de respuesta, así que un
noindexenviado con la cabecera X-Robots-Tag no lo verás en el log. Tampoco muestra si ejecutó el JavaScript: ves las peticiones de recursos, no el renderizado (para eso, la inspección de URL en Search Console). - Diferencias con Search Console. Google reconoce que los recuentos del informe pueden diferir de tus logs. No intentes cuadrarlos al dato: usa cada fuente para lo que muestra.
- Datos personales. Una IP de usuario es un dato personal en muchos contextos. Si compartes logs con un tercero, filtra antes las líneas de usuarios o limítate a las de bots.
Cómo trato los logs en mi web
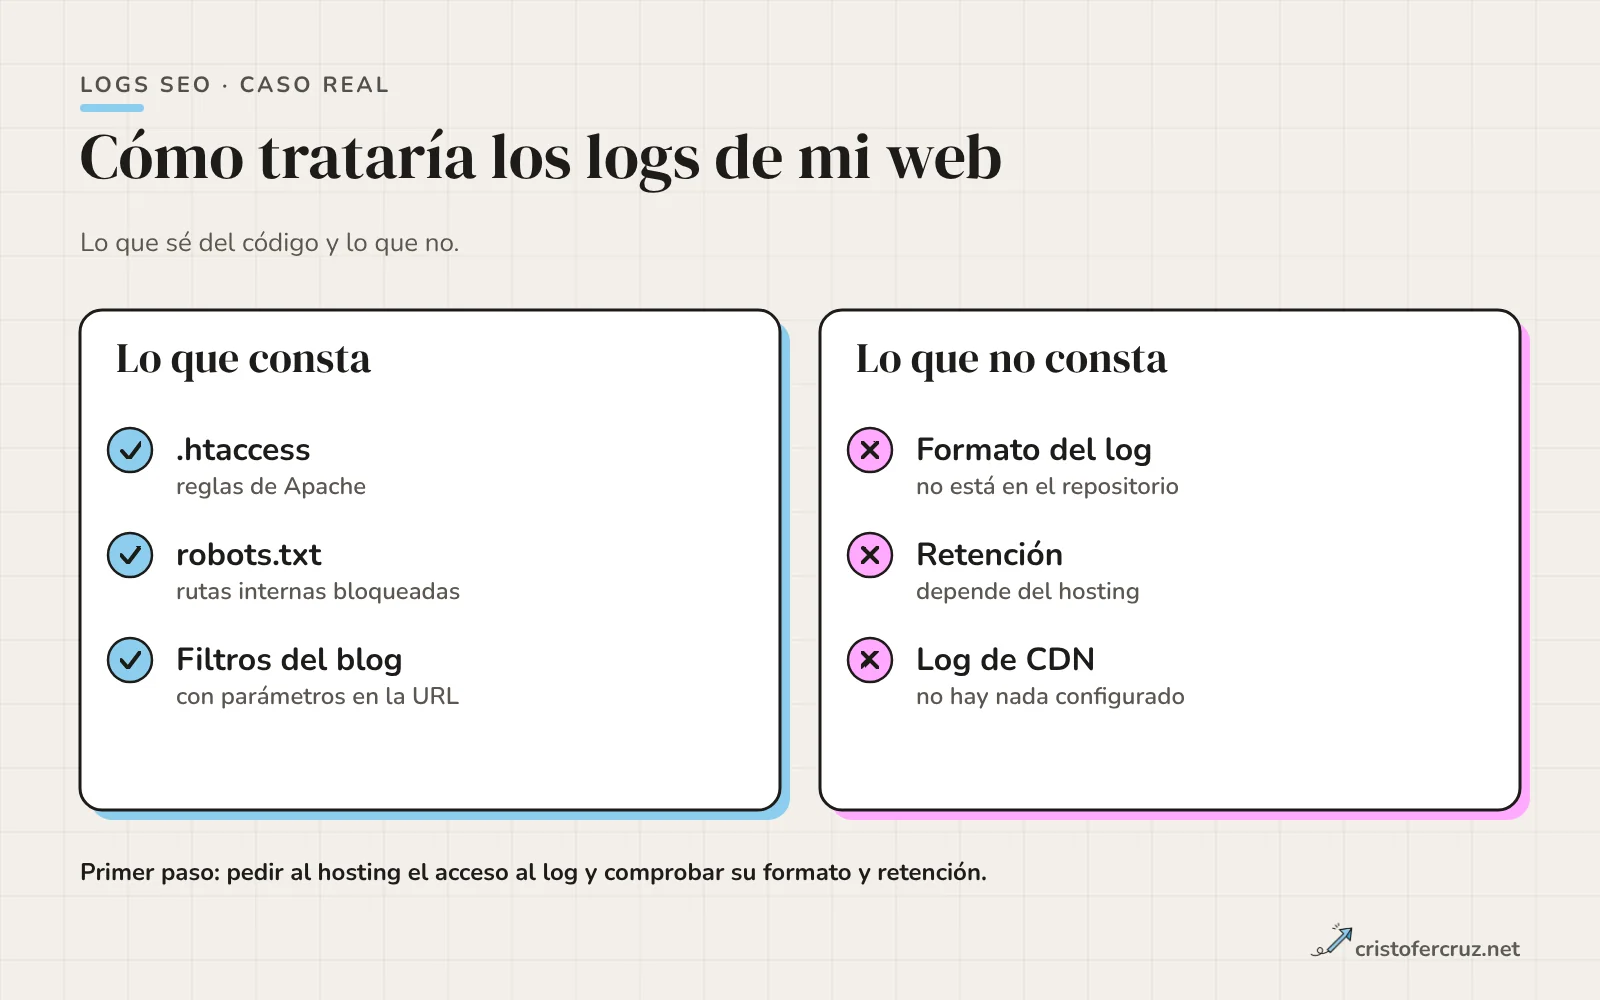
Esta es la parte donde más fácil sería inventar, así que voy por lo comprobado. El repositorio de cristofercruz.net tiene un .htaccess con directivas de Apache (mod_headers, mod_deflate, FilesMatch), de modo que el servidor es compatible con Apache. El código no define dónde se guarda el log de acceso, qué formato usa ni cuánto tiempo se conserva: eso lo decide el hosting, y no lo he documentado. Las únicas llamadas a error_log que veo en el código son las del formulario de contacto, que registran fallos de envío de correo, no peticiones. Tampoco hay ningún CDN configurado en el repositorio.
Lo que sí hay en el código y daría trabajo a un análisis de logs: el robots.txt de mi web bloquea carpetas internas (/includes/, /tools/, /PHPMailer/, /send.php…) y el comentario del propio fichero indica que no se bloquean los filtros, la búsqueda ni la paginación del blog, porque el servidor gestiona canonical y noindex según la URL. Es justo el tipo de decisión que un log permitiría verificar: si Googlebot pide combinaciones de filtros del blog y cuántas.
Mi plan, por tanto, es éste: pedir al hosting el acceso a los registros en bruto, comprobar con una línea el formato y los días que conservan, verificar las IP con los ficheros JSON de Google y pasar las consultas de arriba. Hasta que lo haga no tengo cifras de rastreo propias que enseñarte, y no voy a ponerlas. Si prefieres montar este análisis con acompañamiento, encaja en una consultoría SEO continua.
Cómo auditar tus logs en seis pasos
- Descarga al menos 30 días de logs de acceso y mira una línea para confirmar el formato.
- Filtra por «Googlebot» y verifica las IP con DNS o con
common-crawlers.json. Descarta las falsas. - Saca la distribución de códigos de estado. Anota 404, 5xx y redirecciones repetidas.
- Lista las URLs más pedidas por sección y las que llevan parámetros.
- Cruza con el sitemap y el enlazado interno para encontrar URLs rastreadas sin función.
- Repite al cabo de un mes de aplicar cambios y compara. Una sola foto no demuestra nada.
Guarda la consulta, no solo el resultado. Dentro de tres meses querrás repetirla con los mismos filtros para comparar, y recordar el awk exacto es más difícil de lo que parece.
Preguntas frecuentes
¿Qué es el análisis de logs SEO?
Es leer los registros de acceso del servidor para ver qué URLs piden Googlebot y otros rastreadores, con qué códigos de estado respondió tu web y con qué frecuencia. A diferencia de Search Console, muestra cada petición tal y como la registró tu servidor.
¿Cómo sé si un Googlebot del log es real?
Con DNS inverso de la IP, comprobando que el dominio termina en googlebot.com, google.com o googleusercontent.com, y DNS directo de ese nombre hasta que coincida con la IP. O comparando la IP con los ficheros JSON de rangos que publica Google.
¿Necesito herramientas de pago?
No para empezar. Con grep y awk puedes responder las preguntas básicas. Las herramientas dedicadas merecen la pena cuando hay millones de líneas, varios sitios o necesitas cruzar logs con rastreos y Search Console.
¿Cuántos días de logs necesito?
No hay una cifra oficial. Yo pediría un mínimo de 30 días para ver patrones y más si el sitio es grande o acabas de migrar. Un solo día no sirve para tendencias.
¿Los logs sirven si uso un CDN?
Sirven, pero incompletos. Lo que el CDN responde desde su caché no llega al origen. Si necesitas la imagen completa, pide los logs del CDN y confirma cómo registra la IP real del cliente.
¿Un log dice si Google indexa una URL?
No. Dice que Googlebot la pidió y qué respondió el servidor. Para saber si está indexada, usa la inspección de URL y el informe de páginas de Search Console.
¿Puedo ver los bots de IA en mis logs?
Sí, por su user-agent (GPTBot, ClaudeBot y otros). Como con Google, el user-agent no basta: OpenAI y Anthropic publican las IP que usan para poder comprobarlo.
Fuentes
- Verifying requests from Google's crawlers and fetchers Google Search Central
- Google's common crawlers Google Search Central
- Overview of Google crawlers and fetchers Google Search Central
- Crawl Stats report Ayuda de Search Console
- Log Files (Apache HTTP Server 2.4) Apache
- Module ngx_http_log_module Nginx
- Overview of OpenAI crawlers OpenAI
- Does Anthropic crawl data from the web? Anthropic