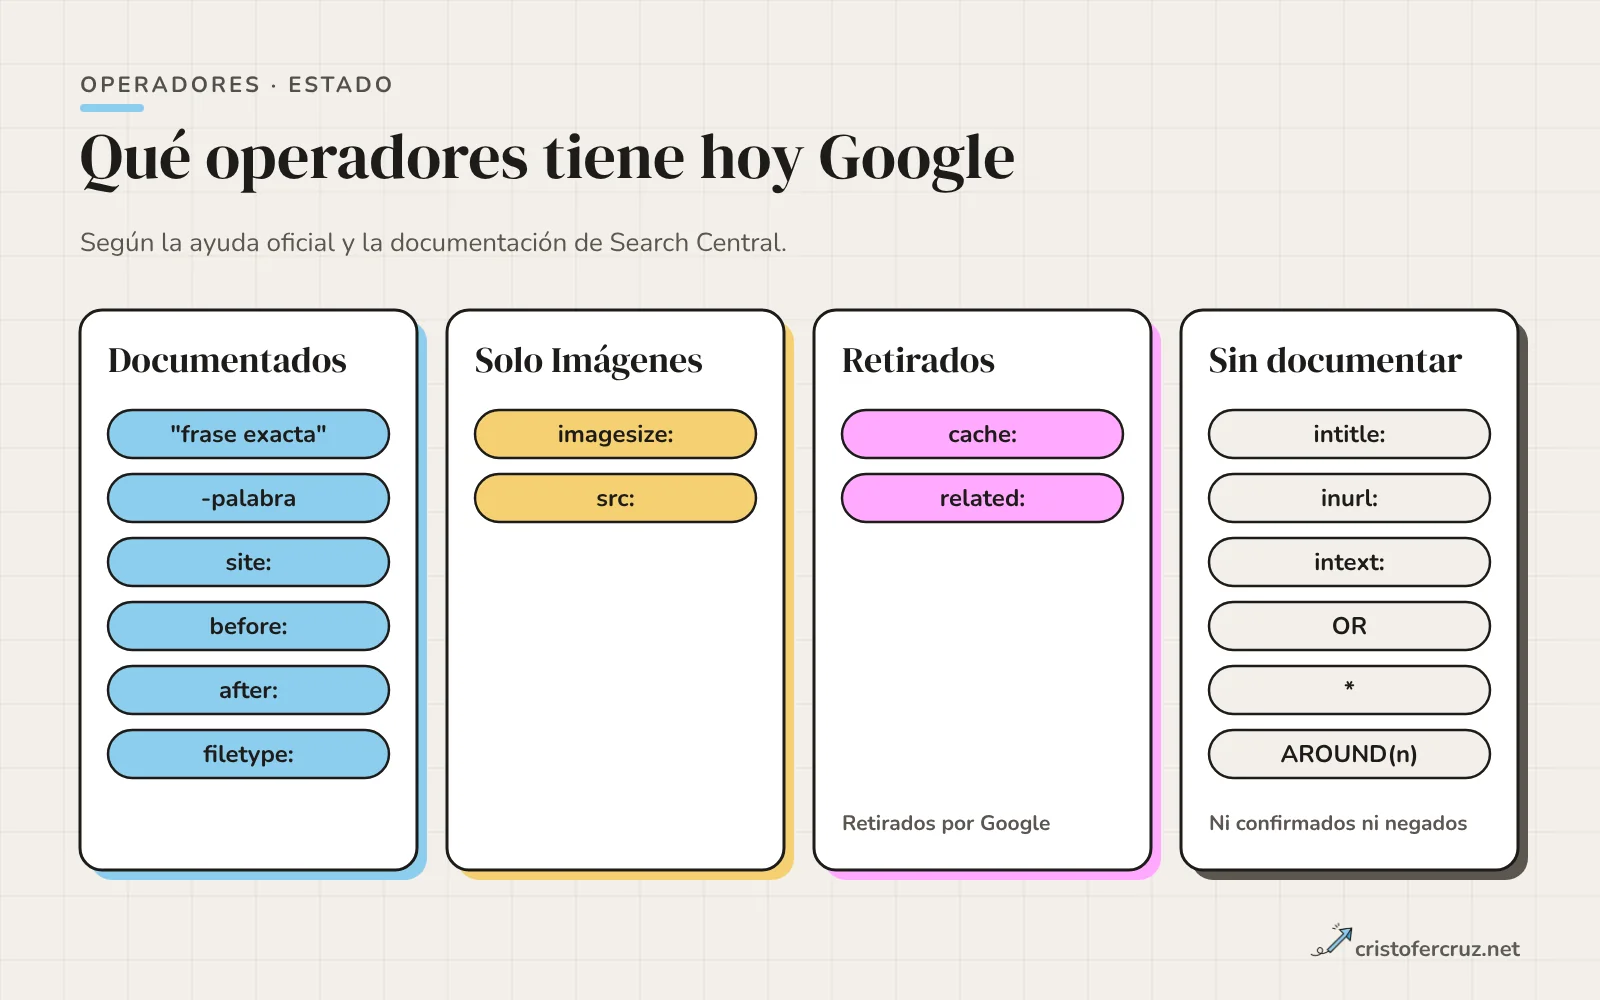
- La ayuda oficial de Google documenta hoy pocos operadores: frase entre comillas,
-,site:,before:,after:yfiletype:.cache:está retirado yrelated:salió de la documentación. intitle:,inurl:,intext:,OR,*yAROUND(n)no aparecen en esa ayuda. Pueden dar resultados, pero Google no los garantiza.site:no sirve para contar páginas indexadas: Google dice que la lista no es exhaustiva. Para eso, Search Console.- Un footprint es un patrón de consulta reutilizable. Los más útiles son los de auditoría de tu propio sitio: secciones, parámetros, duplicados, entornos de prueba y documentos.
- Automatizar consultas para extraer resultados incumple las políticas de spam y los Términos de Google; la prospección se hace a mano.
- Las consultas de este artículo son recetas: no las he lanzado en Google desde el entorno donde trabajo, así que no te enseño resultados.
Casi todos los artículos sobre operadores de búsqueda y footprints son listas de treinta o cuarenta comandos copiados de una versión anterior de la ayuda de Google. El problema es que parte de esa lista ya no funciona, parte nunca estuvo documentada y casi ninguno te explica qué pregunta responde cada consulta ni qué dato no puede darte.
Aquí separo lo documentado de lo que simplemente suele funcionar, explico los límites de site:, te dejo una tabla de footprints de auditoría para tu propio dominio, los usos de prospección con sus límites éticos y una forma de registrar las consultas para que los resultados se puedan comparar. Todo cuenta como receta, porque no he consultado Google para escribirlo.
Los operadores que Google documenta hoy
La página de ayuda de búsqueda de Google presenta los operadores como «algunos operadores populares» y lista estos: comillas, site:, -, before:, after: y filetype:. La documentación para webmasters en Search Central añade que filetype: busca por el encabezado content-type o por la extensión, y que imagesize: y src: solo funcionan en Google Imágenes.
| Operador | Qué hace según Google | Para qué lo uso en SEO |
|---|---|---|
"frase" | Coincidencia exacta de palabra o frase | Buscar un párrafo tuyo copiado en otras webs |
-palabra | Excluye una palabra | Quitar tu propio dominio de una búsqueda de menciones |
site: | Limita a un sitio o dominio | Ver qué rastros hay de una sección, un host o una URL |
before: y after: | Documentos actualizados antes o después de una fecha (año o fecha completa) | Acotar menciones o contenido de competidores por periodo |
filetype: | Un tipo de archivo concreto | Localizar PDF u hojas de cálculo publicados en tu dominio |
imagesize: y src: | Solo en Google Imágenes: dimensiones y URL de imagen referenciada | Encontrar dónde se usa una imagen tuya |
Dos reglas de sintaxis que Google repite: no se deja espacio entre el operador y el término (site: ejemplo.com no funciona) y el protocolo y el subdominio cuentan, porque site:https://www.ejemplo.com no equivale a site:https://ejemplo.com/. Esto último enlaza con lo que cuento en cómo tratar los subdominios en SEO: cada host es un ámbito distinto y conviene consultarlos por separado.
Operadores retirados y operadores sin documentar
Hay dos grupos que se mezclan en casi todas las guías.
Retirados
cache: dejó de funcionar: Search Engine Land informó el 24 de septiembre de 2024 de que Google lo había cerrado del todo, después de quitar en enero de ese año el enlace «En caché» de los resultados. Danny Sullivan ya había anticipado que el operador desaparecería. Qué hacer ahora para ver cómo ve Google una página lo detallo en la guía de caché para SEO: la respuesta es la Inspección de URLs.
related: es el segundo caso. En julio de 2023 Sullivan dijo que «no ha funcionado muy bien desde hace tiempo» y Google lo retiró de su documentación. Esa misma fuente señalaba que todavía devolvía resultados en aquel momento; no puedo decirte cómo se comporta hoy, y por eso no lo uso para encontrar competidores. link: y daterange: tampoco figuran en la ayuda actual, y las guías que los siguen presentando como válidos están desactualizadas.
Sin documentar
Aquí entran intitle:, inurl:, intext:, OR, el asterisco como comodín y AROUND(n). La ayuda oficial que he abierto no los menciona, ni para decir que funcionan ni para decir que se han retirado. Mi criterio: los uso porque son rápidos y sirven para orientarme, pero no construyo conclusiones ni informes a cliente sobre un resultado que dependa de ellos sin confirmarlo con una fuente que sí esté documentada (Search Console, un rastreo propio o los logs).
Hay una trampa extra: muchas guías hablan de allintitle:, allinurl: o inanchor:. Tampoco las he podido verificar contra documentación de Google, así que las trato igual.
site: y sus límites
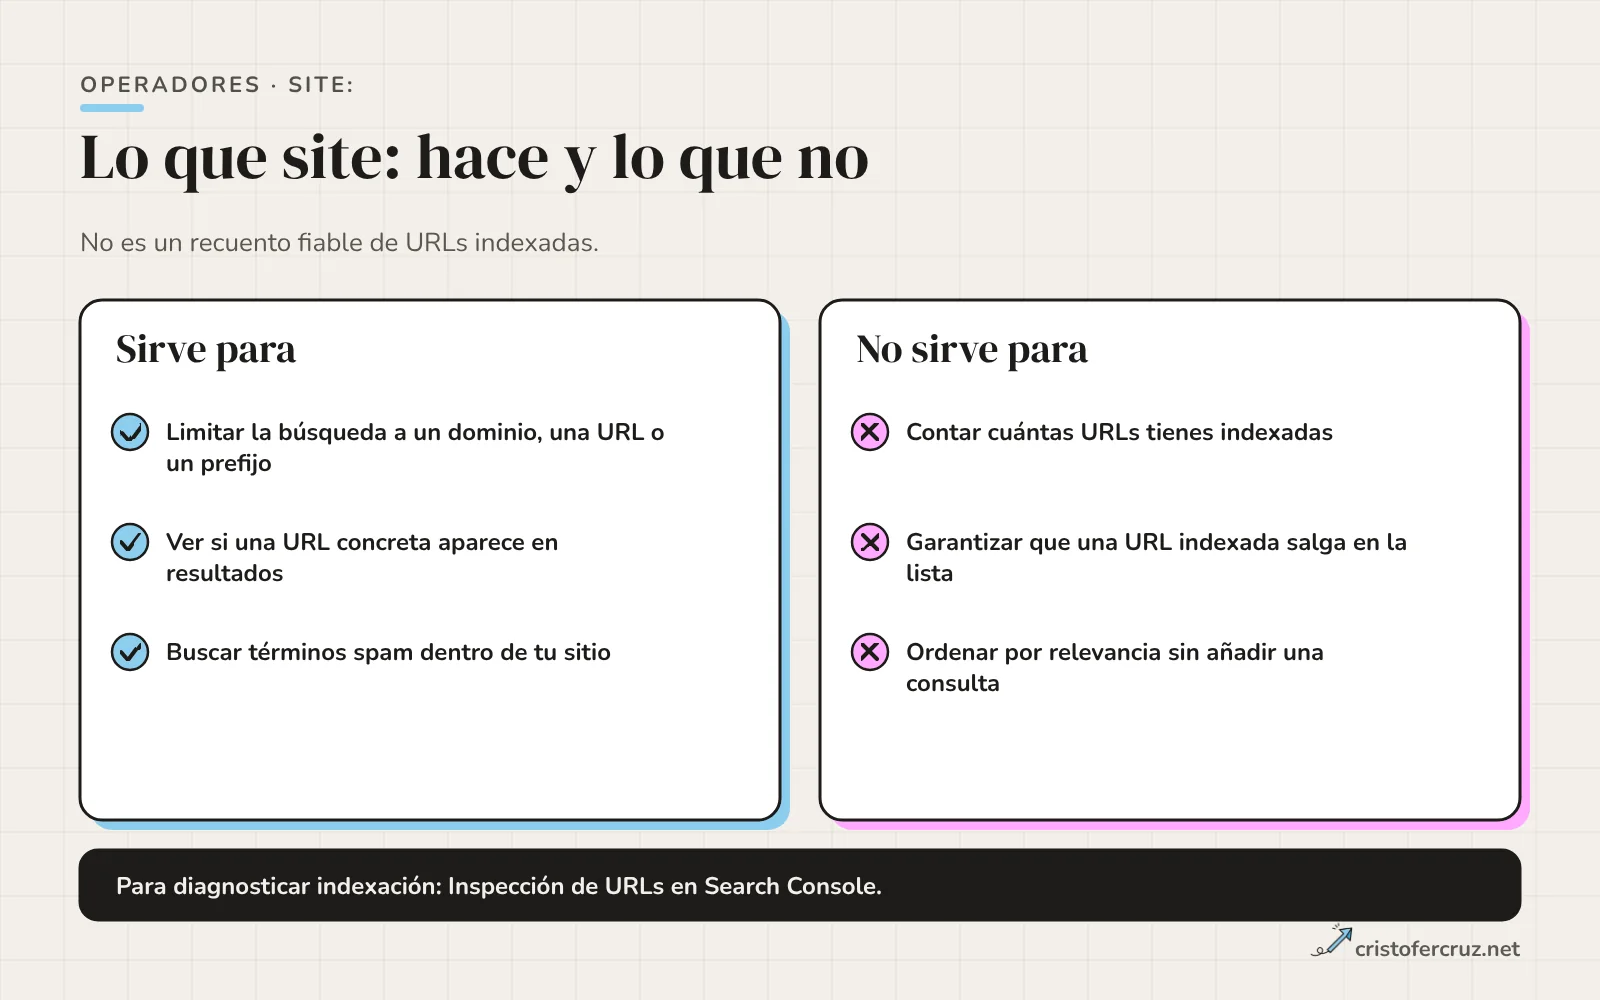
site: y lo que no debes pedirle.La página de Search Central sobre site: es clara. Una consulta site: pide resultados de un dominio, una URL o un prefijo. Si una URL está indexada, puede aparecer, pero «no está garantizado», y la lista de URLs devueltas «no siempre es exhaustiva». Sin términos de búsqueda no hay ranking: generalmente va primero la URL más corta y el resto es relativamente aleatorio. Y el operador se diseñó sobre todo para quien busca, no para contar URLs indexadas.
Gary Illyes lo resumió en el pódcast Search Off the Record en 2023: «el site: me muestra algunas de las páginas que están indexadas». Esa frase es toda la política de Google sobre el tema. Un «Aproximadamente 1.230 resultados» no es un dato que pueda ir a una presentación.
| Quiero saber | Con site: sirve | Mejor herramienta |
|---|---|---|
| Si una URL concreta está indexada | Orientativo | Inspección de URLs de Search Console |
| Cuántas páginas tengo indexadas | No | Informe de indexación de páginas |
| Si hay URLs que no he creado | Sí, como alerta | Site: más rastreo y logs para confirmar |
| Qué hosts tienen rastro | Sí, uno a uno | Propiedad de dominio en Search Console |
Si site: no te devuelve una URL, Google recomienda la Inspección de URLs para saber si puede indexarse. La ausencia en site: no es un diagnóstico.
Qué es un footprint y cómo se construye
Un footprint es un patrón de consulta que reutilizas porque identifica un rasgo repetible: una estructura de URL, una frase de plantilla, un tipo de archivo. No es un concepto de Google ni un operador: es una forma de usar los operadores. La anatomía casi siempre tiene tres partes.
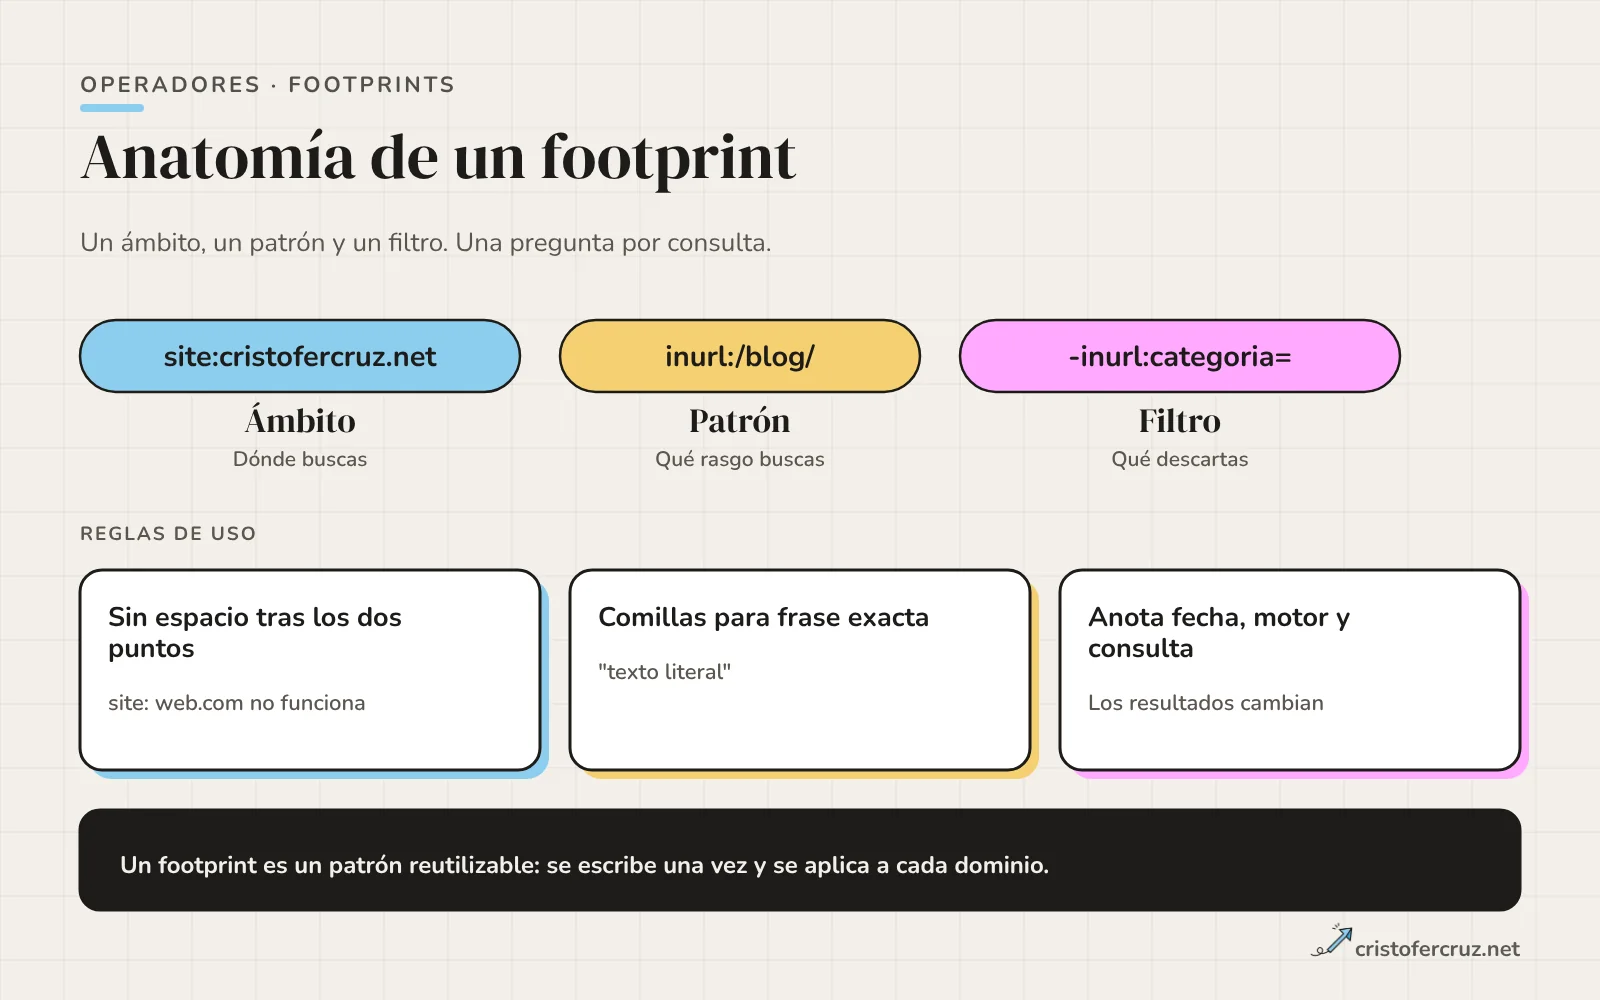
- Ámbito. Dónde buscas:
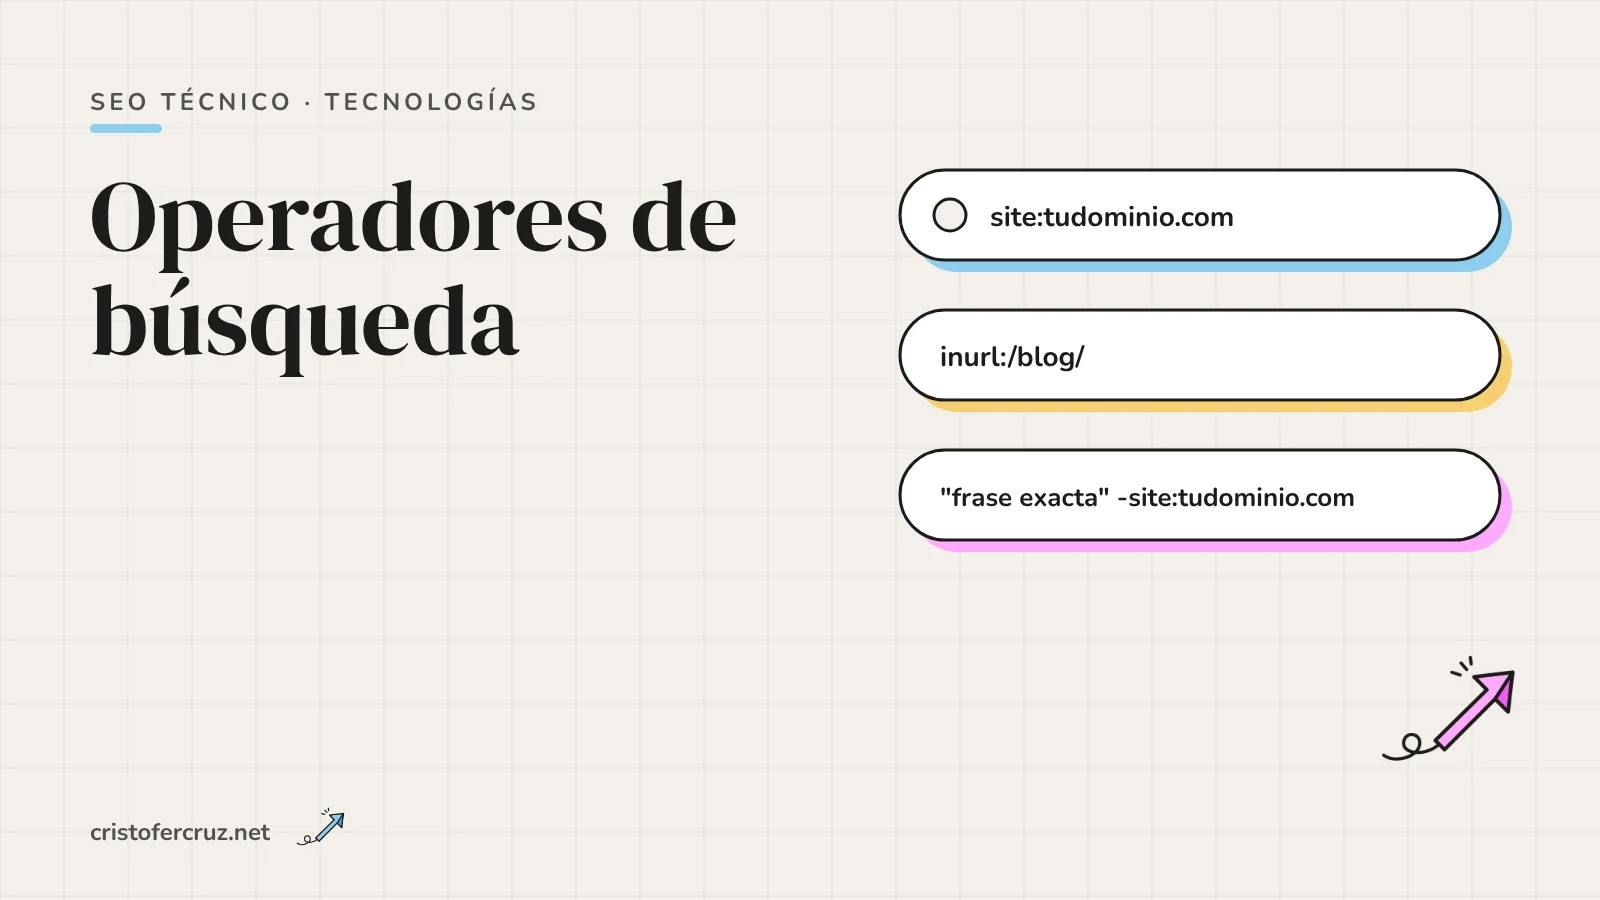
site:tudominio.compara auditar, o ningúnsite:para mirar fuera. - Patrón. El rasgo que quieres encontrar:
inurl:/blog/, una frase entre comillas,filetype:pdf. - Filtro. Lo que descartas para reducir ruido:
-inurl:categoria=o tu propio dominio con-site:.
Mi norma práctica es una pregunta por consulta. Si una consulta mezcla cinco operadores, cuando devuelve poco no sé qué parte la ha vaciado. Y si necesitas un patrón con alternativas o comodines sobre muchas URLs, el operador se queda corto: ahí entran las expresiones regulares de Search Console o de un rastreador, que explico en regex, XPath y selectores para SEO.
Footprints de auditoría sobre tu propio sitio
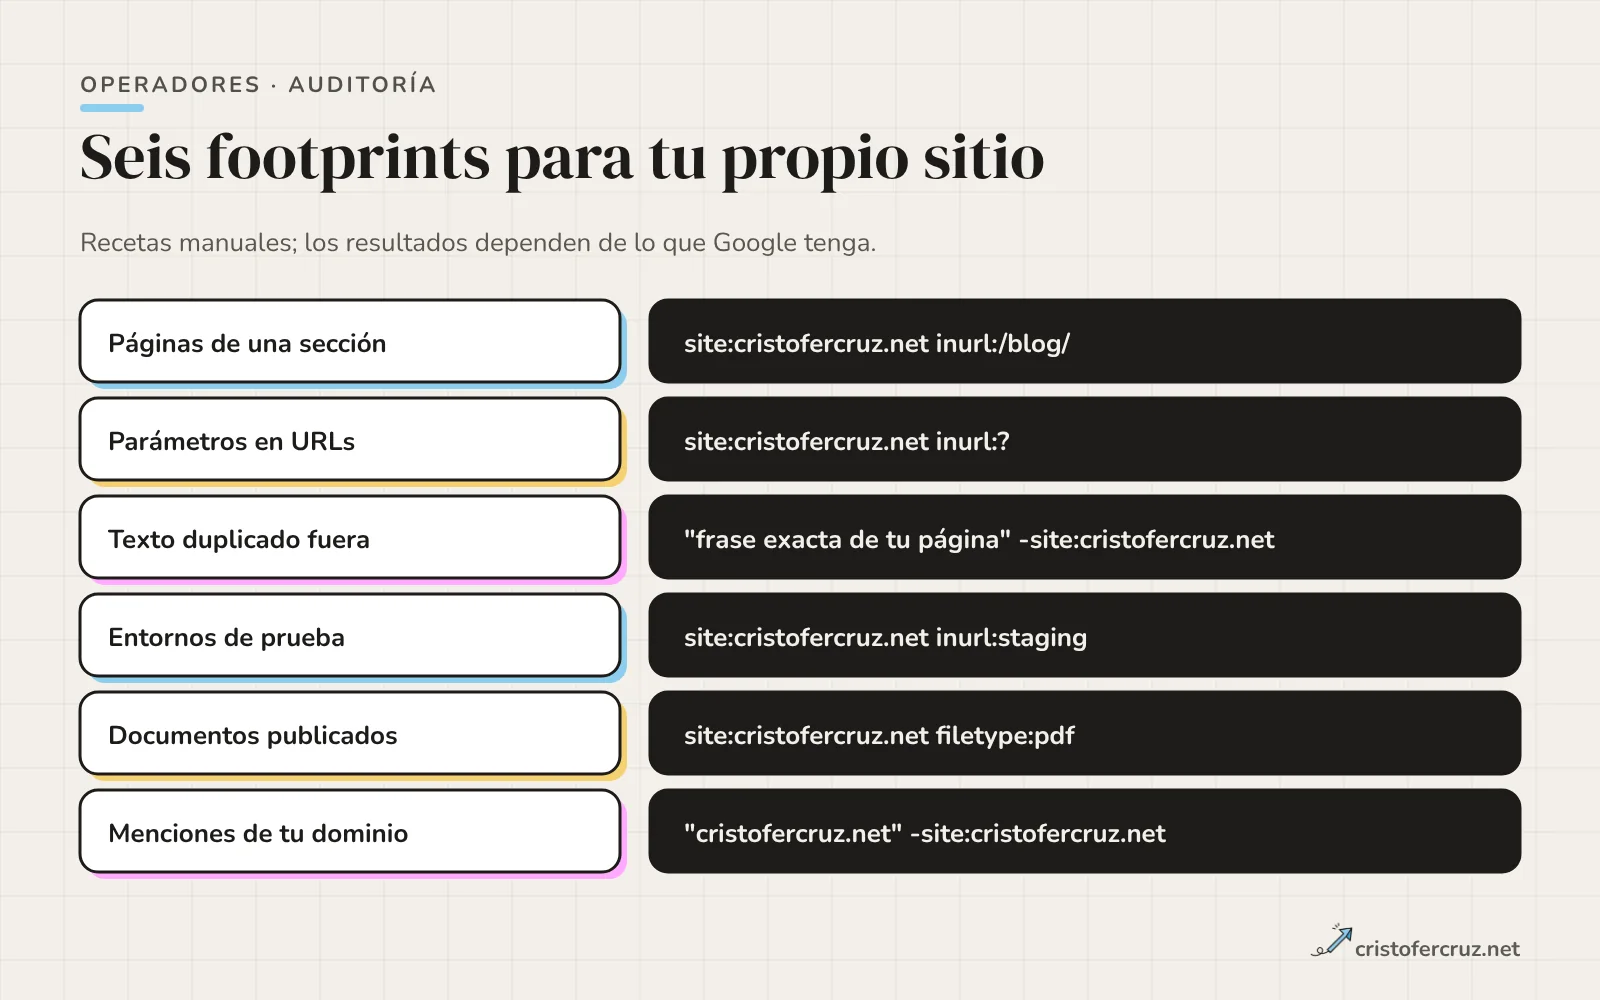
Estas son las que repito en casi todas las revisiones. Ninguna sustituye a un rastreo ni a Search Console; sirven para detectar rápido lo que no esperabas.
| Pregunta | Consulta | Cómo la leo |
|---|---|---|
| ¿Qué hay de una sección? | site:tudominio.com inurl:/blog/ | Si salen URLs que no reconoces, o la sección no aparece, investigo |
| ¿Se indexan parámetros? | site:tudominio.com inurl:? | Cualquier URL con parámetros indexada merece una revisión de canonical y noindex |
| ¿Alguien copia mi texto? | "una frase exacta y poco común" -site:tudominio.com | Elijo una frase de unas 10-12 palabras que solo tú escribirías |
| ¿Hay entornos de prueba? | site:tudominio.com inurl:staging o inurl:dev | Una URL de pruebas indexada se protege o se retira |
| ¿Hay documentos expuestos? | site:tudominio.com filetype:pdf | Reviso que cada archivo sea público a propósito |
| ¿Quién me menciona? | "tudominio.com" -site:tudominio.com | Menciones con y sin enlace: se separan a mano |
Parámetros y duplicados
Si inurl:? te enseña URLs con parámetros, el siguiente paso no es bloquearlas en robots.txt a ciegas. Primero compruebas qué señal llevan (canonical, noindex, ninguna) con lo que cuento en la guía de canonicals. Con la frase entre comillas pasa algo parecido: encontrar tu texto en otro dominio no es una sanción, es un dato que decide si pides retirada, enlazas con canonical entre dominios o lo ignoras.
Entornos de prueba y documentos
Para los entornos de pruebas, la solución buena es protegerlos con contraseña; Google lo cita como opción permanente para retirar contenido, junto con quitar el contenido o usar noindex. Una consulta site: no te avisará de un staging en otro dominio, así que también conviene revisar a mano los subdominios que existan (DNS, certificados) y comparar con lo que declaras en tu sitemap XML: lo que está indexado y no figura en él merece una mirada.
Menciones, competencia y prospección de enlaces
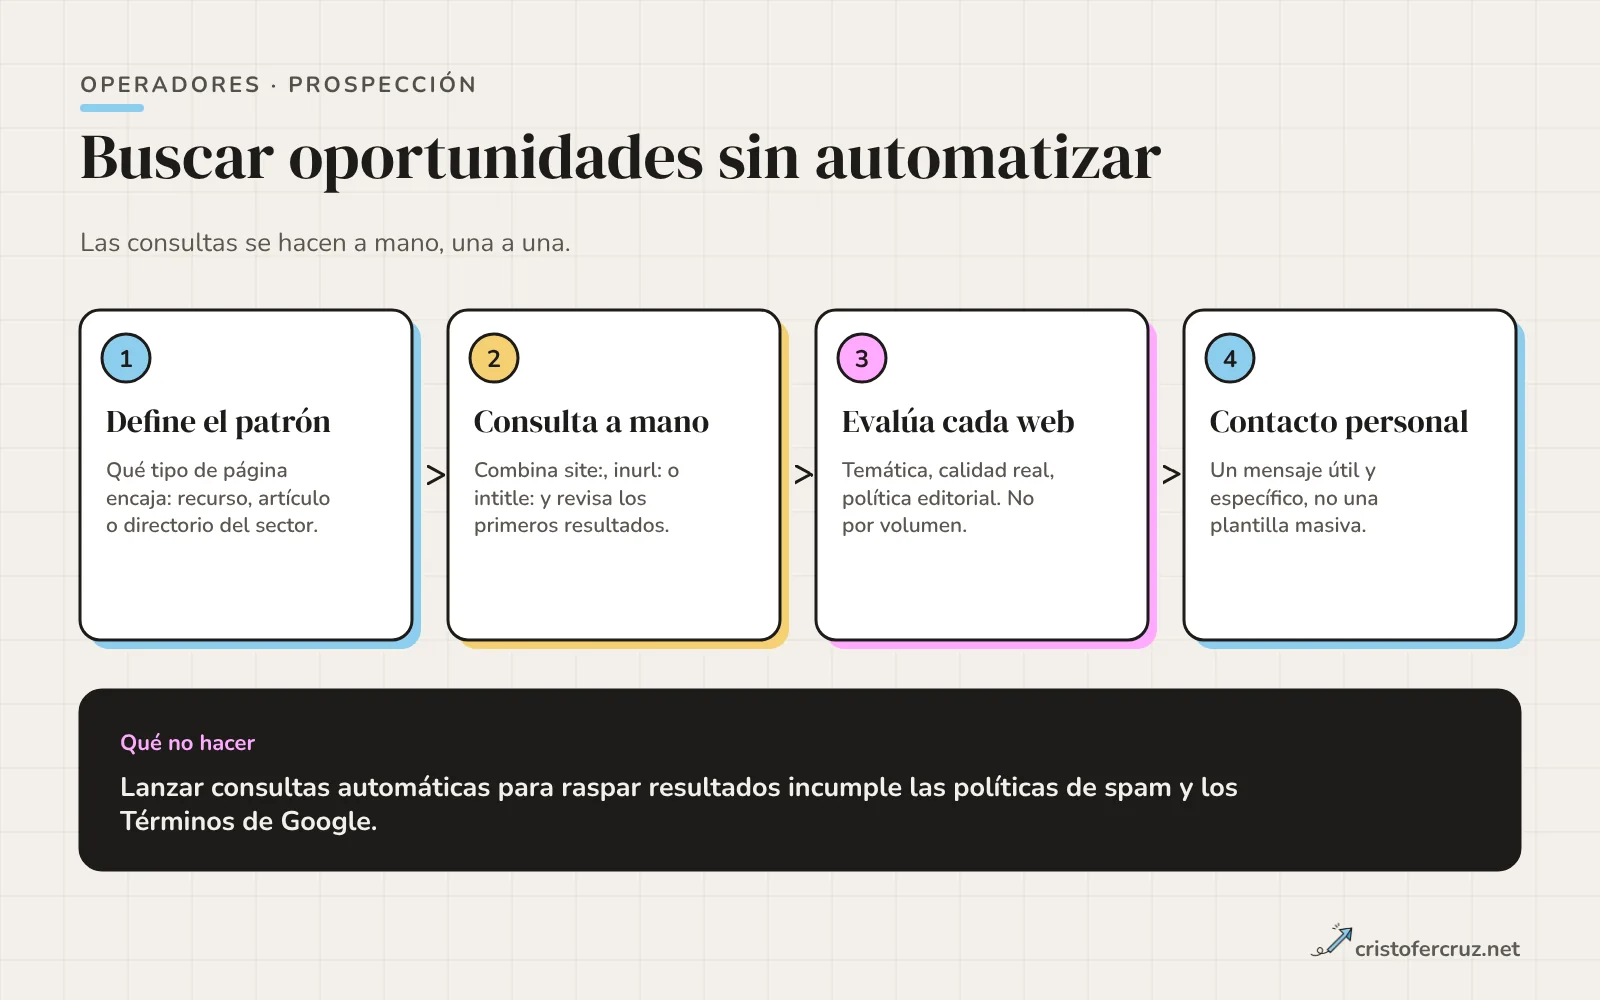
Los footprints de prospección son los más repetidos en internet y los que peor envejecen. La versión útil es más modesta que la lista de «cien footprints de link building».
- Menciones sin enlace.
"nombre de tu marca" -site:tudominio.comy revisión manual de qué páginas lo enlazan. Si no enlazan, pides el enlace con un mensaje personal. - Competencia por tema.
intitle:"guía de" "tu tema"muestra qué páginas se titulan para una búsqueda. Lo uso al empezar un keyword research para ver quién compite por el término, aunque el orden de resultados no sea fiable. - Páginas de recursos.
inurl:recursos "tu tema": sirve para identificar páginas que enlazan a materiales como el tuyo. No te dice si merece la pena pedir nada.
Detrás de cada una hay un filtro humano: temática, calidad real, política editorial y relevancia para tu audiencia. Cuando lo hago como servicio de link building, el operador solo genera la lista de candidatos y lo importante pasa después. Y los footprints de «deja un comentario» o de «perfiles con enlace» que algunas guías recomiendan son justo lo contrario de lo que quiero para una web.
Por qué no automatizar estas consultas
En su política de spam, Google define como «tráfico generado por máquina» el envío de consultas automáticas, e incluye como ejemplo extraer resultados para comprobar posiciones sin permiso expreso. Dice que esas prácticas violan sus políticas de spam y los Términos de servicio de Google. La consecuencia práctica: las herramientas que lanzan miles de consultas contra la SERP son un riesgo que asumes tú, no una técnica; para volumen, usa las fuentes con API o con permiso (Search Console, plataformas con datos propios) y reserva los operadores para el trabajo manual.
Bing y DuckDuckGo: solo lo documentado
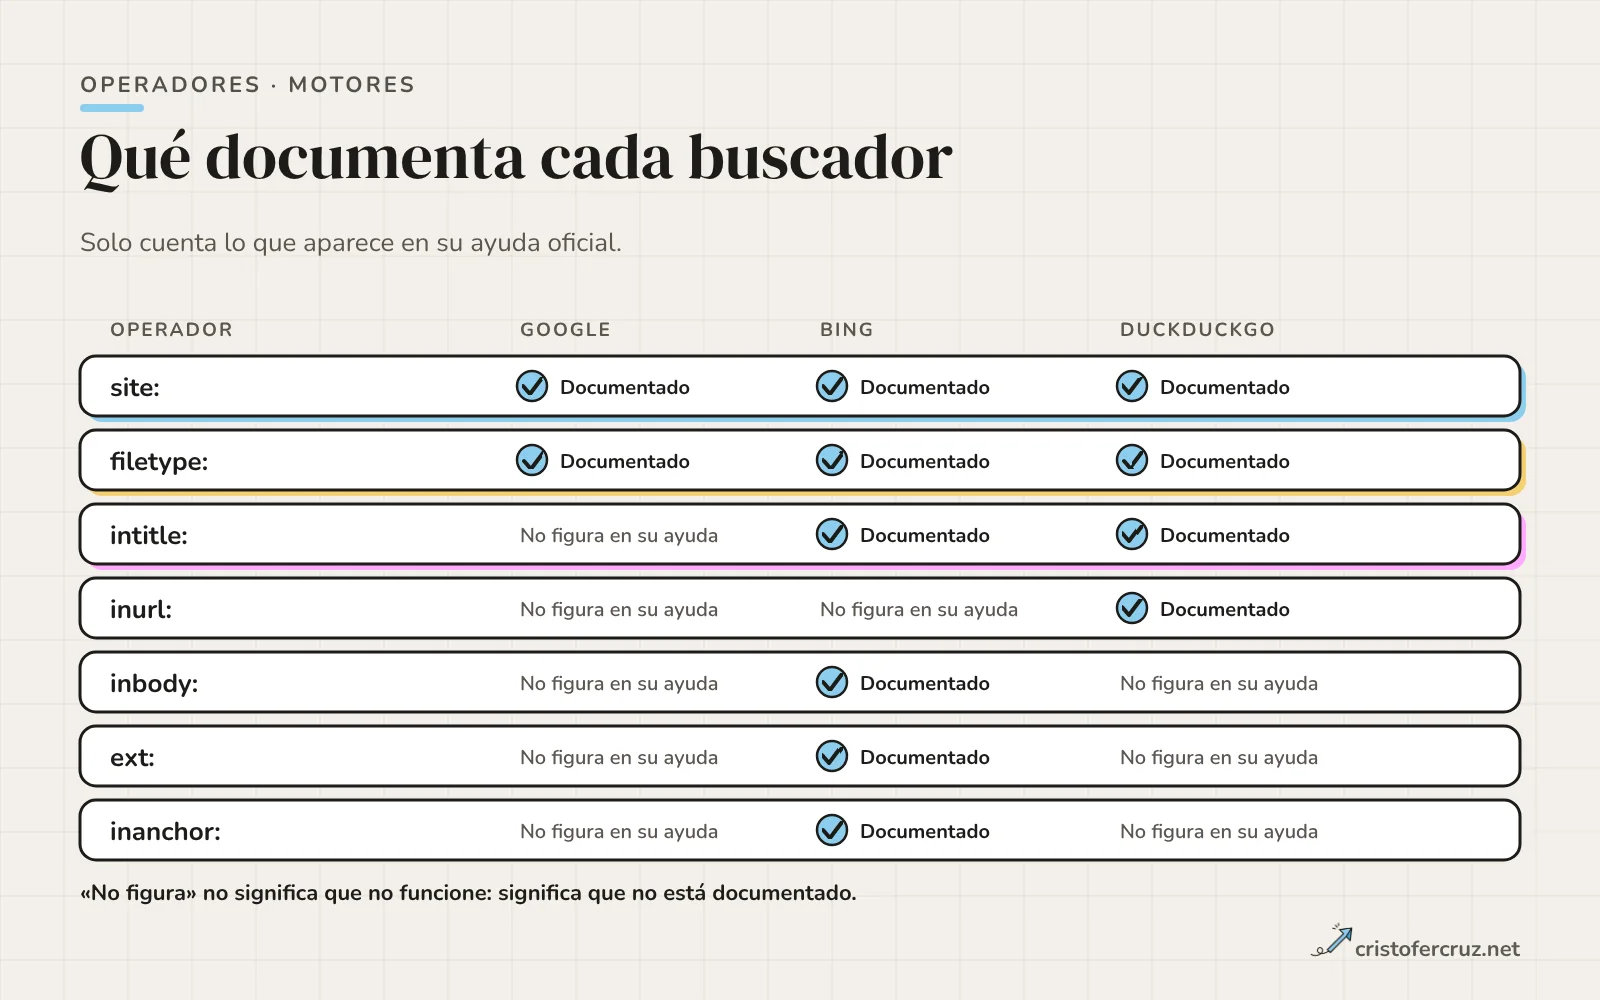
La documentación de Bing es más generosa que la de Google. Su página de palabras clave avanzadas incluye contains:, ext:, filetype:, inanchor:, inbody:, intitle:, ip:, language:, loc:, location:, prefer:, site:, feed:, hasfeed: y url:, y de los booleanos menciona OR con paréntesis. Tiene un uso concreto: url:tudominio.com comprueba si una dirección está en el índice de Bing, e inanchor: permite buscar por texto ancla, algo que la ayuda de Google no documenta.
DuckDuckGo documenta un conjunto más pequeño: comillas, -, +, site:, -site:, filetype:, intitle: e inurl:, además de una sintaxis experimental con tilde. Para auditoría de exposición, tener tres buscadores es útil por una razón sencilla: indexan en momentos distintos y devuelven cosas distintas. La guía de pruebas de seguridad web de OWASP recomienda precisamente usar más de un buscador por esa razón.
Dorking de seguridad sobre tu propio sitio
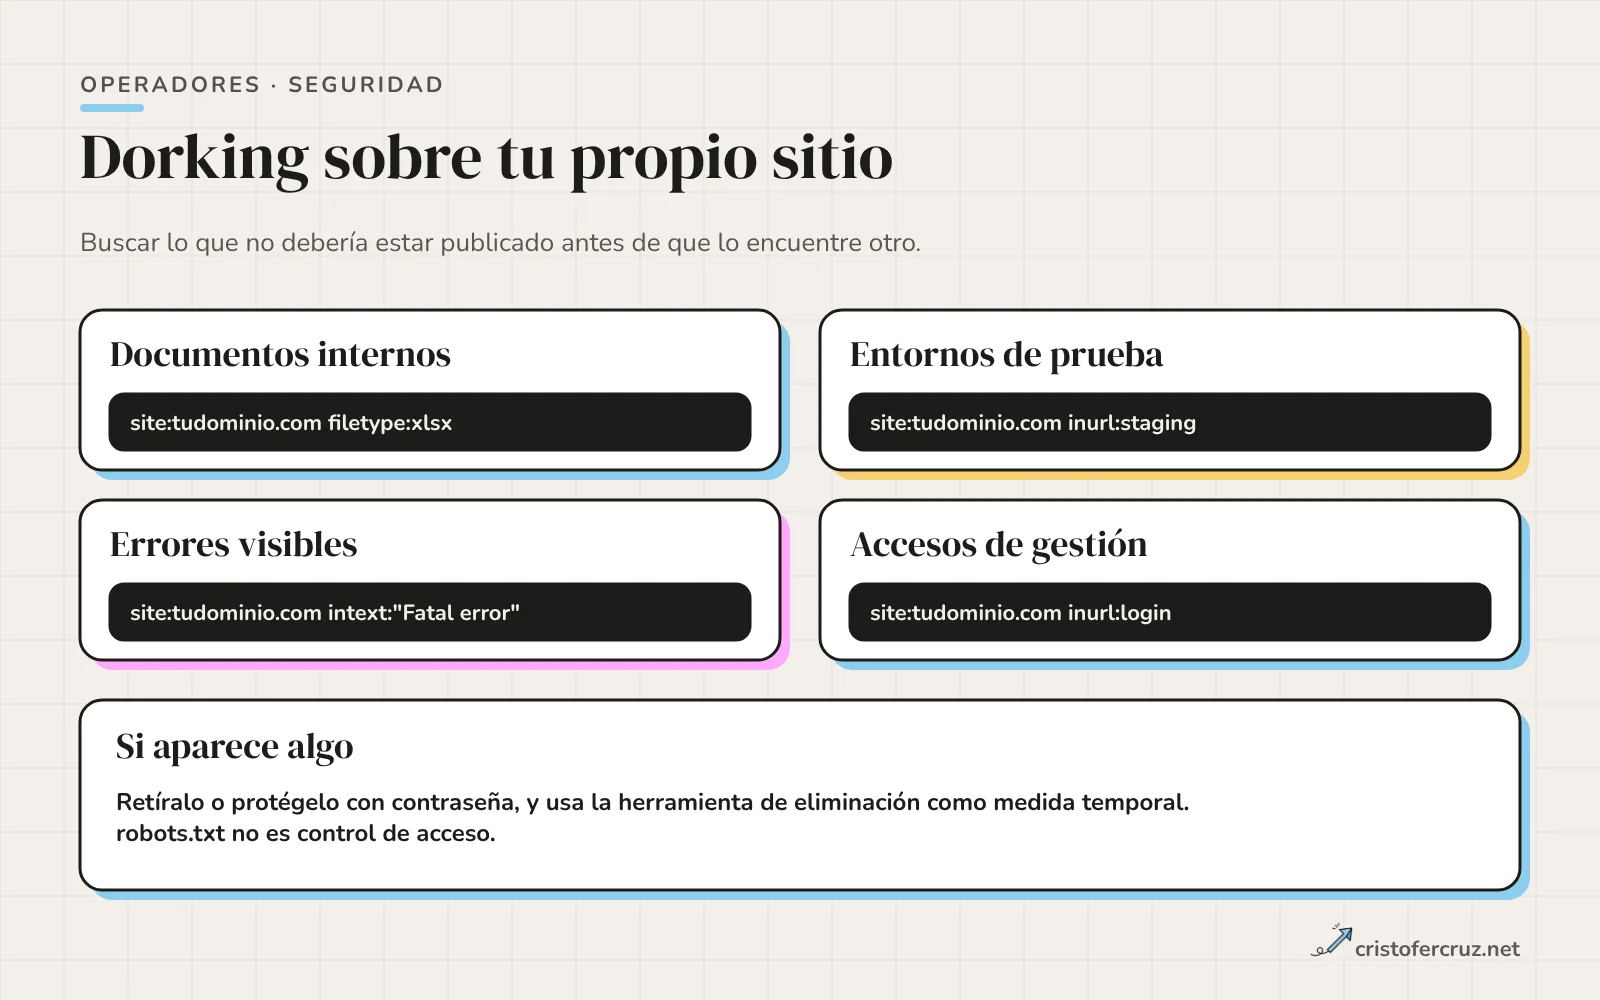
«Google dorking» es encadenar operadores para encontrar archivos o páginas que alguien no quiso publicar. OWASP lo recoge en su guía como parte del reconocimiento de fuga de información y enumera qué buscar: diagramas y configuraciones, credenciales y claves, archivos de configuración de servicios en la nube, mensajes de error reveladores y versiones de desarrollo, pruebas o preproducción.
La versión defensiva se limita a tu dominio y a cuatro familias de consulta: filetype: con extensiones de hojas de cálculo y documentos; inurl: con nombres típicos de entornos (staging, dev, test); intext: con textos de error de tu tecnología; e inurl: con rutas de acceso. Hazlo solo sobre dominios que administras, no sobre terceros.
Si algo aparece, el orden es este, según la documentación de Google sobre cómo quitar información: retira el contenido o protégelo con contraseña; usa la herramienta de eliminación como medida rápida, sabiendo que dura unos seis meses; y no confíes en robots.txt para esconder nada, porque la propia documentación avisa de que no es el método para bloquear una página. Un noindex solo impide que salga en Google. Si el archivo contiene datos sensibles, retirarlo del índice no resuelve que ya fuera público: eso es un incidente de seguridad, no de SEO.
Cómo lo aplico a mi web: recetas, sin resultados
No consulto Google desde el entorno donde escribo esto, así que no voy a decirte qué devuelve cada consulta para cristofercruz.net. Te explico qué espero según el código de mi sitio y qué haría con cada resultado. Lo que sí he leído es esto:
- El
robots.txtbloquea/includes/,/contact-private/,/PHPMailer/,/tools/,/tests/,/.git/,/send.phpy/plantilla-pagina.php. Bloquear el rastreo no garantiza que una URL no aparezca si otras páginas la enlazan, y por eso conviene comprobarlo. - El listado del blog cambia su meta robots a
noindex, followcuando hay un filtro por categoría (?categoria=) o una búsqueda (?q=). La paginación (?pagina=) sí se indexa y su canonical apunta a sí misma. - Un artículo no publicado devuelve 404 con
X-Robots-Tag: noindexdesde el renderizador de artículos.
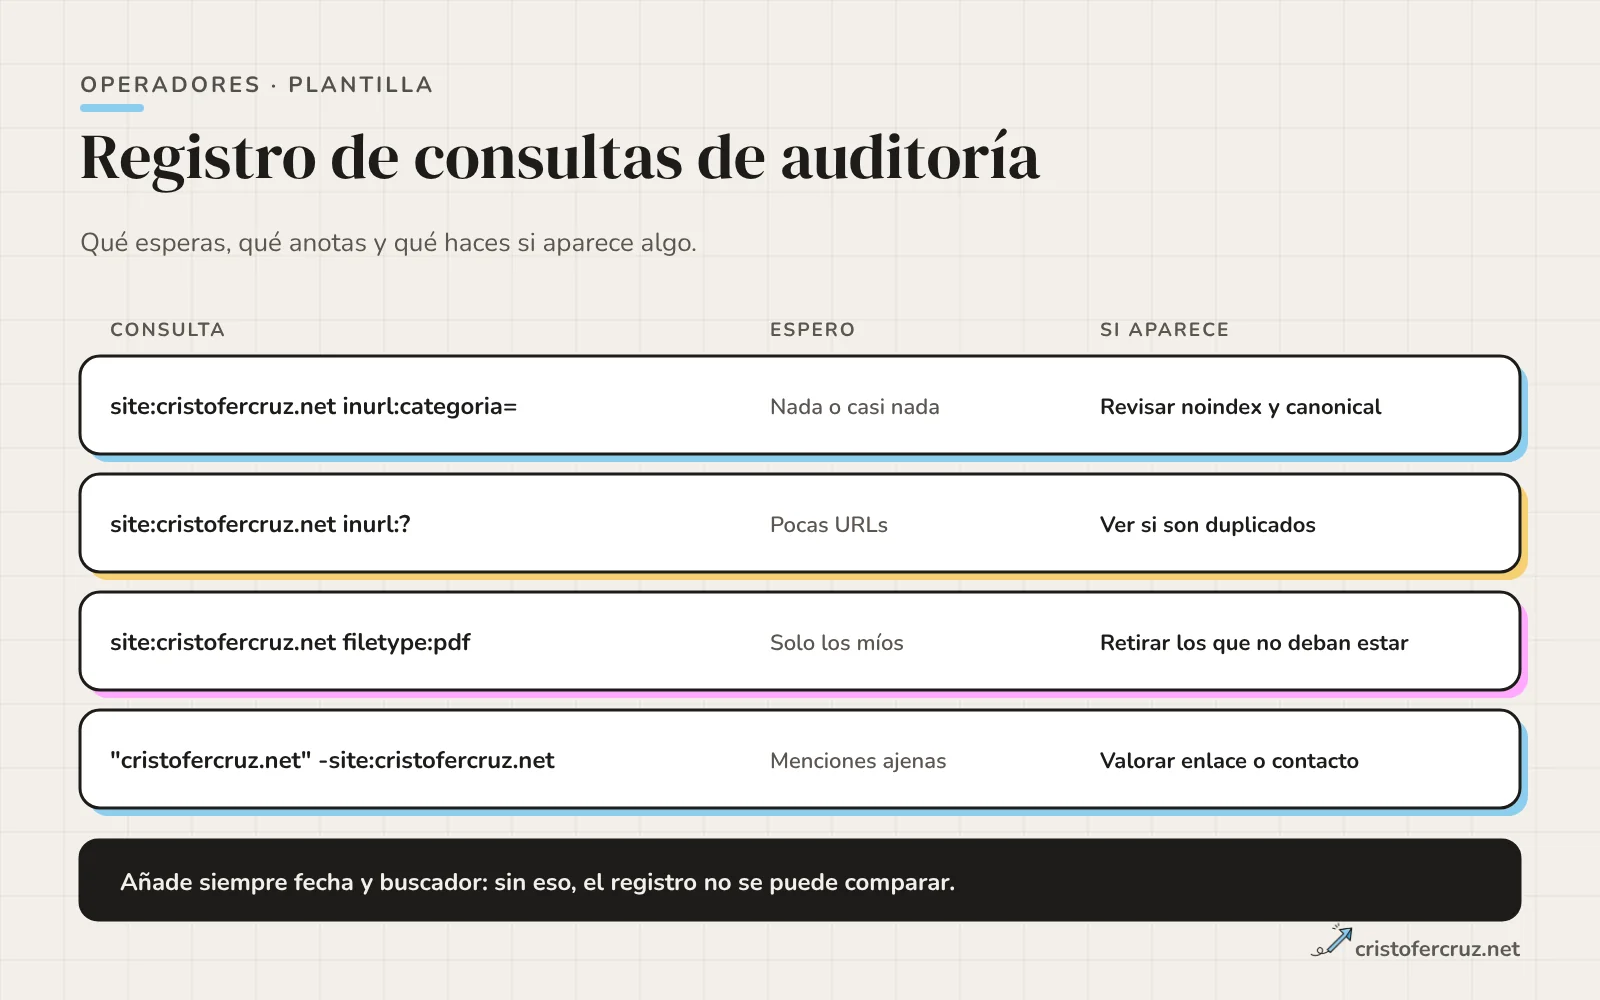
| Consulta | Qué espero y por qué | Si aparece algo inesperado |
|---|---|---|
site:cristofercruz.net inurl:categoria= | Poco o nada: esas URLs llevan noindex | Revisar si el noindex se está sirviendo y si Google ha recogido la señal |
site:cristofercruz.net inurl:? | Sobre todo páginas del listado paginado | Cualquier otro parámetro: investigar de dónde sale |
site:cristofercruz.net inurl:/tools/ | Nada: está bloqueado en robots.txt y el servidor devuelve 403 | Si hay URLs, aparecen por enlaces externos: revisar |
site:cristofercruz.net inurl:contact-private | Nada | Quitar la exposición y proteger el directorio |
site:cristofercruz.net filetype:pdf | Solo documentos que haya publicado yo | Retirar o proteger los que no deban estar |
"cristofercruz.net" -site:cristofercruz.net | Menciones y enlaces de terceros | Lo que no enlace, candidato a una petición cordial |
Lo que no he hecho: no sé si existe algún entorno de pruebas indexado de esta web, y no he probado las consultas anteriores en Google. La que menos puedo asegurar es /tools/: lo que sí está en el .htaccess es una regla que devuelve 403 para esa ruta; qué ha indexado Google antes de esa regla no lo sé.
Cómo hacer la auditoría y dejarla comparable
Una consulta suelta no demuestra nada; un registro repetido sí. Este es el procedimiento que sigo en una auditoría SEO cuando uso operadores:
- Escribe las preguntas antes que las consultas: qué quieres descartar (staging, parámetros, duplicados, documentos).
- Para cada pregunta, una consulta con ámbito, patrón y filtro. Anota la fecha, el buscador y el país o idioma.
- Lanza cada consulta en Google y en un segundo buscador (Bing o DuckDuckGo).
- Para cada URL sospechosa, comprueba con la Inspección de URLs y con
curl -Iqué señales envía (estado, canonical,noindex). - Cruza con Search Console y con tus logs: los operadores te avisan, esas fuentes confirman.
- Guarda la plantilla y repite cada trimestre; lo que cambia entre ejecuciones es lo único que interpretas.
Un operador no es un informe. Si solo tienes una consulta de site: para afirmar «hay 800 URLs indexadas», no tienes un dato; tienes una impresión. Pasa siempre a Search Console antes de escribirlo en un documento para un cliente.
Los operadores tampoco ven lo que viene de los buscadores de IA. Si te interesa cómo se te menciona o cita ahí, es otro trabajo con otras fuentes, que cuento en posicionar en buscadores de IA. Y para validar marcado, site: no sirve: eso se comprueba con las herramientas descritas en datos estructurados con schema.
Preguntas frecuentes
¿Qué operadores de búsqueda de Google siguen funcionando?
Los que la ayuda oficial documenta hoy: comillas, -, site:, before:, after: y filetype:. Otros, como intitle: o inurl:, no figuran en esa ayuda: pueden devolver resultados, pero sin garantía.
¿Funciona todavía cache: en Google?
No. Search Engine Land informó en septiembre de 2024 de que Google lo había cerrado, después de retirar el enlace de caché de los resultados en enero de ese año.
¿Puedo usar site: para saber cuántas páginas tengo indexadas?
No como dato fiable. Google dice que la lista no siempre es exhaustiva y que el operador no está pensado para contar. Usa el informe de indexación de páginas de Search Console.
¿Qué es un footprint en SEO?
Un patrón de consulta reutilizable basado en operadores, que identifica un rasgo repetible: una estructura de URL, una frase de plantilla o un tipo de archivo. Sirve para auditar tu sitio, localizar menciones o buscar oportunidades.
¿Puedo automatizar consultas con operadores?
Google considera tráfico generado por máquina el envío de consultas automáticas, con el ejemplo de extraer resultados para comprobar posiciones, y dice que viola sus políticas de spam y sus Términos de servicio. Para volumen usa Search Console o servicios con permiso.
¿Es legal usar Google dorks sobre otros sitios?
No he analizado la ley y no doy una respuesta jurídica. Mi práctica es limitarme a dominios que administro o sobre los que tengo permiso, y no tocar nada de lo que encuentre.
¿Los operadores funcionan igual en Bing y DuckDuckGo?
No. Comparten site: y filetype:, pero Bing documenta más (inbody:, inanchor:, ext:, url:) y DuckDuckGo menos. Consulta la ayuda de cada uno antes de dar nada por hecho.
Referencias y fuentes
- Refine web searches Ayuda de Búsqueda de Google
- Search operators Google Search Central
- The site: search operator Google Search Central
- Spam policies for Google web search Google Search Central
- Remove information from Google Google Search Central
- Google Search completely kills the cache feature Search Engine Land
- Google confirms related search operator is going away Search Engine Land
- Google’s site: operator won’t show you everything that’s indexed Search Engine Journal
- Advanced search keywords Microsoft Bing
- Search syntax DuckDuckGo Help
- Conduct Search Engine Discovery Reconnaissance for Information Leakage OWASP WSTG v4.2