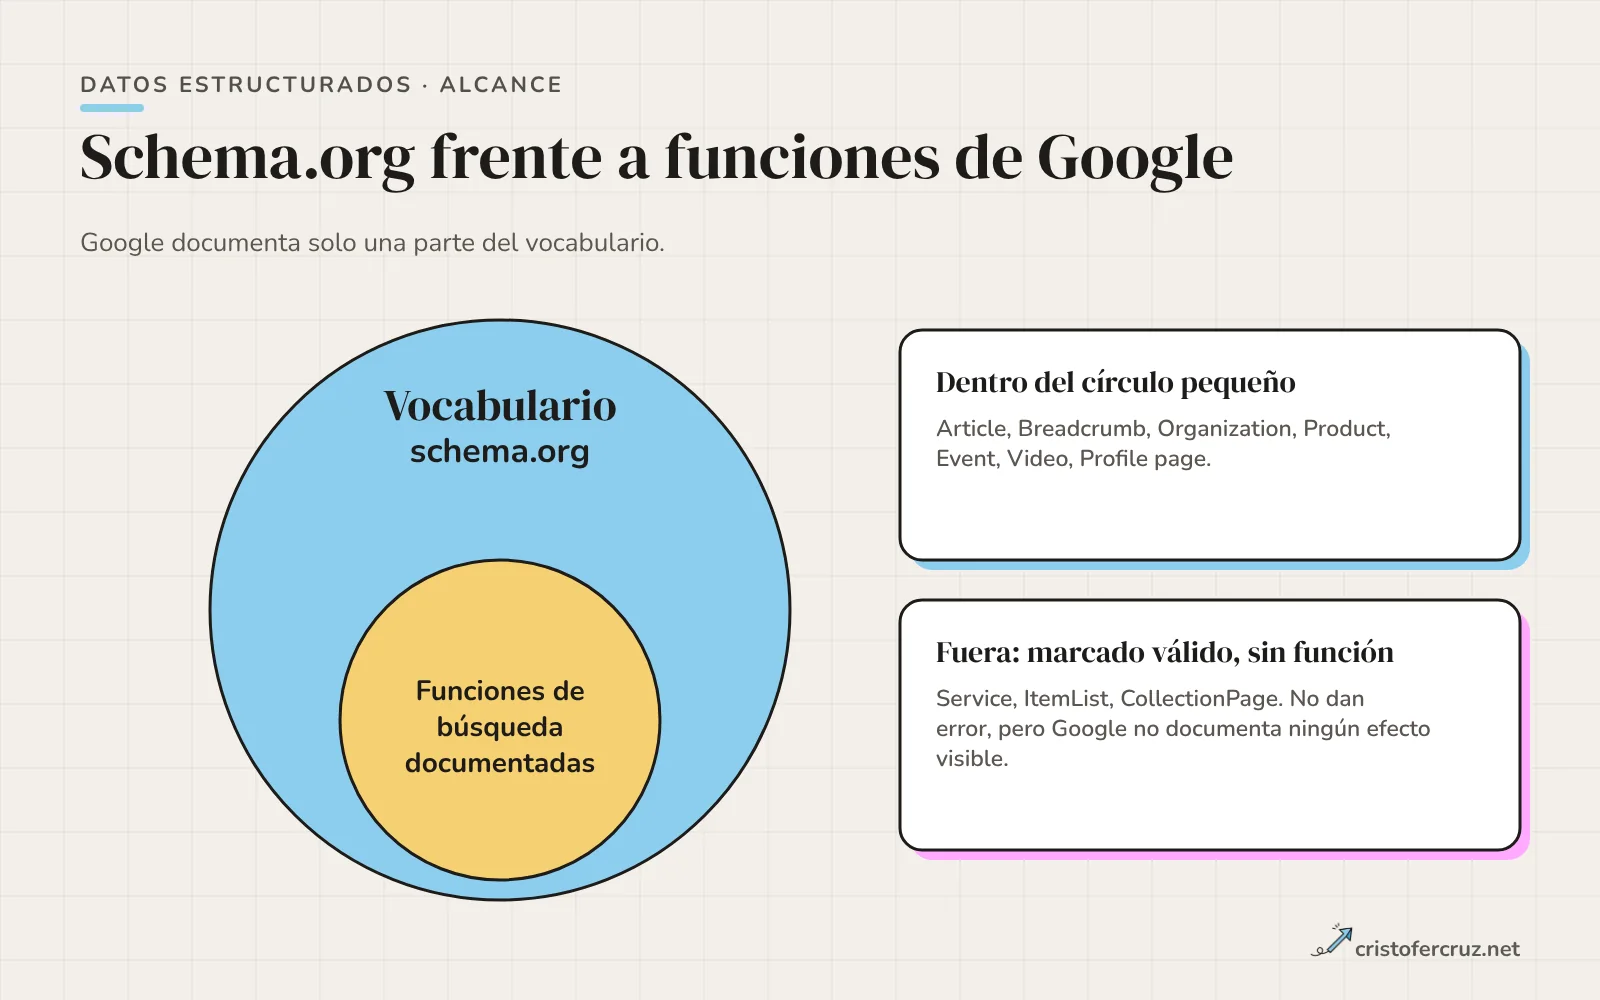
- Schema.org es un vocabulario enorme; Google solo usa una parte para mostrar funciones concretas en los resultados. Marcar un tipo que Google no documenta no rompe nada, pero tampoco cambia nada visible.
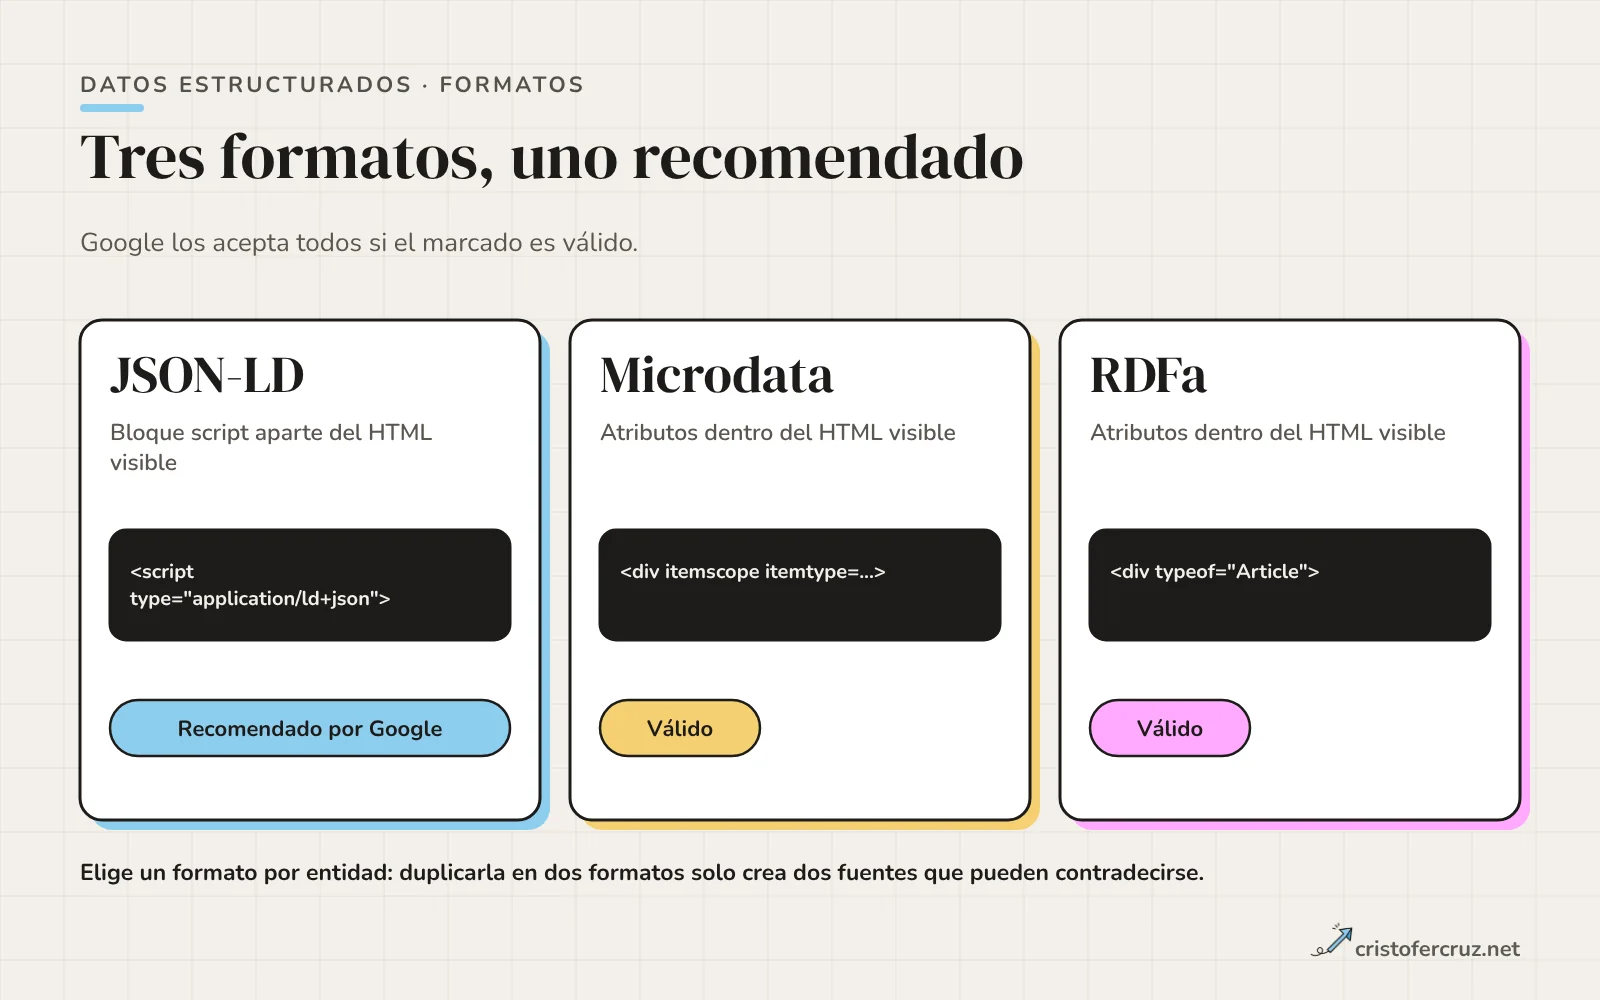
- JSON-LD es el formato que Google recomienda, aunque dice que los tres formatos (JSON-LD, Microdata y RDFa) son igual de válidos si el marcado es correcto.
- Los datos estructurados no mejoran el ranking por sí solos. Sirven para entender la página y ser elegible para resultados enriquecidos, y esa lista se ha ido recortando: FAQ dejó de mostrarse el 7 de mayo de 2026 y How-to está deprecado desde 2023.
- El marcado tiene que describir lo que el usuario ve en la página. Lo oculto, inventado o desactualizado es la vía directa a perder la elegibilidad.
- Con
@idy referencias entre nodos puedes montar un grafo (WebSite, Organization o Person, página, artículo, migas) en lugar de bloques sueltos que no se conocen entre sí. - Se valida con la Prueba de resultados enriquecidos, el validador de schema.org y los informes de Search Console, y se vuelve a validar tras cada cambio de plantilla.
La mayoría de problemas con schema que veo en auditorías no son de sintaxis. Son de expectativas: webs con cuarenta tipos de marcado esperando un efecto en el ranking que nadie ha prometido, plantillas que declaran un FAQPage que Google ya no muestra, o un Organization en cada URL que no apunta a ningún sitio. El JSON-LD es válido y la estrategia, inexistente.
Este artículo separa lo que es schema.org de lo que Google convierte en función de búsqueda, repasa qué resultados enriquecidos siguen vivos, explica cómo enlazar nodos con @id y termina con lo que emite hoy mi propia web, incluidas sus carencias. Si lo tuyo es la visibilidad en buscadores con IA, el matiz va en el artículo sobre AEO y GEO.
Qué son los datos estructurados y para qué sirven
Los datos estructurados son marcado dentro de la página que describe su contenido en un formato estándar: qué es la página, quién la escribe, cuándo se publicó, dónde está dentro de la web. Google define el objetivo en su documentación: usa los datos estructurados para entender el contenido y mostrarlo con una apariencia más rica, lo que llama resultado enriquecido.
Ese «para qué» tiene dos partes que conviene no mezclar. La primera es la comprensión: el marcado le dice a un sistema qué entidad aparece en la página. La segunda es la elegibilidad: si el tipo y las propiedades coinciden con una función documentada, la página puede optar a un resultado enriquecido. Que opte no significa que lo obtenga; la propia documentación aclara que el marcado habilita una función, pero no garantiza que aparezca.
JSON-LD frente a Microdata y RDFa
Google acepta tres formatos y lo dice con claridad: recomienda JSON-LD «si la configuración de tu sitio lo permite», y afirma que los tres son igual de válidos para Google siempre que el marcado sea correcto. La ventaja práctica de JSON-LD, según la propia documentación, es que el marcado no va entremezclado con el texto visible.
| Formato | Dónde vive | Cuándo lo elegiría |
|---|---|---|
| JSON-LD | Bloque <script type="application/ld+json"> independiente del HTML visible | Casi siempre: se genera desde plantilla, se puede probar aparte y no se rompe al cambiar el diseño |
| Microdata | Atributos (itemscope, itemprop) dentro del HTML | Si el CMS ya lo emite y no puedes cambiarlo |
| RDFa | Atributos (typeof, property) dentro del HTML | Casos con requisitos de datos enlazados; en SEO es raro |
Hay un límite que no he visto documentado con detalle: qué pasa si mezclas formatos en la misma página para la misma entidad. Google no prohíbe tenerlos, pero duplicar un Article en JSON-LD y en Microdata solo te da dos fuentes que pueden contradecirse. Elige una por entidad.
Sobre JSON-LD inyectado con JavaScript, Google documenta que puede procesar el marcado que esté en el DOM cuando renderiza la página, y recomienda con Tag Manager extraer los valores de la propia página en lugar de duplicarlos a mano, porque duplicar aumenta el riesgo de desajuste con el contenido. Si trabajas con renderizado en cliente, es mejor que el JSON-LD llegue ya en el HTML inicial, igual que recomiendo en mi guía de JavaScript SEO.
Schema.org frente a lo que Google convierte en función
Schema.org es el vocabulario: miles de tipos y propiedades pensados para describir casi cualquier cosa. Google, en cambio, documenta un subconjunto de tipos y propiedades vinculados a funciones de búsqueda concretas, con sus propios requisitos. Fuera de ese subconjunto, el marcado es legítimo, pero Google no promete ningún efecto.
Mueller lo resumió en abril de 2025 en Bluesky: los datos estructurados no hacen que tu web posicione mejor y se usan para mostrar las funciones de búsqueda de la galería; usar schema.org con otros fines no causa problemas, pero es poco probable que veas un cambio visible en Google. Es una declaración personal en una red social, no documentación, pero coincide con lo que dice la documentación: los datos estructurados habilitan funciones, no posiciones.
Qué resultados enriquecidos siguen vivos
Esta es la parte que más rápido caduca, así que fecha y fuente van por delante. Al revisar la galería de búsqueda de Google para este artículo, listaba 25 funciones, entre ellas Article, Breadcrumb, Organization, Profile page, Image metadata, Q&A, Speakable, Product, Recipe, Event, Job posting, Local business, Review snippet y Video. Ni FAQ ni How-to aparecen ya en esa lista.
| Función | Estado según la documentación de Google |
|---|---|
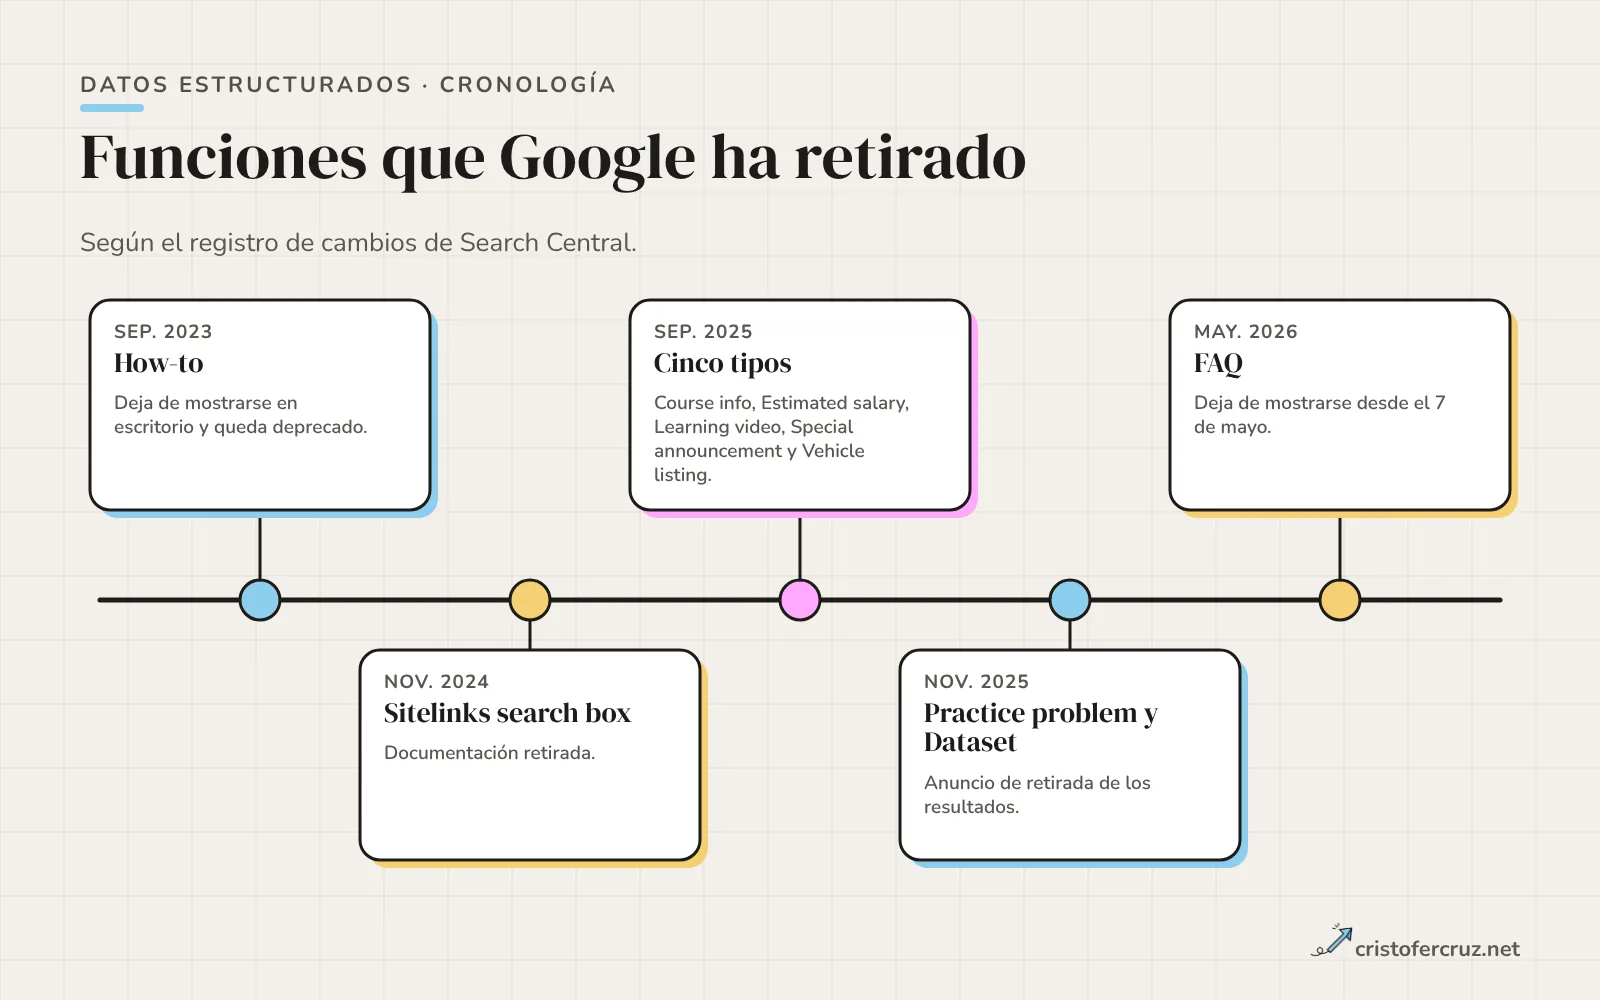
| FAQ | El 8 de mayo de 2026 Google anunció su deprecación: «no aparecerá en Google Search a partir del 7 de mayo de 2026». El 15 de junio de 2026 retiró la documentación |
| How-to | Desde el 13 de septiembre de 2023 no se muestra en escritorio y el tipo quedó deprecado; antes ya se había quitado en móvil. El marcado sigue siendo válido, pero sin beneficio en resultados |
| Course info, Estimated salary, Learning video, Special announcement, Vehicle listing | Documentación retirada el 9 de septiembre de 2025: «ya no se muestran» en resultados |
| Practice problem y Dataset | El 5 de noviembre de 2025 Google anunció que los retiraba de los resultados. La documentación de Practice problem se retiró el 6 de enero de 2026; la galería sigue listando Dataset vinculado a Dataset Search, así que compruébalo antes de decidir |
| Sitelinks search box | Documentación retirada en noviembre de 2024 |
| Article, Breadcrumb, Organization, Product, Event, Video… | Siguen en la galería |
La lectura práctica es que ya no merece la pena añadir FAQPage esperando el desplegable en los resultados. Si tu web tiene preguntas frecuentes visibles, déjalas para el usuario. Que el marcado siga existiendo no es un error, pero tampoco aporta lo que aportaba. En agosto de 2023 el FAQ enriquecido ya se había limitado, según la cobertura de aquel cambio, a webs gubernamentales y de salud conocidas; no he podido leer el cuerpo de la entrada original de Google, así que doy esa parte como cobertura secundaria.
Antes de proponer un tipo de marcado a un cliente, abre la galería de búsqueda y comprueba que la función sigue en la lista. Es una comprobación de un minuto que evita implementar algo que ya no se muestra.
Requisitos y políticas de calidad
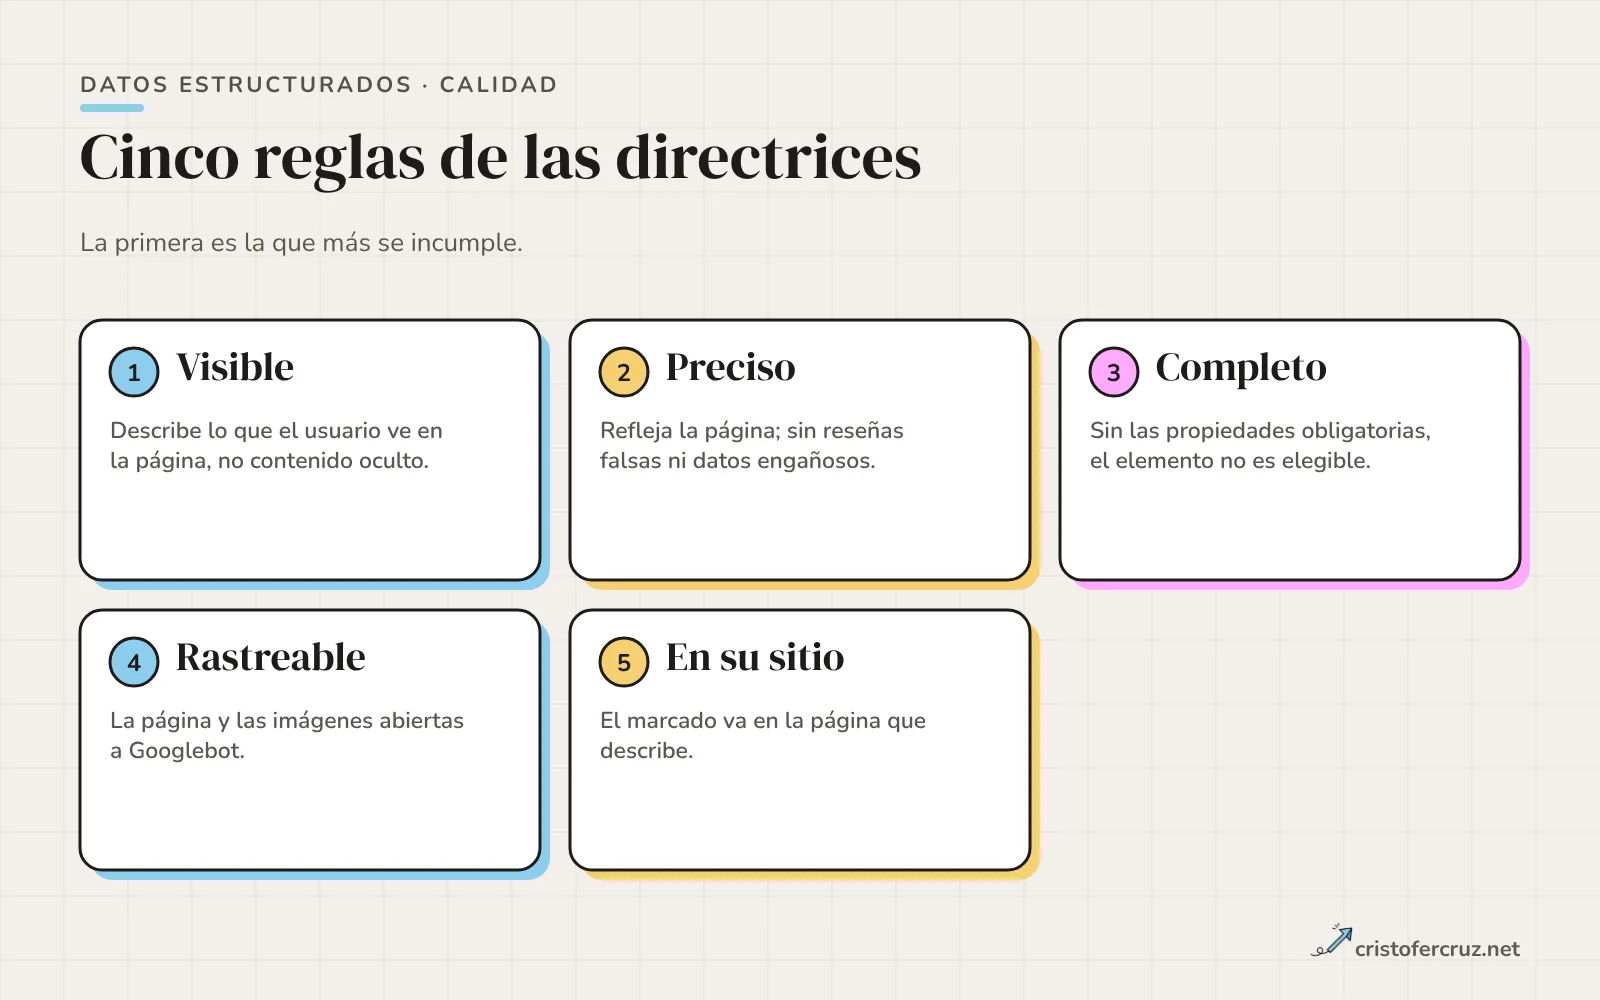
Las directrices generales de Google se resumen en pocas reglas, y la mayoría de infracciones se reduce a la primera.
- Visible: no marques contenido que los lectores de la página no puedan ver. Si el marcado habla de un artista, el HTML debe hablar de ese mismo artista.
- Preciso y relevante: el marcado debe representar la página. Reseñas falsas o información engañosa están prohibidas, y el contenido caducado no obtiene resultados enriquecidos.
- Completo: los elementos a los que les falten propiedades obligatorias no son elegibles.
- Rastreable: la página con marcado debe estar abierta a Googlebot, sin robots.txt, noindex ni controles de acceso. Y las imágenes que cites deben ser rastreables, y conviene que lleven un buen texto alternativo en el HTML.
- En su sitio: el marcado va en la página a la que describe.
Un detalle que se pasa por alto: la acción manual por problemas de datos estructurados hace que la página pierda la elegibilidad como resultado enriquecido, pero según la documentación no afecta a su posicionamiento en la búsqueda web. Se consulta en el informe de Acciones manuales de Search Console.
También conviene saber que muchos tipos no tienen propiedades obligatorias. En la documentación de Article, por ejemplo, ninguna lo es: todas son recomendadas, y en la de Organization igual. Eso no significa que den igual; significa que el criterio es completar las que apliquen.
El grafo: @id y relaciones entre nodos
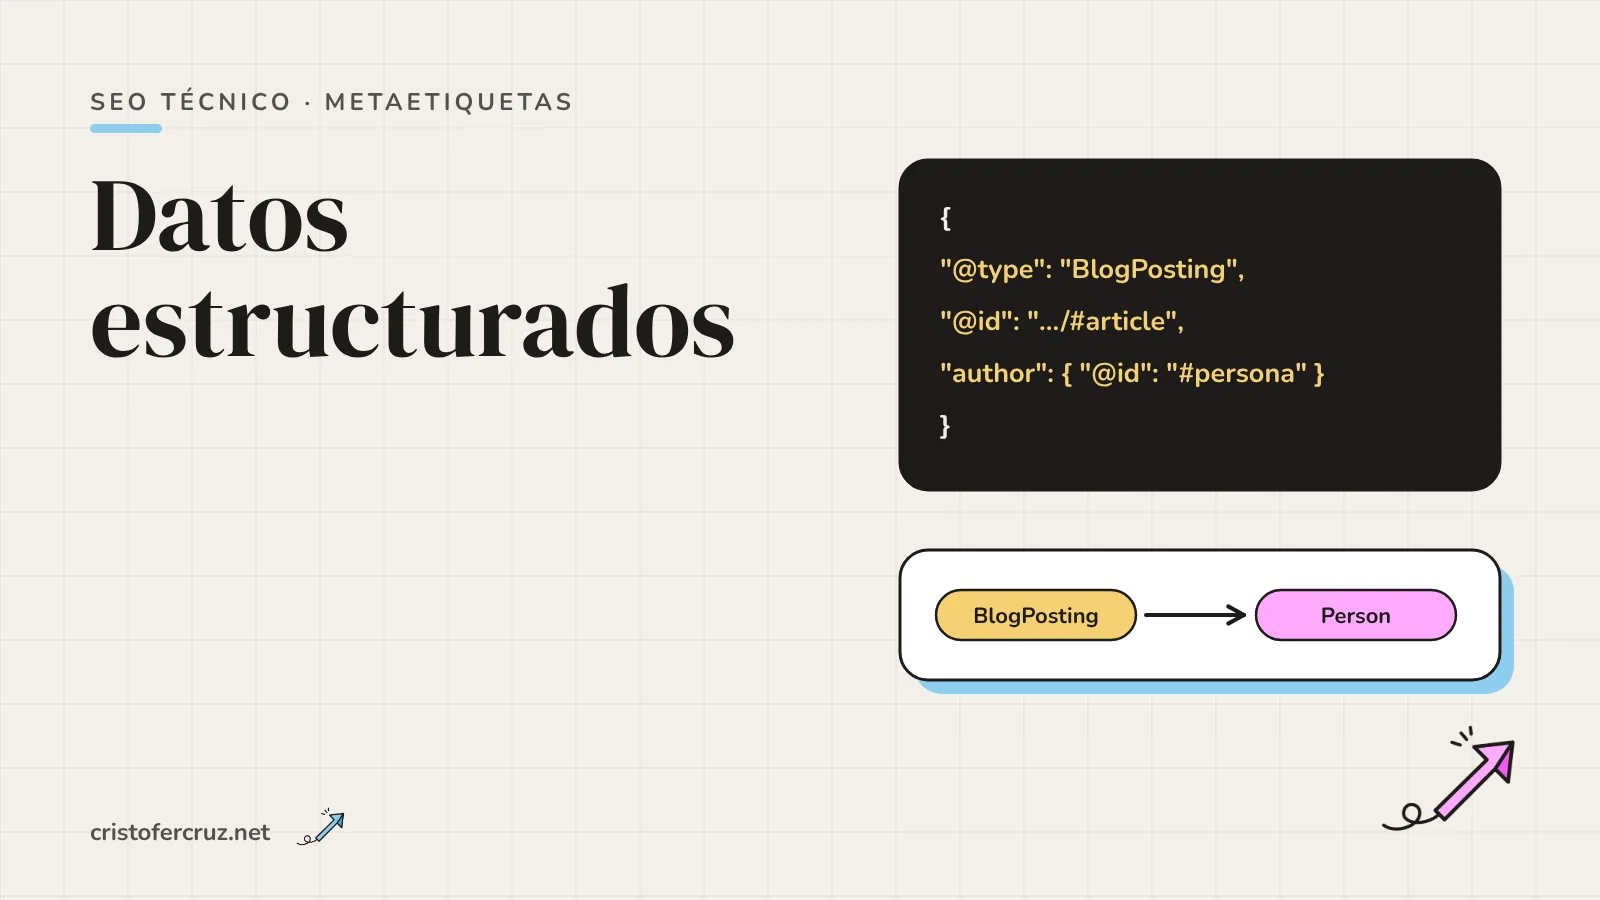
El error de estructura más habitual es tratar cada bloque JSON-LD como una isla: un Organization en el pie, un Article en el cuerpo, unas migas en la cabecera, sin que nada diga que el autor del artículo es la misma persona que aparece en «Sobre mí». Con @id y @graph cada entidad se declara una vez y se referencia desde las demás.
{
  "@context": "https://schema.org",
  "@graph": [
    { "@type": "WebSite", "@id": "https://ejemplo.com/#website",
      "url": "https://ejemplo.com/", "publisher": { "@id": "https://ejemplo.com/#org" } },
    { "@type": "Organization", "@id": "https://ejemplo.com/#org",
      "name": "Ejemplo", "url": "https://ejemplo.com/" },
    { "@type": "WebPage", "@id": "https://ejemplo.com/guia/#webpage",
      "url": "https://ejemplo.com/guia/", "isPartOf": { "@id": "https://ejemplo.com/#website" } },
    { "@type": "BlogPosting", "@id": "https://ejemplo.com/guia/#article",
      "isPartOf": { "@id": "https://ejemplo.com/guia/#webpage" },
      "author": { "@id": "https://ejemplo.com/autor/#persona" } }
  ]
}
Tres reglas que aplico siempre. Un @id es un identificador, no tiene que ser una URL que cargue algo, y funciona bien como URL canónica de la página más un fragmento (#org). Cada @id debe significar una sola cosa en todo el sitio: si la home llama #person a una persona y otra página la llama #persona, estás declarando dos entidades. Y una referencia {"@id": "…"} solo es útil si ese nodo existe en la misma página o se declara completo en otra que Google rastree; no he encontrado documentado que Google resuelva referencias entre páginas, así que declaro los nodos clave en cada página donde los necesito.
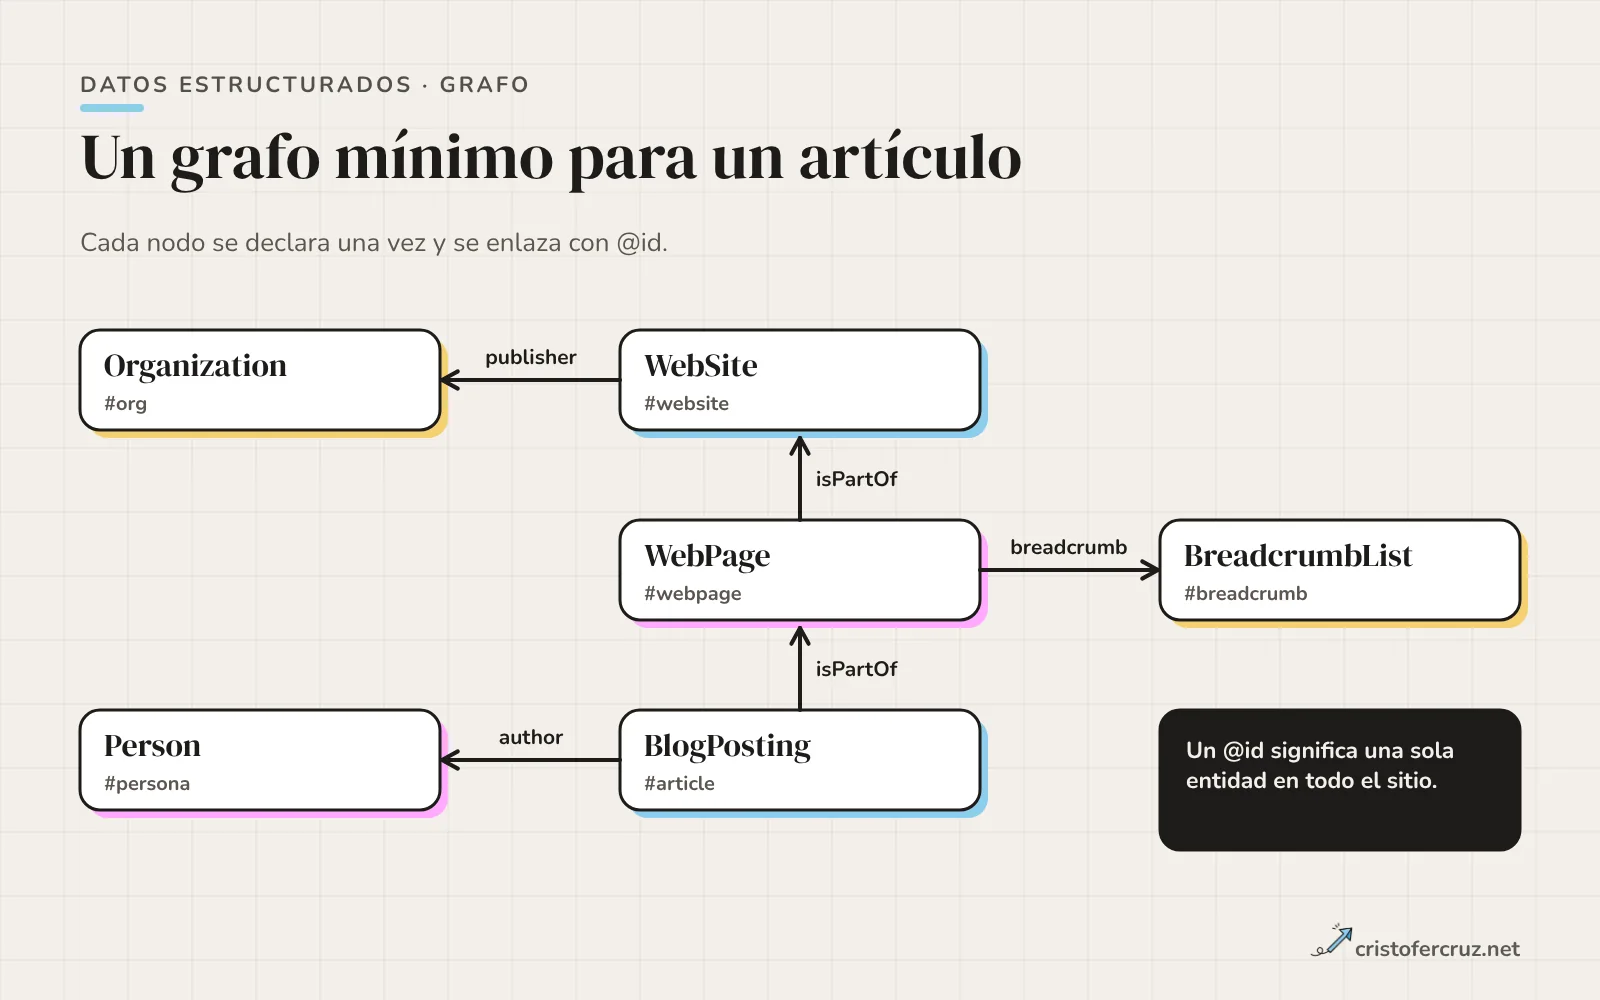
@id.Un buen test del grafo: si borras un nodo, ¿queda alguna referencia colgando? Si hay un @id citado que no existe en ningún sitio, o falta el nodo o sobra la referencia.
Qué tipos uso en un blog o web de consultor
No hay una lista universal. Esta es la que defendería para una web como la mía, y cada fila responde a una pregunta: ¿está el dato visible y sirve a alguna función o a la comprensión?
| Tipo | Dónde | Para qué |
|---|---|---|
| Organization (o ProfessionalService) y Person | Home y página sobre mí | Declarar quién es la entidad, con logo, sameAs y datos de contacto. Google pide el marcado de Organization en la home o en una página que describa la organización, no en todas |
| WebSite | Home | Nombre e identidad del sitio; punto de anclaje del grafo |
| BlogPosting o Article | Cada artículo | Titular, fechas, autor, imágenes; es una función documentada |
| BreadcrumbList | Páginas internas | Reflejar la jerarquía. Requiere al menos dos elementos con item, name y position |
| ProfilePage | Página sobre mí | Página centrada en una persona afiliada al sitio |
| Service, ItemList, CollectionPage | Servicios y listados | Comprensión; Google no documenta funciones asociadas |
Un apunte sobre autoría: la documentación de Article recomienda poner cada autor visible en la página en su propio author, con type y una url o sameAs que ayude a identificarlo. Y sobre imágenes, que las URL sean rastreables e indexables, y que haya varias en distintas proporciones. Para la tarjeta que se ve al compartir el enlace en redes no sirve schema, sino las etiquetas Open Graph.
Datos estructurados y buscadores con IA
Se repite que el schema es la llave para aparecer en las respuestas de IA. Lo que dice Google en su documentación sobre funciones de IA en Search es lo contrario: no hay ningún schema.org especial que debas añadir, ni archivos o marcado nuevos para aparecer en esas funciones. Sí recomienda comprobar que el marcado coincide con el texto visible, como cualquier otra buena práctica.
Eso es lo documentado para Google. Para otros sistemas no tengo una fuente primaria que garantice nada, y lo trato como una hipótesis útil: un marcado limpio de autor, organización y fechas no hace daño y ayuda a que la entidad esté clara. Lo desarrollo, con sus límites, en AEO y GEO. Y si quieres controlar qué fragmentos se muestran, eso se hace con otros mecanismos, como data-nosnippet, no con schema.
Cómo lo tengo en mi web
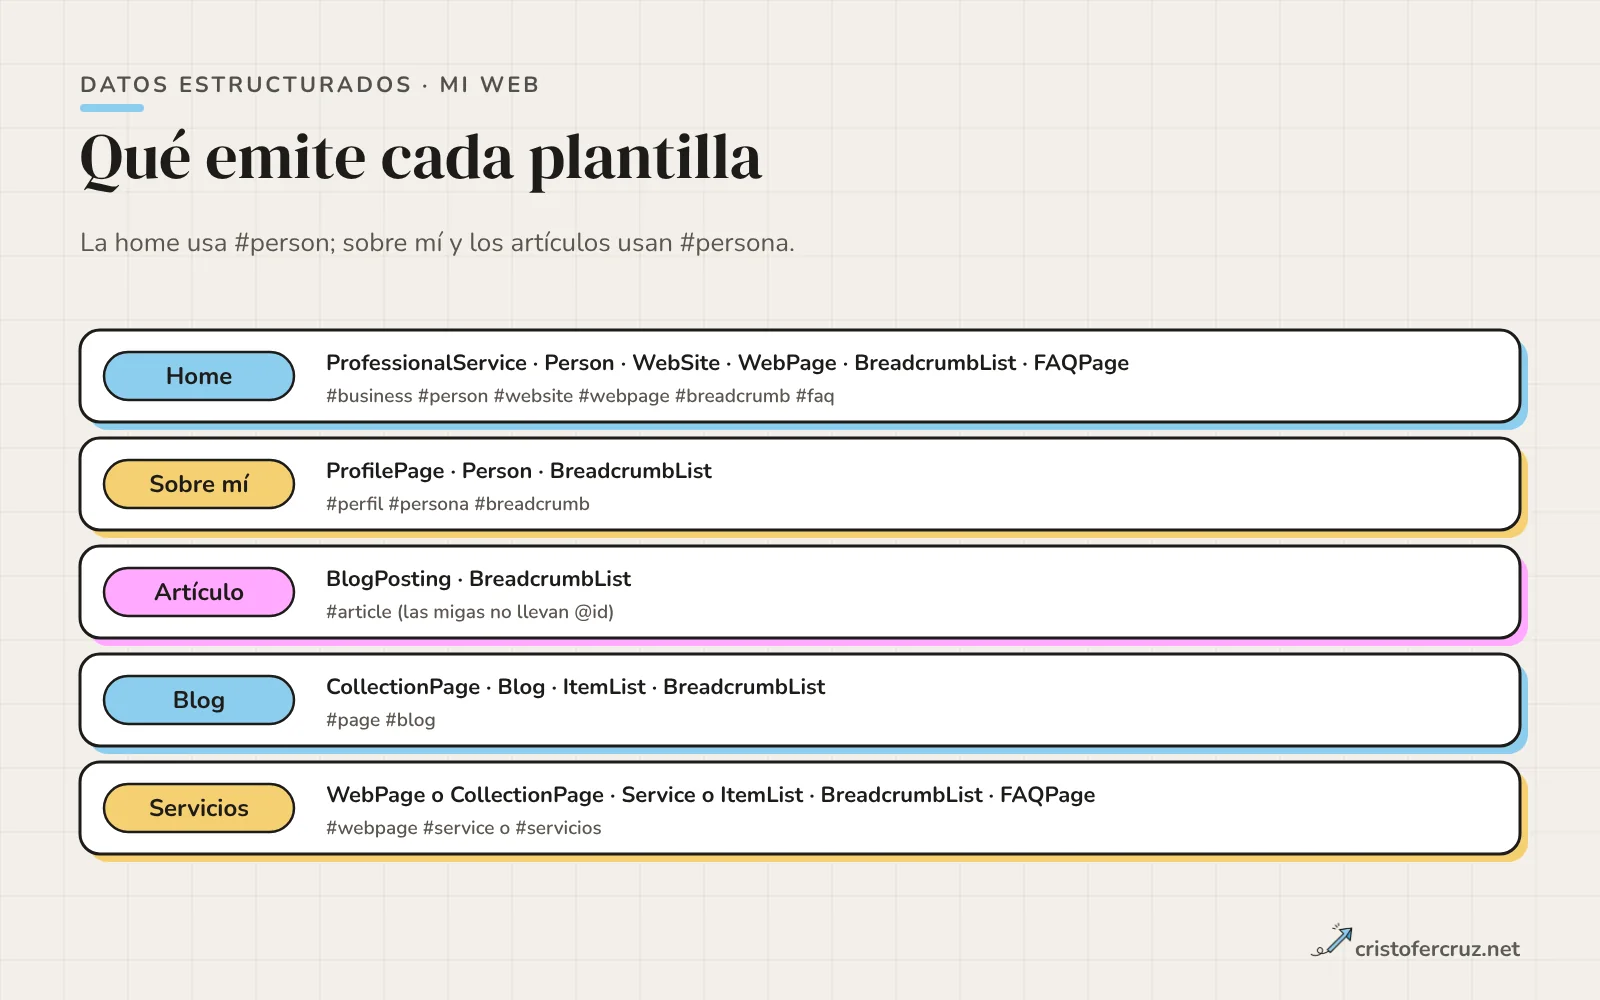
Esto es lo que emite hoy cristofercruz.net, leído del código y de las páginas servidas. Todo se genera en PHP con json_encode desde las mismas variables que pintan el HTML, así que título, descripción y fechas del marcado coinciden con los visibles. Todo es JSON-LD; no uso Microdata ni RDFa.
| Página | Nodos emitidos | @id declarados |
|---|---|---|
| Home | ProfessionalService, Person, WebSite, WebPage, BreadcrumbList, FAQPage | /#business, /#person, /#website, /#webpage, /#breadcrumb, /#faq |
| Sobre mí | ProfilePage, Person, BreadcrumbList | #perfil, #persona, #breadcrumb |
| Artículo del blog | BlogPosting, BreadcrumbList | #article (la lista de migas no lleva @id) |
| Índice del blog | CollectionPage, Blog, ItemList, BreadcrumbList | #page y #blog |
| Servicios | WebPage o CollectionPage, Service o ItemList, BreadcrumbList, y FAQPage en algunos | #webpage, #service o #servicios |
El JSON-LD de un artículo, resumido
El BlogPosting de cada artículo lleva titular, descripción, URL, datePublished y dateModified (tomadas del mismo archivo de datos del artículo), idioma, sección, timeRequired, dos imágenes (portada y primera figura) y el autor como Person con @id en /sobre-mi/#persona, imagen y sameAs a LinkedIn. Las migas siguen el patrón Inicio, Blog y título del artículo.
"@graph": [
  { "@type": "BlogPosting", "@id": ".../blog/ARTICULO/#article",
    "mainEntityOfPage": { "@id": ".../blog/ARTICULO/" },
    "author": { "@type": "Person", "@id": ".../sobre-mi/#persona", ... },
    "publisher": { "@type": "Person", "@id": ".../sobre-mi/#persona", ... } },
  { "@type": "BreadcrumbList", "itemListElement": [ ...3 ListItem... ] }
]
@id que emite cada plantilla de la web, según el código.Lo que le falta a mi grafo
Lo que tengo funciona por plantillas, no como un grafo único, y tiene huecos que conozco:
- Dos identificadores para la misma persona. La home declara
/#persony «Sobre mí» declara/sobre-mi/#persona. Los artículos usan este último. Son dos nodos para la misma entidad y no están unidos consameAsni por referencia. - El artículo no se conecta con el sitio. El BlogPosting no cita un WebPage ni el WebSite con
isPartOf, y no existe un nodo WebPage en la plantilla de artículo. La propiedadmainEntityOfPageapunta a la URL, no a un nodo declarado. - El editor de los artículos es una Person. Es el mismo nodo que el autor. No enlaza con el ProfessionalService de la home, que es donde están el logo y los datos de contacto.
- Autor repetido. En cada artículo la Person va completa dentro del
author, no como nodo separado referenciado. - Migas sin
@iden artículos, y el Service de servicios lleva a su proveedor como Person en línea, sin@id. - FAQPage en la home y en algunos servicios. Las preguntas están visibles en la página, así que el marcado no es engañoso, pero con la deprecación de mayo de 2026 ya no produce función de búsqueda.
- No hay Review ni AggregateRating. La home muestra reseñas de clientes, pero no las marco; prefiero no arriesgar la política de reseñas.
Lo que sí está bien resuelto: todo sale de las mismas variables que el HTML, dateModified solo se emite si es una fecha válida, no anterior a la publicación ni futura, no hay propiedades inventadas y la serialización escapa etiquetas HTML dentro del script. Y tengo una herramienta propia, Visual Schema, para ver las entidades y sus conexiones de cualquier URL.
Mi siguiente cambio, sin fecha comprometida, es unificar el @id de la persona y sumar WebPage con isPartOf a la plantilla de artículo. Lo cuento como pendiente, no como hecho.
Cómo validar y auditar el marcado
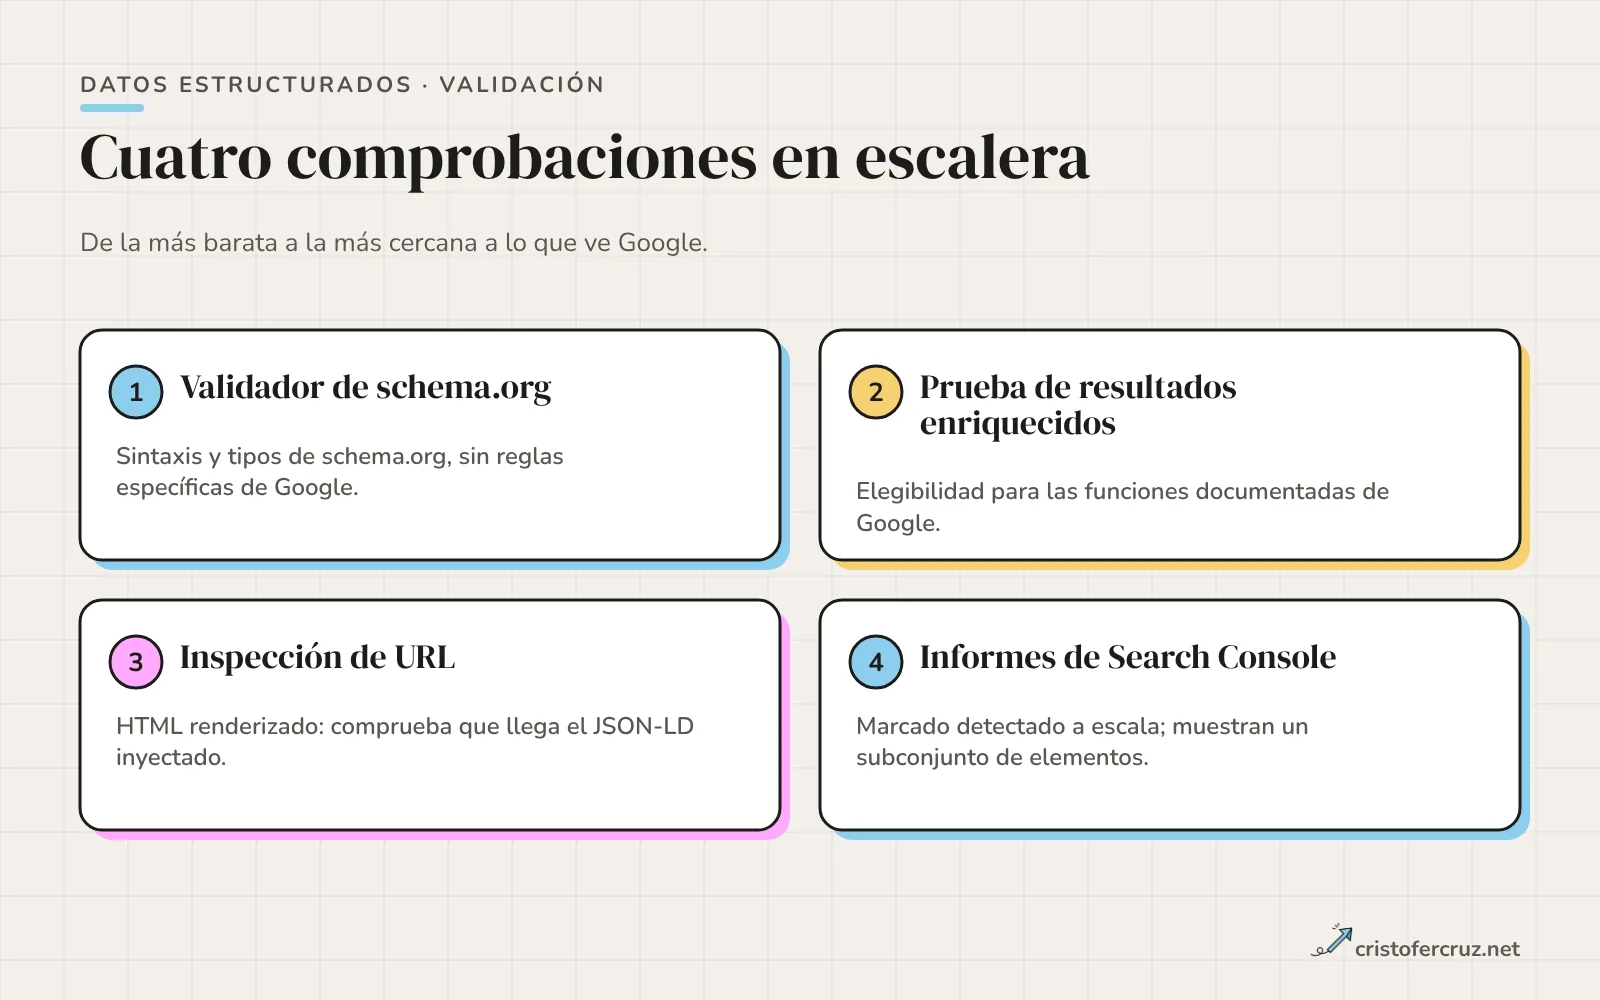
Hay cuatro comprobaciones, de la más barata a la más completa. Google recomienda empezar por la Prueba de resultados enriquecidos, su herramienta oficial; para una validación genérica de schema.org, sin comprobaciones específicas de Google, existe el Schema Markup Validator.
- Sintaxis: pega el JSON-LD en el validador de schema.org. Detecta propiedades mal escritas y tipos que no existen.
- Elegibilidad: la Prueba de resultados enriquecidos indica si la URL cumple los requisitos de una función documentada.
- Lo que ve Google: la Inspección de URL en Search Console muestra el HTML renderizado; si inyectas JSON-LD con JavaScript, es la forma de comprobar que llega.
- A escala: los informes de resultados enriquecidos de Search Console muestran el marcado detectado y su validez. Cuidado con su alcance: muestran un subconjunto de elementos y cuentan elementos, no páginas.
Para un grafo propio añado dos pruebas a mano: contar cuántos nodos hay con el mismo @id en todo el sitio (no debería haber dos con distinto contenido) y comparar el titular y la fecha del marcado con los visibles. Si sacas el JSON-LD del HTML con un script, esas dos comprobaciones se automatizan en cinco minutos. Para el resto de la auditoría técnica, mi auditoría SEO incluye esta revisión.
Errores típicos
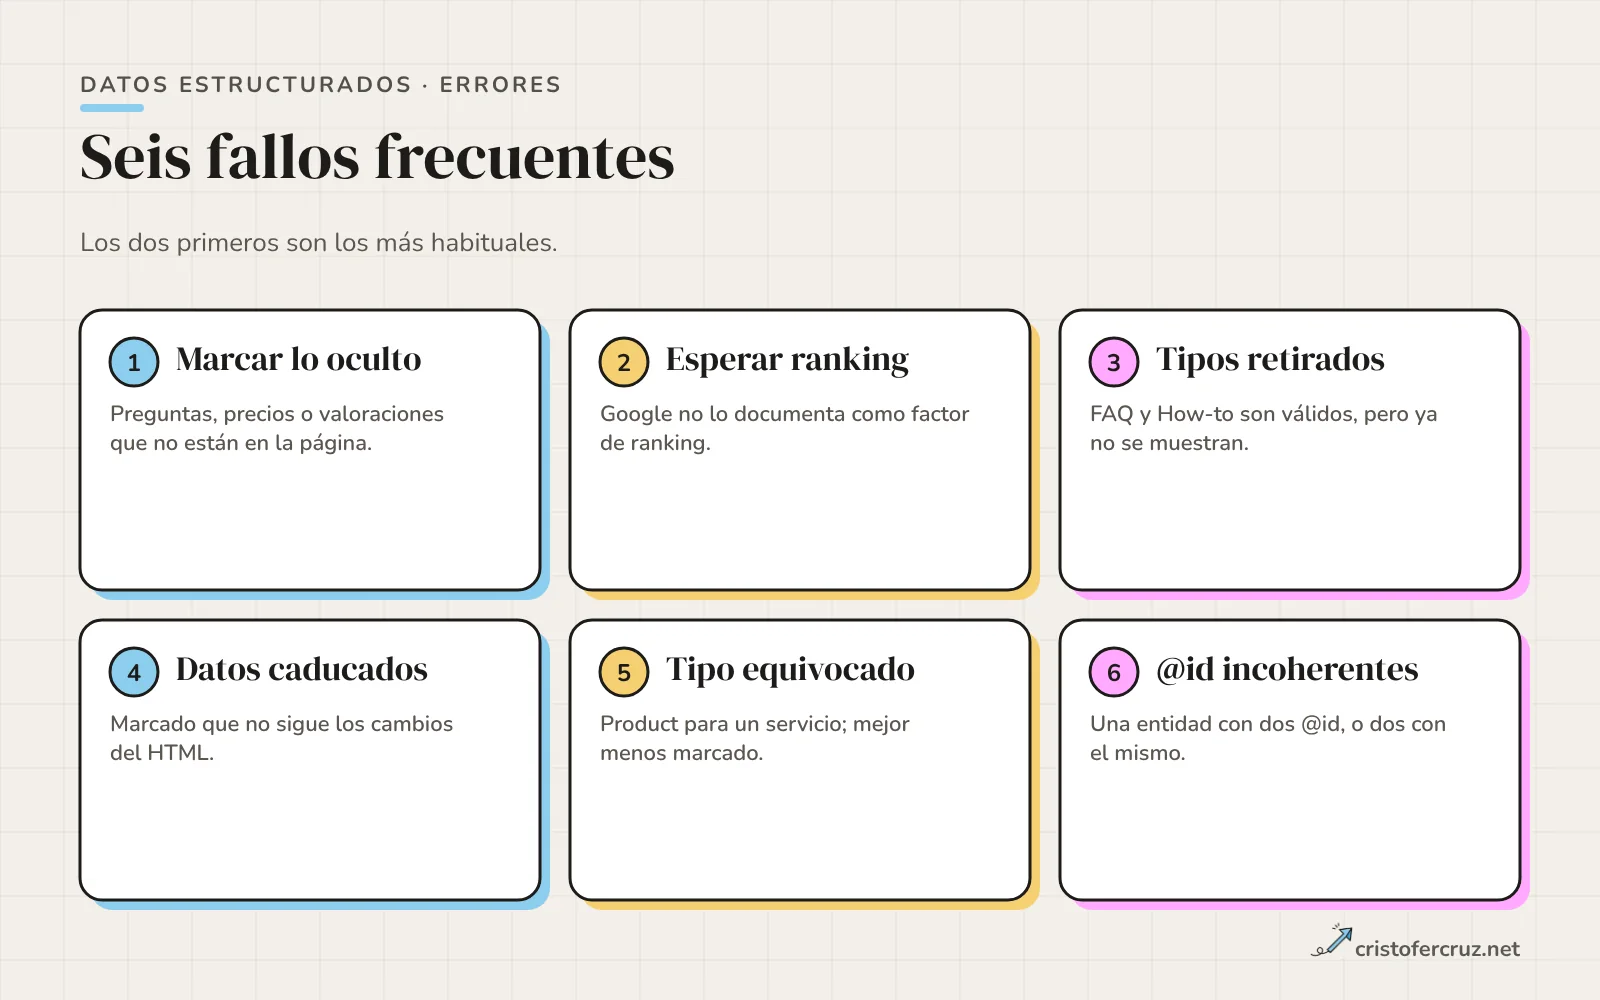
- Marcar lo que no se ve. Preguntas, valoraciones o precios que no están en la página. Incumple la política de contenido visible.
- Esperar ranking. Añadir schema para subir posiciones; Google no lo documenta como factor y Mueller lo ha negado.
- Tipos que ya no producen función. FAQPage y HowTo siguen siendo válidos como vocabulario, pero Google no los muestra.
- Datos desactualizados. Un Event pasado o un precio viejo en el marcado, mientras el HTML ya cambió.
- Tipo equivocado. Un Product para un servicio, una Organization con datos de una persona. Si no sabes qué tipo usar, mejor menos marcado que uno incorrecto.
- Identificadores incoherentes. El mismo
@idpara entidades distintas, o dos@idpara una sola.
Preguntas frecuentes
¿Los datos estructurados son un factor de ranking?
No hay documentación de Google que los presente como factor de ranking. Mueller dijo en abril de 2025 que no hacen que tu web posicione mejor. Su función documentada es habilitar resultados enriquecidos y ayudar a entender la página.
¿JSON-LD, Microdata o RDFa?
Google recomienda JSON-LD, pero dice que los tres son igual de válidos si el marcado es correcto. Yo uso JSON-LD porque se genera desde plantilla y no se mezcla con el HTML visible.
¿Sigo necesitando FAQPage?
Para obtener el resultado enriquecido de preguntas, no: Google lo deprecó y dejó de mostrarlo el 7 de mayo de 2026. Si tienes preguntas visibles útiles para el usuario, mantenlas; el marcado ya no aporta función en Google.
¿Y HowTo?
Google dejó de mostrarlo en escritorio el 13 de septiembre de 2023 y lo marcó como deprecado. El marcado es válido, pero sin efecto en resultados.
¿Tengo que marcar la organización en todas las páginas?
No. La documentación de Organization pide el marcado en la home o en una página que describa la organización, y dice expresamente que no hace falta en todas.
¿Puede penalizarme el schema incorrecto?
Un problema grave de datos estructurados puede provocar una acción manual. Según la documentación, la consecuencia es perder la elegibilidad para resultados enriquecidos, sin efecto en el posicionamiento web. Se revisa en el informe de Acciones manuales.
¿Ayuda el schema a salir en AI Overviews?
Google dice en su documentación que no hay ningún schema.org especial que añadir para esas funciones. Mantener el marcado coherente con el texto visible sí es buena práctica.
Qué hacer esta semana
- Abre la galería de búsqueda de Google y tacha de tu lista los tipos que ya no aparecen.
- Saca el JSON-LD de tres plantillas (home, artículo, categoría) y revisa que cada dato coincide con lo visible.
- Lista todos los
@iddel sitio; unifica los duplicados y completa las referencias colgantes. - Pasa home y un artículo por la Prueba de resultados enriquecidos y por el validador de schema.org.
- Revisa en Search Console los informes de resultados enriquecidos de las funciones que sí usas.
Si quieres que lo revise alguien con el código delante, escríbeme y lo vemos. Y si tu duda es cómo encaja el marcado en la visibilidad dentro de buscadores con IA, es lo que trabajo en SEO para LLMs e IA.
Referencias y fuentes
Documentación consultada para este artículo.
- Introduction to structured data markup in Google Search Google Search Central
- General structured data guidelines Google Search Central
- Structured data markup that Google Search supports Google Search Central
- Latest Google Search Documentation Updates Google Search Central
- Organization structured data Google Search Central
- Breadcrumb structured data Google Search Central
- Article structured data Google Search Central
- AI features and your website Google Search Central
- Google Again Says Structured Data Does Not Make Your Site Rank Better Search Engine Roundtable
- Google Completely Removes How-To Rich Results Search Engine Journal