- Google solo descubre enlaces que sean
<a>con atributohref; unonclicko unrouterLinksinhrefno es fiable para el rastreo. - Para el enrutado en cliente, usa la History API. Los fragmentos (
#) no sirven para cargar contenido distinto. - Una SPA que responde 200 a todo genera soft 404. Redirige a una URL que devuelva 404 o añade
noindexcuando el contenido no exista. - Si el HTML original lleva
noindex, Google puede saltarse el renderizado: no cuentes con que un script lo quite. - Bloquear en robots.txt los JS o la API de la que depende el contenido impide que Google renderice la página como la ve un usuario.
- Se depura comparando el código fuente con el HTML renderizado en la Inspección de URLs, no mirando solo lo que ves en el navegador.
El error más caro que veo con JavaScript no es elegir mal el framework: es un enlace sin href, una ruta que devuelve 200 cuando no existe o un script bloqueado en robots.txt. Son fallos pequeños que dejan páginas sin descubrir, sin indexar o indexadas con contenido de error, y que no aparecen si solo revisas la web en tu navegador.
Aquí no repito la comparativa entre CSR, SSR, SSG e ISR, que ya tienes en mi artículo sobre estrategias de renderizado. Me centro en las buenas prácticas que Google documenta para JavaScript, en cómo se depura y en qué hace mi propia web, que es PHP con HTML renderizado en el servidor y JavaScript solo como mejora.
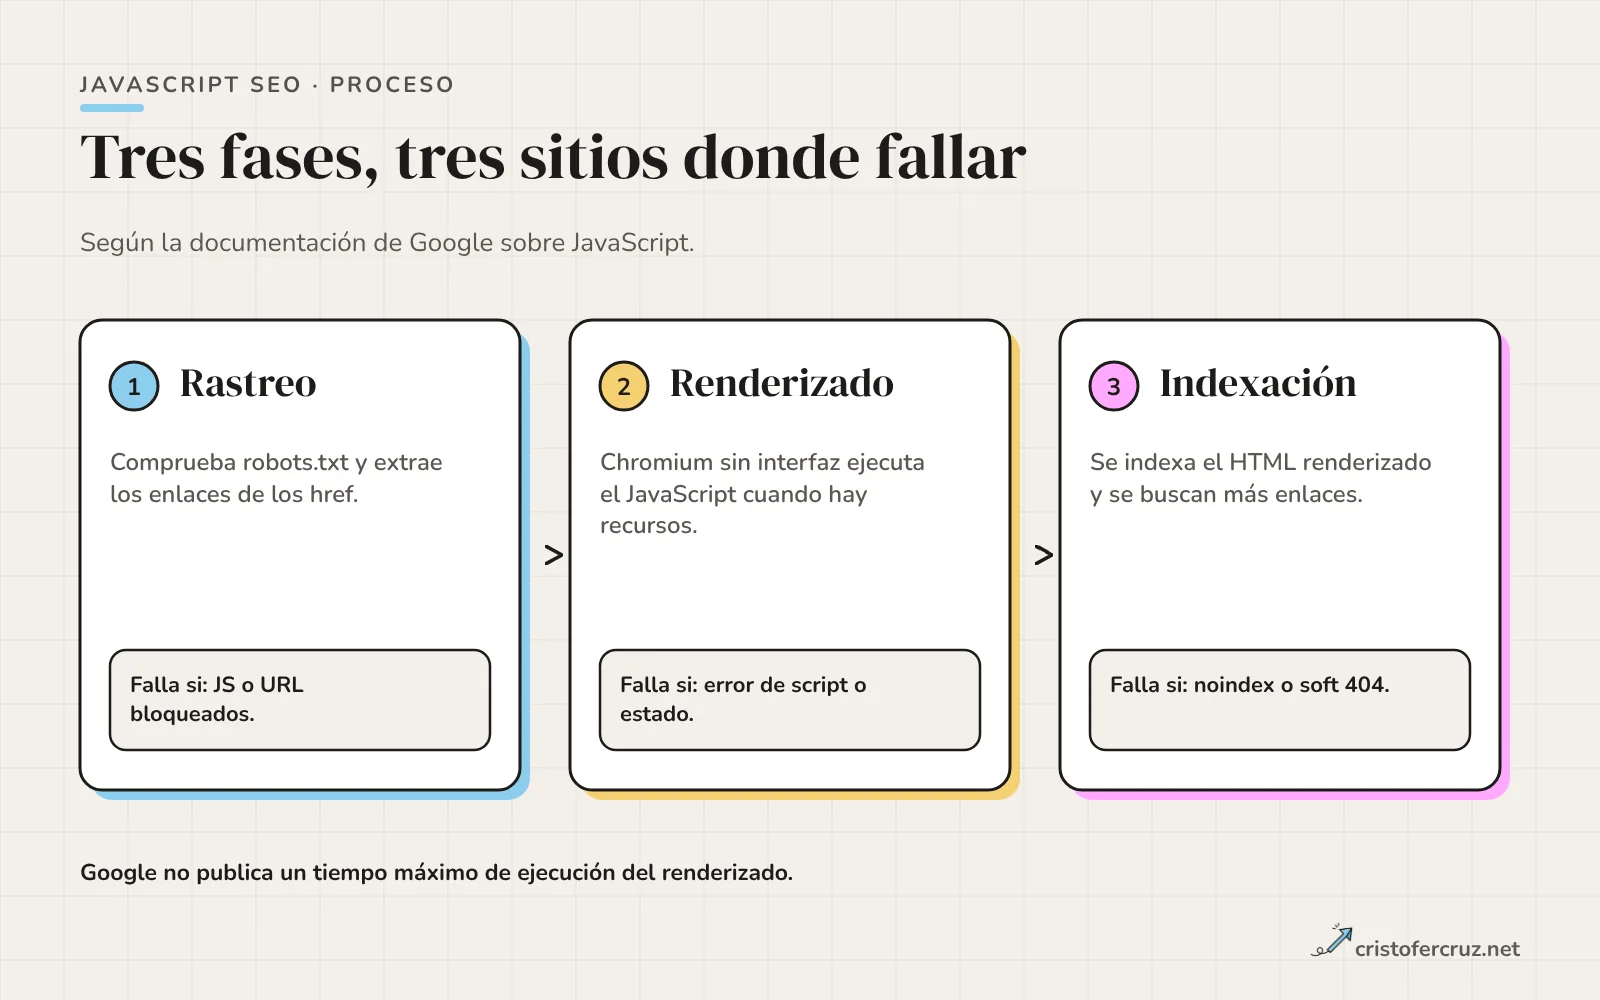
Cómo procesa Google el JavaScript y qué no dice
Google describe tres fases: rastreo, renderizado e indexación. Primero comprueba robots.txt; si la URL está bloqueada, Googlebot ni siquiera hace la petición HTTP. Si no lo está, descarga el HTML y extrae los enlaces de los atributos href. Cuando hay recursos disponibles, un Chromium sin interfaz ejecuta el JavaScript, y el HTML resultante se vuelve a analizar en busca de enlaces y se usa para indexar la página.
Ese renderizado lo hace el Web Rendering Service (WRS). Lo documentado es poco y conviene no inflarlo: la página puede esperar en cola «unos segundos», aunque «puede tardar más»; Google no publica un tiempo máximo de ejecución ni un límite numérico de recursos. Lo que sí está escrito son restricciones concretas, que resumo en esta tabla.
| Límite o comportamiento del WRS | Qué implica para ti |
|---|---|
| No retiene estado entre cargas: ni Local Storage, ni Session Storage, ni cookies | El contenido no puede depender de algo guardado en una visita anterior |
| Puede ignorar las cabeceras de caché | Si cambias un script con el mismo nombre, puede ejecutar la versión vieja: versiona los archivos en el nombre |
| Rechaza peticiones de permisos, como la cámara | El contenido no debe quedar tras un permiso del navegador |
| Puede no tener ciertas APIs, como WebGL | Detecta la función y ofrece alternativa, o renderiza en servidor |
| Solo usa HTTP; no admite otras conexiones, como WebSockets o WebRTC | Da una vía HTTP para el contenido que cargues por esos canales |
| Las páginas con estado distinto de 200 pueden no renderizarse | Un error con JavaScript posterior no va a «arreglarse» en el render |
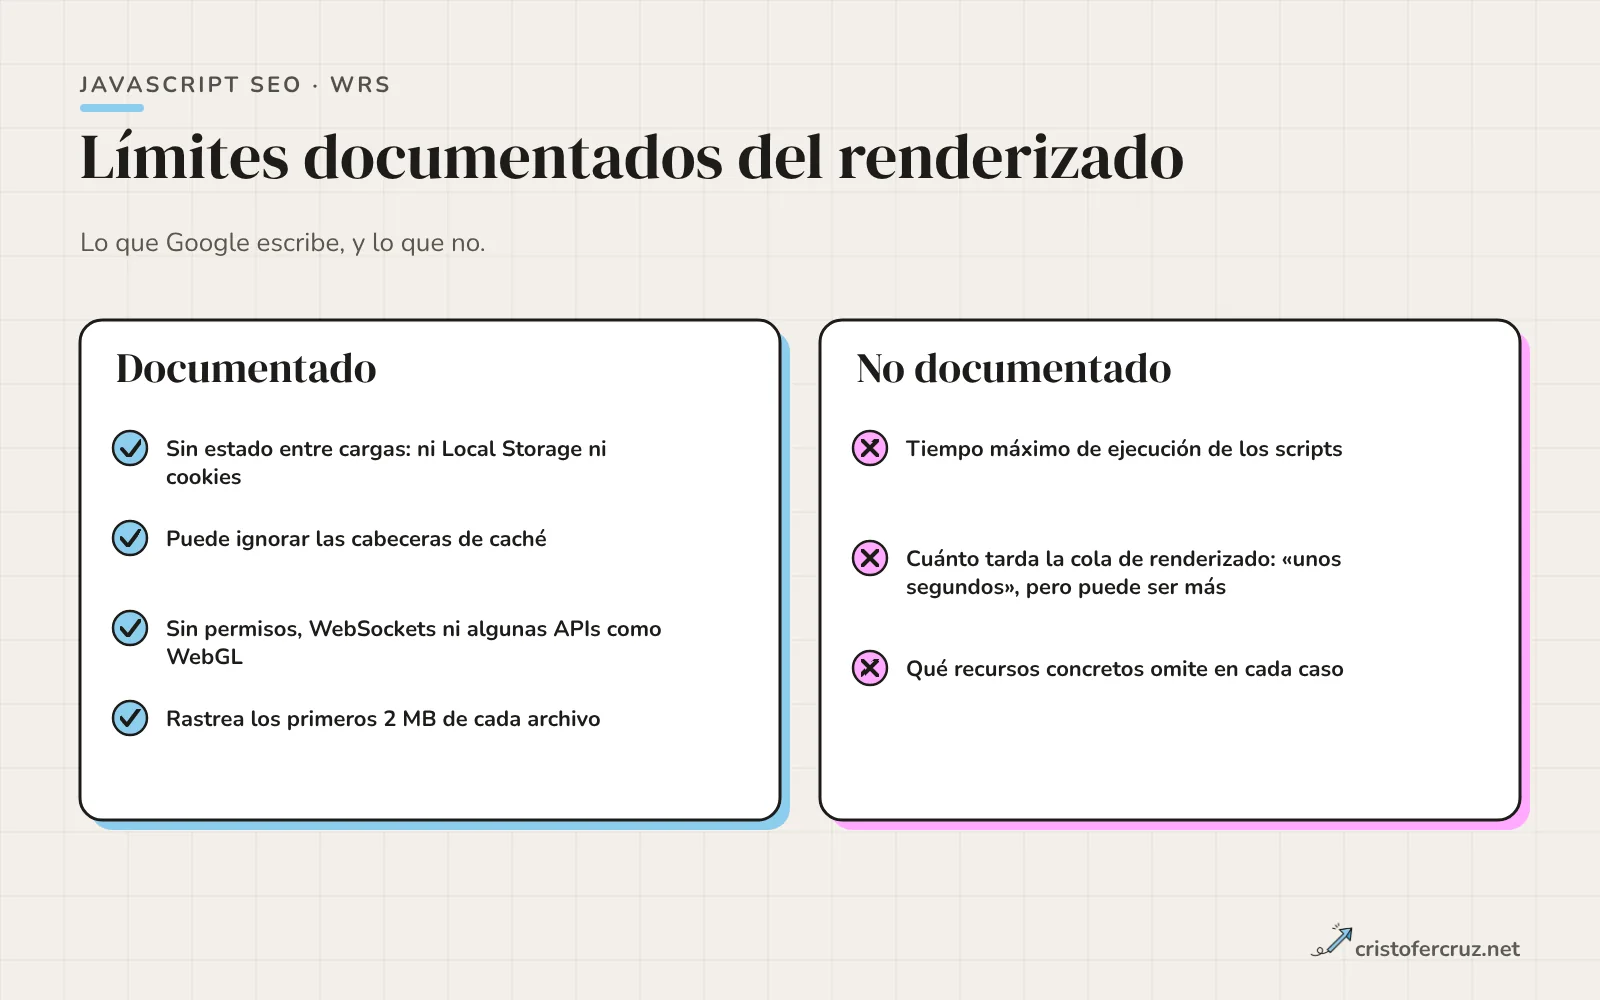
Separado de esto está el tamaño: Googlebot rastrea los primeros 2 MB de un tipo de archivo compatible, medidos sin comprimir, y cada recurso referenciado (un JS, un CSS) se descarga por separado con su propio límite. Un bundle enorme no cuenta contra el HTML, pero si pasa de ese tamaño Google solo recibe la parte descargada.
Sobre la cola de renderizado, el retraso y qué crawlers de IA ejecutan JavaScript, no lo repito: está en el artículo de CSR, SSR, SSG e ISR.
Enlaces rastreables: <a href> o nada
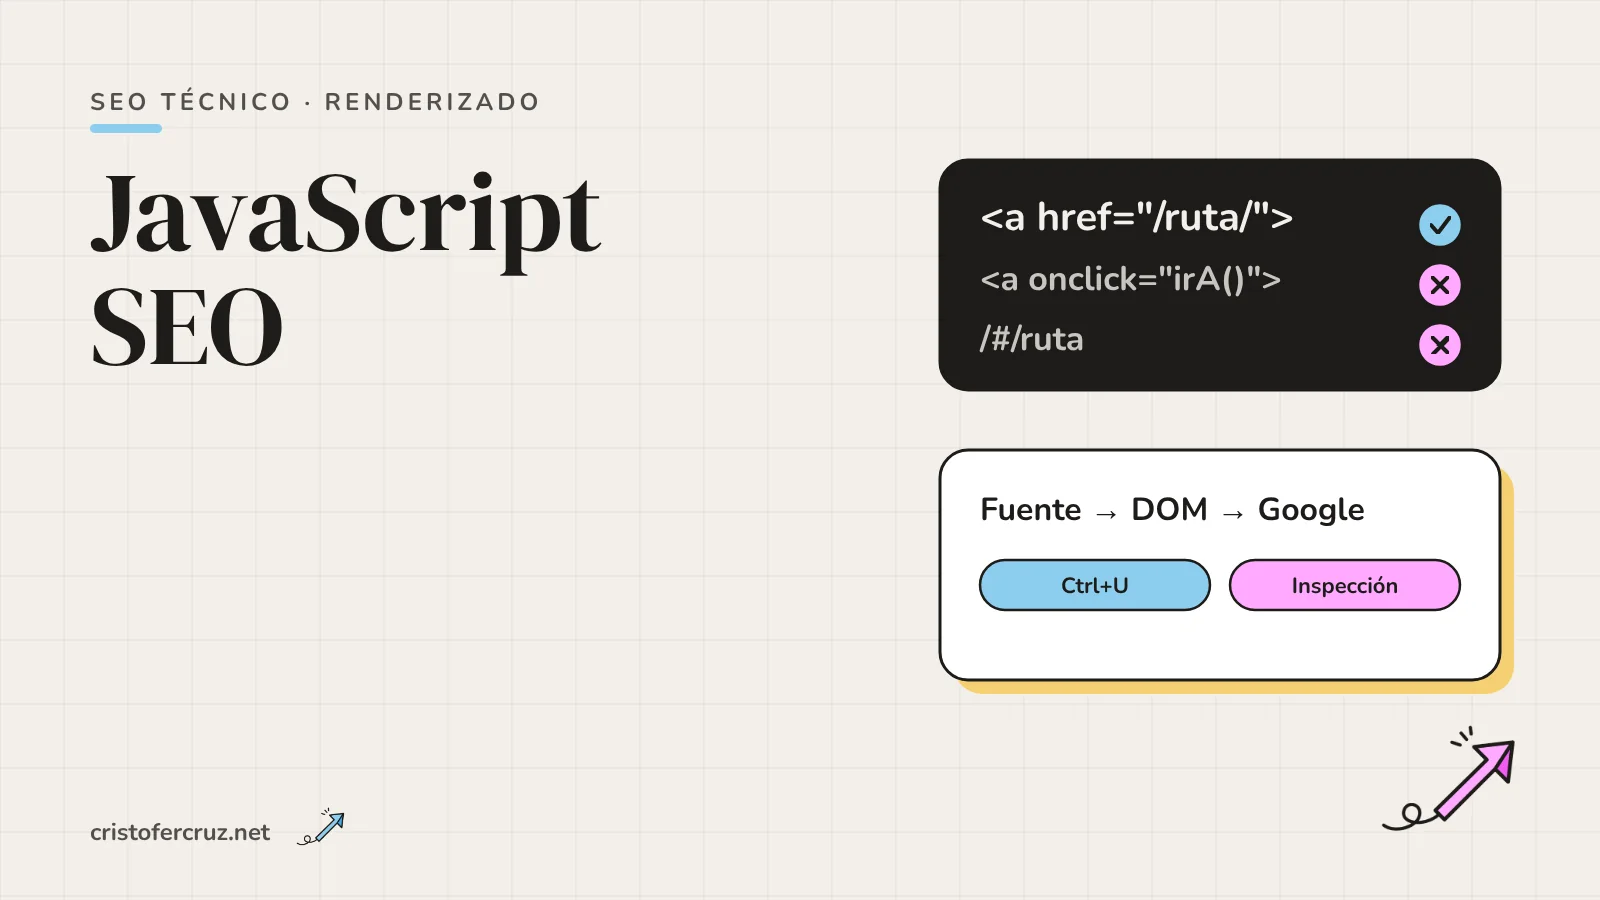
La regla de Google es literal: solo descubre enlaces que sean elementos <a> con atributo href. Las variantes sin href (<span href>, routerLink, un <a onclick> sin destino) figuran como «no recomendadas», aunque Google pueda intentar interpretarlas. Un href="javascript:goTo('x')" tampoco cumple, porque el href debe resolver en una dirección web real que se pueda solicitar.
Lo que sí vale: insertar enlaces con JavaScript, siempre que el resultado sea un <a href> normal, y mantener un onclick junto a un href válido. Eso permite que el router de tu app intercepte el clic sin quitarle al rastreador el destino.
<!-- Rastreable: href real y JS encima -->
<a href="/productos/zapatillas/" onclick="irA('zapatillas'); return false;">Zapatillas</a>

<!-- No fiable: sin href -->
<span onclick="irA('zapatillas')">Zapatillas</span>
<a onclick="irA('zapatillas')">Zapatillas</a>

<!-- No cumple: el href no es una URL -->
<a href="javascript:irA('zapatillas')">Zapatillas</a>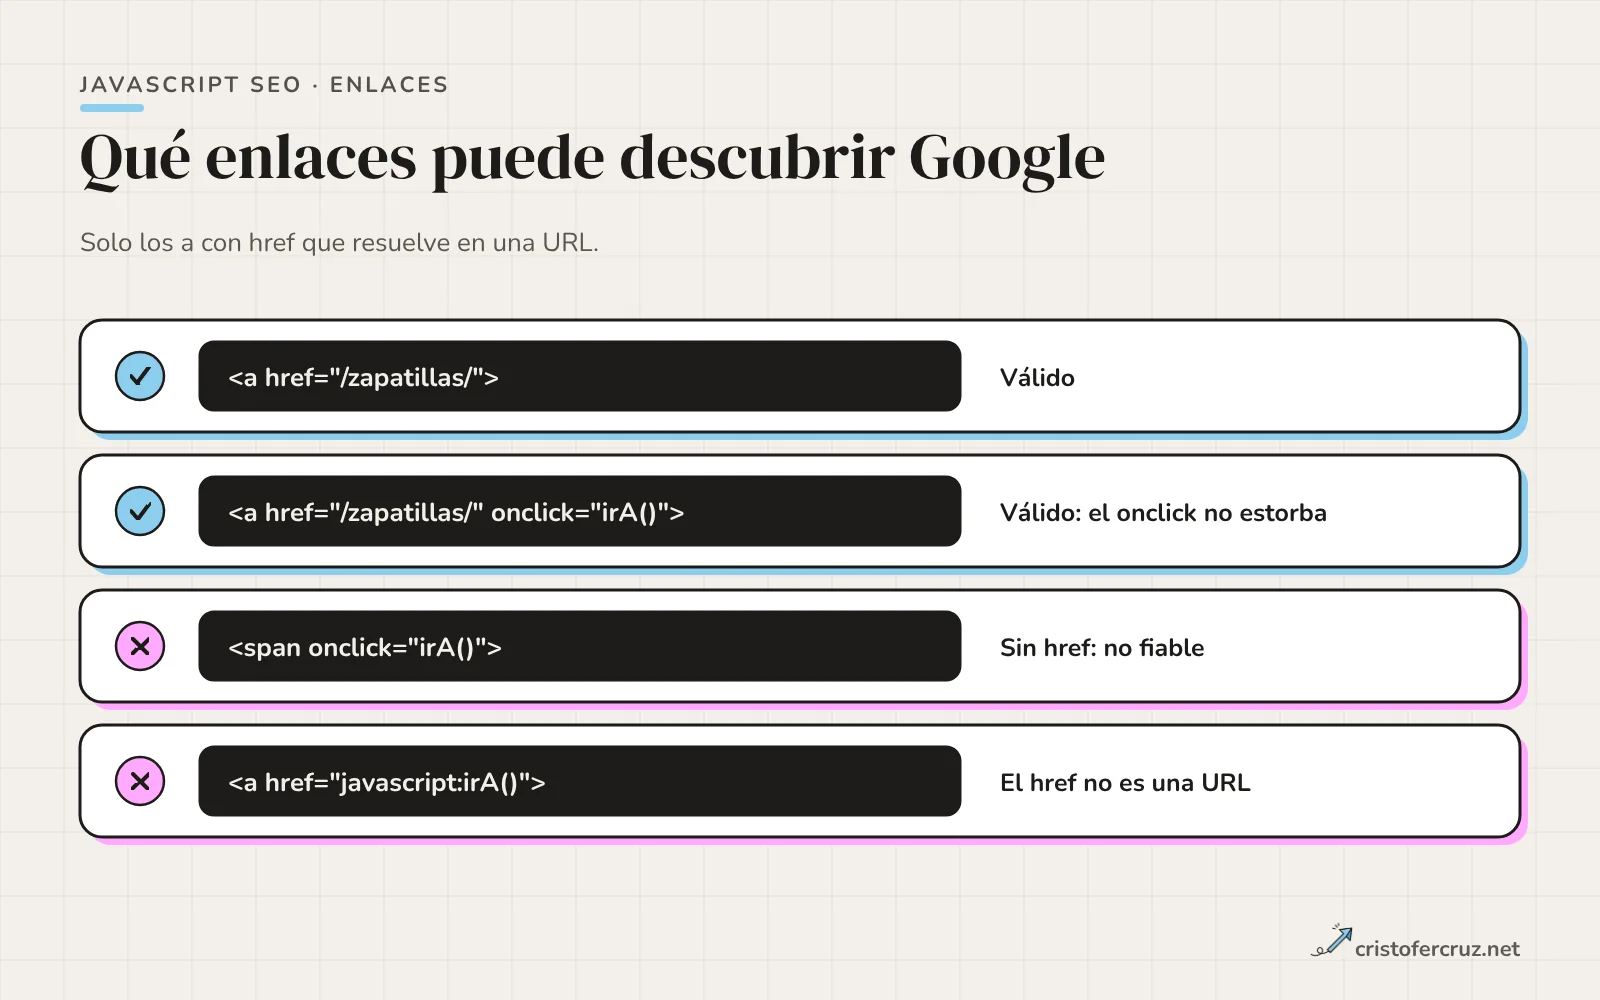
El texto ancla también cuenta con JavaScript: si lo insertas por script, comprueba en el HTML renderizado que está dentro del enlace. Y si el enlace es una imagen, Google usa su alt; un enlace sin texto y con alt vacío no dice nada.
History API frente a fragmentos con #
Una SPA cambia de «página» sin recargar, y la URL tiene que cambiar con ella. La documentación de Google lo dice sin matices: para que Googlebot pueda analizar y extraer tus URLs, no uses fragmentos para cargar contenido distinto. /#/productos y /#/contacto son para el rastreador una sola URL; con la History API, /productos/ y /contacto/ son dos.
// Fragmento: una sola URL para Google
location.hash = '/productos';

// History API: una URL por vista
history.pushState({}, '', '/productos/');
Con la History API hay una condición más: cada URL tiene que funcionar también cuando alguien la abre directamente o Googlebot la solicita, es decir, el servidor debe responder esa ruta con el contenido (o al menos con la app y un estado correcto). Una ruta que solo existe después de navegar desde la home no es una URL rastreable.
Los fragmentos siguen teniendo su sitio: un #seccion que lleva a un ancla dentro de la misma página es correcto y es lo que usa el índice de este artículo.
Título, meta description y canonical con JavaScript
JavaScript puede establecer el título y la meta description, y Google los usará porque indexa el HTML renderizado. Con el canonical, la recomendación es otra: el HTML es el método preferido, y el JavaScript no debería cambiarlo a una URL distinta de la que ya indica el HTML original. Google dice que recogerá el canonical inyectado al renderizar, pero también que canonicals múltiples o en conflicto pueden dar resultados inesperados.
Esto lleva a un fallo habitual en plantillas: el HTML inicial trae un canonical (a menudo el de la home, por una plantilla) y el script añade otro al montar la vista. Hay dos etiquetas, y no controlas cuál manda. Si usas JavaScript para la metainformación, elimina la del servidor o haz que ambas coincidan siempre. Tienes la parte de canonical sin JavaScript en el artículo sobre canonicals.
| Elemento | Con JavaScript | Mi criterio |
|---|---|---|
| Title y meta description | Se leen del HTML renderizado | Ponlos ya en el HTML del servidor; JS solo para actualizar tras navegar |
| Canonical | Se recoge el inyectado, pero HTML preferido | Una sola etiqueta, la misma en HTML y en el DOM |
| JSON-LD | Google lo admite generado con JS; hay que probarlo | En el HTML inicial si puedes; cómo montarlo, en datos estructurados con JSON-LD |
| Meta robots | Se lee del renderizado, con matices (siguiente sección) | No dependas de JS para quitar un noindex |
Códigos de estado y soft 404 en una SPA
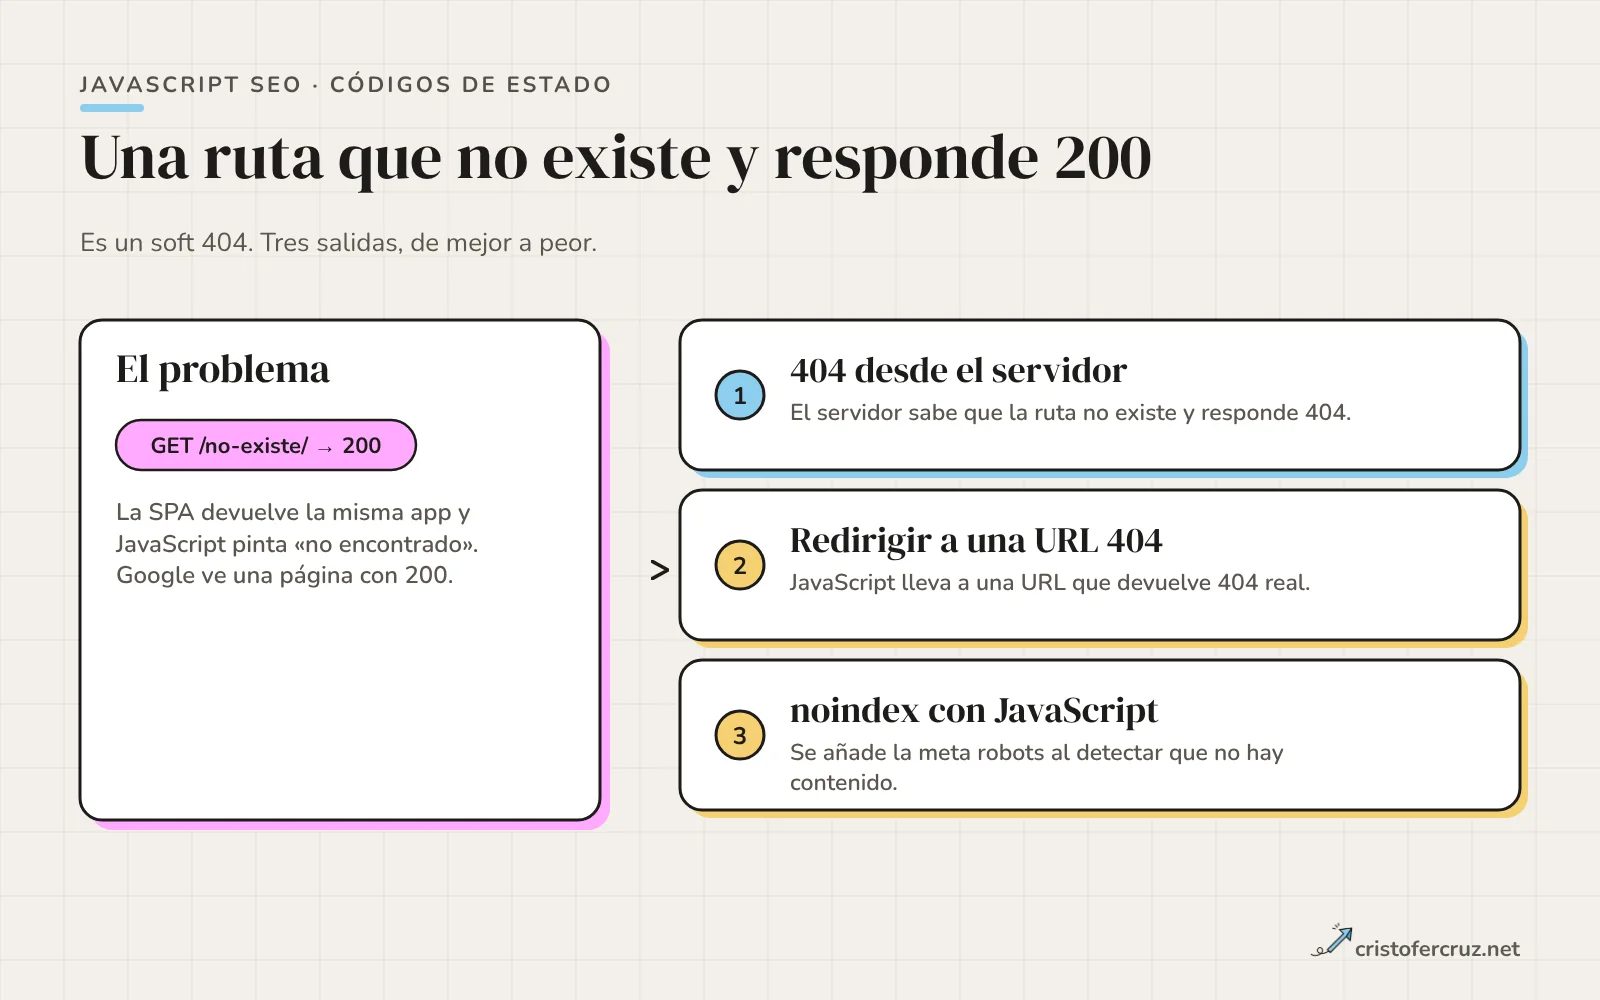
En una app de cliente, la URL /producto-que-no-existe/ suele devolver el mismo HTML con un 200 y es JavaScript quien pinta el aviso de «no encontrado». Google lo advierte: una SPA que gestiona errores en cliente suele reportar un 200 en lugar del código adecuado. El resultado es una página de error candidata a indexarse; en Search Console aparece como soft 404, y el rastreo se gasta en URLs sin valor.
Google propone dos soluciones, que se pueden combinar: redirigir con JavaScript a una URL que devuelva un 404 real, o añadir una meta robots noindex cuando la API indica que el contenido no existe.
// Opción 1: redirigir a una URL que responde 404 en servidor
fetch('/api/producto/123').then(r => {
  if (r.status === 404) window.location.href = '/no-encontrado/';
});

// Opción 2: añadir noindex al detectar que no hay contenido
const m = document.createElement('meta');
m.name = 'robots'; m.content = 'noindex';
document.head.appendChild(m);
La opción buena es evitar el problema: si el servidor sabe que la ruta no existe, que responda 404 antes de enviar la app. Con SSR o PHP es lo normal; en una SPA pura, no. Para el resto de códigos (301, 410, 5xx) vale lo mismo: el estado lo decide el servidor, y un script no puede cambiar el código de una respuesta ya enviada.
noindex y JavaScript: la trampa del HTML original
La regla que más se pasa por alto está en la documentación: cuando Google encuentra noindex, puede saltarse el renderizado y la ejecución de JavaScript. Y la consecuencia directa: si quieres que la página se indexe, no pongas noindex en el código original, ni siquiera con la idea de quitarlo luego con un script. Puede que el script nunca se ejecute.
La dirección contraria sí está documentada: añadir noindex con JavaScript cuando no hay contenido es una de las dos vías oficiales contra los soft 404. Funciona porque Google lee el HTML renderizado. Aun así, para páginas que no quieres indexar y puedes decidirlo en el servidor, es más robusto el noindex en el HTML o en una cabecera X-Robots-Tag, algo que tratamos en el artículo sobre X-Robots-Tag.
Haz esta prueba en cada plantilla: compara la meta robots del código fuente (Ctrl+U) con la del DOM renderizado. Si difieren, tienes un problema o una dependencia de JavaScript que debes decidir a propósito.
robots.txt y recursos JavaScript bloqueados
Google no renderiza JavaScript procedente de archivos bloqueados ni en páginas bloqueadas. Si tu robots.txt tiene un Disallow: /assets/ o Disallow: /static/ por costumbre, Google puede ver la página sin los scripts que construyen el contenido, y lo que indexa se parece poco a lo que ven tus usuarios. Lo mismo ocurre con los endpoints de API de los que depende el contenido: si los bloqueas, el render queda vacío.
Google aplica la regla más específica según la longitud de la ruta, y admite los comodines * y $. Eso te permite bloquear un directorio y permitir los archivos que hacen falta para renderizar, pero lo normal y más seguro es no bloquear nada que sea CSS, JS o la API pública. Los detalles de sintaxis los he tratado en el artículo sobre robots.txt.
Hay un matiz: Google indica que Googlebot y el WRS pueden omitir recursos que no contribuyen al contenido esencial, y recomienda mirar el informe de estadísticas de rastreo para ver qué se pide. Qué recursos concretos omite en cada caso no está documentado.
Lazy-loading y contenido que depende de una interacción
Googlebot no hace scroll ni clics. Por eso Google pide que el lazy-loading cargue todo el contenido relevante cuando sea visible en el viewport, con métodos que no dependan de acciones del usuario: el atributo nativo para imágenes e iframes, la API IntersectionObserver o librerías que carguen al entrar en el viewport. Lo que se carga solo tras un clic en «Ver más» o un evento de scroll puede no verse nunca. Para los iframes, el detalle está en mi guía de lazy loading en iframes sin romper el SEO.
| Patrón | ¿Lo ve Google? | Cómo arreglarlo |
|---|---|---|
loading="lazy" en imágenes | Sí, es un método admitido | No lo uses en la imagen principal visible al cargar |
| IntersectionObserver al entrar en viewport | Sí | Comprueba que la URL de la imagen acaba en el src |
| Botón «Cargar más» que pide datos al hacer clic | No es fiable | URLs paginadas con enlaces reales |
| Scroll infinito sin URLs por tramo | No es fiable | Cada tramo con URL propia, estable y enlazada |
| Pestañas o acordeones que cargan el texto al pulsar | No es fiable | Texto en el HTML, oculto con CSS o details |
Para el scroll infinito Google propone dar a cada tramo una URL persistente y única, con contenido estable, numeración absoluta (?page=12, no ?fecha=ayer), enlazar los tramos entre sí y actualizar la URL con la History API cuando un tramo pasa a ser el principal. No lo hagas con el contenido que el usuario ve nada más llegar: retrasarlo penaliza la carga y es perceptible. La parte de rendimiento de ese retraso la tienes en Core Web Vitals.
Cómo depuro una web con JavaScript, paso a paso
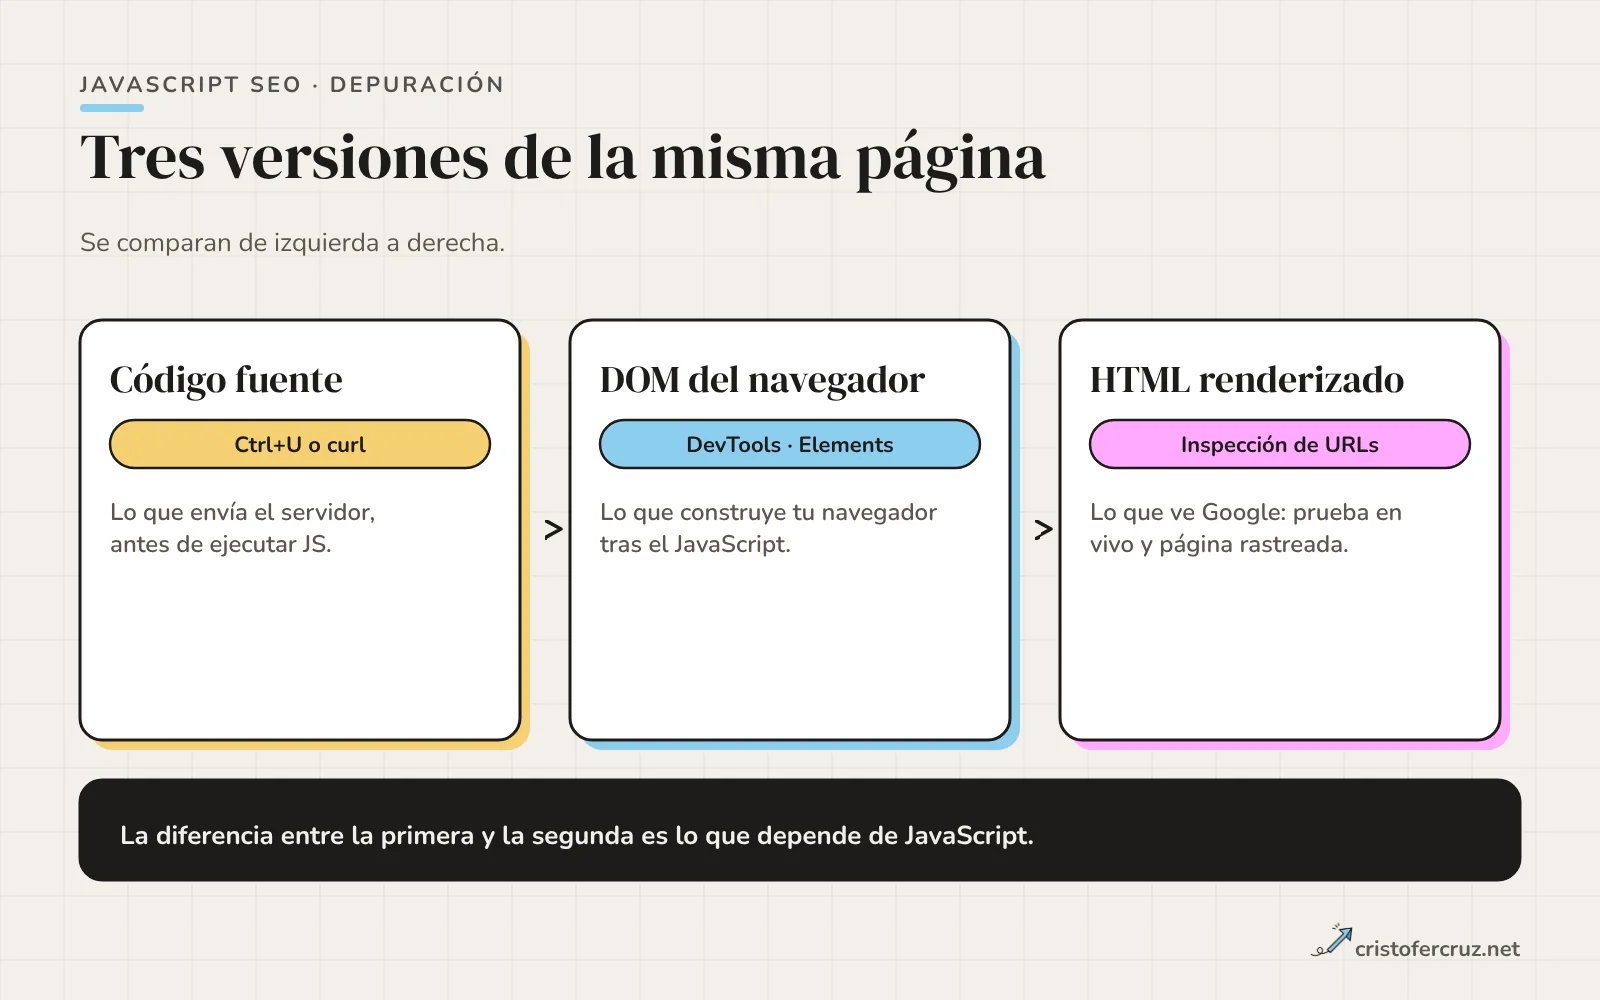
La clave es comparar tres versiones de la página: lo que envía el servidor, lo que construye tu navegador y lo que ve Google. Para cada URL con problemas sigo este orden.
- Código fuente (Ctrl+U o
curl). Es el HTML inicial. Busca el texto principal, los enlaces, el canonical, la meta robots y el JSON-LD. Lo que no esté aquí depende del renderizado. - DOM en DevTools (pestaña Elements). Es lo que ha construido tu navegador tras ejecutar el JavaScript. La diferencia con el paso 1 es el contenido que depende de JS.
- Inspección de URLs en Search Console. Con «Probar URL publicada» y «Ver página probada», el panel muestra el HTML renderizado, las cabeceras HTTP, la salida de la consola de JavaScript y los recursos cargados. Para la versión ya indexada se usa «Ver página rastreada».
- Consola y errores. Los errores de JavaScript y los recursos que no cargan aparecen en la prueba; un error que rompe el script es una causa típica de contenido ausente.
- Búsqueda de una frase exacta. Una frase entre comillas del texto que depende de JS, en Google, indica si ese contenido está en el índice.
Un detalle de la herramienta: la captura de pantalla de la página renderizada solo está disponible en una prueba en tiempo real. Y una limitación mía: la Inspección de URLs prueba una URL cada vez; para auditar muchas a la vez uso un rastreador con renderizado de JavaScript, y compruebo después las URLs dudosas en Search Console, que es la fuente oficial. Para un repaso rápido de cómo comparar el código fuente y el HTML renderizado, tienes la sección de auditoría del artículo de renderizado.
Errores típicos con JavaScript y SEO
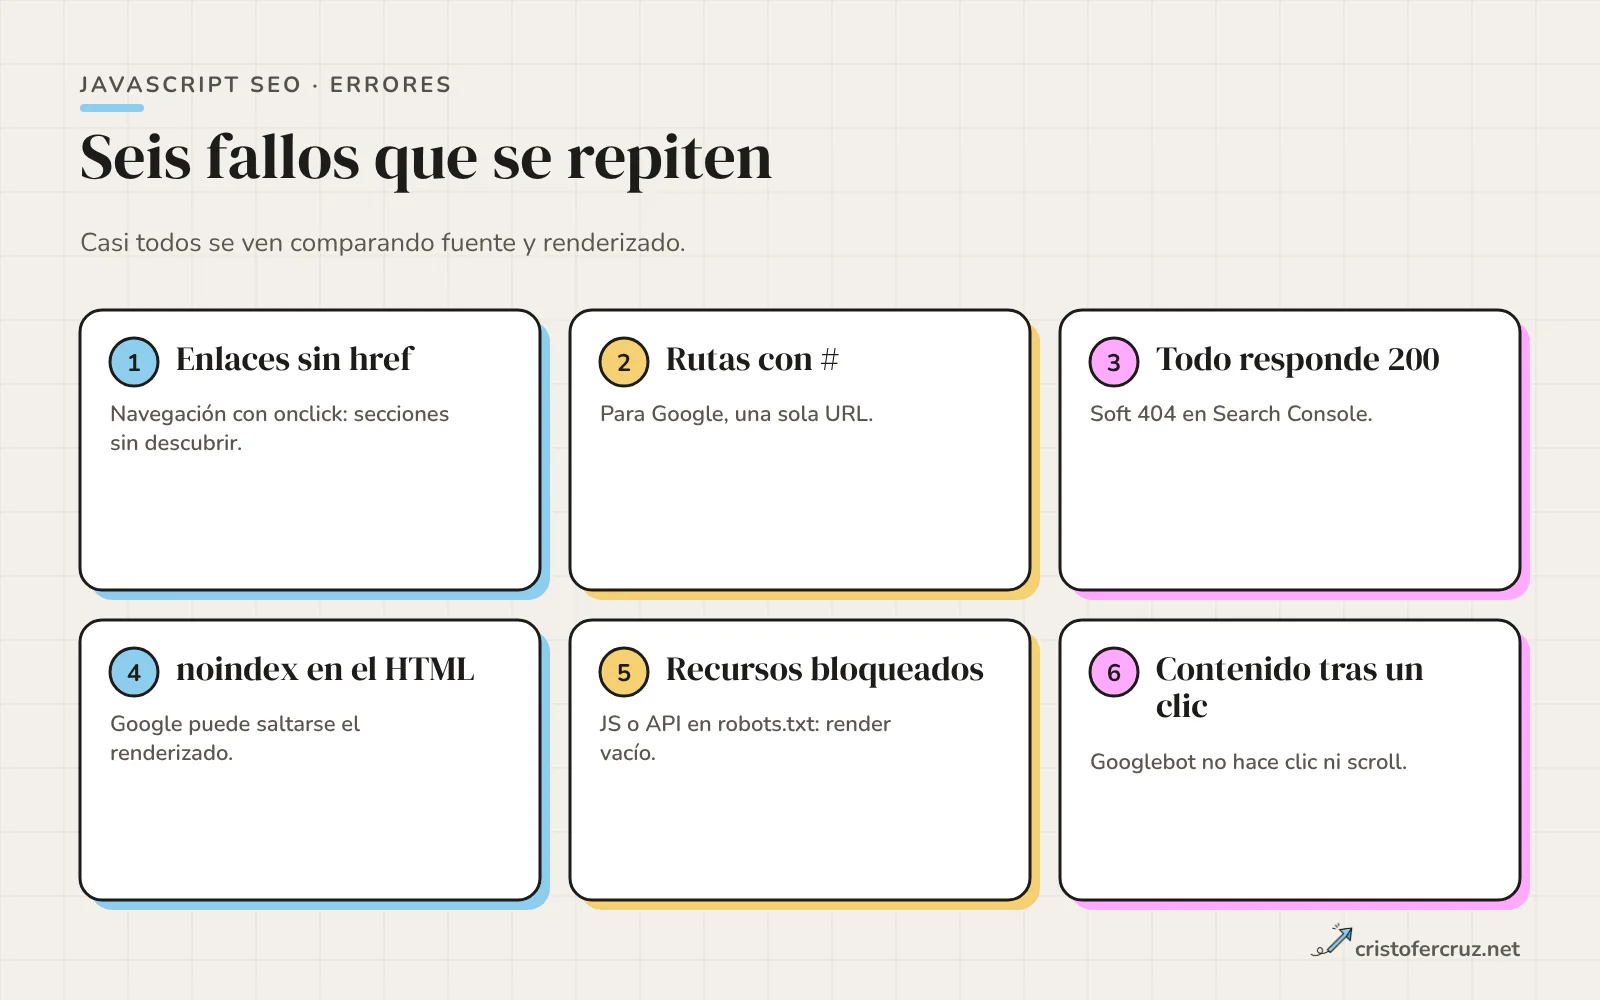
| Error | Síntoma | Corrección |
|---|---|---|
Navegación con onclick y sin href | Secciones enteras sin descubrir | <a href> real |
Rutas con #/ | Una sola URL indexada | History API |
| Todo responde 200 | Soft 404 en Search Console | 404 de servidor, redirección o noindex |
noindex en el HTML y JS que lo quita | Páginas que no se indexan | Quitarlo del HTML original |
| JS o API bloqueados en robots.txt | Render vacío o distinto | Permitir recursos de renderizado |
| Texto que aparece tras un clic | Contenido que no se indexa | Texto en el HTML, no cargado por evento |
| Dos canonicals (HTML y JS) | Canonical elegido por Google | Una sola etiqueta coherente |
| Contenido de pago oculto con JS | Texto visible en código fuente | Servidor envía el texto completo solo con suscripción |
El último caso conviene explicarlo: esconder un contenido con JavaScript no es un control de acceso fiable. Google lo indica para los muros de pago: el servidor debería enviar el contenido completo solo cuando se confirma la suscripción.
Renderizado dinámico: por qué ya no es la respuesta
Servir a los bots una versión prerenderizada y a los usuarios la de JavaScript fue una solución habitual. Hoy Google lo describe como un workaround y no como una solución a largo plazo ni recomendada, por la complejidad y los recursos que exige. Sus alternativas son el renderizado en servidor, el renderizado estático o la hidratación. Si tu proyecto todavía depende de un servicio de prerender, tiene sentido planificar la salida, con los criterios del artículo de estrategias de renderizado.
Cómo lo tengo yo: PHP en servidor y JavaScript solo como mejora
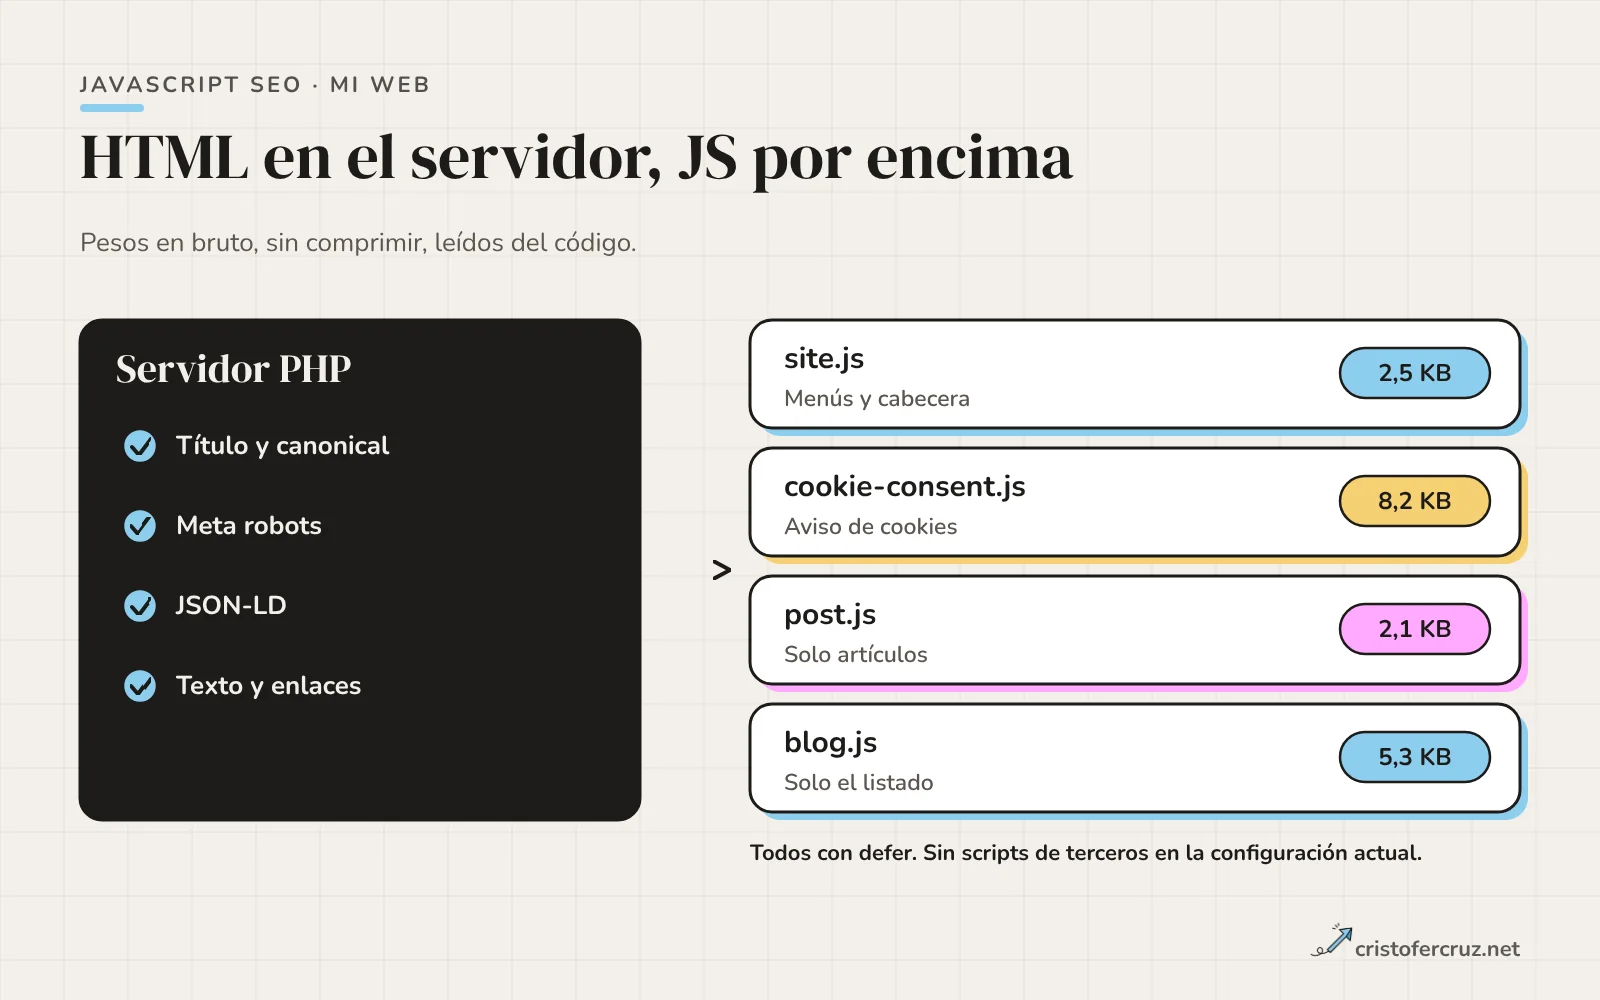
Mi web es PHP: cada URL devuelve el HTML completo desde el servidor, con el título, el canonical, la meta robots y el JSON-LD ya en el código fuente. No hay una app de cliente que construya las páginas. El JavaScript lo añade solo como mejora, y esto es lo que he verificado leyendo el código del sitio.
| Archivo | Dónde se carga | Peso en bruto | Para qué sirve |
|---|---|---|---|
site.js | Todas las páginas | 2,5 KB | Menús y cabecera; los menús son details nativos y funcionan sin JS |
cookie-consent.js | Todas las páginas | 8,2 KB | Aviso de cookies |
post.js | Artículos | 2,1 KB | Copiar enlace y resumen con sección activa |
blog.js | Listado del blog | 5,3 KB | Búsqueda y filtros sin recargar |
| Herramientas (analizador de logs, redirecciones, schema visual, radar local) | Cada una en su página | De 8 a 93 KB | La herramienta en sí |
Un artículo como este carga, por tanto, unos 13 KB de JavaScript propio en bruto (site.js, cookie-consent.js y post.js), todo con defer. Son tamaños sin comprimir; no he medido el peso transferido. Las copias versionadas que genero para caché tienen exactamente el mismo tamaño que los originales, así que hoy no minifico ese paso.
Los puntos concretos que cumplen lo de arriba:
- Enlaces. Los filtros y la paginación del blog son
<a href>con URL real;blog.jssolo intercepta el clic para evitar la recarga. Sin JavaScript, el clic navega a la misma URL y el servidor devuelve la lista. - History API. El mismo script actualiza la URL con
history.pushState, no con fragmentos. - Canonical y robots desde JS, coherentes con el servidor. Tras filtrar,
blog.jsactualiza el canonical, la meta robots y el título. El servidor ya emite esos mismos valores para esa URL (noindex, followcon búsqueda o categoría; canonical sin filtros), así que el DOM renderizado y el HTML inicial no se contradicen. - Datos de la lista.
blog/feed.php, que usa el script, responde JSON conX-Robots-Tag: noindexyCache-Control: no-store. No está bloqueado en robots.txt, a propósito, porque forma parte de la carga del listado. - robots.txt. Bloqueo solo carpetas internas (
/includes/,/tools/,/tests/…) y el procesamiento de formularios. Los CSS, JS e imágenes públicos están permitidos. - Terceros. En la configuración actual todos los proveedores de analítica y publicidad están desactivados, así que mis páginas no cargan scripts de terceros. Si los activo, se insertarán solo tras el consentimiento.
Lo que no he verificado: cómo trata el WRS el sondeo periódico que hace blog.js para avisar de artículos nuevos (no está documentado) ni cómo se ve cada página en la Inspección de URLs. Lo primero no afecta al contenido, que ya está en el HTML. Lo segundo lo reviso con el procedimiento de la sección anterior.
Cuándo un enfoque con mucho JavaScript sí compensa
Una aplicación con login, un panel o una herramienta no necesita posicionar sus pantallas internas, y ahí el JavaScript del lado del cliente es razonable. El problema aparece cuando una app así convive con páginas que sí quieres posicionar (la home, categorías, fichas, blog) y todas comparten el mismo enfoque. La separación que recomiendo es clara: lo que debe rankear sale con el contenido en el HTML; lo que es interacción, se carga encima. Es el principio de mejora progresiva, y lo que decida el equipo técnico sobre el framework tiene que partir de esa lista de URLs, no de la preferencia del desarrollador.
Checklist de verificación antes de publicar
| Comprobación | Cómo |
|---|---|
Cada enlace de navegación es <a href> | Inspeccionar el DOM o rastrear con JS desactivado |
Cada vista tiene su URL sin # | Abrir la URL directamente en una ventana nueva |
| Una ruta inexistente no responde 200 | curl -I a una URL inventada |
| Meta robots y canonical iguales en fuente y DOM | Ctrl+U frente a Elements |
| Los scripts y la API no están bloqueados | robots.txt y «Ver página probada» |
| El texto principal está en el HTML renderizado | Inspección de URLs |
| Nada esencial depende de un clic, scroll o permiso | Probar la página sin interactuar |
Si quieres que revise cómo se renderiza tu web y qué ve Google de verdad, es una parte habitual de mi auditoría SEO; si lo que necesitas es acompañamiento continuo con tu equipo técnico, lo trabajo en una consultoría SEO, y si prefieres hablarlo antes, puedes escribirme.
Preguntas frecuentes
¿Google puede rastrear e indexar JavaScript?
Sí. Renderiza las páginas con un Chromium sin interfaz y usa el HTML renderizado para indexar. Lo que no garantiza es cuándo: la página puede esperar en cola, y hay restricciones documentadas, como la ausencia de estado entre cargas o de algunas APIs.
¿Es obligatorio usar SSR para posicionar?
No es obligatorio, pero Google recomienda el renderizado en servidor, el estático o la hidratación frente al renderizado dinámico. Una web con CSR puede indexarse; lo que gana el HTML servido ya hecho es que no depende del renderizado en cola.
¿Los enlaces con onclick cuentan para SEO?
Solo si además llevan un href válido. Google descubre enlaces que sean <a> con href; un onclick sin destino aparece como no recomendado, aunque Google pueda intentar interpretarlo.
¿Puedo usar # en las URLs de una SPA?
No para cargar contenido distinto. Google indica que no se usen fragmentos para ello y que se emplee la History API. Un fragmento como ancla dentro de una página sí es correcto.
¿Puedo quitar un noindex con JavaScript?
No cuentes con ello. Google puede saltarse el renderizado cuando encuentra noindex en el HTML original, así que el script que lo retira puede no ejecutarse. Si la página debe indexarse, que el HTML original no lleve noindex.
¿Cómo evito los soft 404 en una SPA?
Con una redirección por JavaScript a una URL que devuelva un 404 real o añadiendo una meta robots noindex cuando el contenido no existe. Lo más sólido es que el servidor responda 404 directamente.
¿Cómo veo lo que Google ve de mi JavaScript?
Con la Inspección de URLs de Search Console: «Probar URL publicada» y «Ver página probada» muestran el HTML renderizado, las cabeceras, la consola de JavaScript y los recursos cargados. Compáralo con el código fuente de la página.
Referencias
- Understand JavaScript SEO basics Google Search Central
- Fix Search-related JavaScript problems Google Search Central
- Make your links crawlable Google Search Central
- Fix lazy-loaded content Google Search Central
- Dynamic rendering as a workaround Google Search Central
- Googlebot Google Search Central
- Cómo interpreta Google las especificaciones de robots.txt Google Search Central
- Herramienta de inspección de URLs Ayuda de Search Console