- Regex busca patrones en texto plano; XPath y los selectores CSS navegan por el árbol del HTML. Mezclarlos es la causa de la mayoría de extracciones que fallan.
- Google usa la sintaxis RE2 en sus filtros: no admite lookahead ni referencias hacia atrás. Apache, nginx y
grep -Pusan PCRE, que sí los admite. - En Looker Studio
REGEXP_MATCHexige que la expresión cubra el valor entero; en Search Console el filtro es parcial salvo que anclas con^y$. - XPath puede subir al padre y filtrar por texto; los selectores CSS son más cortos y los entiende cualquier librería. En XPath 1.0 no existe
ends-with(). - Una regex sobre el HTML fuente también casa con comentarios y bloques de código: en mi artículo de hreflang encontró 14 etiquetas donde XPath encontró 2.
- Todas las recetas de este artículo las ejecuté antes de publicarlas. Las que no pude probar, lo digo.
Casi toda la ayuda que circula sobre «regex para SEO» se queda en una lista de patrones para Search Console. El problema aparece después: copias un patrón con lookahead en un filtro de Google y no devuelve nada, usas una regex para sacar el canonical y recoges también el que estaba comentado, o escribes [0-9]{4} en una regla de nginx y el servidor se niega a arrancar.
Aquí junto los tres lenguajes que más uso para extraer y filtrar datos (expresiones regulares, XPath y selectores CSS), con sus diferencias reales, recetas ejecutadas sobre HTML de ejemplo y sobre mi propia web, y las trampas que me he encontrado.
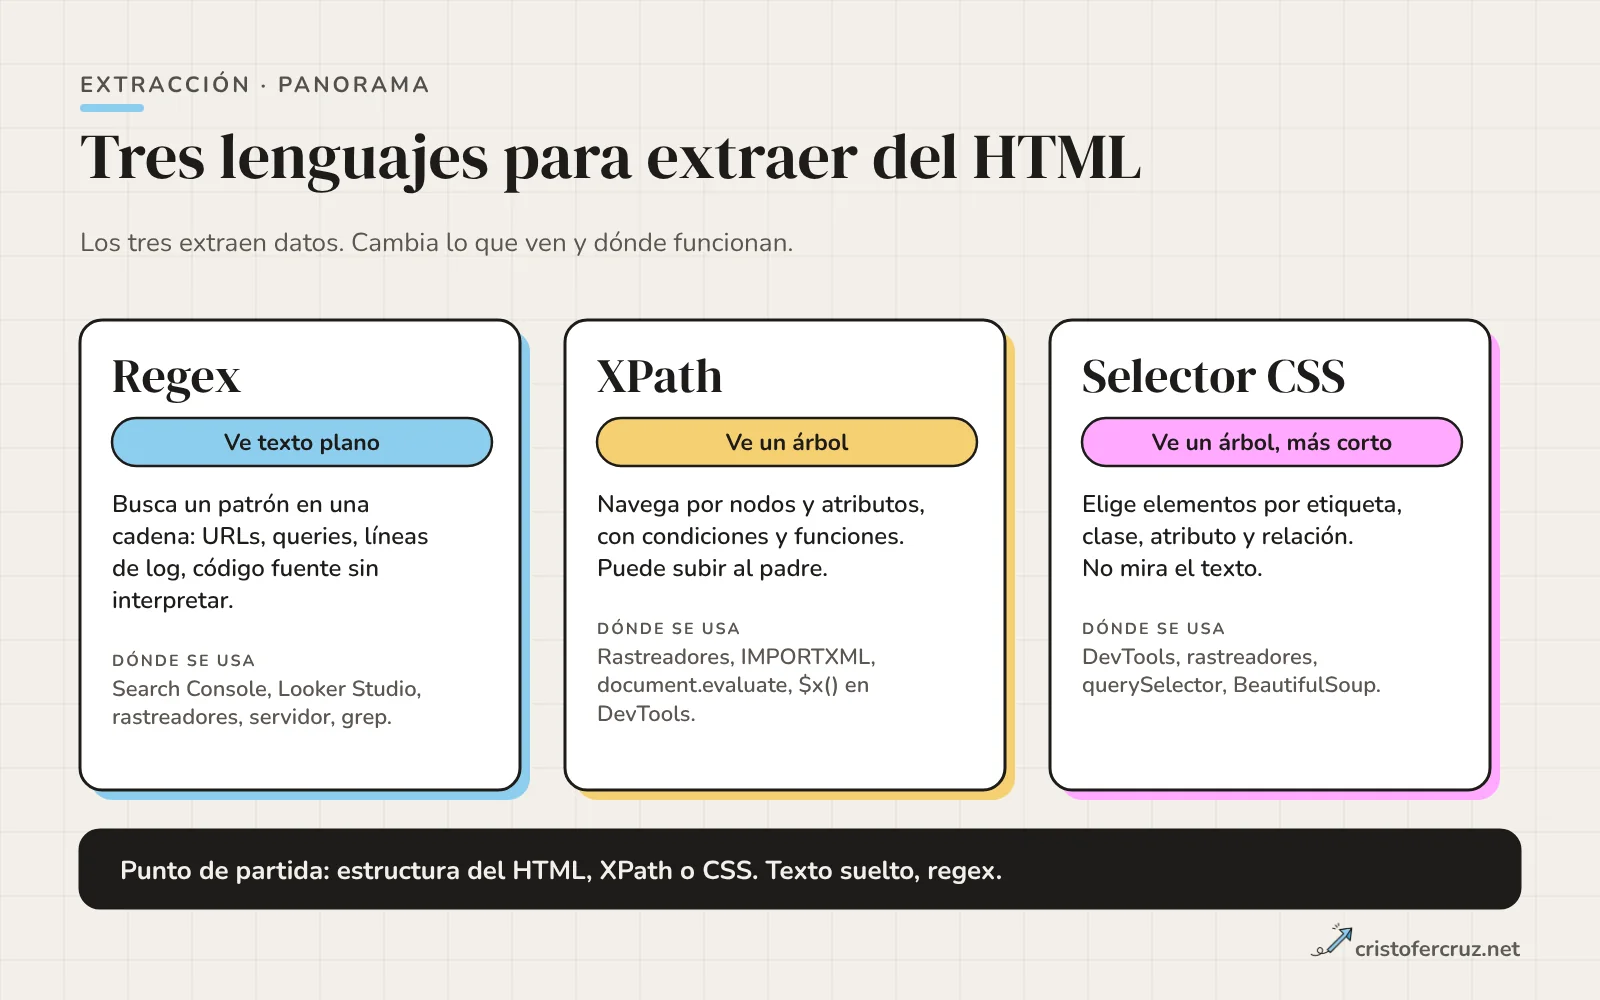
Tres lenguajes, tres problemas distintos
Conviene separarlos porque miran el documento de forma diferente. Una expresión regular trata el HTML como una cadena de caracteres y no sabe qué es una etiqueta. XPath y los selectores CSS trabajan sobre el árbol que construye un parser: saben qué es un <link>, qué atributos tiene y quién es su padre.
| Lenguaje | Qué recibe | Dónde lo uso | Punto débil |
|---|---|---|---|
| Regex | Una cadena | Filtros de Search Console, Looker Studio, logs, reglas de servidor, rastreadores | No entiende la estructura; cada motor tiene su dialecto |
| XPath | Un árbol (DOM) | Rastreadores, IMPORTXML de Google Sheets, document.evaluate, $x() | Sintaxis larga; en navegadores solo XPath 1.0 |
| Selector CSS | Un árbol (DOM) | DevTools, rastreadores, querySelector, BeautifulSoup | No selecciona por texto ni sube al padre (salvo con :has()) |
Mi regla de partida: si el dato vive en la estructura (canonical, H1, atributo rel), XPath o CSS; si está en una cadena sin estructura (una URL, una query, una línea de log), regex. Más abajo la afino con una tabla.
Regex: RE2 y PCRE son dos dialectos
El primer error con las regex es creer que existe una sola. Los filtros de Google (Search Console, Looker Studio) usan RE2; Apache, nginx y grep -P usan PCRE. Casi todo lo cotidiano (clases, grupos, alternancia, .*?) funciona igual en ambos, pero lo que falla en RE2 falla fuerte.
La documentación de RE2 marca como no soportados los lookahead (?=re), los lookbehind (?<=re) y las referencias hacia atrás \1. Lo comprobé compilando patrones con la librería google-re2 para Python:
(?=a)b    -> invalid perl operator: (?=
^/blog/(?!logs)  -> invalid perl operator: (?!
(?<=/)blog  -> invalid perl operator: (?<=
(a)\1     -> invalid escape sequence: \1
Y lo mismo en servidores reales, con Apache 2.4.58 y nginx 1.24.0 arrancados en local:
| Regla | Petición | Resultado |
|---|---|---|
Apache: RewriteRule ^(?!api/)viejo/([^/]+)/$ /nuevo/$1/ [R=301,L] | /viejo/cosa/ | 301 a /nuevo/cosa/ |
| Apache: la misma regla | /api/viejo/cosa/ | 404 (el lookahead la excluye) |
Apache: RewriteRule ^(.+)/\1/?$ /duplicada/$1/ [R=301,L] | /seo/seo/ | 301 a /duplicada/seo/ (referencia hacia atrás) |
nginx: location ~ ^/(?!api/)viejo/(?<slug>[^/]+)/$ { return 301 /nuevo/$slug/; } | /viejo/cosa/ | 301 a /nuevo/cosa/ |
| nginx: la misma regla | /api/viejo/cosa/ | 200 (cae en el location /) |
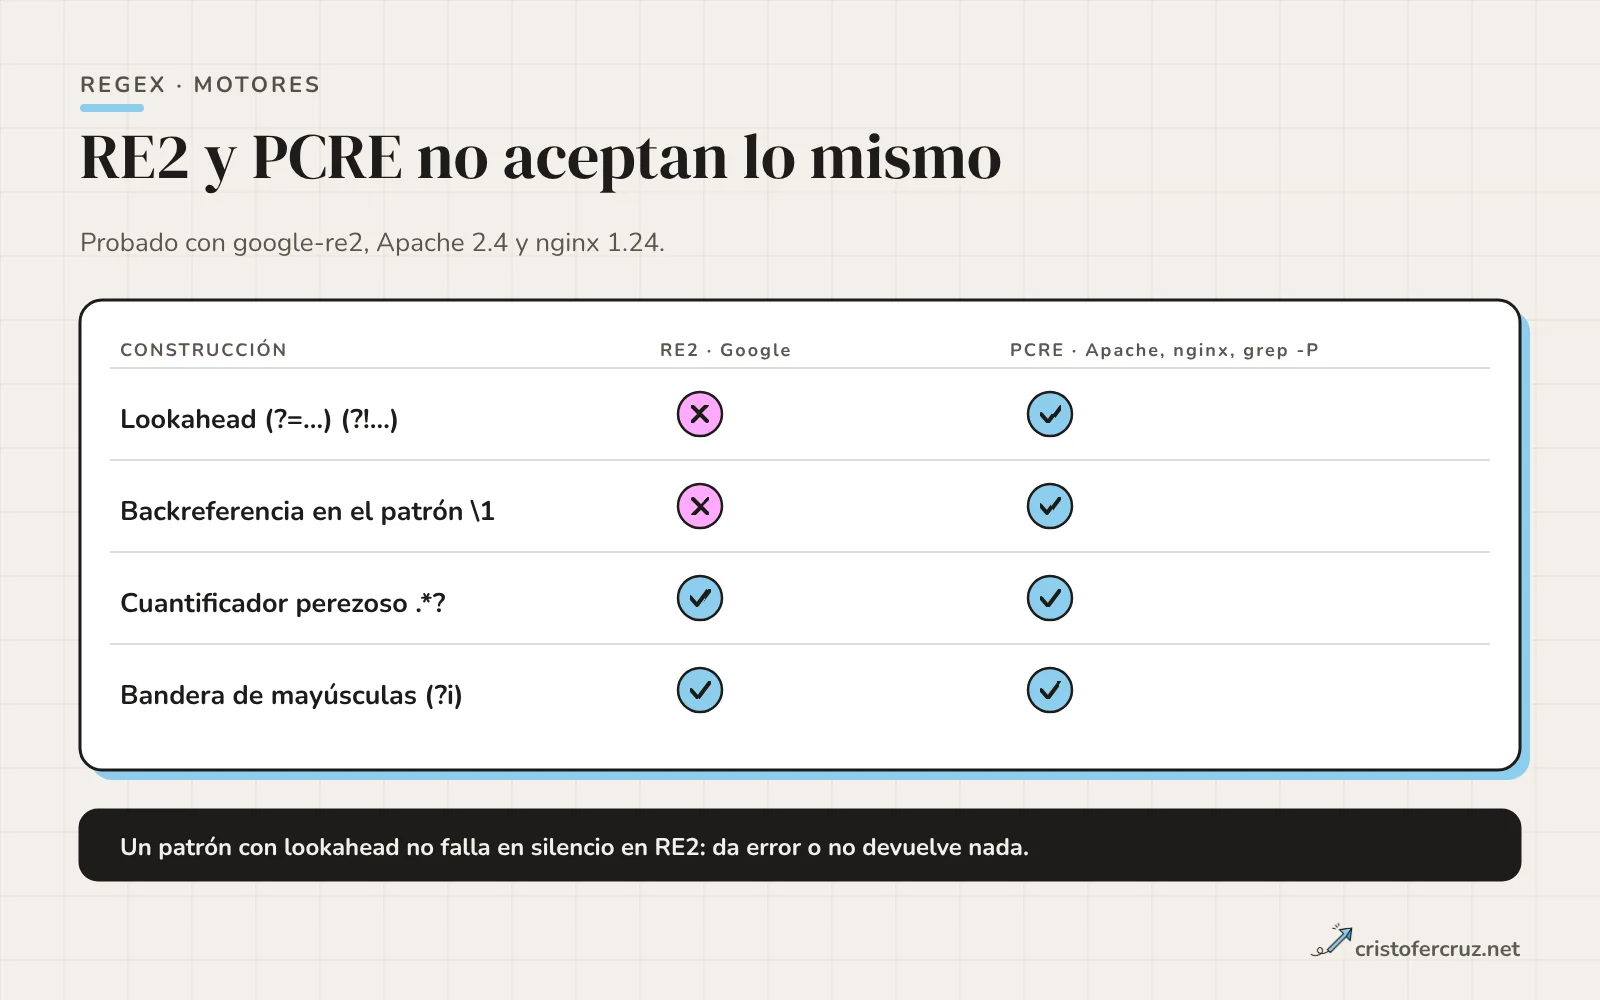
La consecuencia práctica: si necesitas «todas las URLs del blog menos las de un directorio» en Search Console, no puedes usar un lookahead negativo. Tienes que reformular el patrón, por ejemplo con una alternancia explícita de los directorios que sí quieres.
Regex en Search Console y Looker Studio
El filtro «Custom (regex)» del informe de rendimiento se anunció en 2020 para filtrar páginas y consultas, y según las crónicas de la época usa RE2, distingue mayúsculas de minúsculas por defecto y no devuelve resultados si la sintaxis es inválida. Un matiz que debes saber: la página de ayuda que consulté para este artículo no detalla el filtro regex, así que lo que sigue lo apoyo en esas crónicas y en mis pruebas con RE2, no en documentación oficial del filtro. Compruébalo en tu interfaz.
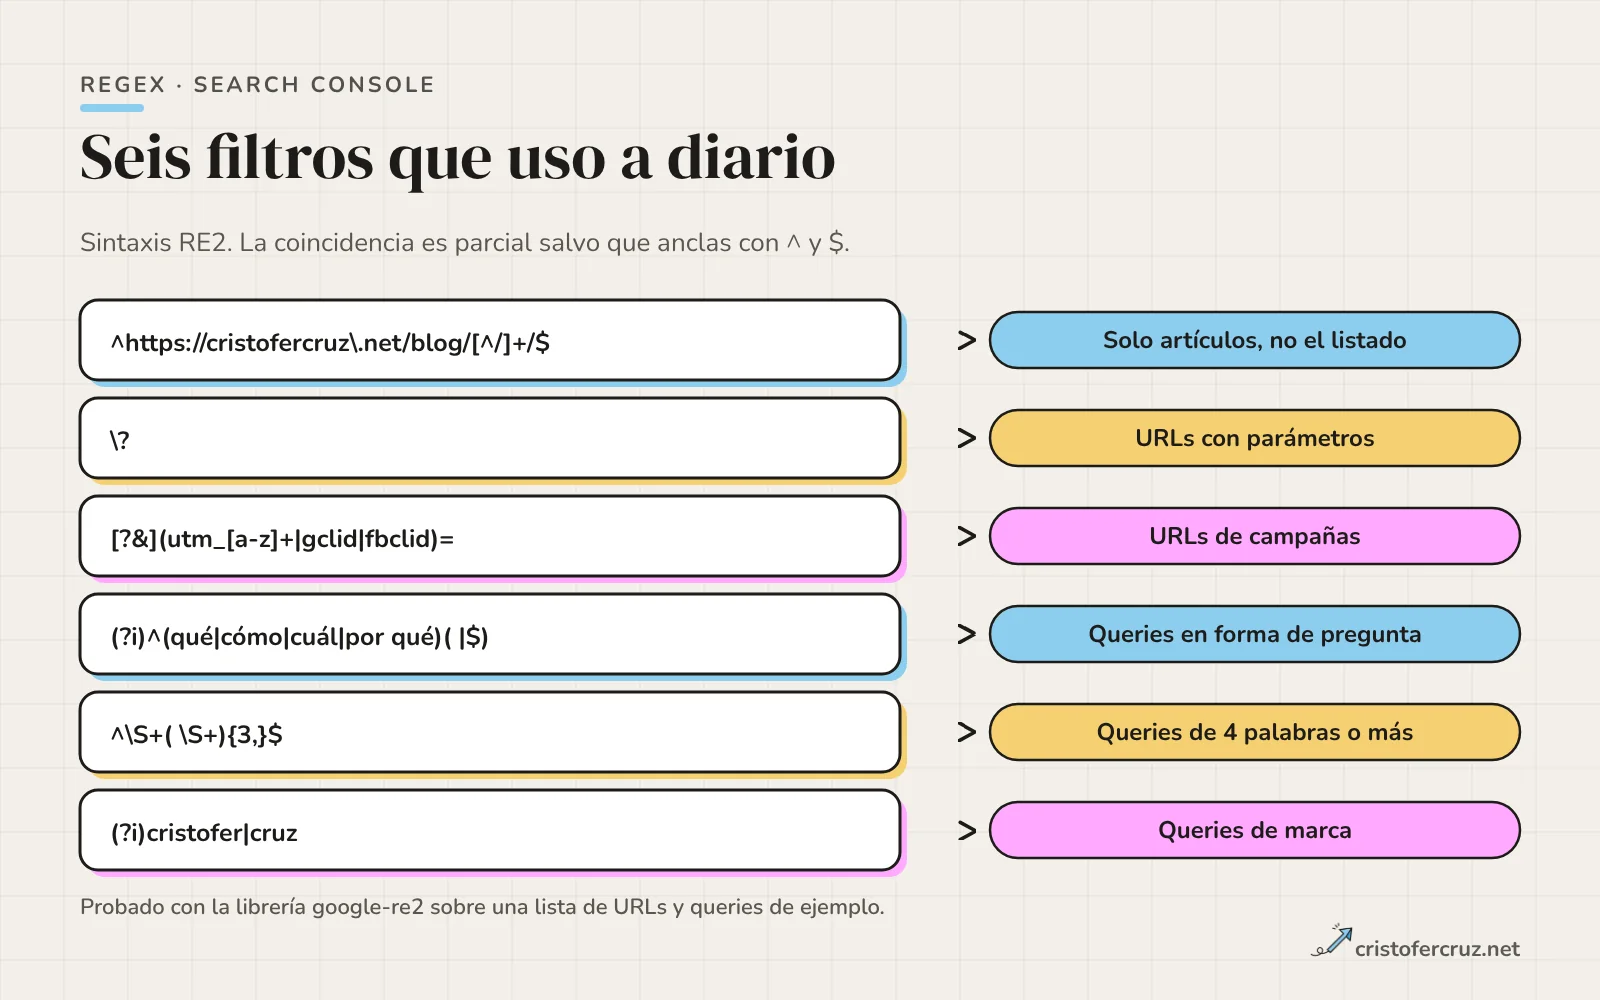
Probé seis filtros sobre una lista de 8 URLs de mi dominio y 8 consultas de ejemplo con google-re2:
| Objetivo | Patrón (RE2) | Resultado en la muestra |
|---|---|---|
| Solo artículos del blog | ^https://cristofercruz\.net/blog/[^/]+/$ | 1 de 8 URLs: el artículo, no el listado ni las páginas con parámetros |
| URLs con parámetros | \? | 3 de 8 |
| Parámetros de campaña | [?&](utm_[a-z]+|gclid|fbclid)= | 2 de 8 |
| Queries en forma de pregunta | (?i)^(qué|cómo|cuál|por qué)( |$) | 4 de 8 consultas |
| Queries largas (4+ palabras) | ^\S+( \S+){3,}$ | 4 de 8 consultas |
| Queries de marca | (?i)cristofer|cruz | 1 de 8 consultas |
El patrón de preguntas y la trampa de las tildes
Mi primera versión del patrón de preguntas usaba \b en lugar de ( |$): (?i)^(qué|cómo|cuál|por qué)\b. Con la lista de ejemplo solo casó «cómo hacer redirecciones 301». «Qué es el crawl budget» y «por qué no indexa google» quedaron fuera. La razón: en RE2 \b es un límite de palabra ASCII, y «é» no cuenta como carácter de palabra, así que entre «qué» y el espacio no hay límite. «Cómo» sí casa porque acaba en «o». En Python, con re, el mismo patrón casa las cuatro, y ahí está el peligro: lo pruebas en un sitio y lo pegas en otro.
Coincidencia parcial frente a completa
En el filtro de Search Console la coincidencia es parcial: /blog/ casa con cualquier URL que contenga esa cadena. En Looker Studio, REGEXP_MATCH(X, expresión) devuelve verdadero solo si el valor «coincide exactamente» con la expresión, según su documentación, que incluye el ejemplo REGEXP_MATCH(campo, 'A') falso y 'A.*' verdadero para «ABC123». Lo reproduje con fullmatch frente a search: la misma expresión da resultados distintos según la herramienta. La documentación avisa además de que los patrones con barra invertida pueden necesitar un escape adicional en Looker Studio.
Cuando pases un patrón de Search Console a Looker Studio, añade .* al principio y al final si quieres la coincidencia parcial, y revisa los escapes con una muestra real antes de montar un informe encima.
robots.txt merece una mención aparte: no admite regex. Google solo documenta dos comodines para las rutas, * y $; lo cuento en mi guía de robots.txt. Y los operadores de búsqueda de Google (inurl:, intitle:) tampoco son expresiones regulares: de ellos me ocupo en el artículo de operadores de búsqueda y footprints.
Regex en logs y reglas de redirección
En los logs y en el servidor trabajas con PCRE (o con su primo ERE, en grep -E). Para un análisis de logs a mano la combinación que más rinde es grep -oP con \K, que descarta lo anterior al patrón y deja solo lo que quieres. Probé estas recetas con un log de ejemplo de seis líneas que escribí yo (no es un log real de mi web), en formato combinado de Apache:
# rutas que dieron 404 a Googlebot
grep Googlebot access.log | grep -oP '"GET \K[^ ]+(?= HTTP[^"]*" 404)'
/blog/viejo-post/

# URLs con parámetros rastreadas por Googlebot
grep Googlebot access.log | grep -oP '"GET \K[^ ?]+\?[^ ]+'
/blog/?categoria=wpo

# códigos de estado de Googlebot
grep Googlebot access.log | grep -oP '" \K[0-9]{3}(?= )' | sort | uniq -c
      2 200
      1 304
      1 404

# bots por nombre
grep -oP '(Googlebot|GPTBot|ClaudeBot|bingbot)' access.log | sort | uniq -c
Un detalle que me costó un minuto: grep -E '" \d{3} ' devolvió 0 líneas y grep -P con el mismo patrón devolvió 6. \d no existe en las expresiones regulares extendidas de POSIX. En el artículo de análisis de logs SEO tienes el flujo completo, incluida la verificación de que Googlebot es Googlebot; aquí solo me interesa la parte regex.
En las redirecciones lo útil son los grupos de captura. Con Apache 2.4.58 y nginx 1.24.0 comprobé esta misma regla, que elimina el año de la ruta del blog:
# Apache (.htaccess)
RewriteRule ^blog/([0-9]{4})/(.+)$ /articulos/$2 [R=301,L]

# nginx (el patrón va entre comillas por las llaves)
rewrite "^/blog/([0-9]{4})/(.+)$" /articulos/$2 permanent;
Ambos devolvieron 301 de /blog/2019/mi-post/ a /articulos/mi-post/. La trampa de nginx es real: con ^/blog/([0-9]{4})/(.+)$ sin comillas, nginx -t falló con directive "rewrite" is not terminated by ";", porque el parser toma la llave como inicio de un bloque. Para el orden de las reglas, las banderas y los bucles, te remito a mis guías de reglas de .htaccess y de redirecciones en nginx.
XPath: extraer del árbol
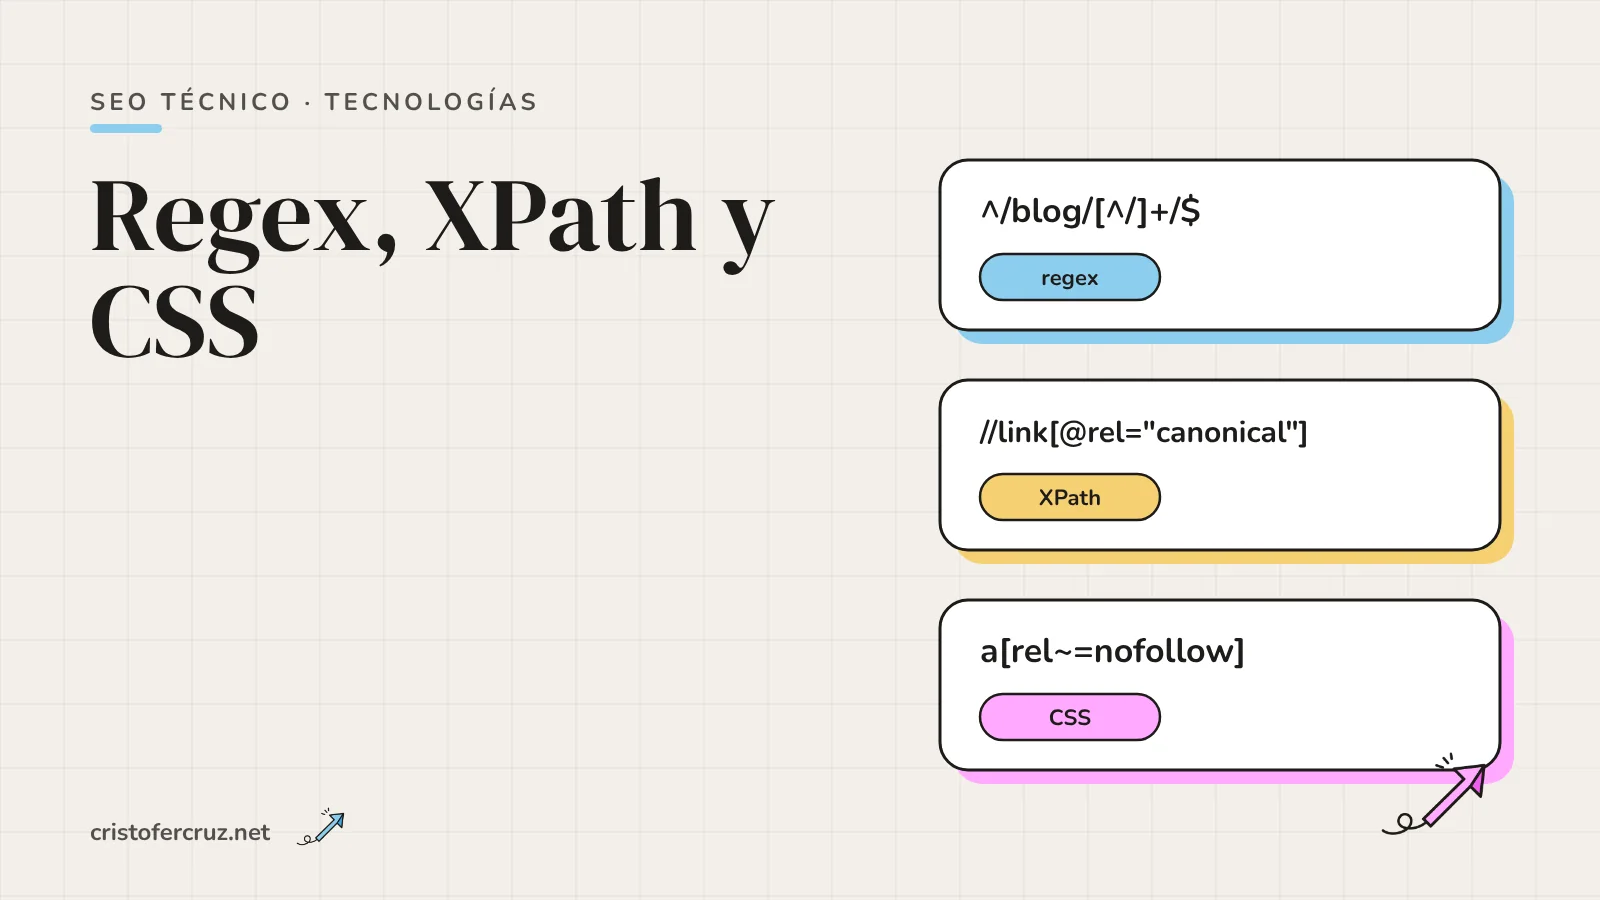
XPath describe una ruta por el documento. //link es «cualquier elemento link en cualquier sitio»; [@rel="canonical"] es un filtro por atributo; /@href es el valor del atributo. Lo ejecuté con lxml y, para las que funcionan en navegador, con document.evaluate en Chromium 141. Sobre este HTML de ejemplo:
<link rel="canonical" href="https://ejemplo.test/zapatillas/?color=rojo&talla=42">
<link rel="alternate" hreflang="es-ES" href="https://ejemplo.test/zapatillas/">
<link rel="alternate" hreflang="es-MX" href="https://ejemplo.test/mx/zapatillas/">
<meta name="robots" content="index, follow">
<a href="https://socio.test/?a=1&b=2" rel="nofollow sponsored">socio</a>
<a href="/ayuda/" rel="noopener nofollow">ayuda</a>
<img src="/a.jpg"><img src="/b.jpg" alt="">| Objetivo | XPath | Devuelve |
|---|---|---|
| Canonical | //link[@rel="canonical"]/@href | https://ejemplo.test/zapatillas/?color=rojo&talla=42 |
| Hreflang | //link[@rel="alternate"]/@hreflang | es-ES, es-MX |
| Meta robots | //meta[@name="robots"]/@content | index, follow |
| JSON-LD | //script[@type="application/ld+json"]/text() | El JSON como texto |
| Enlaces nofollow | //a[contains(concat(" ",normalize-space(@rel)," ")," nofollow ")]/@href | Los dos enlaces, el de rel="nofollow sponsored" y el de rel="noopener nofollow" |
| Imágenes sin atributo alt | //img[not(@alt)]/@src | /a.jpg (la de alt="" no cuenta) |
| Número de H1 | count(//h1) | 1 |
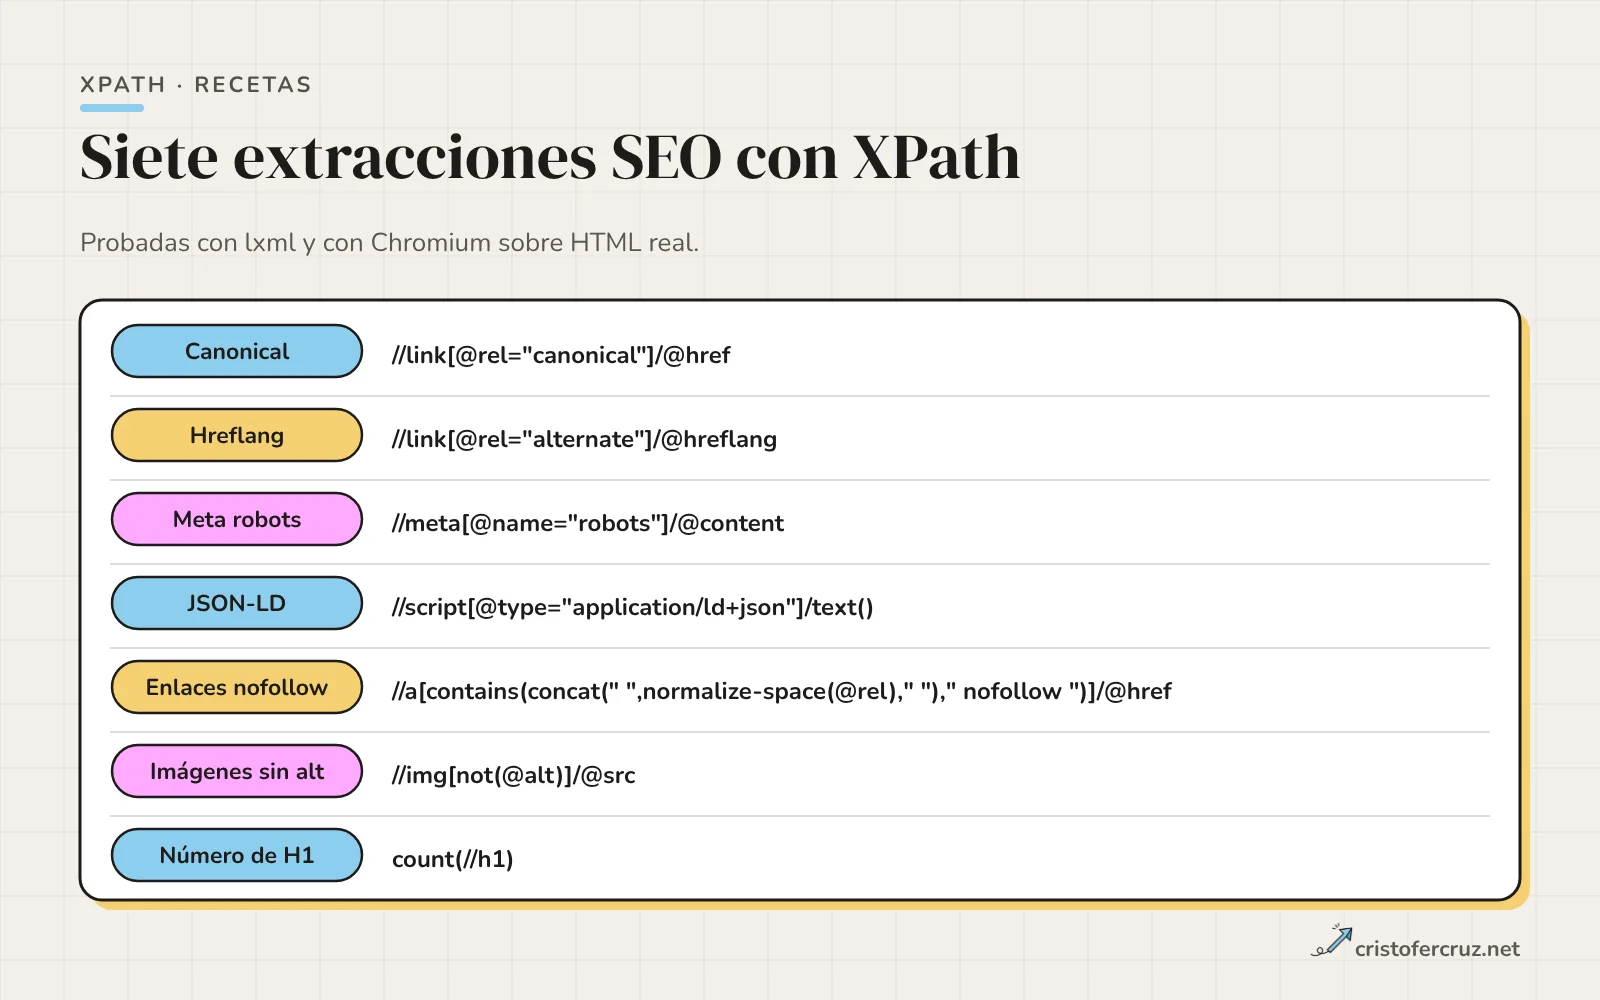
La receta de los enlaces nofollow se ve larga, y hay un atajo tentador: //a[@rel="nofollow"]. En mi prueba devolvió una lista vacía, porque exige que el atributo valga exactamente «nofollow» y ninguno de los dos enlaces lo cumplía. Con contains(@rel,"nofollow") sí salen, pero ese patrón también casaría con un hipotético «nofollowx». Rodear el valor de espacios con concat y normalize-space compara palabras completas.
Versiones de XPath
ends-with() y matches() son de XPath 2.0 o superior. Con lxml y con Chromium, que implementan XPath 1.0, ambas dieron error: «Unregistered function» en lxml y «not a valid XPath expression» en document.evaluate. Para «termina en .pdf» tienes que usar substring() con string-length(). En cambio, Screaming Frog documenta que desde su versión 21 admite XPath 2.0, 3.0 y 3.1, así que allí esas funciones sí están. Antes de copiar una receta, mira en qué versión corre tu herramienta.
Dónde ejecutarlo
En DevTools, $x(ruta) devuelve un array con los nodos que casan, según la documentación de Chrome; yo comprobé el equivalente con document.evaluate, no la consola. En Google Sheets, IMPORTXML(url; consulta_xpath) importa datos de HTML, XML, CSV y feeds; no lo he probado para este artículo, así que cito la sintaxis de la documentación y nada más. Y los rastreadores con extracción personalizada permiten escoger XPath, CSS o regex: Screaming Frog, por ejemplo, ofrece las tres, y reserva la regex para casos como comentarios HTML o JavaScript en línea. De otras herramientas de pago no te cuento nada que no haya visto funcionar.
Extraer JSON-LD y entenderlo
El XPath devuelve el JSON como texto; para usarlo hay que parsearlo. Con Python:
import json
from lxml import html
t = html.fromstring(open('pagina.html', 'rb').read())
for bloque in t.xpath('//script[@type="application/ld+json"]/text()'):
    datos = json.loads(bloque)
    print(datos.get('@type') or [n.get('@type') for n in datos['@graph']])
Es la forma más fiable de auditar a escala los datos estructurados de un sitio: extraes todos los bloques, comprueban que son JSON válido y cuentas los tipos. Con una regex sobre el HTML esto es frágil en cuanto el JSON anida objetos.
Selectores CSS: lo mismo, más corto
Los selectores CSS cubren casi todo lo que hago con XPath con una sintaxis mucho más corta, y tienen la ventaja de que los conoce cualquiera que haya escrito CSS. Los operadores de atributo que más uso son ^= (empieza por), $= (termina en), *= (contiene) y ~= (contiene la palabra completa). Ejecuté cada fila de esta tabla con XPath en lxml y con CSS en BeautifulSoup (y las que lo permiten, en Chromium) y los dos devolvieron los mismos nodos:
| Qué busco | XPath | Selector CSS |
|---|---|---|
| Atributo igual | //link[@rel="canonical"] | link[rel=canonical] |
| Palabra dentro de rel | //a[contains(@rel,"nofollow")] | a[rel~=nofollow] |
| Empieza por | //a[starts-with(@href,"http")] | a[href^=http] |
| Contiene | //a[contains(@href,"?")] | a[href*="?"] |
| Termina en | No hay ends-with() en XPath 1.0 | a[href$=".pdf"] |
| Sin atributo | //img[not(@alt)] | img:not([alt]) |
| Hijo directo | //p/a | p > a |
| Padre que contiene un enlace | //p[.//a[contains(@rel,"nofollow")]] | p:has(a[rel~=nofollow]) |
| Por el texto | //a[contains(text(),"guía")] | No existe en CSS |
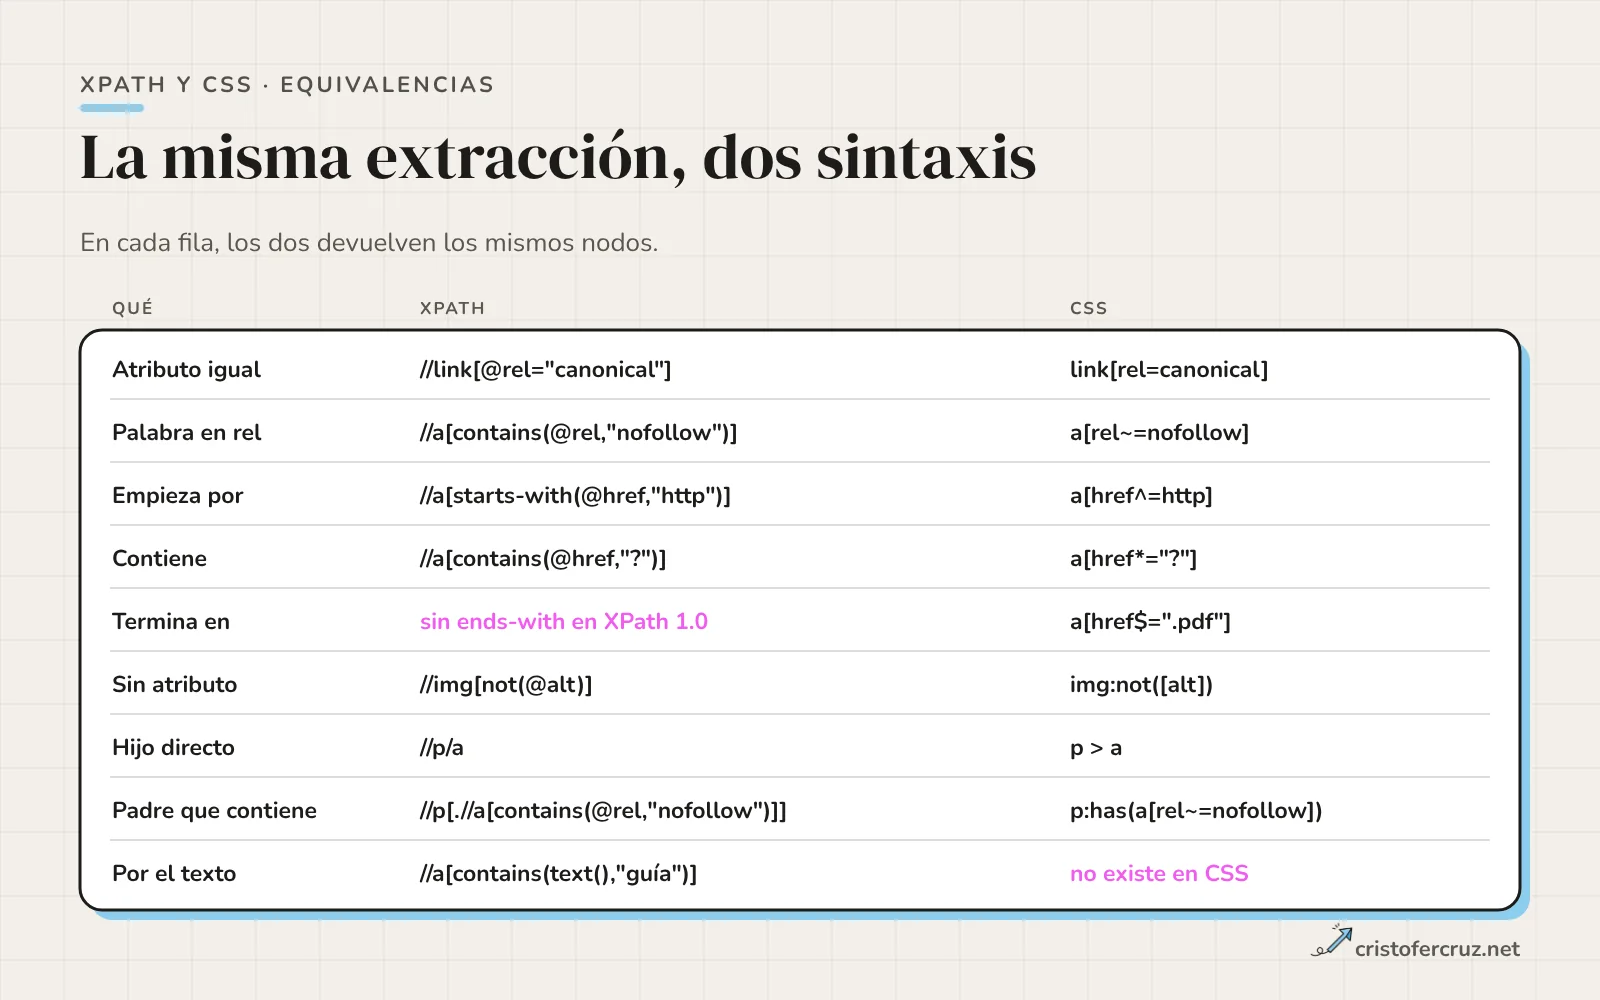
En DevTools, $$('a[rel~=nofollow]') devuelve el array de elementos, y $('link[rel=canonical]') el primero. Lo que esa consola ve es el DOM ya renderizado, que no siempre coincide con lo que recibe un rastreador sin JavaScript. De eso va el siguiente apartado.
Trampas que reproduje
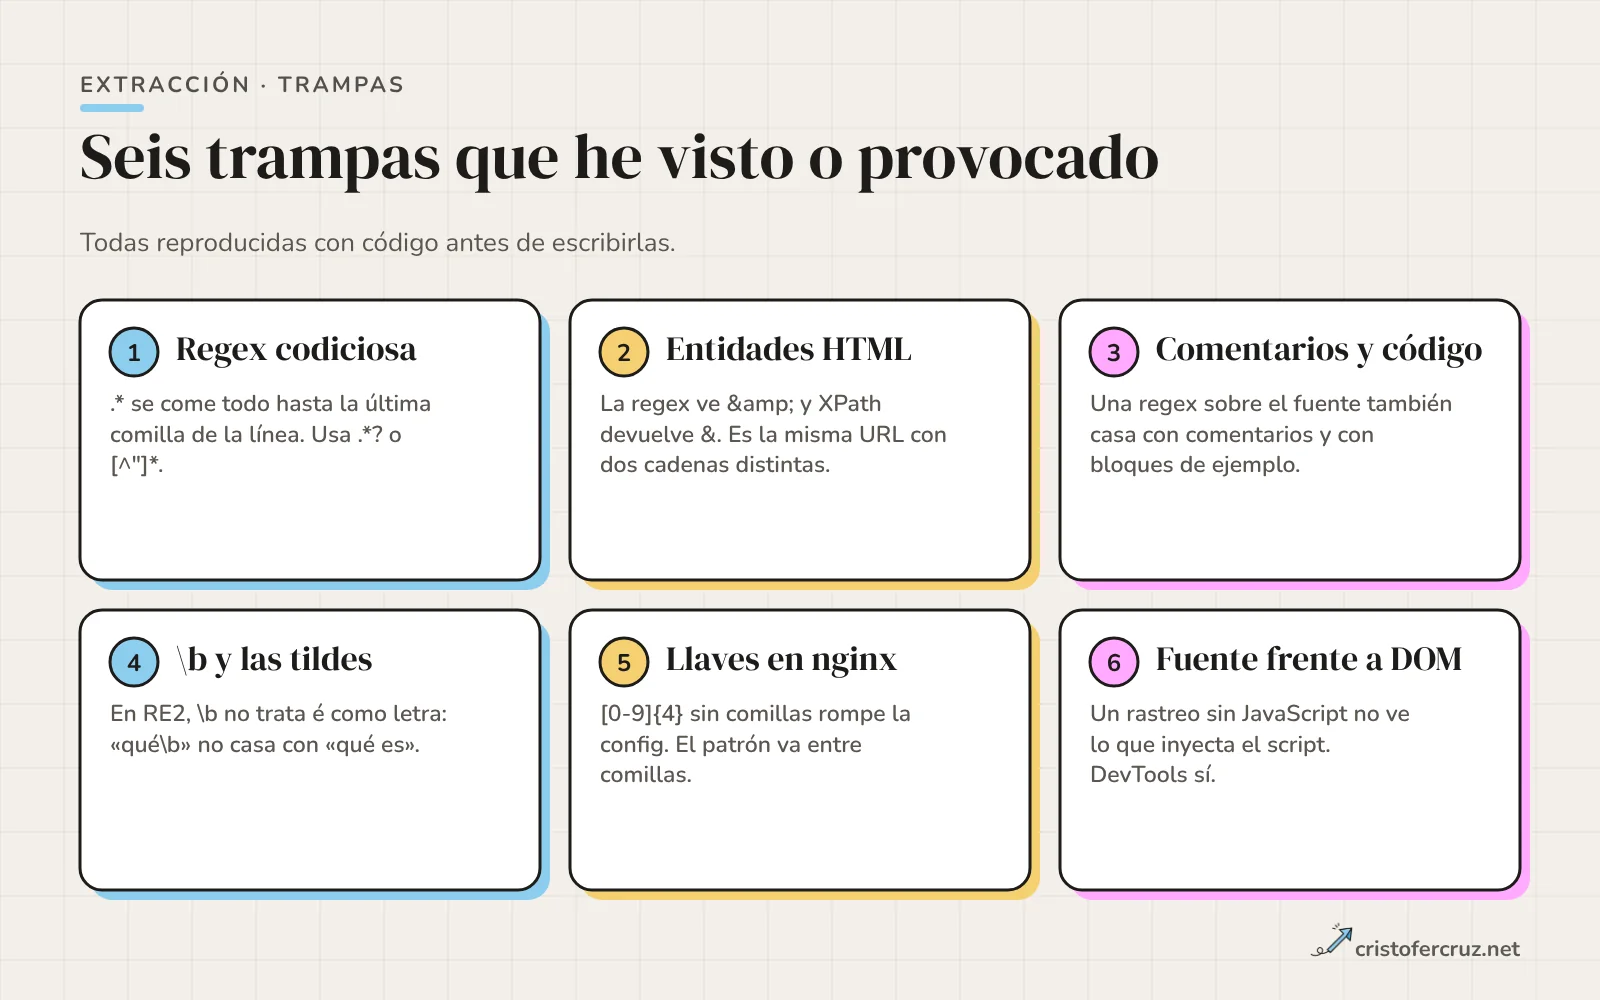
Regex codiciosa
Con <a href="(.*)" sobre una línea con varios enlaces, la captura se comió todo hasta la última comilla de la línea. Con (.*?) salieron los cinco href por separado. En RE2 el cuantificador perezoso funciona; aun así prefiero [^"]*, que dice exactamente lo que quiero.
Entidades y comentarios
En mi HTML de ejemplo el canonical lleva & en el fuente. La regex devolvió ...?color=rojo&talla=42 y XPath ...?color=rojo&talla=42: misma URL, dos cadenas, y si las comparas sin decodificar, sale una falsa discrepancia. Además, la regex casó dos canonicals, porque había uno dentro de un comentario HTML; XPath devolvió solo el real. Y una regex que fija el orden de atributos (rel="canonical" href=) no encuentra nada si el CMS emite href antes de rel.
HTML fuente frente a DOM
Con una página que inyecta en JavaScript un <h1> y un canonical, XPath sobre el HTML fuente no devolvió nada, y el mismo XPath y el selector CSS ejecutados en Chromium sobre el DOM devolvieron los dos. Un rastreador sin renderizado ve lo primero; Google renderiza, pero no todos los consumidores lo hacen. Si lo que te importa depende de JavaScript, mira mi guía de SEO para JavaScript y extrae siempre sobre ambas versiones.
Cómo lo aplico a mi web
Ejecuté las recetas sobre /blog/hreflang/, tal como la sirve mi web en local, con XPath en lxml y CSS en BeautifulSoup. Los datos principales salieron idénticos con XPath y con CSS:
| Dato | Resultado |
|---|---|
| Canonical | https://cristofercruz.net/blog/hreflang/ |
| Hreflang | es-ES y x-default, ambos a la misma URL |
| Meta robots | index, follow, max-image-preview:large, max-snippet:-1, max-video-preview:-1 |
| JSON-LD | 1 bloque, con BlogPosting y BreadcrumbList |
| H1 | 1 |
| Enlaces con nofollow | 0 |
Imágenes sin alt / con alt="" | 0 / 7 de 18 |
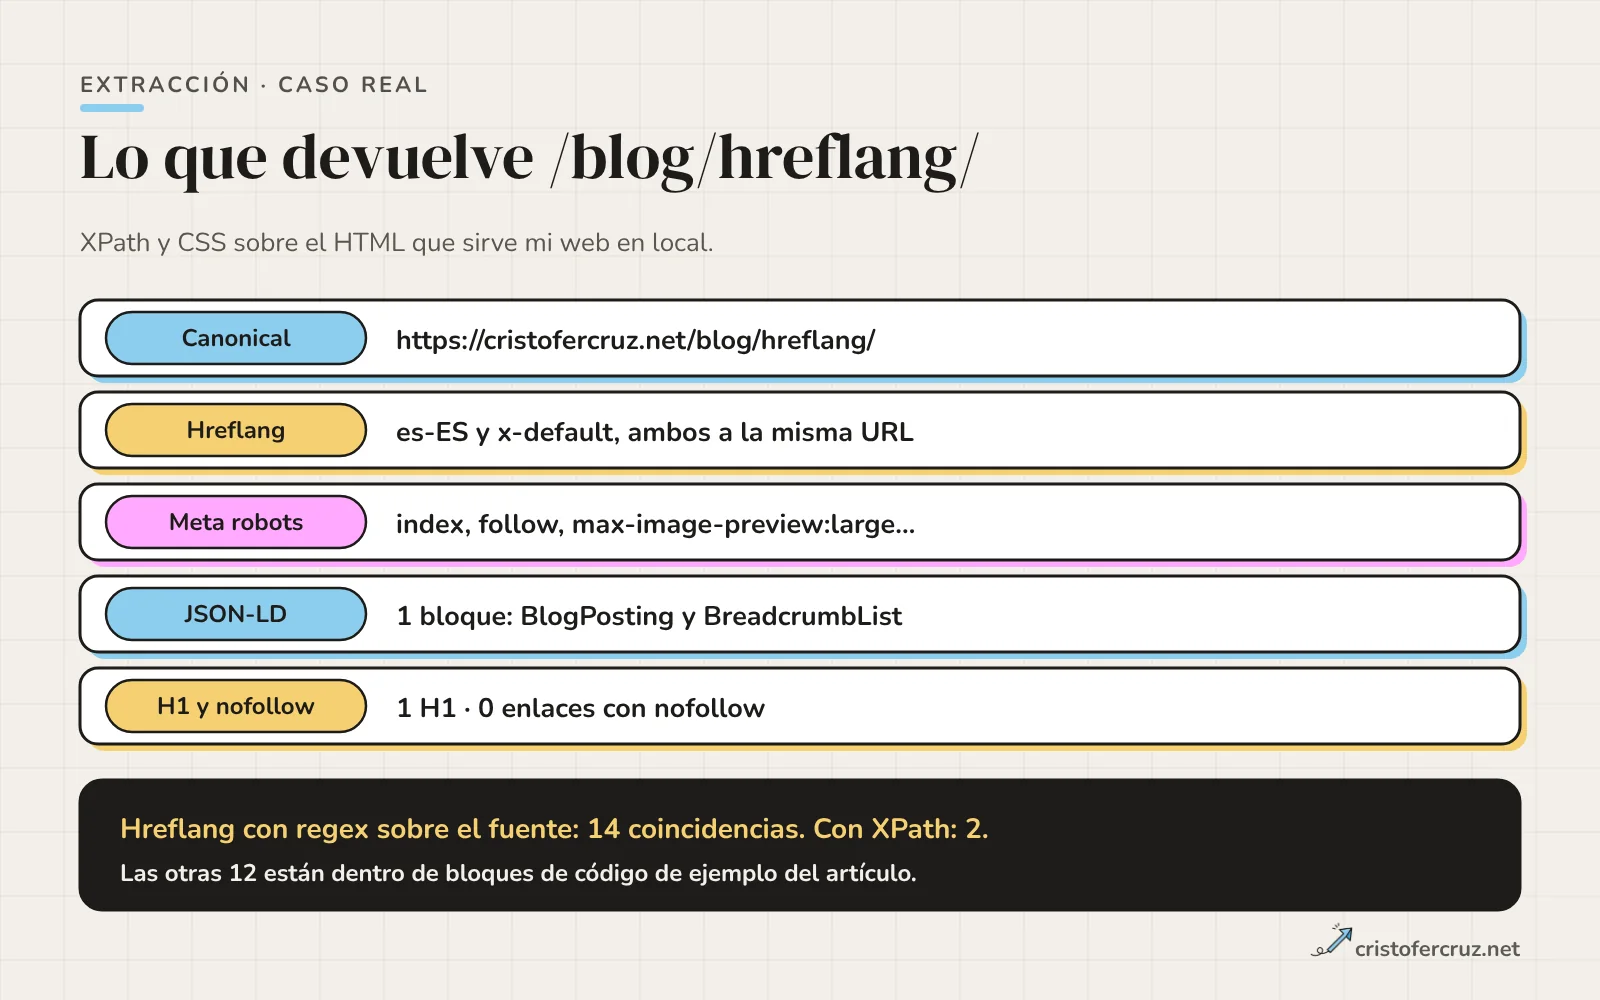
La comparación que más me interesó: una regex hreflang="([^"]+)" sobre el HTML fuente devolvió 14 coincidencias; XPath, 2. Las otras 12 están dentro de los bloques de código de ejemplo del propio artículo, que contienen etiquetas hreflang escritas como texto. Para una auditoría de hreflang a escala, esa diferencia importa: con regex contarías anotaciones que no existen.
Las regex que sí uso en mi web, y que he verificado leyendo el código, son estas:
- En el
.htaccess, unFilesMatchcon\.[a-f0-9]{12}\.(js|woff2|webp|svg|png|jpg)$asignaCache-Control: public, max-age=31536000, immutablea los archivos con hash de contenido. Lo comprobé contraassets/cache: los 333 archivos de esa carpeta casan. - Un
RewriteRule ^tools(?:/|$) - [F,L]impide servir los scripts de build. - En PHP, el listado del blog solo carga carpetas cuyo nombre cumple
/^[a-z0-9]+(?:-[a-z0-9]+)*$/D. Pasé las carpetas del blog por ese mismo patrón congrep -Py casaron todas (39 cuando lo comprobé). - Mi
robots.txtno usa comodines: son rutas con prefijo.
No tengo en este artículo datos de filtros regex de mi propia propiedad de Search Console, así que las cifras de la tabla de arriba son sobre mi muestra de ejemplo, no sobre tráfico real.
Cuándo uso cada uno
| Tarea | Mi elección | Por qué |
|---|---|---|
| Filtrar URLs o queries en Search Console | Regex (RE2) | Es lo único que ofrece la interfaz |
Sacar canonical, H1, JSON-LD, rel | XPath o CSS | Dependen de la estructura, no del texto |
| Filtrar por el texto de un nodo o subir al padre | XPath | CSS no selecciona por texto |
| Selector que también uso en JavaScript o en DevTools | CSS | Es más corto y lo entiende todo el equipo |
| Reglas de redirección y análisis de logs | Regex (PCRE) | Son cadenas sin estructura y el motor lo permite |
| Contenido que inyecta JavaScript | DOM renderizado | El HTML fuente no lo tiene |
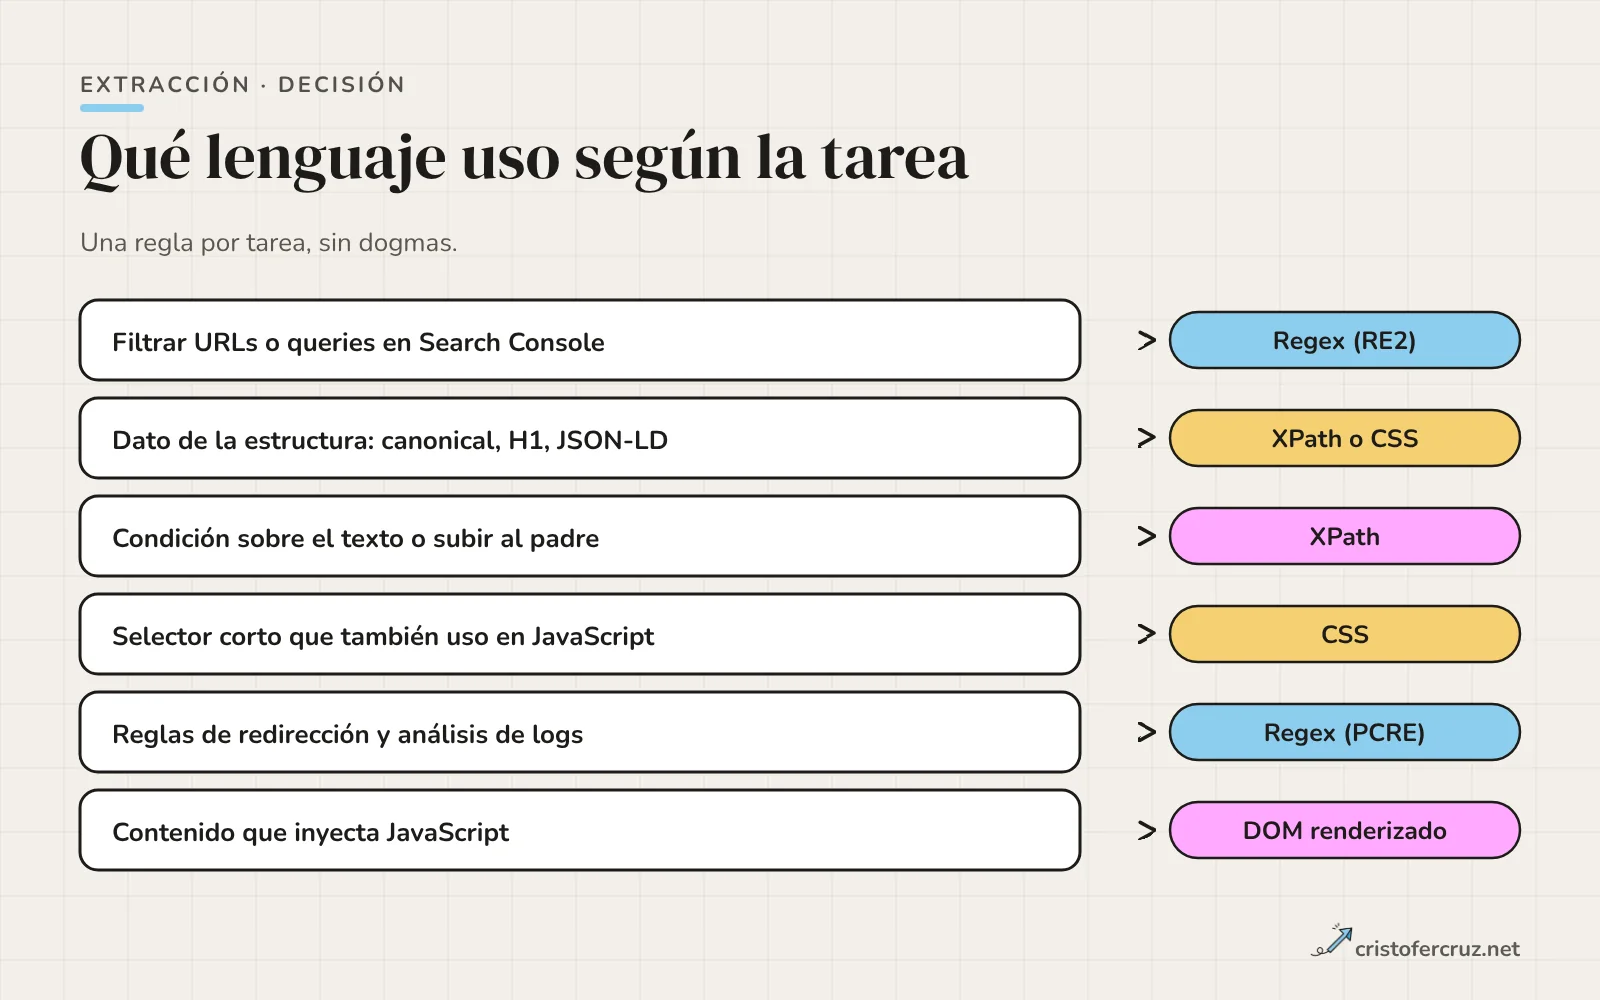
Si dudas entre XPath y CSS, empieza por CSS. Cambia a XPath cuando necesites filtrar por texto, subir al padre o usar funciones, y comprueba antes qué versión de XPath soporta tu herramienta.
Dónde probar antes de pegar
Un patrón sin probar es un patrón con un fallo por descubrir. Mi orden de preferencia:
- Regex: un probador online como regex101 sirve para ver los grupos, con el motor correcto seleccionado. Si es para Google, comprueba que el motor sea RE2 o equivalente; si lo pruebas con el motor equivocado, el resultado no sirve. Mejor aún, una prueba con una muestra real de tus propias URLs o logs.
- XPath:
$x()en la consola de DevTools, odocument.evaluate, para el DOM renderizado;lxmlpara el HTML fuente. - CSS:
$$()en DevTools yselect()de BeautifulSoup. - Servidor:
nginx -tyapachectl configtestantes de recargar, ycurl -sIpara ver el código y la cabeceraLocation.
Cómo verifico una extracción antes de fiarme
- Descarga el HTML fuente con
curly compara con el DOM de DevTools: si el dato solo está en el segundo, tu rastreador necesita renderizar. - Prueba el selector en una página donde sepas el resultado, y en otra donde el elemento no exista. Un selector que devuelve algo en ambas es sospechoso.
- Cuenta, no leas: compara el número de resultados entre dos métodos (XPath y CSS, o regex y XPath). Si difieren, uno de los dos está contando mal.
- Decodifica las entidades antes de comparar URLs extraídas con regex.
- En regex para Google, prueba con RE2 y sin lookarounds. En regex para servidor,
nginx -toconfigtesty una petición concurl. - Guarda los selectores que funcionan, con la herramienta y la versión donde los probaste.
Si quieres que alguien revise este tipo de extracciones sobre tu sitio, es parte de lo que hago en una auditoría, o de forma recurrente en una consultoría SEO.
Preguntas frecuentes
¿Qué sintaxis de regex usa Google Search Console?
RE2, según las crónicas del lanzamiento del filtro en 2020. No admite lookahead, lookbehind ni referencias hacia atrás: lo comprobé compilando esos patrones con google-re2, y los tres dan error. Valida el comportamiento en tu propia interfaz.
¿Por qué mi regex funciona en un probador y no en Search Console?
Lo más probable es que el probador use PCRE o el motor de JavaScript y tu patrón lleve un lookahead, una referencia hacia atrás o un \b con tildes. Prueba con RE2 y con una muestra de tus datos.
¿Es mejor XPath o un selector CSS para SEO?
Para extraer atributos y texto de elementos, los selectores CSS son más cortos y suficientes. XPath es necesario si filtras por el texto del nodo, subes al padre o usas funciones. Los dos devuelven los mismos nodos en las recetas que probé.
¿Puedo extraer datos con regex en lugar de XPath?
Puedes, pero lee el HTML como texto: casa con comentarios, con bloques de código y con entidades sin decodificar. Mi regex de hreflang encontró 14 etiquetas donde XPath encontró 2. Reserva la regex para lo que XPath y CSS no ven, como el JavaScript en línea.
¿Por qué ends-with() me da error en XPath?
Porque es de XPath 2.0 y los navegadores y lxml implementan XPath 1.0: en mis pruebas dio «not a valid XPath expression» en Chromium y «Unregistered function» en lxml. Usa substring() con string-length() o un selector CSS con $=.
¿Cómo extraigo los datos estructurados de una página?
Con //script[@type="application/ld+json"]/text() sacas el JSON como texto y lo parseas con json.loads o JSON.parse. Con CSS, script[type="application/ld+json"]. No lo hagas con regex.
¿Funciona IMPORTXML con selectores CSS?
La documentación de Google Sheets describe IMPORTXML(url, consulta_xpath) y habla solo de XPath. No he probado la función para este artículo.
Referencias y fuentes
Documentación y artículos consultados para este artículo.
- RE2 Syntax GitHub · Google
- REGEXP_MATCH Looker Studio · Google Cloud
- IMPORTXML Editores de Documentos de Google · Ayuda
- Console Utilities API reference Chrome for Developers
- Introduction to using XPath in JavaScript MDN Web Docs
- SEO Spider configuration: custom extraction Screaming Frog
- Advanced XPath functions for the Screaming Frog SEO Spider Screaming Frog
- Google Search Console performance report to get regular expression filter Search Engine Roundtable
- Cómo interpreta Google las especificaciones de robots.txt Google Search Central