- Google no hace clic en botones ni genera eventos de scroll: lo que solo aparece tras «cargar más» o al llegar al final del listado puede no llegar nunca al índice.
- El patrón que documenta Google para el scroll infinito es una paginación con URLs únicas y enlaces
<a href>entre ellas; el scroll es una mejora encima. - Cada página de la secuencia lleva su propio canonical.
rel="prev"yrel="next"ya no los usa Google. - Los problemas que no ve Search Console son los de experiencia: CLS, memoria, pie de página inalcanzable, foco y lectores de pantalla.
- La «profundidad de scroll» no es una señal de ranking documentada. Lo que sí está documentado es que el contenido debe cargarse sin depender de una interacción.
- El listado de mi blog usa enlaces reales y JavaScript como mejora; lo probé con JavaScript activado y desactivado y tiene cuatro puntos que revisar.
Un listado de 500 productos que solo enseña 24 hasta que el usuario hace scroll puede estar indexando 24. Lo normal es no enterarte: la página se ve completa en tu navegador, el rastreo no da errores y el problema solo aparece cuando buscas productos concretos y no salen.
Aquí separo los tres patrones (paginación, «cargar más» y scroll infinito), recojo lo que Google dice y no dice, doy una receta de código que he probado y repaso los dos temas que suelen quedar fuera: el rendimiento y la accesibilidad del scroll, y el mito de que el contenido «bajo el pliegue» vale menos.
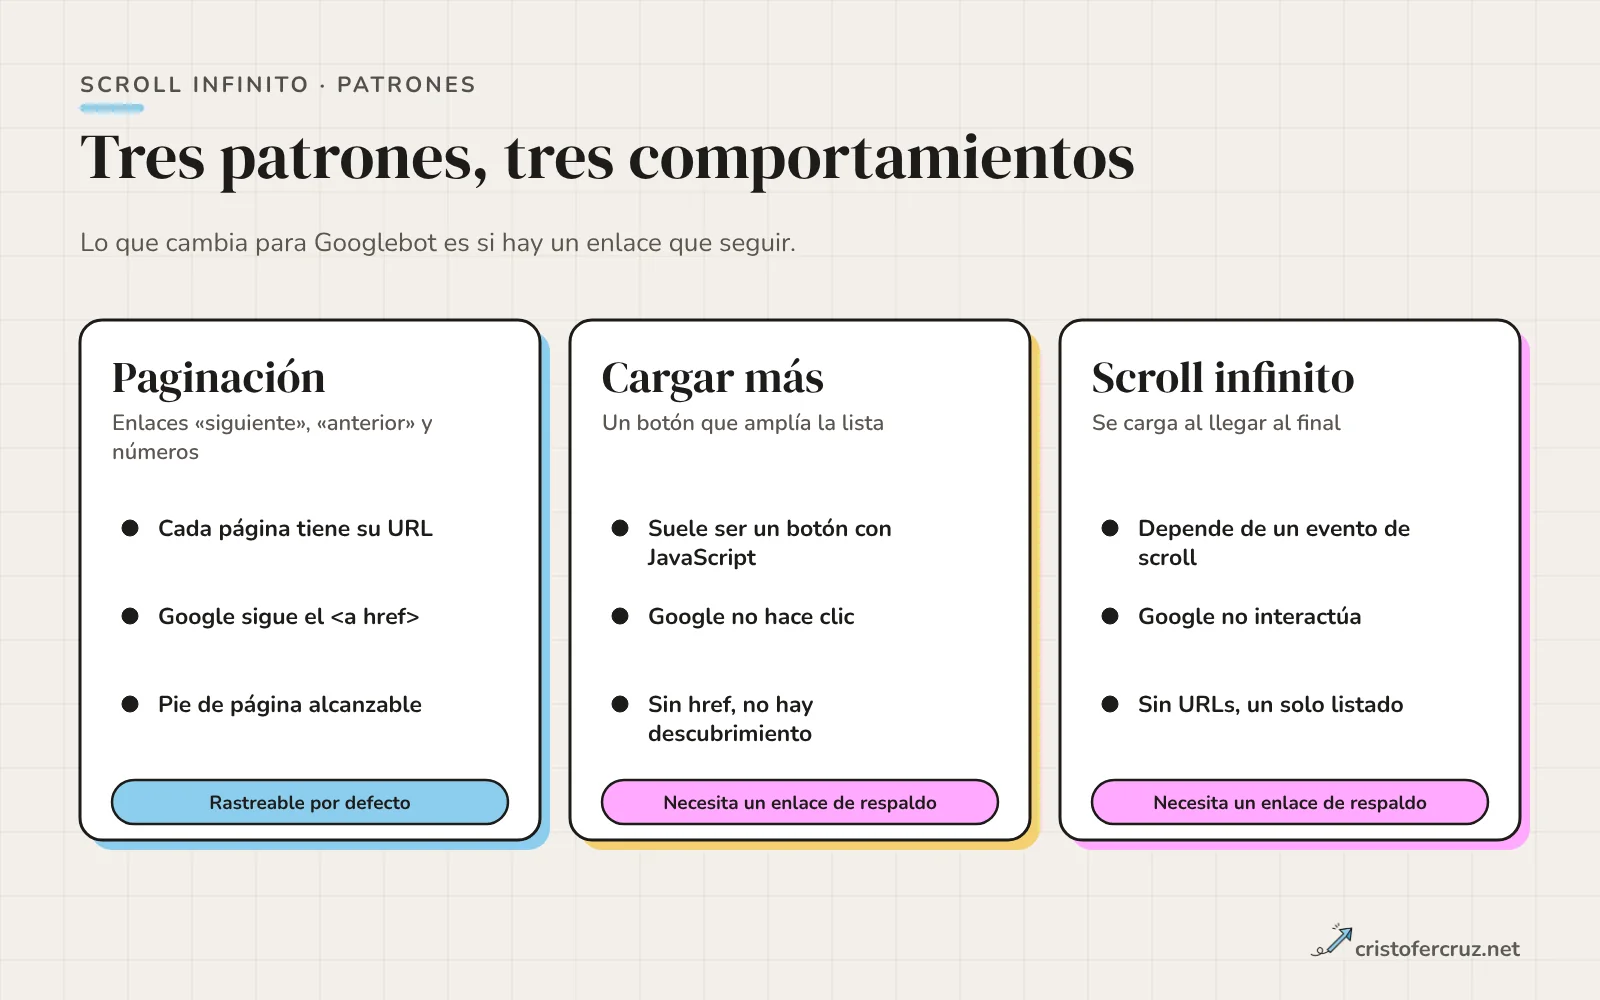
Paginación, «cargar más» y scroll infinito: qué es cada uno
Google define los tres en su documentación sobre paginación y carga incremental. La paginación es cuando el usuario navega con enlaces como «siguiente», «anterior» y números de página. «Cargar más» es un botón que amplía el conjunto inicial de resultados. El scroll infinito carga más contenido cuando el usuario llega al final de la página.
Para el SEO la diferencia es dónde está el enlace.
| Criterio | Paginación | Cargar más | Scroll infinito |
|---|---|---|---|
| Cómo descubre Google las páginas siguientes | Enlaces <a href> en el HTML | Solo si el botón es un enlace con href; un botón con JavaScript no se pulsa | Solo si hay enlaces de respaldo; el scroll no se simula |
| URL de cada tramo | Una por página | Una sola, salvo que la actualices | Una sola, salvo que la actualices |
| Pie de página | Siempre alcanzable | Alcanzable | Se aleja con cada carga |
| Volver a una posición | Fácil: la URL lo recuerda | Difícil sin estado en la URL | Difícil sin estado en la URL |
| Rendimiento | Cada página es ligera | El DOM crece con cada clic | El DOM crece sin parar |
| Listados grandes | Funciona | Limitado según Google | Limitado según Google |
Lo que se rompe es la implementación que depende solo de JavaScript y no deja ningún enlace en el HTML.
Qué dice Google: rastreo, URLs y canonical
Esto es lo que dice la documentación de Search Central sobre paginación y carga incremental, con fecha de última actualización 2025-12-10:
- Google suele seguir las URLs que están en el atributo
hrefde elementos<a>. - Sus rastreadores no «hacen clic» en botones y, por lo general, no activan funciones de JavaScript que necesiten una acción del usuario.
- «Cargar más» y el scroll infinito suelen apoyarse en JavaScript, así que Google puede no descubrir lo que cargan. Como ayuda para descubrir contenido, la página sugiere un sitemap o un feed de Google Merchant Center.
- Cada página de una secuencia debe tener su propia URL (por ejemplo
?page=n) y Google las trata como páginas independientes. - No uses la primera página como canonical de toda la secuencia: cada una lleva su propio canonical.
- Google ignora lo que va después de
#, así que un enlace al «siguiente» que solo cambie el fragmento puede no seguirse. - Google ya no usa
rel="prev"yrel="next", aunque otros buscadores puedan seguir haciéndolo.
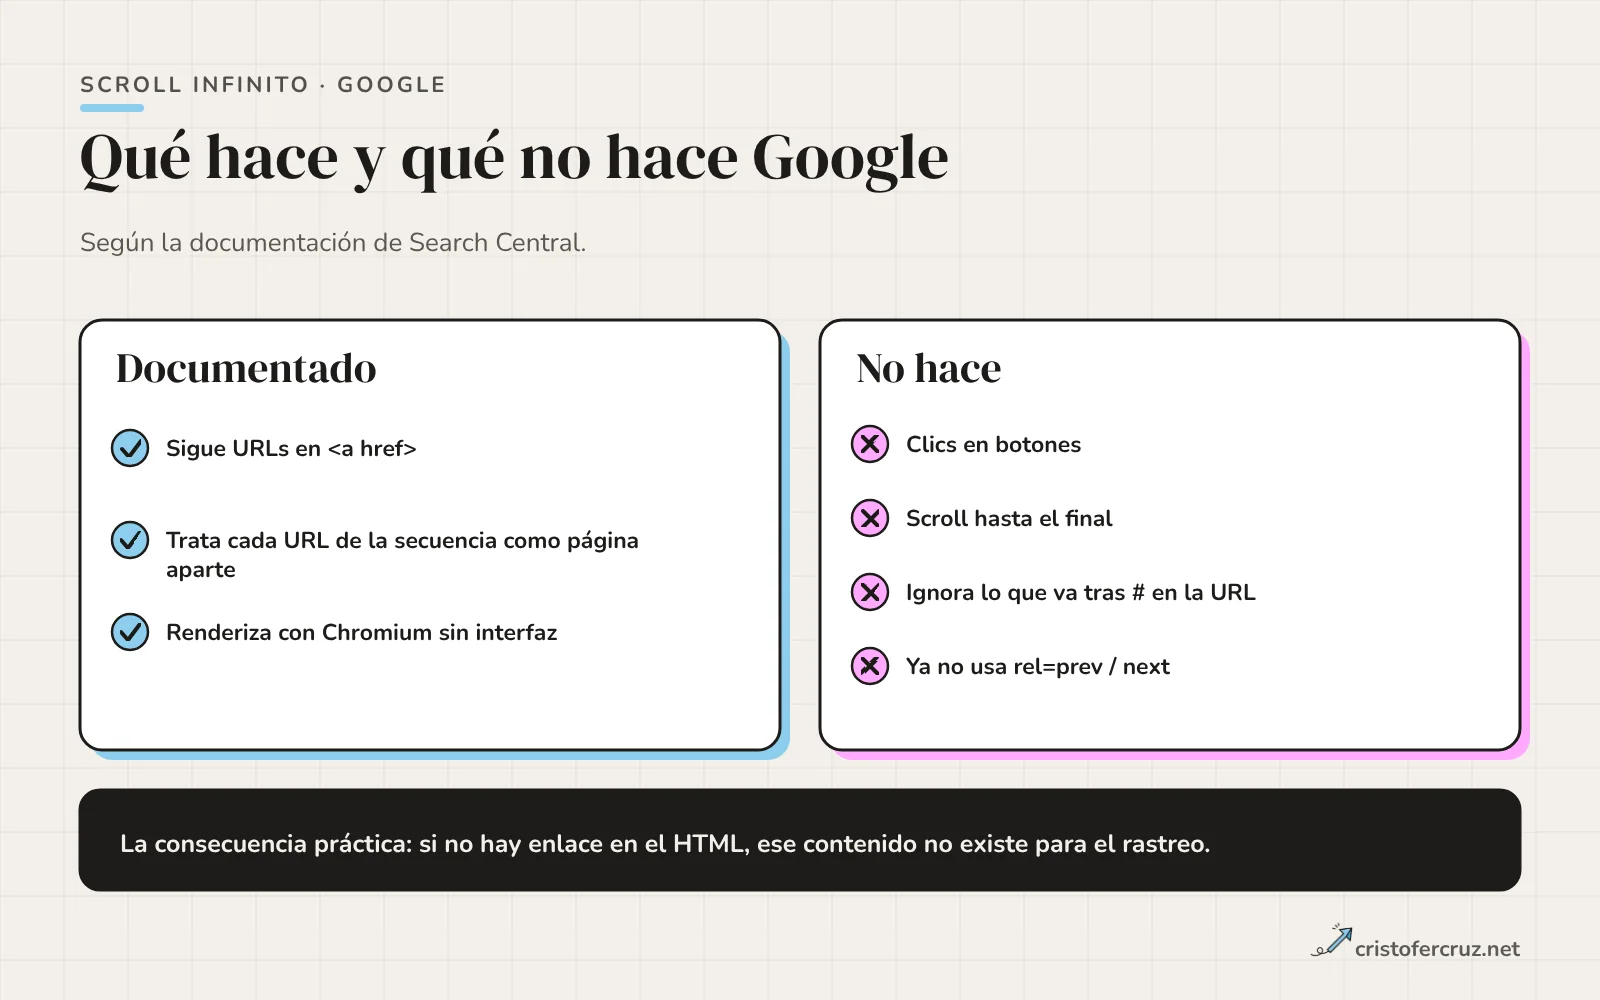
La guía sobre contenido de carga diferida añade el criterio que más cita todo el mundo: «Google Search does not interact with your page», así que los métodos de carga no deben depender de acciones del usuario como hacer scroll o clic. Para el scroll infinito pide dos cosas: dar a cada tramo una URL persistente y única, y enlazar secuencialmente las URLs para que los buscadores descubran el conjunto.
Y el viewport de Googlebot, ¿hace scroll o no?
La documentación no habla de un scroll de Googlebot ni de su viewport. La referencia más citada es de 2020: Martin Splitt dijo en el evento «Better Together» que Googlebot «no hace scroll» (It doesn’t scroll) y que conviene que las bibliotecas carguen cuando el elemento entra en el viewport, según la crónica de Search Engine Journal. La documentación tampoco da una cifra del tamaño de ese viewport, y cualquier número que leas por ahí es una observación de terceros que no he podido verificar en fuente oficial.
La conclusión práctica no necesita esa cifra: lo que dependa de que el viewport crezca o de que alguien haga scroll es lo que debes tratar como invisible. Cómo procesa Google el JavaScript en general, incluida la cola de renderizado, lo tienes en mi guía de cómo procesa Google el JavaScript.
Un dato de contexto: tras el anuncio del 26 de junio de 2024, Google retiró el scroll continuo de sus propios resultados en escritorio, según la prensa del sector, que cuenta que cargar resultados que nadie pide no mejoraba la satisfacción. No es una regla para tu web, pero ilustra que el patrón no es obligatorio.
El patrón que funciona: URLs únicas, enlaces y History API
La arquitectura que encaja con lo anterior es una paginación clásica que el JavaScript mejora. Cada tramo existe como página real, y el scroll es una comodidad que pide esas mismas páginas por detrás.
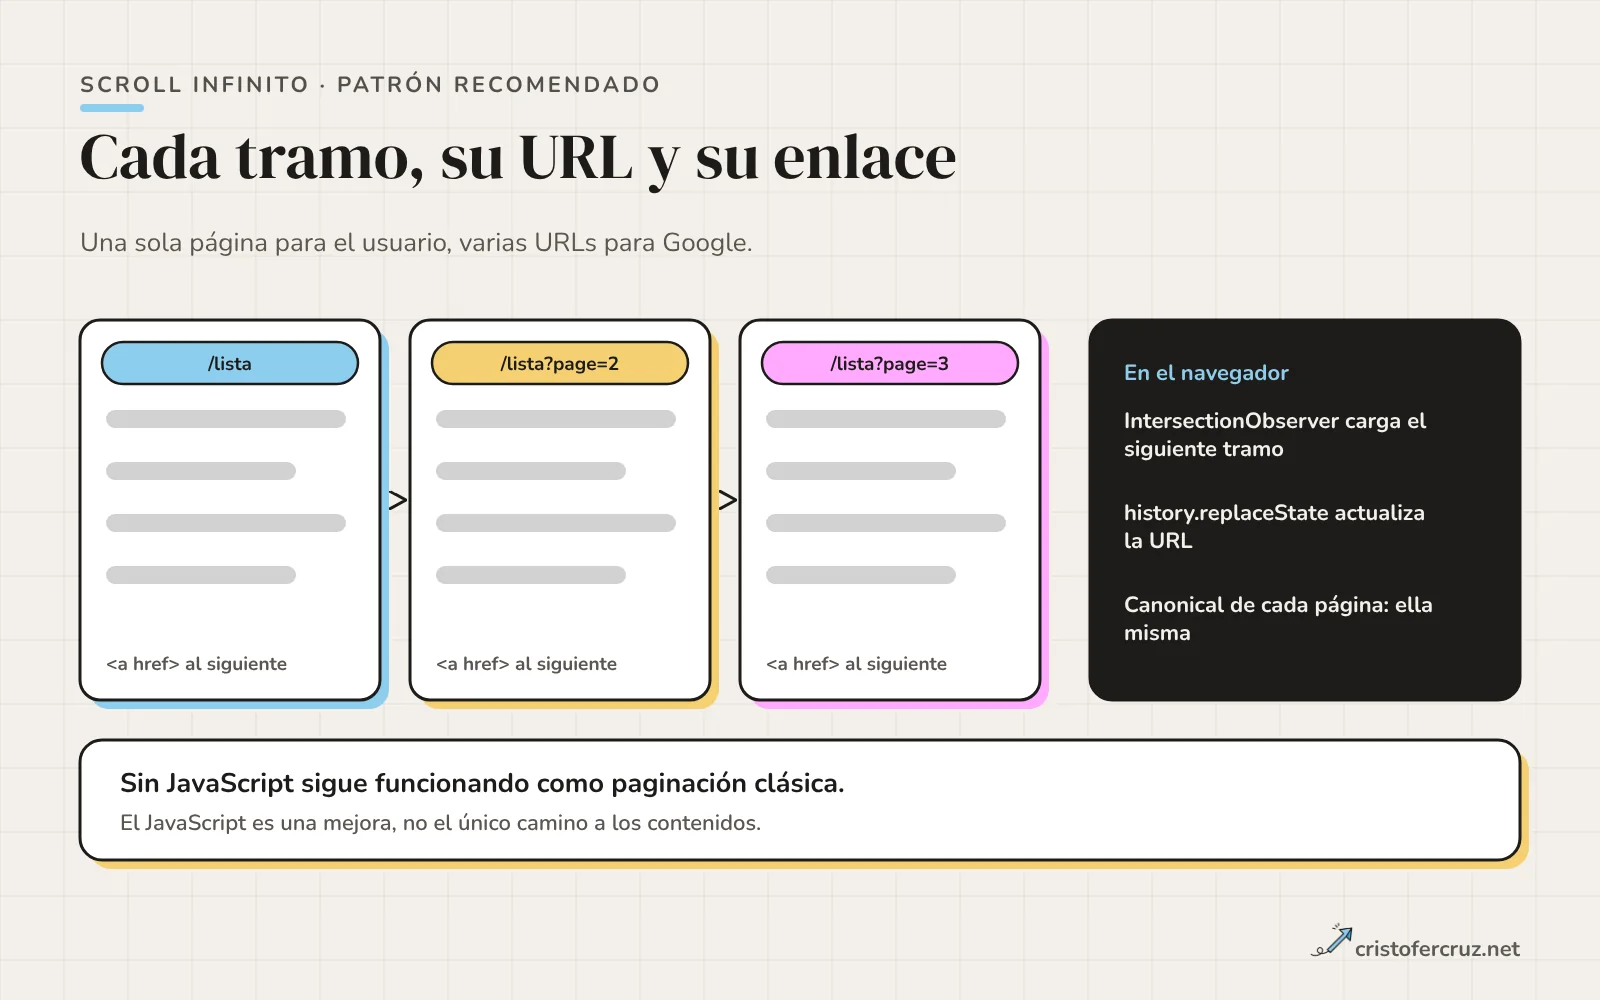
- URL propia por tramo, con numeración absoluta (
?page=3) y no relativa («los de ayer»), para que la misma URL devuelva siempre lo mismo. - Enlace
<a href>al siguiente tramo en el HTML, también cuando el JavaScript no ha cargado. Si además enlazas a la primera página, indicas cuál es la mejor para aterrizar. - Canonical autorreferenciado en cada página. Las reglas generales de canonical, incluidos los filtros, están en mi guía de canonical y duplicados; aquí solo cambia que nunca apuntes toda la secuencia a la página 1.
- History API para reflejar dónde está el usuario. Con
history.replaceStatela URL cambia sin añadir entradas al historial; conpushStatese añade una entrada por tramo, y el botón «atrás» recorre tramos en lugar de salir del listado. Yo prefieroreplaceStateen scroll automático ypushStatecuando el usuario pulsa un botón. - Filtros y ordenaciones: Google recomienda
noindexo una regla de robots.txt para evitar indexar variantes filtradas o reordenadas.
Los títulos y descripciones pueden repetirse entre páginas de la secuencia: Google intenta reconocerla. El valor que pasa el enlace entre tramos es el del enlazado interno: un producto que solo se alcanza tras muchos «siguiente» está a muchos clics de la home.
Si el listado es muy grande
Con miles de URLs paginadas aparece el problema de siempre: rastreo desperdiciado y páginas profundas que se visitan poco. Antes de decidir qué se indexa, mira el presupuesto de rastreo y qué páginas profundas reciben visitas de Googlebot. Y piensa si esa profundidad es necesaria: cuántos niveles tiene un listado es una decisión de la arquitectura web, no del componente de scroll. Con categorías y subcategorías razonables no hace falta una lista de 400 páginas.
Cómo elegir: árbol de decisión
La pregunta de partida no es qué patrón queda más moderno, sino si lo que carga el listado tiene que posicionar.
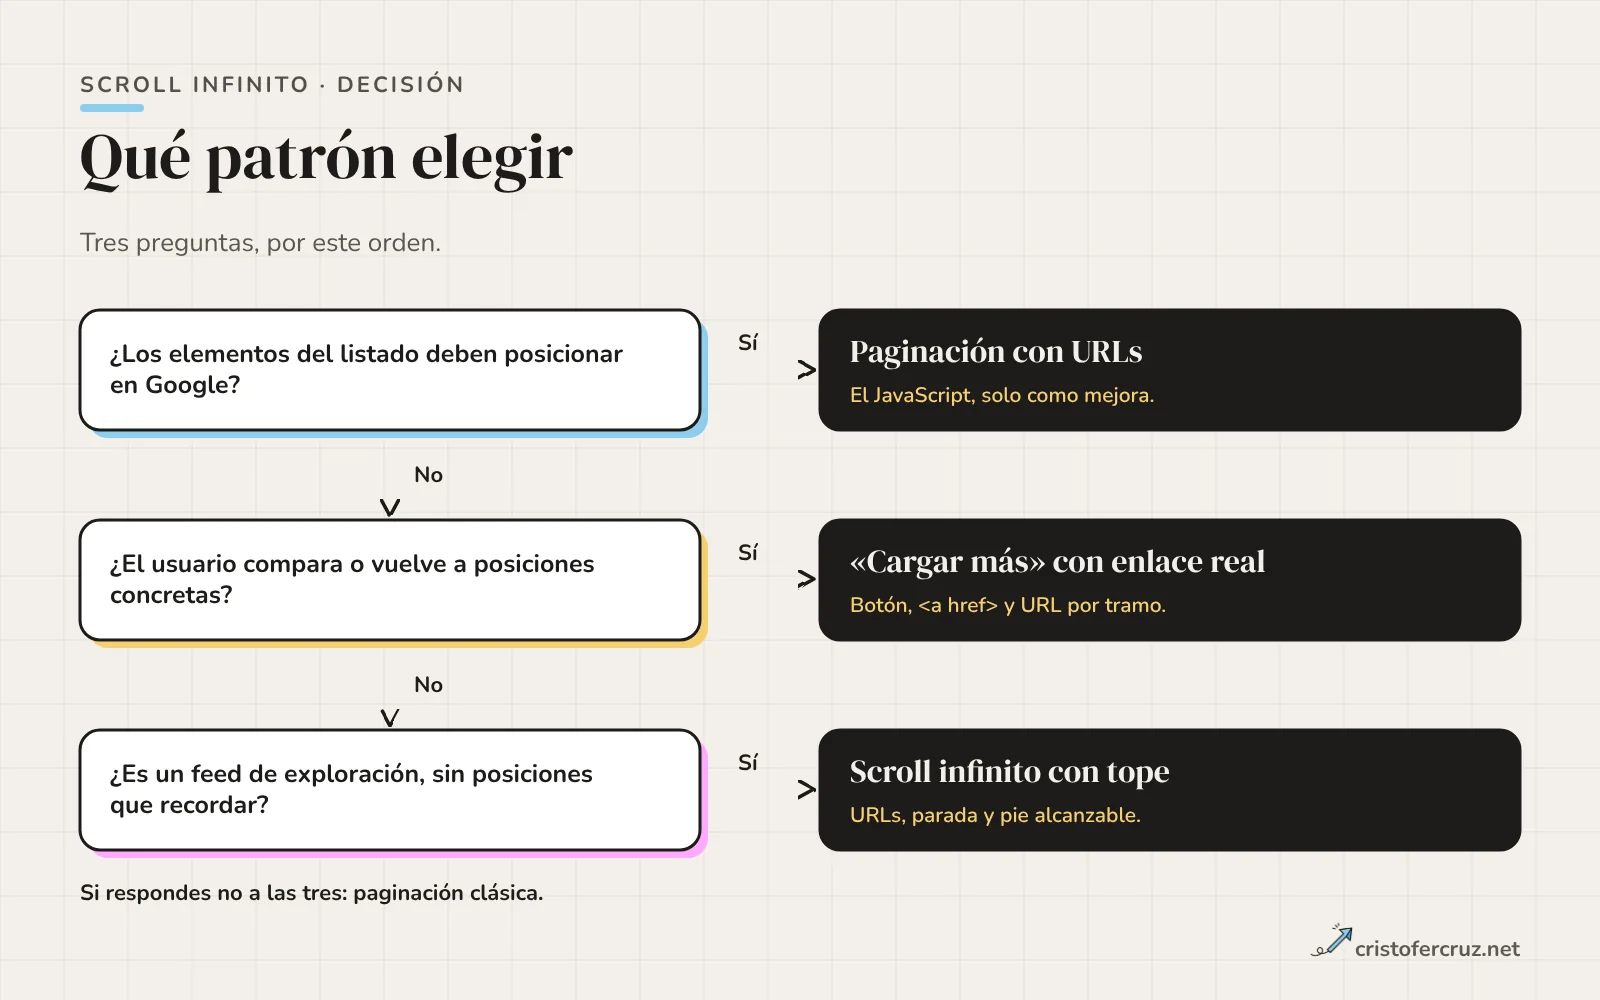
- Un catálogo, un blog o un listado que debe posicionar: paginación con URLs. Si quieres comodidad, mejórala con el JavaScript de la receta.
- Un listado en el que el usuario compara, filtra o vuelve a posiciones concretas: «cargar más» con enlace real y URL por tramo.
- Un feed de exploración, sin posiciones que recordar: scroll infinito, con tope de cargas automáticas, URLs por tramo y pie accesible.
Receta: IntersectionObserver con enlace de respaldo
El HTML es una paginación normal. La página 1 lleva sus elementos y un enlace al siguiente tramo:
<ul id="lista" data-page="1">
  <li><a href="/producto/1">Producto 1</a></li>
  <!-- … hasta el 10 -->
</ul>
<nav aria-label="Paginación">
  <a id="mas" rel="next" href="/lista?page=2">Cargar más</a>
</nav>
El script se limita a mejorar ese enlace. Lo he probado con Playwright y Chromium contra un servidor de prueba de cinco páginas de diez elementos:
(() => {
  const list = document.querySelector('#lista');
  let more = document.querySelector('#mas');
  if (!list || !more || !('IntersectionObserver' in window)) return;
  const MAX_AUTO = 3;
  let auto = 0, busy = false;
  const pages = new IntersectionObserver((entries) => {
    entries.forEach((e) => {
      if (e.isIntersecting && e.target.dataset.url !== location.href)
        history.replaceState(null, '', e.target.dataset.url);
    });
  }, { rootMargin: '0px 0px -70% 0px' });
  const mark = (el, url) => { el.dataset.url = url; pages.observe(el); };
  mark(list.firstElementChild, location.href);

  async function load() {
    if (busy || !more) return;
    busy = true;
    more.setAttribute('aria-busy', 'true');
    try {
      const url = more.href;
      const res = await fetch(url, { headers: { Accept: 'text/html' } });
      if (!res.ok) throw new Error(res.status);
      const doc = new DOMParser().parseFromString(await res.text(), 'text/html');
      const items = [...doc.querySelectorAll('#lista > li')];
      items.forEach((li) => list.append(document.importNode(li, true)));
      mark(list.children[list.children.length - items.length], url);
      const nextLink = doc.querySelector('#mas');
      if (nextLink) { more.href = nextLink.getAttribute('href'); }
      else { io.disconnect(); more.remove(); more = null; }
    } catch (err) {
      /* El enlace sigue siendo un <a href> normal: el usuario puede navegar */
      io.disconnect();
    } finally {
      busy = false;
      if (more) { more.removeAttribute('aria-busy'); io.unobserve(more); io.observe(more); }
    }
  }
  const io = new IntersectionObserver((entries) => {
    if (entries[0].isIntersecting && auto < MAX_AUTO) { auto++; load(); }
  }, { rootMargin: '0px 0px 400px 0px' });
  io.observe(more);
  more.addEventListener('click', (e) => {
    e.preventDefault();
    load();
  });
})();
Las decisiones de diseño, para que puedas cambiarlas con criterio:
- El enlace
#mases a la vez el botón, el respaldo para rastreadores y el elemento que vigila el observador. ConrootMarginde 400 px el siguiente tramo empieza a cargarse algo antes de que llegue a la pantalla, según describe MDN. - Tras tres cargas automáticas el observador deja de actuar y la carga pasa a ser por clic. Es lo que evita que el pie de página se aleje para siempre.
- Cada tramo marca su primer elemento con su URL; cuando ese elemento entra en la zona alta de la pantalla se llama a
replaceState. - Si el listado lo pinta el cliente en lugar del servidor, esta receta no sirve tal cual: primero hay que resolver el renderizado en servidor o estático de cada página.
Esto es lo que midió el test:
| Prueba | Resultado |
|---|---|
| JavaScript desactivado | 10 elementos y el enlace /lista?page=2 en el HTML |
| Scroll gradual en ventana de 1280×720 | Se cargaron los tramos 2, 3 y 4 solos; después, el botón; la URL cambió a ?page=2, ?page=3 y ?page=4 y volvió a /lista al subir |
| Clic en el enlace tras el tope | Cargó el último tramo y el enlace desapareció |
Entrada directa a ?page=3 | Carga con sus 10 elementos y arranca desde ahí |
| Ventana de 412×9000 sin hacer scroll | 40 elementos: tres cargas automáticas; el quinto tramo quedó tras el enlace |
| Historial del navegador | Sin entradas nuevas durante el scroll (replaceState) |
La penúltima fila no simula a Googlebot: Google no documenta su viewport y ese resultado solo describe mi código. Lo que garantiza el diseño es que el HTML inicial ya trae el enlace a la página siguiente y que cada página existe por sí misma.
Qué contenido queda oculto y cómo detectarlo
Hay tres familias de contenido que dependen de una interacción y pueden no llegar al índice.
- Tramos de listado cargados por scroll o por «cargar más», sin URL ni enlace.
- Contenido que se pide con
fetchtras un clic, como un «ver más» que descarga el texto restante del servidor. Si el texto ya está en el HTML y solo se oculta con CSS, el caso es distinto: lo tienes en la guía de lazy-loading y contenido tras una interacción. - Elementos de carga diferida: imágenes, vídeos y bloques que esperan a entrar en el viewport. Los métodos válidos están en mi guía de carga diferida de imágenes y JavaScript, y el caso de los iframes en iframes con carga diferida.
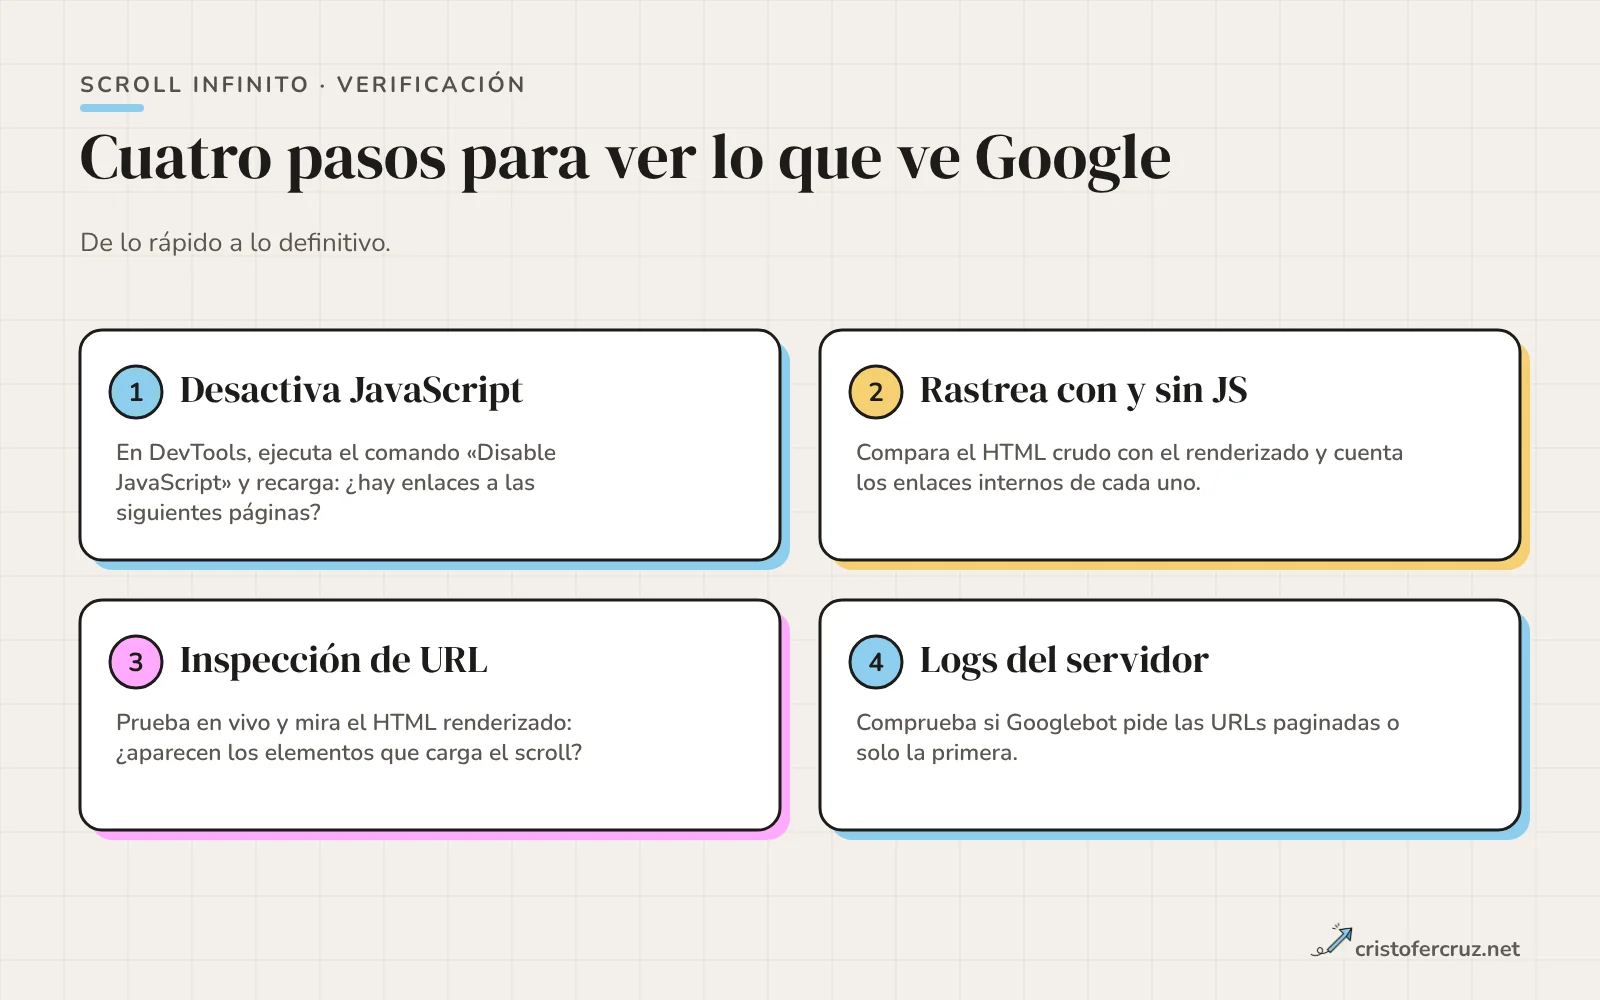
Cómo lo audito, paso a paso
- Sin JavaScript. En Chrome DevTools, abre la paleta de comandos (Ctrl+Shift+P), escribe «Disable JavaScript» y recarga. ¿Quedan enlaces a la página siguiente? ¿Cuántos elementos ves?
- Con y sin JavaScript a escala. Rastrea una muestra con un crawler en modo JavaScript y otra sin él, y compara el recuento de enlaces internos y de URLs descubiertas. Los listados paginados que solo aparecen en el rastreo con JavaScript son el síntoma.
- Inspección de URL. Haz una prueba en vivo en Search Console y abre el HTML renderizado: Google recomienda mirar ahí si los elementos cargados aparecen.
- Logs. Mira si Googlebot pide las URLs paginadas o solo la primera. El análisis de logs del servidor es la forma de saber qué rastrea de verdad, algo que ningún test sintético te dice.
Rendimiento y accesibilidad: lo que no ve Search Console
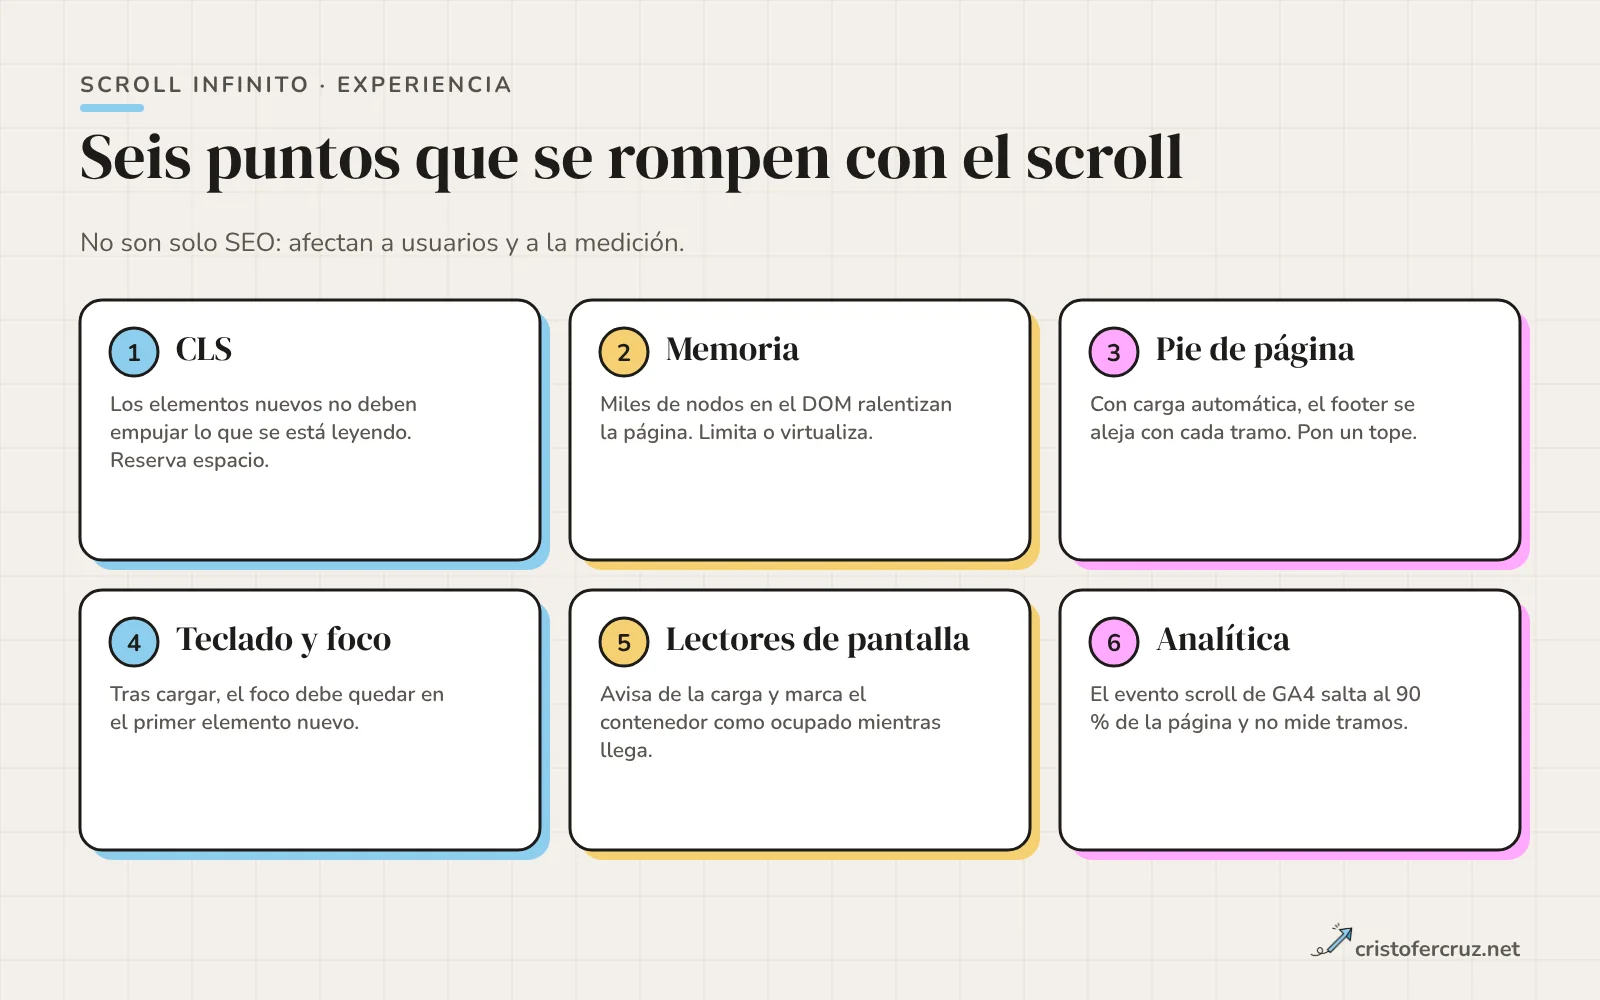
CLS. Los tramos nuevos no deben desplazar lo que el usuario está leyendo. Según web.dev, un buen CLS es 0,1 o menos en el percentil 75, y los cambios de diseño que ocurren en los 500 ms posteriores a una entrada del usuario (clic, toque o pulsación de tecla) se excluyen del cálculo, pero el scroll no cuenta como entrada. Por tanto, el scroll infinito que inserta contenido sin reservar espacio suma CLS; con «cargar más», el desplazamiento que ocurre justo tras el clic queda dentro de esa ventana. Más sobre el resto de métricas en mi guía de Core Web Vitals.
Memoria y DOM. Cada tramo añade nodos que nunca se retiran. En móviles modestos, miles de nodos acaban notándose, y el SEO para móvil es donde más se nota. No tengo cifras de umbral que dar como verificadas: mide con DevTools (pestaña Performance y Memory) en un dispositivo real.
Pie de página. Con carga automática, el usuario que quiere llegar al pie (contacto, legal, enlaces de ayuda) lo ve alejarse con cada tramo. Es lo que justifica el tope de cargas automáticas de la receta.
Teclado, foco y lectores de pantalla. El patrón de feed de las WAI-ARIA Authoring Practices recomienda role="feed" en el contenedor y role="article" en cada elemento, con aria-posinset y aria-setsize (con -1 si no se conoce el total), y aria-busy="true" mientras se añaden varios elementos. El mismo documento avisa de que la carga por scroll puede dar problemas de uso e interoperabilidad con tecnologías de apoyo. Tras cargar, mueve el foco al primer elemento nuevo si el usuario ha pulsado el botón. El contexto general está en mi guía de accesibilidad web y SEO.
Si implementas scroll automático, prueba una vez con solo teclado y una vez con un lector de pantalla. Si no llegas al pie sin recorrer todo el listado, el patrón no está terminado.
Analítica: qué mide el scroll en GA4
La medición mejorada de GA4 recoge de serie un evento scroll, pero según la documentación de Google solo se dispara la primera vez que el usuario llega al final de cada página, entendido como el 90 % de la profundidad vertical visible. Se envía una vez por página y su único parámetro es engagement_time_msec.
Con un scroll infinito esto cambia de significado: llegar al 90 % de una página que no para de crecer puede ocurrir mucho antes de lo esperado, y después no se vuelve a medir. Con ese evento no sabrás en qué tramo abandona la gente. Define eventos propios, uno por tramo cargado con el número de página, desde el mismo código que actualiza la URL. GA4 no lo hace por defecto y no tengo un nombre de evento oficial que recomendar.
Profundidad de scroll y «above the fold»: qué se sabe
La otra mitad de «scroll y SEO» es la creencia de que el contenido que queda por debajo de la primera pantalla pesa menos para Google. Esto es lo que he podido verificar:
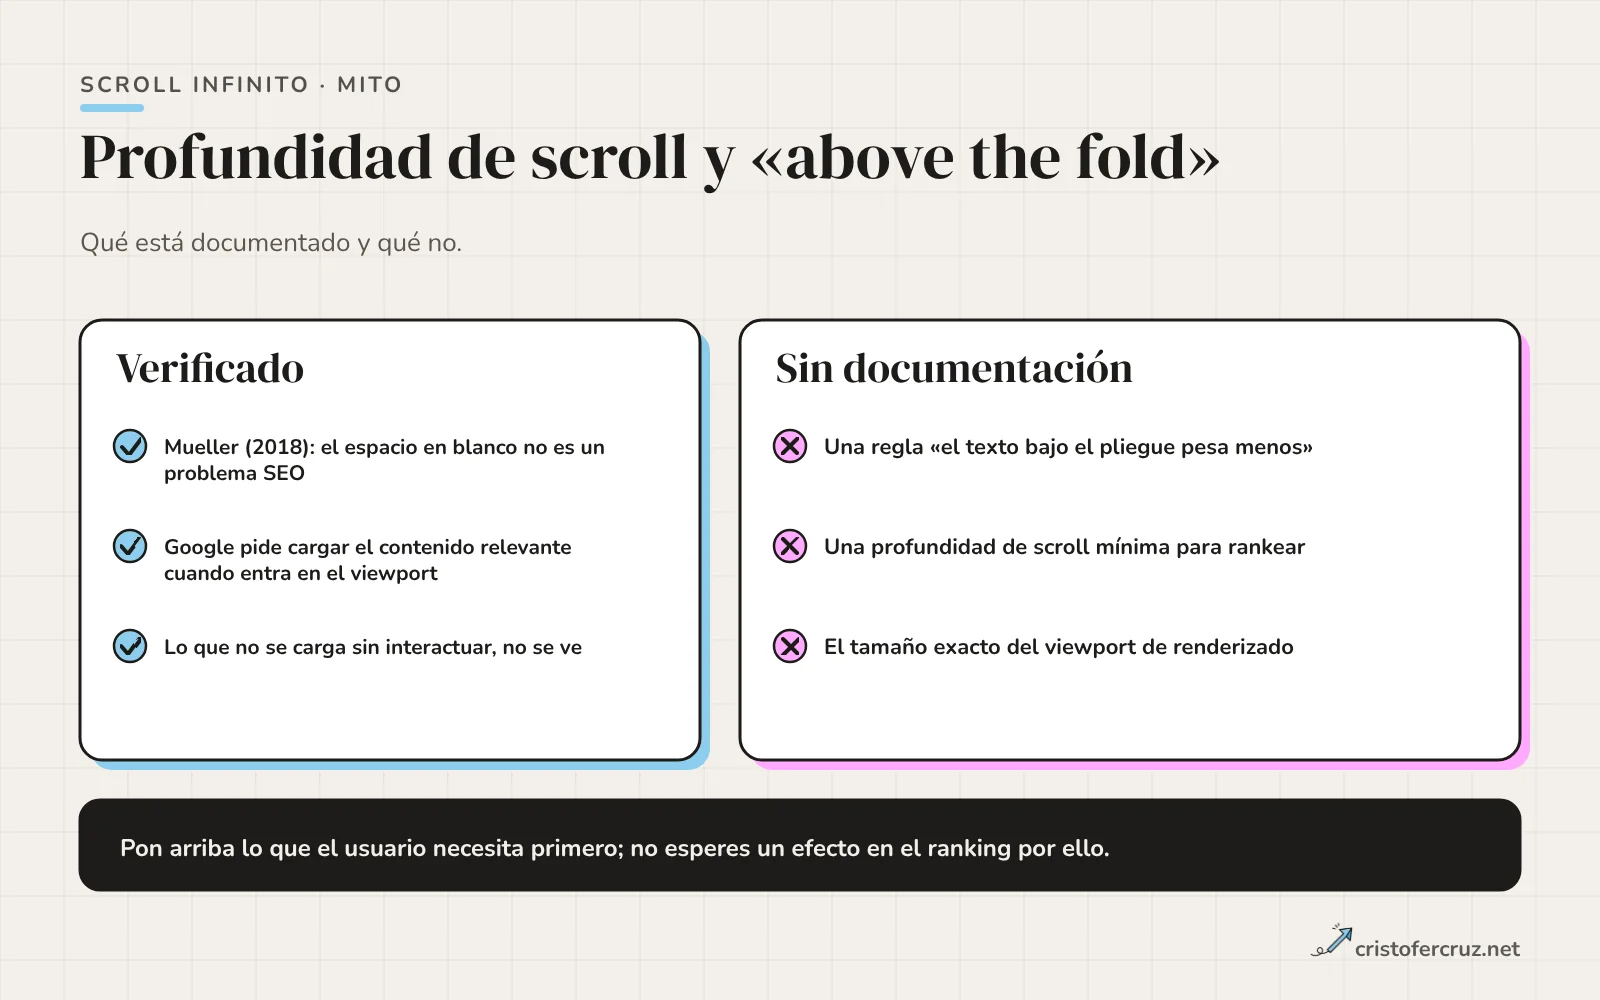
- En 2018, John Mueller respondió en un hangout que el espacio en blanco que empuja el contenido hacia abajo es «absolutamente ningún problema». Lo que sí le preocupaba eran los anuncios que ocupan la parte superior y dejan al usuario sin ver el contenido que buscaba, según la crónica de Search Engine Roundtable.
- La documentación que he repasado para este artículo no define una regla de peso por posición en la página, ni una profundidad mínima de scroll para posicionar. La página de Google sobre experiencia de página no menciona «above the fold».
Que algo no esté documentado no prueba que no exista, y lo digo expresamente: no tengo un experimento propio que lo refute. Lo que sí cambia con la posición es lo que el usuario ve primero. Por eso pongo arriba lo que responde a su intención, sin esperar un efecto en posiciones.
Cómo lo tengo en mi web
El listado del blog de cristofercruz.net no usa scroll infinito ni «cargar más»: es paginación clásica, con seis artículos por página y URLs de la forma /blog/?pagina=2. Lo comprobé en el código (blog/index.php, includes/blog.php y assets/blog.js) y con curl y Playwright contra una copia local.
| Qué comprobé | Resultado |
|---|---|
| Enlaces a artículos | Son <a href> en el HTML del servidor: seis tarjetas por página, igual con JavaScript activado y desactivado |
| Navegación entre páginas | Enlaces «Anterior» y «Siguiente» con href real y rel="prev" / rel="next" (Google ya no los usa). No hay números de página |
| Canonical y robots de las páginas paginadas | Cada página se autorreferencia (?pagina=2), con index, follow y título «Blog SEO · Página 2» |
| Filtros y búsqueda | Con categoría o búsqueda: noindex, follow y canonical a la lista sin filtrar |
| robots.txt | No bloquea ni la paginación ni los filtros; el servidor decide con canonical y noindex |
| Con JavaScript | assets/blog.js intercepta el clic en esos enlaces, pide el listado a /blog/feed.php, actualiza la URL con pushState y reescribe canonical, robots y título. El feed responde con noindex y no-store |
Eso es la estructura de la receta: HTML con enlaces reales y JavaScript como mejora. Esto es lo que no está resuelto o que debería revisar:
- Sin números de página, la página N está a N-1 clics de
/blog/. Al probarlo había nueve páginas, y el último listado quedaba a ocho «Siguiente». Los artículos entran en el sitemap, así que se descubren sin recorrer el listado, pero el listado profundo es poco accesible. - El sitemap del blog (
/sitemap-blog.xml) incluye/blog/y los artículos, y no las URLs?pagina=N. El código no explica si es deliberado; no lo he preguntado a nadie, y conviene saberlo. - Una URL fuera de rango como
?pagina=999responde 200 con la última página y un canonical a esa última página, en lugar de un 404. - Con categoría y página (
?categoria=rastreo&pagina=2) la página llevanoindexy un canonical a/blog/?pagina=2. Es una combinación de señales distintas y no he comprobado cómo la trata Google.
Mi veredicto: para un blog con esta cantidad de artículos, la paginación con URLs es la elección correcta; lo siguiente que añadiría son enlaces numerados y no tocar el resto.
Preguntas frecuentes
¿El scroll infinito es malo para el SEO?
No por sí mismo. Es malo cuando no deja enlaces ni URLs en el HTML, porque Google no hace clic ni scroll. Con URLs únicas por tramo y enlaces <a href> entre ellas, el contenido es rastreable.
¿Googlebot hace scroll?
La documentación de Google no lo describe. Martin Splitt dijo en 2020 que Googlebot no hace scroll, y la guía de lazy loading establece que Google Search no interactúa con la página. Es más seguro diseñar como si no lo hiciera.
¿«Cargar más» es mejor que el scroll infinito para SEO?
Es más fácil de arreglar, porque puedes hacer que el botón sea un enlace con href a la página siguiente. Pero un botón con solo JavaScript tiene el mismo problema: Google no hace clic en botones.
¿Sigue sirviendo rel=prev y rel=next?
Google ya no los usa, según su documentación sobre paginación. Otros buscadores pueden seguir leyéndolos. No hacen daño, pero lo que importa son los enlaces <a href> y los canonical de cada página.
¿Qué canonical lleva cada página paginada?
El suyo propio. Google desaconseja usar la primera página como canonical de toda la secuencia, porque trata las URLs de una secuencia como páginas independientes.
¿Importa que el contenido esté al principio o al final de la página?
No hay una regla documentada de peso por posición ni de profundidad de scroll. Mueller dijo en 2018 que el espacio en blanco que baja el contenido no es un problema. Sí importa que lo que necesita el usuario no esté tapado por anuncios.
Referencias y fuentes
Documentación y fuentes que he abierto para este artículo.
- Pagination, incremental page loading, and their impact on Google Search Google Search Central · actualizada 2025-12-10
- Fix lazy-loaded content Google Search Central · actualizada 2025-12-10
- Medición mejorada: eventos de GA4 Ayuda de Google Analytics
- Cumulative Layout Shift (CLS) web.dev · Google
- Feed Pattern W3C · WAI-ARIA Authoring Practices
- Google on infinite scroll and lazy loading (Martin Splitt, abril de 2020) Search Engine Journal
- Google: White Space Pushing Content Down Is Not An SEO Issue Search Engine Roundtable · 2018
- Impact of Google Removing Infinite Scrolling Workshop Digital · 2024