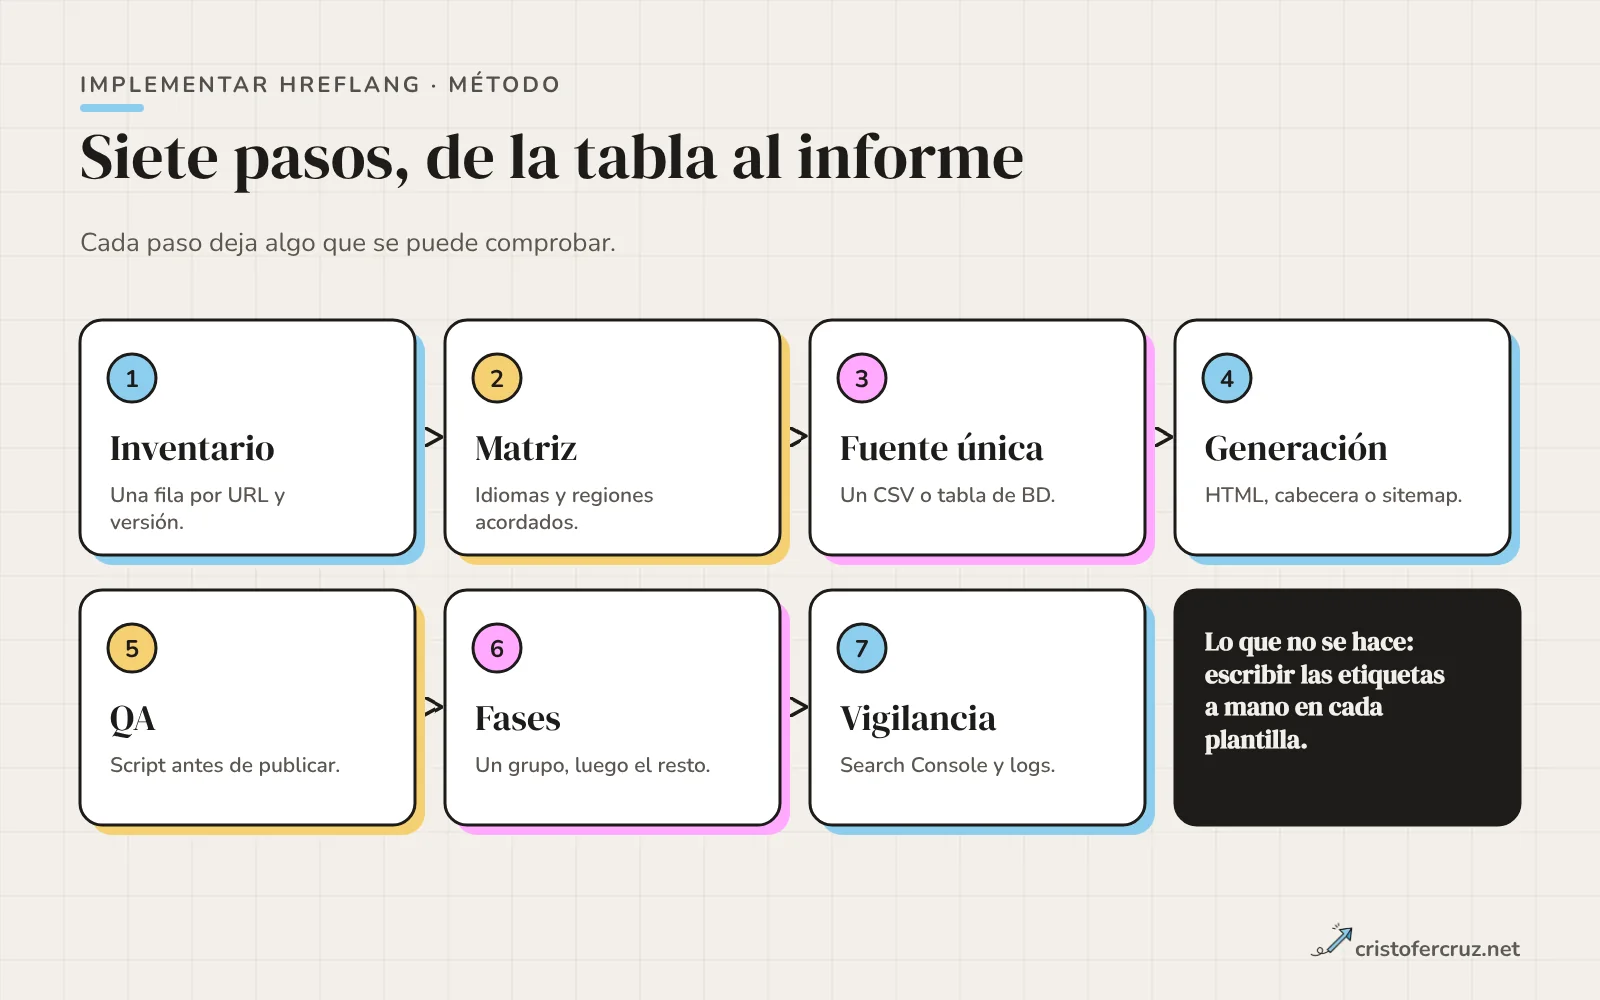
- Implementar hreflang es un problema de datos, no de etiquetas: una tabla con una fila por URL y versión, validada, de la que salen el HTML, la cabecera o el sitemap.
- Antes de generar nada hay que cerrar la matriz idioma-región y decidir qué URL es la de cada versión y cuál es el
x-default, si lo hay. - Una URL solo entra en el grupo si responde 200, es indexable, tiene canonical propio y se declara con URL absoluta.
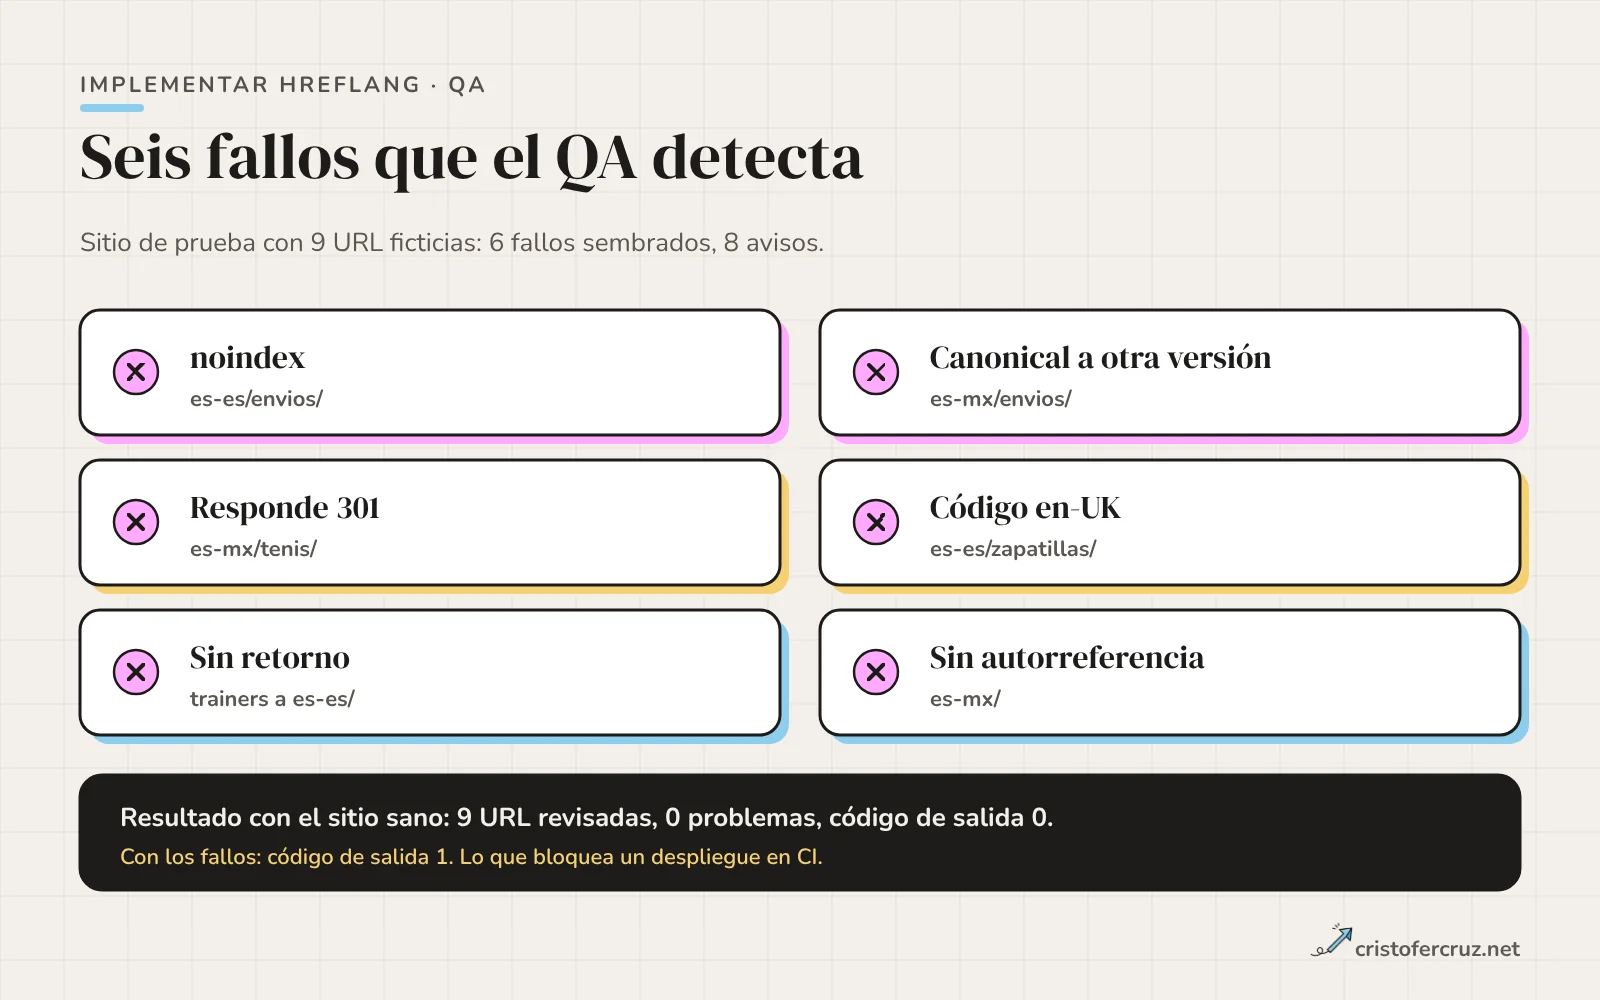
- El QA se automatiza contra la respuesta real de cada URL, no contra la tabla. En mi sitio de prueba, un script de 66 líneas detecta seis fallos sembrados.
- Se despliega por fases, con una condición de paso entre cada una, y se vigila con Search Console y logs, porque ya no existe un informe específico de hreflang.
- Mi web es monolingüe y no necesita esta implementación: el código del artículo se ha probado sobre un sitio ficticio.
El fallo habitual al implementar hreflang no está en la sintaxis. Está en que alguien escribe las etiquetas a mano en la plantilla de tres idiomas, se añade una cuarta versión seis meses después y solo se actualiza la nueva. Desde fuera todo parece correcto y Google ignora las anotaciones porque falta la mitad de las confirmaciones de vuelta.
Qué es hreflang, los códigos válidos y las reglas de reciprocidad ya los expliqué en la guía de hreflang. Aquí está lo que viene después: el proceso para implementarlo en un proyecto con muchas URL, con un generador y un validador que he escrito y ejecutado sobre un sitio ficticio, cómo integrarlo en un CMS y cómo desplegarlo y vigilarlo sin romper lo que ya posiciona.
Primero el inventario: qué URL equivale a cuál
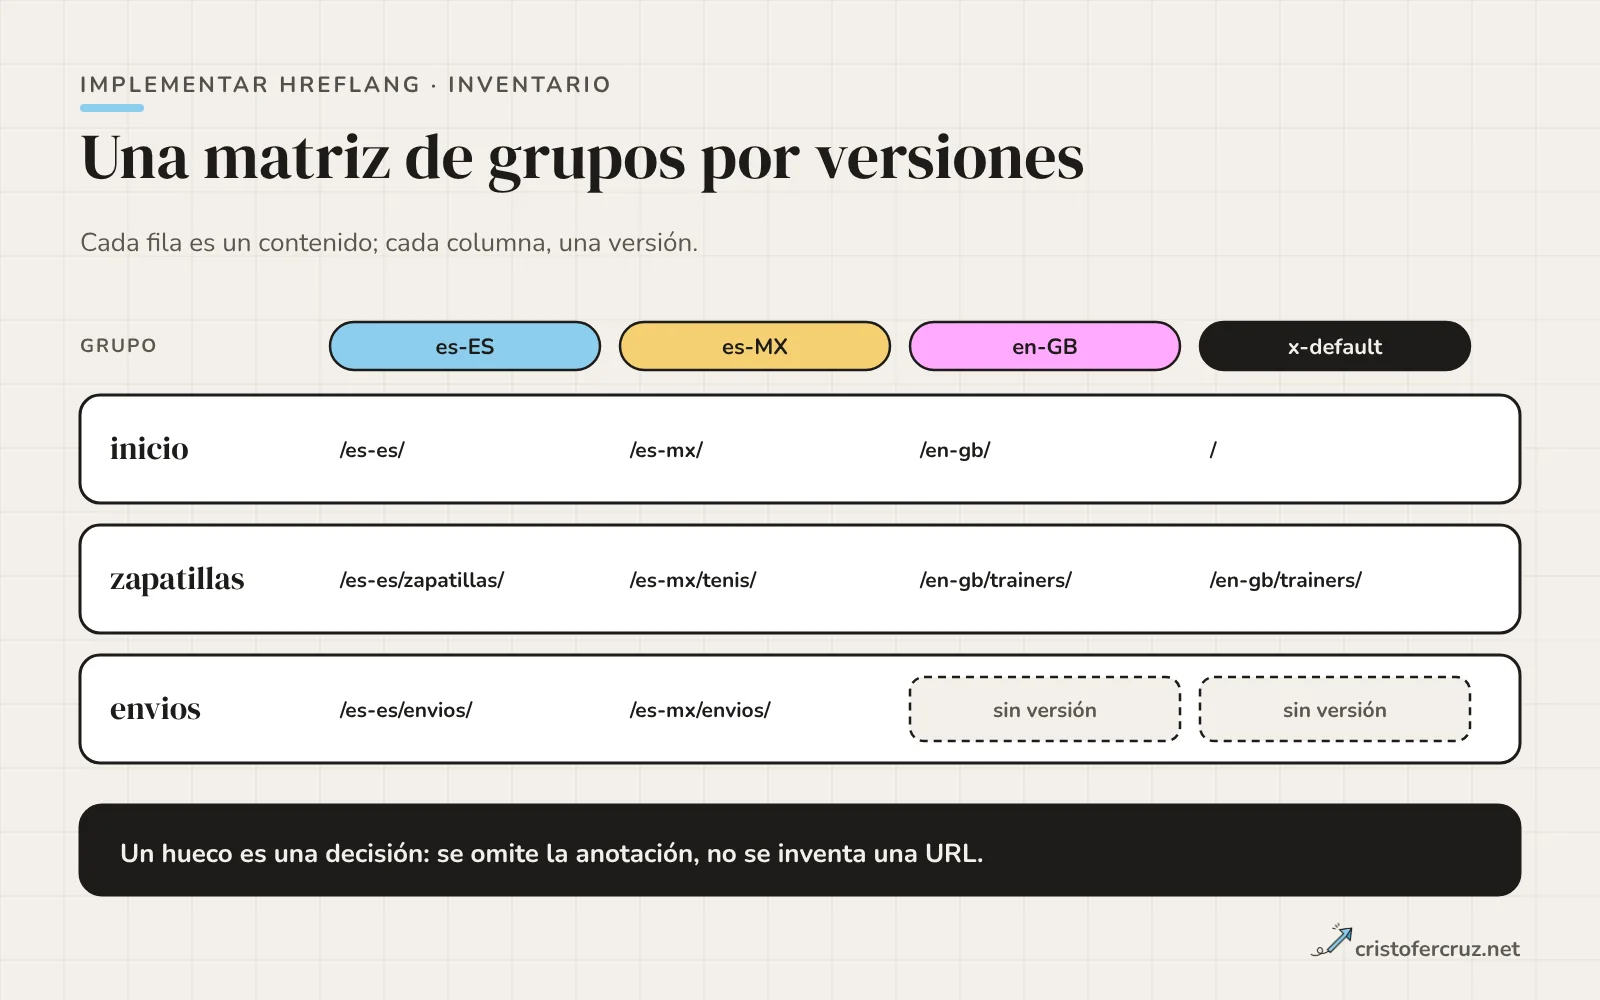
Lo primero no es elegir el método, es saber qué páginas son versiones de qué. Google indica que cada versión debe listarse a sí misma y a todas las demás, así que necesitas esa relación completa antes de generar una sola línea. Yo la organizo en grupos: un grupo es un contenido (una home, una categoría, un producto) y cada fila del grupo es una versión.
La relación no siempre es 1 a 1 ni tiene la misma URL con el idioma cambiado. En mi sitio ficticio, «zapatillas» es /es-es/zapatillas/ en España, /es-mx/tenis/ en México y /en-gb/trainers/ en Reino Unido. Si dedujeras las equivalencias por el patrón de la URL, fallarías justo en las páginas que más venden.
Las fuentes para construir el inventario, de más a menos fiable: la base de datos o el CMS si las traducciones están enlazadas entre sí, el sitemap actual si cada URL ya está en su idioma, o un rastreo exportado con una hoja de emparejamiento manual cuando no hay relación explícita.
Los huecos importan. Si «envíos» existe en español pero no en inglés, el grupo tiene dos versiones y punto. Google admite que se puedan omitir idiomas en algunas páginas si cuesta mantener el conjunto completo. Lo que no debes hacer es apuntar a una URL del idioma que falta para que el grupo parezca simétrico.
La matriz idioma-región
La matriz es la lista cerrada de códigos que existirán en el proyecto. Se decide una vez, por escrito, y el validador la usa como lista blanca. Para cada versión necesitas el código (es-ES, es-MX, en-GB), el patrón de URL y, si procede, el mercado al que sirve.
¿es o es-ES?
Con una sola versión en español para todos los países, es basta. Con versiones por país, usa es-ES y es-MX. Mezclar es con es-ES en el mismo grupo es posible, pero que sea una decisión explícita y no un accidente. Los códigos válidos y los clásicos como en-UK los tienes en la guía principal.
x-default en la tabla
En mi modelo, x-default es una fila más del grupo con su propia URL. En el grupo «inicio» apunta a un selector de país en la raíz; en «zapatillas», a la versión en inglés. Es una decisión por grupo y se guarda en los datos, no en el código. Qué URL poner y cuándo es innecesario lo cubre el artículo sobre x-default en hreflang.
Una fuente única de datos
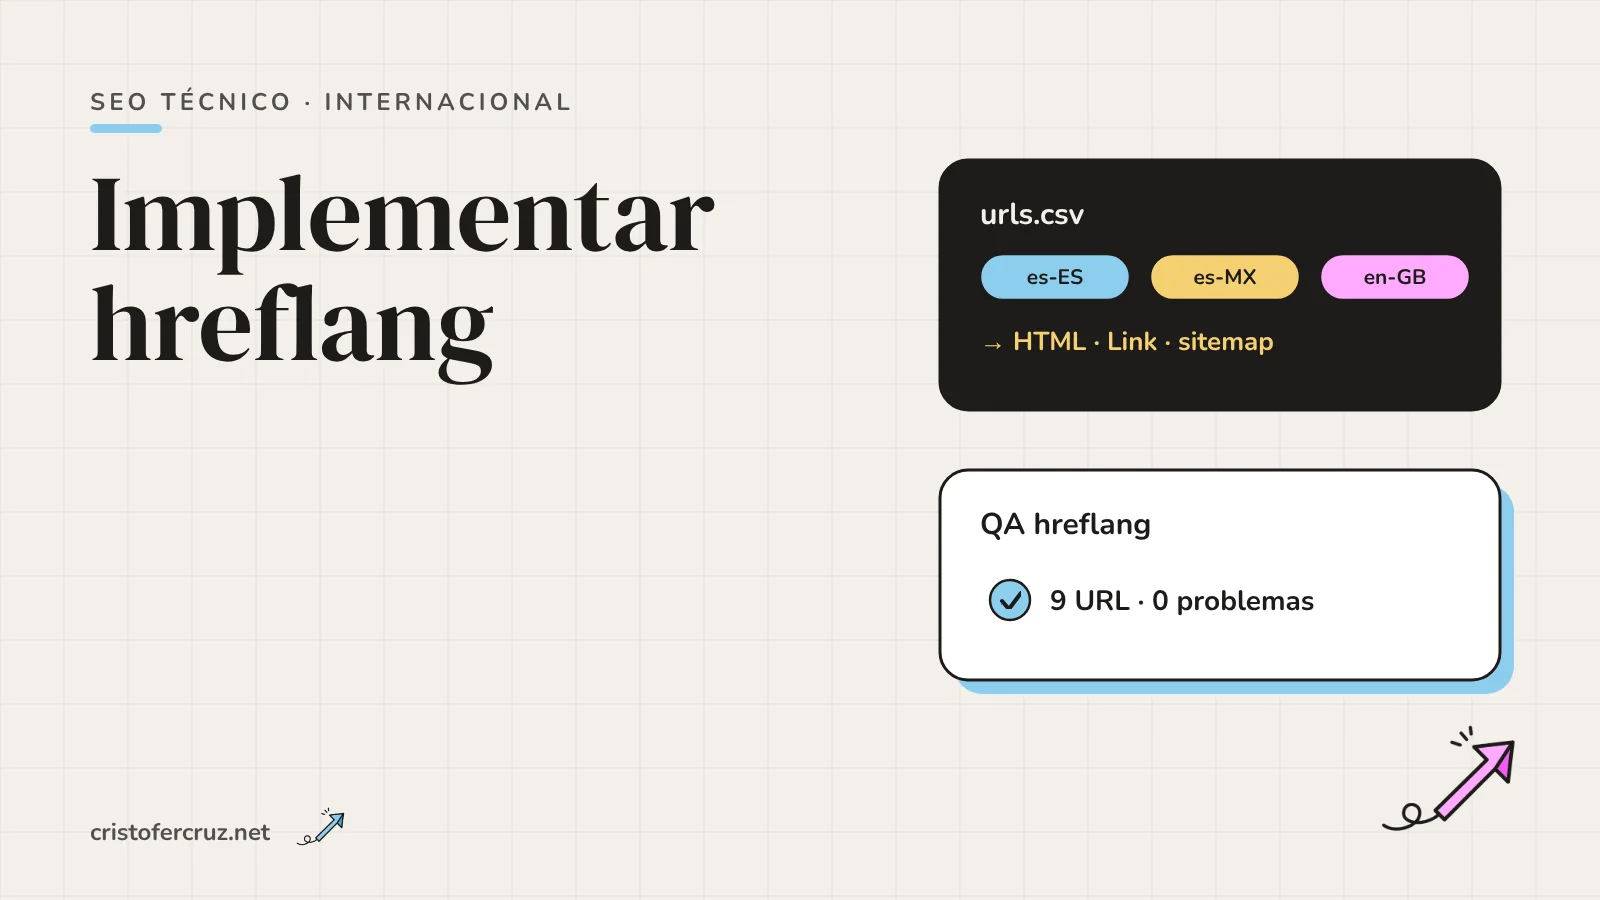
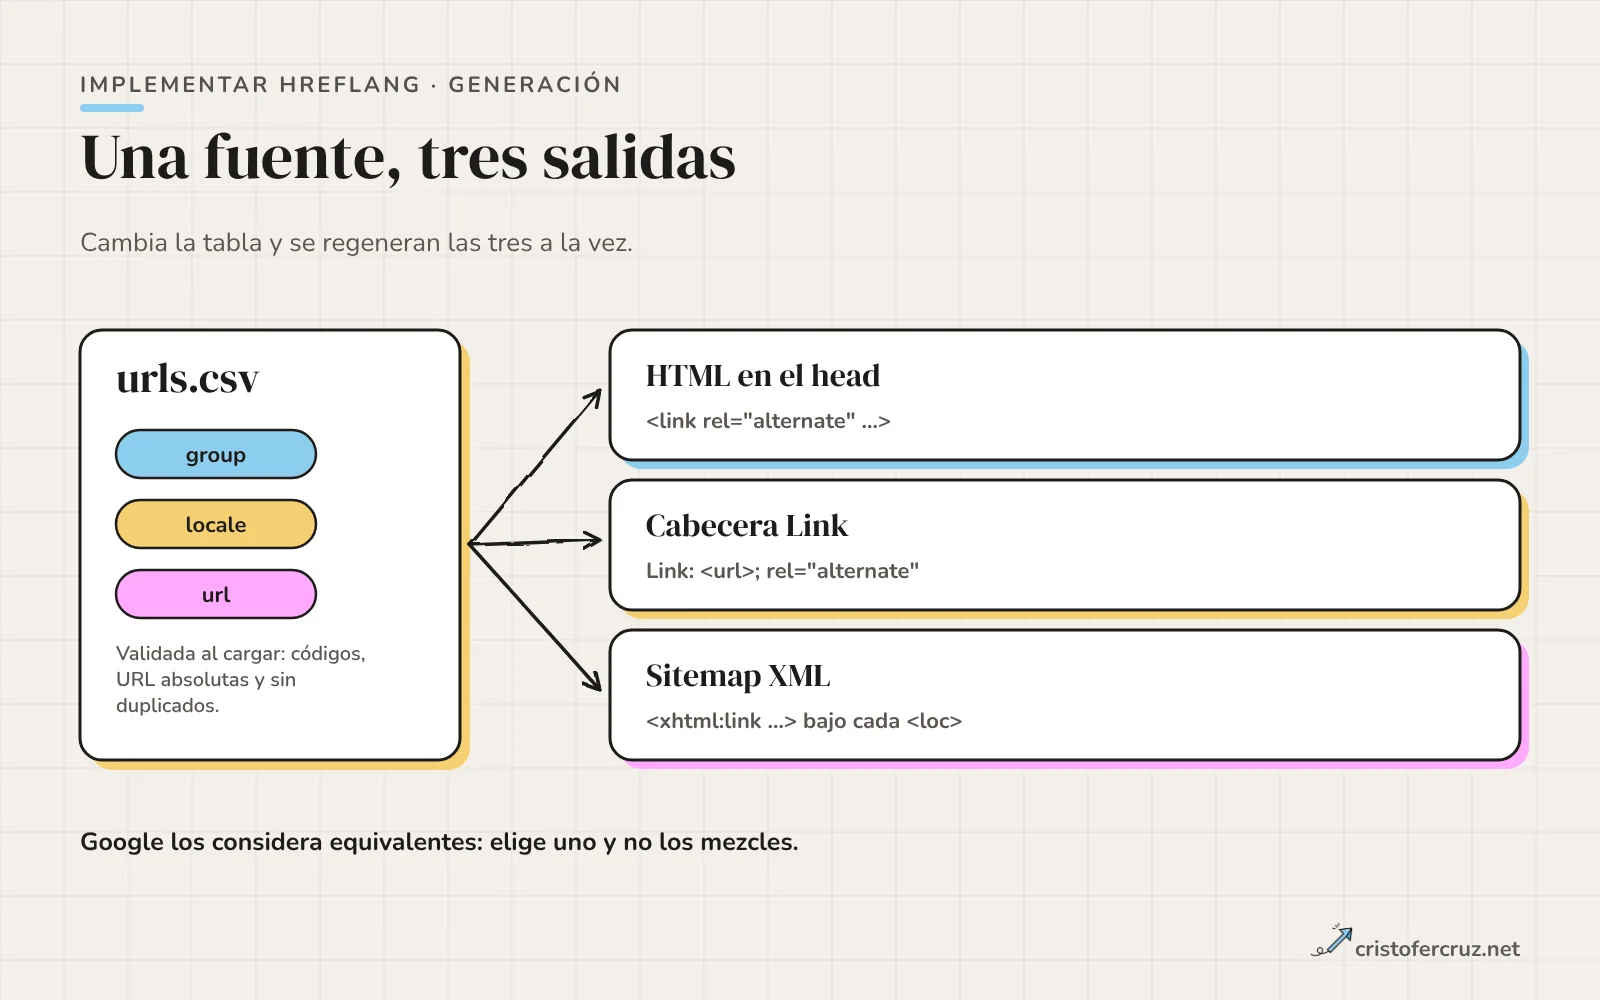
La tabla es un CSV con tres columnas: grupo, código y URL. Cuando el proyecto crece pasa a una tabla de base de datos con el mismo esquema. Debe haber una sola fuente y todas las salidas (HTML, cabecera, sitemap) se generan de ella.
group,locale,url
inicio,es-ES,https://tienda-ejemplo.test/es-es/
inicio,es-MX,https://tienda-ejemplo.test/es-mx/
inicio,en-GB,https://tienda-ejemplo.test/en-gb/
inicio,x-default,https://tienda-ejemplo.test/
zapatillas,es-ES,https://tienda-ejemplo.test/es-es/zapatillas/
zapatillas,es-MX,https://tienda-ejemplo.test/es-mx/tenis/
zapatillas,en-GB,https://tienda-ejemplo.test/en-gb/trainers/
zapatillas,x-default,https://tienda-ejemplo.test/en-gb/trainers/
envios,es-ES,https://tienda-ejemplo.test/es-es/envios/
envios,es-MX,https://tienda-ejemplo.test/es-mx/envios/
Todo el código de este artículo trabaja sobre este sitio ficticio (tienda-ejemplo.test), un laboratorio para romper cosas a propósito. Probé los scripts con Python 3.13 y PHP 8.3.
El generador valida la tabla al cargarla y se detiene con un error claro si encuentra cualquiera de estos problemas:
- Un código que no cumple el formato idioma o idioma-región, o que usa una región reservada sin efecto en Google (
UK,EU,UN). - Una URL relativa o sin protocolo.
- Una versión repetida en el mismo grupo.
- Una URL que aparece en dos grupos distintos.
Probé tres de ellos (código reservado, URL relativa y URL en dos grupos) con un CSV defectuoso. Por ejemplo, en-UK en la línea 2 produce ValueError: línea 2: código no válido «en-UK» y una URL relativa produce la URL debe ser absoluta: /a/. Más barato que descubrirlo semanas después en el rastreo.
Generar el HTML, la cabecera Link y el sitemap
El núcleo del generador son dos funciones. Cada versión del grupo recibe el mismo conjunto de anotaciones, con x-default al final para que la salida sea estable entre ejecuciones:
def annotations(group):
    return sorted(group.items(), key=lambda kv: (kv[0] == 'x-default', kv[0]))

def html_block(group):
    return '\n'.join(f'<link rel="alternate" hreflang="{l}" href={quoteattr(u)} />'
                     for l, u in annotations(group))
Para la página /es-mx/tenis/, el generador devuelve este bloque, idéntico para las tres versiones de «zapatillas»:
<link rel="alternate" hreflang="en-GB" href="https://tienda-ejemplo.test/en-gb/trainers/" />
<link rel="alternate" hreflang="es-ES" href="https://tienda-ejemplo.test/es-es/zapatillas/" />
<link rel="alternate" hreflang="es-MX" href="https://tienda-ejemplo.test/es-mx/tenis/" />
<link rel="alternate" hreflang="x-default" href="https://tienda-ejemplo.test/en-gb/trainers/" />
La versión para sitemap añade una sola cosa: un <url> por URL única (si el x-default coincide con una versión, no se duplica el <loc>) y el espacio de nombres xhtml. Para la cabecera Link usa la misma lista con el formato <url>; rel="alternate"; hreflang="...", útil sobre todo para PDF.
def sitemap(groups):
    out = ['<?xml version="1.0" encoding="UTF-8"?>',
           '<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9" xmlns:xhtml="http://www.w3.org/1999/xhtml">']
    for g, items in groups.items():
        for url in dict.fromkeys(items.values()):
            out.append(f'  <url>\n    <loc>{escape(url)}</loc>')
            out += [f'    <xhtml:link rel="alternate" hreflang="{l}" href={quoteattr(u)} />'
                    for l, u in annotations(items)]
            out.append('  </url>')
    return '\n'.join(out + ['</urlset>'])
Con mi tabla genera 9 bloques <url> y xmllint --noout confirma que el XML está bien formado. Si el sitemap crece mucho, hay un límite que se pasa por alto. Los hijos xhtml:link no cuentan para el límite de URL (lo dice Google), pero el fichero sí tiene un tope de 50 MB sin comprimir según el protocolo de sitemaps.org, y cada versión nueva hace crecer cada entrada.
| Versiones por grupo | Bytes por URL | URL que caben en 50 MiB |
|---|---|---|
| 3 | ≈ 370 | ≈ 142.000 |
| 6 | ≈ 665 | ≈ 79.000 |
| 12 | ≈ 1.260 | ≈ 41.700 |
Medición sintética con el mismo generador y URL cortas: en un proyecto real saldrá algo peor. Con 12 versiones, el límite de tamaño llega antes que el de 50.000 URL. Para el reparto en varios ficheros y un índice, mira la guía de sitemaps XML.
Integración en una plantilla PHP
Si el sitio es propio y prefieres el HTML, la función equivalente en PHP lee la misma tabla y pinta el bloque. Tiene una decisión de diseño: si la URL no está en la tabla, no emite nada.
function hreflang_links(string $csv, string $urlActual): string {
    $grupos = [];
    $f = fopen($csv, 'r'); fgetcsv($f, 0, ',', '"', '');
    while (($r = fgetcsv($f, 0, ',', '"', '')) !== false) { $grupos[$r[0]][$r[1]] = $r[2]; }
    foreach ($grupos as $items) {
        if (!in_array($urlActual, $items, true)) continue;
        uksort($items, fn($a, $b) => [$a === 'x-default', $a] <=> [$b === 'x-default', $b]);
        $html = '';
        foreach ($items as $loc => $url) {
            $html .= '<link rel="alternate" hreflang="' . htmlspecialchars($loc)
                   . '" href="' . htmlspecialchars($url) . '" />' . "\n";
        }
        return $html;
    }
    return '';
}
Para /es-mx/envios/ devuelve exactamente las dos líneas (es-ES y es-MX) que genera la versión Python. En producción cachearías la tabla en memoria; no he medido rendimiento.
Integración en un CMS
En un CMS la pregunta es quién conoce las equivalencias: si el sistema ya enlaza las traducciones, que pinte él las etiquetas; si no, necesitas la tabla.
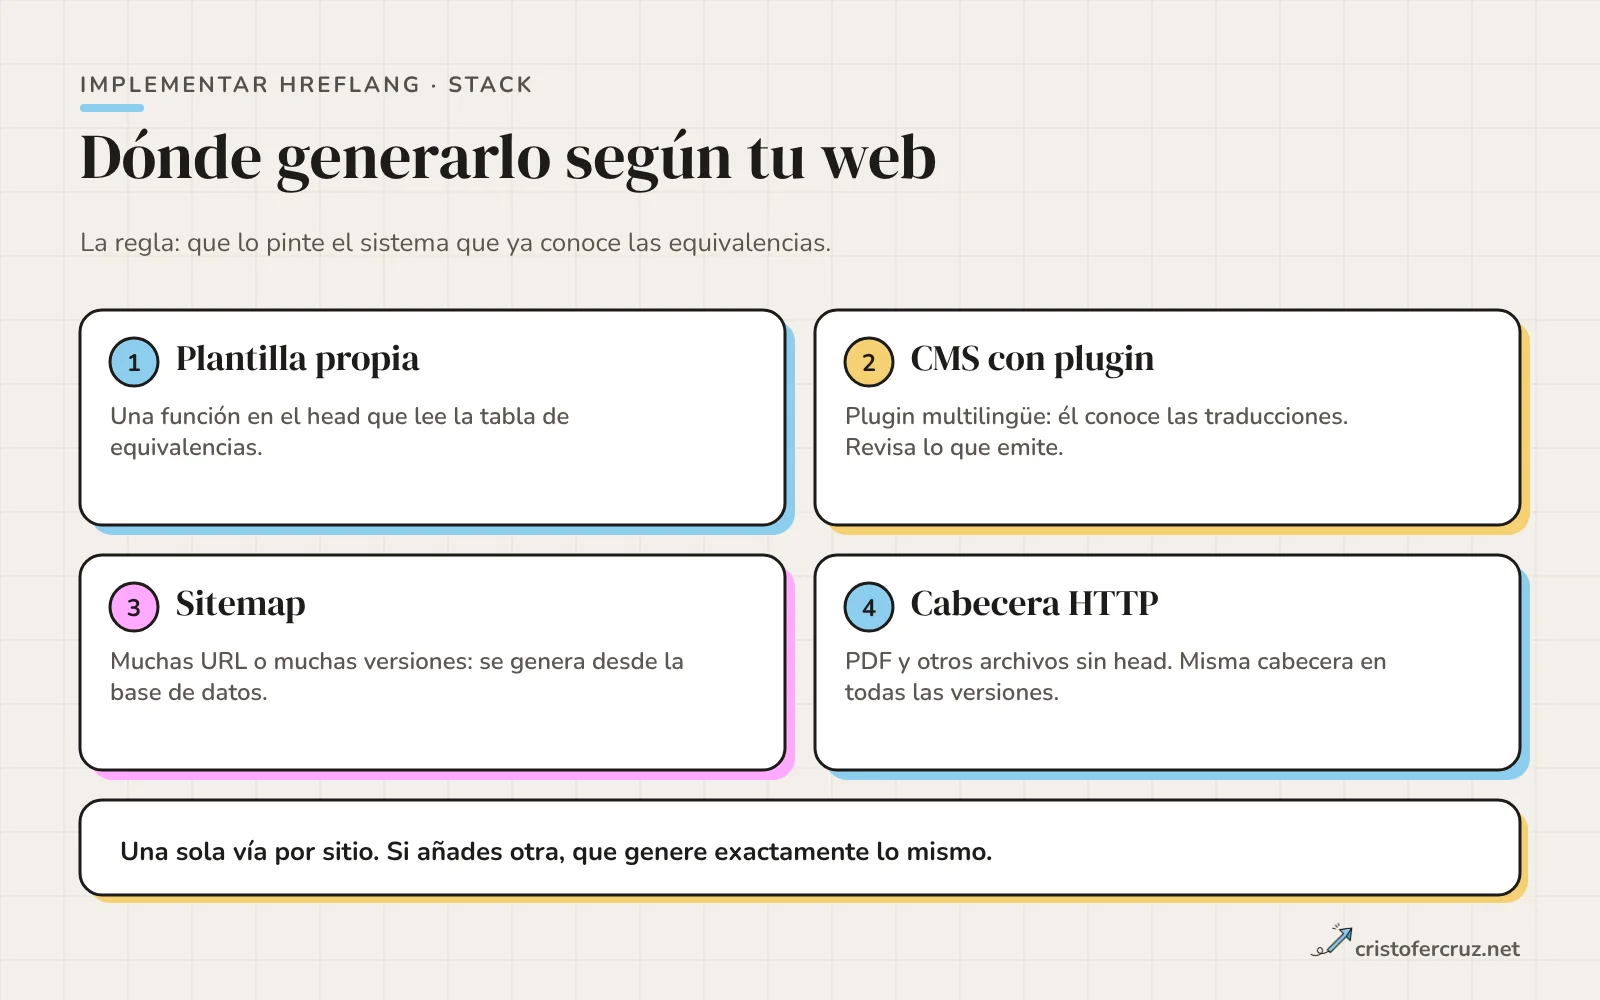
Con WordPress hay dos caminos. Uno es un plugin multilingüe, que sabe qué entrada traduce a cuál y emite las etiquetas. No he probado ninguno, así que no te doy nombres. Una guía de terceros (la última referencia) indica que al menos uno de los más usados no añade x-default por defecto; no lo he comprobado. Revisa lo que emite el plugin, no lo que promete.
El otro camino es una función propia enganchada a wp_head, la acción que según la documentación de WordPress «imprime scripts o datos en la etiqueta head del front end». Tiene sentido con instalaciones separadas por idioma o con CMS headless, donde ningún plugin conoce el resto de versiones. No he probado ese código sobre WordPress; la lógica sería la de la función PHP anterior con tu tabla.
De Shopify y PrestaShop no puedo decirte nada contrastado: no los he probado. Mira qué genera tu plantilla con curl. Si cada idioma vive en un subdominio y no en una carpeta, la decisión de estructura es anterior y la trato en la guía sobre subdominios y subdirectorios.
URL absolutas y canonical coherente
Google exige que las URL alternativas estén completamente cualificadas, con protocolo. El generador lo comprueba al cargar la tabla, y por eso una URL como /es-mx/tenis/ hace fallar el script antes de generar nada. No mezcles http con https ni www con no-www: la URL de hreflang tiene que ser la canónica de esa versión, byte a byte.
Con el canonical, la regla de Google es que cada página localizada tenga como canonical una página de su mismo idioma o, si no existe, la mejor sustituta. Una versión que canonicaliza a otra se trata como duplicado y deja de tener sentido en el grupo. Cómo elegir y declarar la canónica está en el artículo de canonicals. Aquí la consecuencia práctica: el canonical de cada URL sale de la misma tabla; con dos fuentes de verdad, tarde o temprano se contradicen.
Qué debe cumplir cada URL antes de entrar al grupo
Una URL del grupo con un problema contamina las demás, porque las anotaciones de todas las versiones apuntan a ella. Antes de publicar un grupo compruebo cinco condiciones por URL, medidas contra la respuesta real.
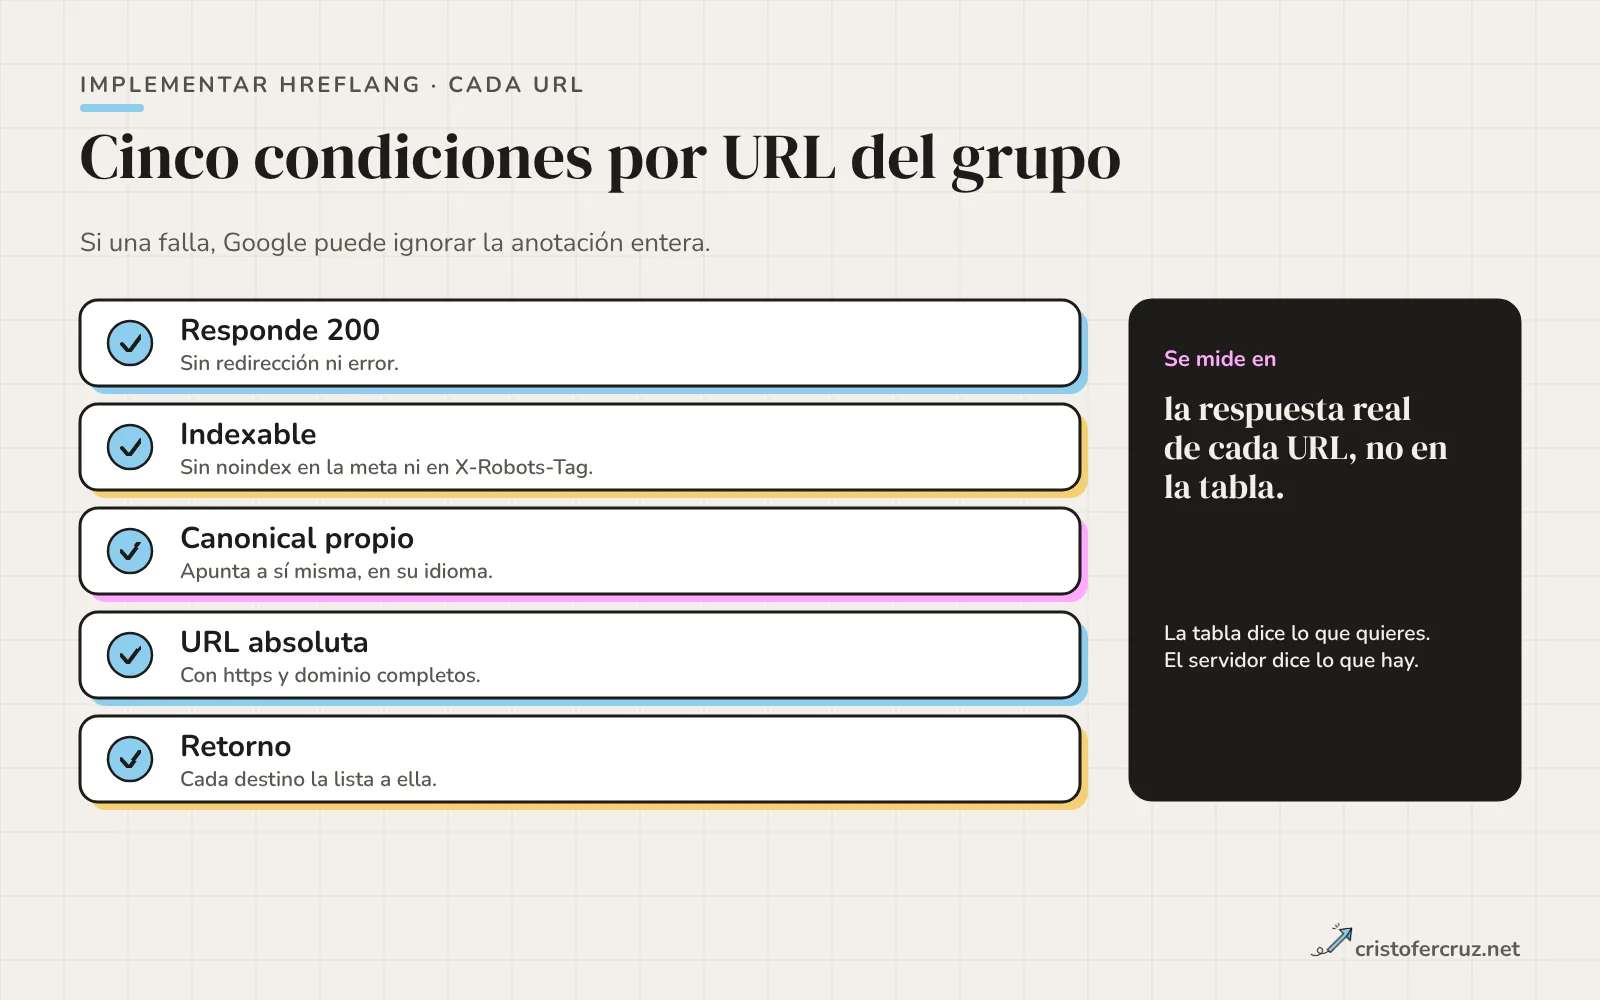
| Condición | Cómo se comprueba | Qué rompe si falla |
|---|---|---|
| Responde 200 | Petición sin seguir redirecciones | Un 301 o un 404 dentro del grupo deja una anotación apuntando a una URL que no es la final |
| Es indexable | Meta robots y cabecera X-Robots-Tag | Una versión con noindex no puede ser alternativa válida |
| Canonical propio | El rel="canonical" del head | La versión se consolida en otra |
| Anotaciones completas | Conjunto declarado igual al de la tabla | Falta autorreferencia o alguna versión |
| Retorno | Cada destino declara a su origen | Si dos páginas no se apuntan, las etiquetas se ignoran |
El primer punto es el más infravalorado: si /es-mx/tenis/ pasa a redirigir por un cambio de slug y la tabla no se actualiza, las demás versiones siguen apuntando a una URL que ya no responde 200. Qué significa cada código y cuándo conviene usarlo está en la guía de códigos de respuesta del servidor, y el criterio para elegir entre 301 y 302 en tipos de redirecciones.
No redirijas por idioma o IP
Otra trampa: mandar al usuario a su versión según Accept-Language o IP. Google recomienda evitar las redirecciones automáticas basadas en el idioma que se supone al usuario y ofrecer enlaces visibles para cambiar. Además, Googlebot suele rastrear desde IP de EE. UU. y no envía Accept-Language, de modo que las variantes que dependen de ellos pueden no rastrearse. hreflang resuelve la elección en el buscador; la web solo necesita URL distintas y enlaces entre ellas.
QA automatizado: un script que lea lo que sirve la web
Revisar a mano una URL por grupo no escala y se salta justo las URL raras. El script carga la tabla, pide cada URL única sin seguir redirecciones y compara lo que declara cada página con lo que debería declarar. La parte central:
st, body, hd = fetch(url, base)
if st != 200:
    errs.append(f'{url} responde {st} (debe ser 200)'); continue
h = Head(); h.feed(body)
if 'noindex' in h.robots or 'noindex' in (hd.get('X-Robots-Tag') or '').lower():
    errs.append(f'{url} es noindex')
if h.canonical != url:
    errs.append(f'{url} tiene canonical {h.canonical}')
esperado = dict(annotations(items))
for loc in esperado.keys() - h.alts.keys():
    errs.append(f'{url} no declara {loc}')
for loc in h.alts.keys() - esperado.keys():
    errs.append(f'{url} declara {loc} y no está en la tabla')
Después hace una pasada de reciprocidad sobre lo que realmente sirve cada página: si A declara a B y B no declara a A, lo marca. Además comprueba cada código contra la matriz del proyecto (es-ES, es-MX, en-GB y x-default). El script devuelve código de salida 1 si hay algún problema, de modo que puede bloquear un despliegue en integración continua.
Qué encontró en mi sitio de prueba
Monté un servidor local que sirve las 9 URL de la tabla con el generador y otra variante con seis fallos sembrados. Con el sitio sano, la salida fue:
9 URL revisadas, 0 problemasCon los fallos, el script leyó 8 URL (la que redirige no se analiza) y devolvió 8 avisos:
8 URL revisadas, 8 problemas
 - https://tienda-ejemplo.test/es-mx/ no declara es-MX
 - https://tienda-ejemplo.test/es-es/zapatillas/ no declara en-GB
 - https://tienda-ejemplo.test/es-es/zapatillas/ declara en-UK y no está en la tabla
 - https://tienda-ejemplo.test/es-mx/tenis/ responde 301 (debe ser 200)
 - https://tienda-ejemplo.test/en-gb/trainers/ no declara es-ES
 - https://tienda-ejemplo.test/es-es/envios/ es noindex
 - https://tienda-ejemplo.test/es-mx/envios/ tiene canonical https://tienda-ejemplo.test/es-es/envios/
 - sin retorno: https://tienda-ejemplo.test/es-es/zapatillas/ apunta a https://tienda-ejemplo.test/en-gb/trainers/ y esa página no apunta de vuelta
Un mismo fallo puede dar más de un aviso: el en-UK aparece como código fuera de la tabla y como falta de en-GB. La URL que redirige no se analiza, así que su reciprocidad queda sin comprobar hasta corregir el 301. Es un validador de laboratorio: no ejecuta JavaScript (no vería etiquetas inyectadas en el cliente) y no mira el sitemap ni la cabecera Link.
Si necesitas una revisión externa del proyecto completo, entra en un trabajo de SEO internacional.
Despliegue por fases
Publicar hreflang en todo el sitio de golpe tiene un problema: si algo falla, falla en todo. Con el generador en control de versiones, desplegar por fases es barato.
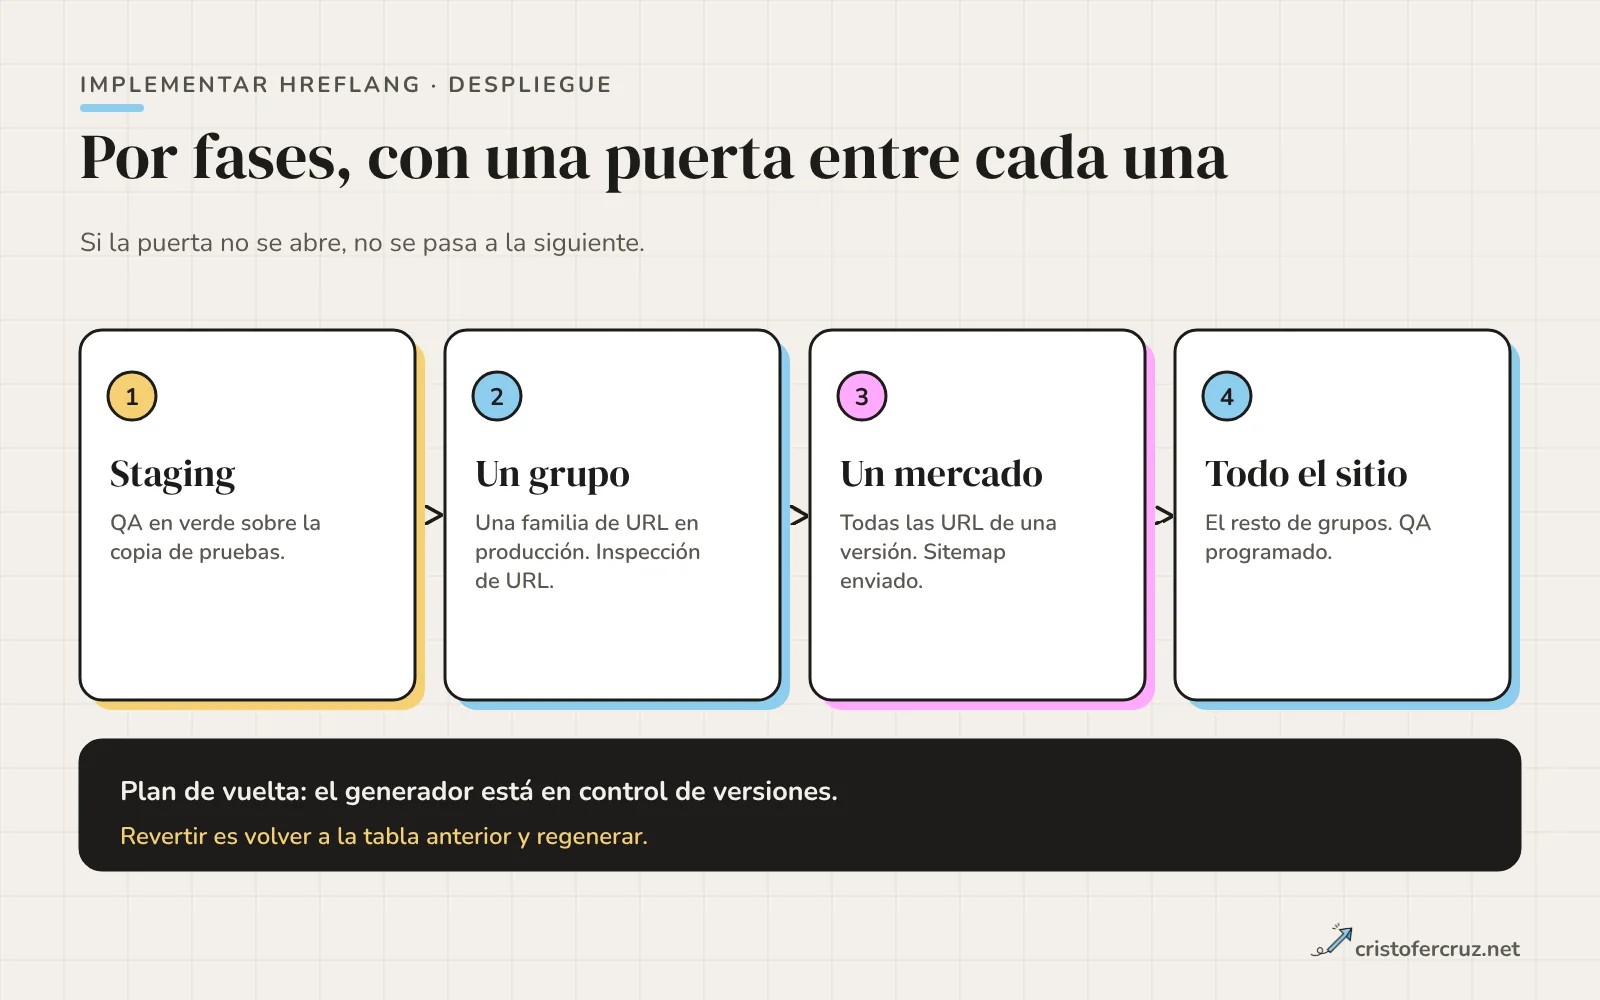
- Staging. El QA pasa con 0 problemas contra la copia de pruebas. Es la única fase donde un fallo no cuesta nada.
- Un grupo en producción. Una familia pequeña, completa y de poco riesgo. Compruebo con Inspección de URL que Google ve el HTML renderizado con las etiquetas.
- Un mercado entero. Todas las URL de una versión, con el sitemap enviado si es tu método. Aquí ya hay datos de rastreo.
- El resto. Con el QA programado de forma recurrente.
El criterio de paso es QA en verde, URL inspeccionadas sin sorpresas y, en logs, que Googlebot pide las URL del grupo sin 3xx ni 5xx. El plan de vuelta es revertir la tabla al estado anterior y regenerar. Si el sitio sirve el HTML desde caché, purga antes de dar por válida la fase, algo que conviene tener en cuenta con tu estrategia de caché.
Lo que cambia después
El mantenimiento rompe más grupos que el lanzamiento. Eventos que obligan a tocar la tabla:
| Evento | Qué actualizar |
|---|---|
| Cambia un slug en una versión | La fila de esa versión, y redirección 301 de la URL vieja |
| Se traduce una página nueva | Una fila en el grupo y regenerar todas las URL del grupo |
| Se despublica una versión | Quitar su fila; las demás dejan de apuntarle |
| Se añade un idioma o mercado | Código en la matriz, filas nuevas y revalidar todo el sitio |
| Migración de dominio o carpeta | Todas las URL de la tabla, antes del cambio |
Monitorización: qué mirar después
Google retiró el informe de segmentación internacional de Search Console. Su página de ayuda dice que el informe está obsoleto y que Google seguirá admitiendo y usando las etiquetas hreflang. No hay un sustituto específico, así que la vigilancia se monta con herramientas generales.
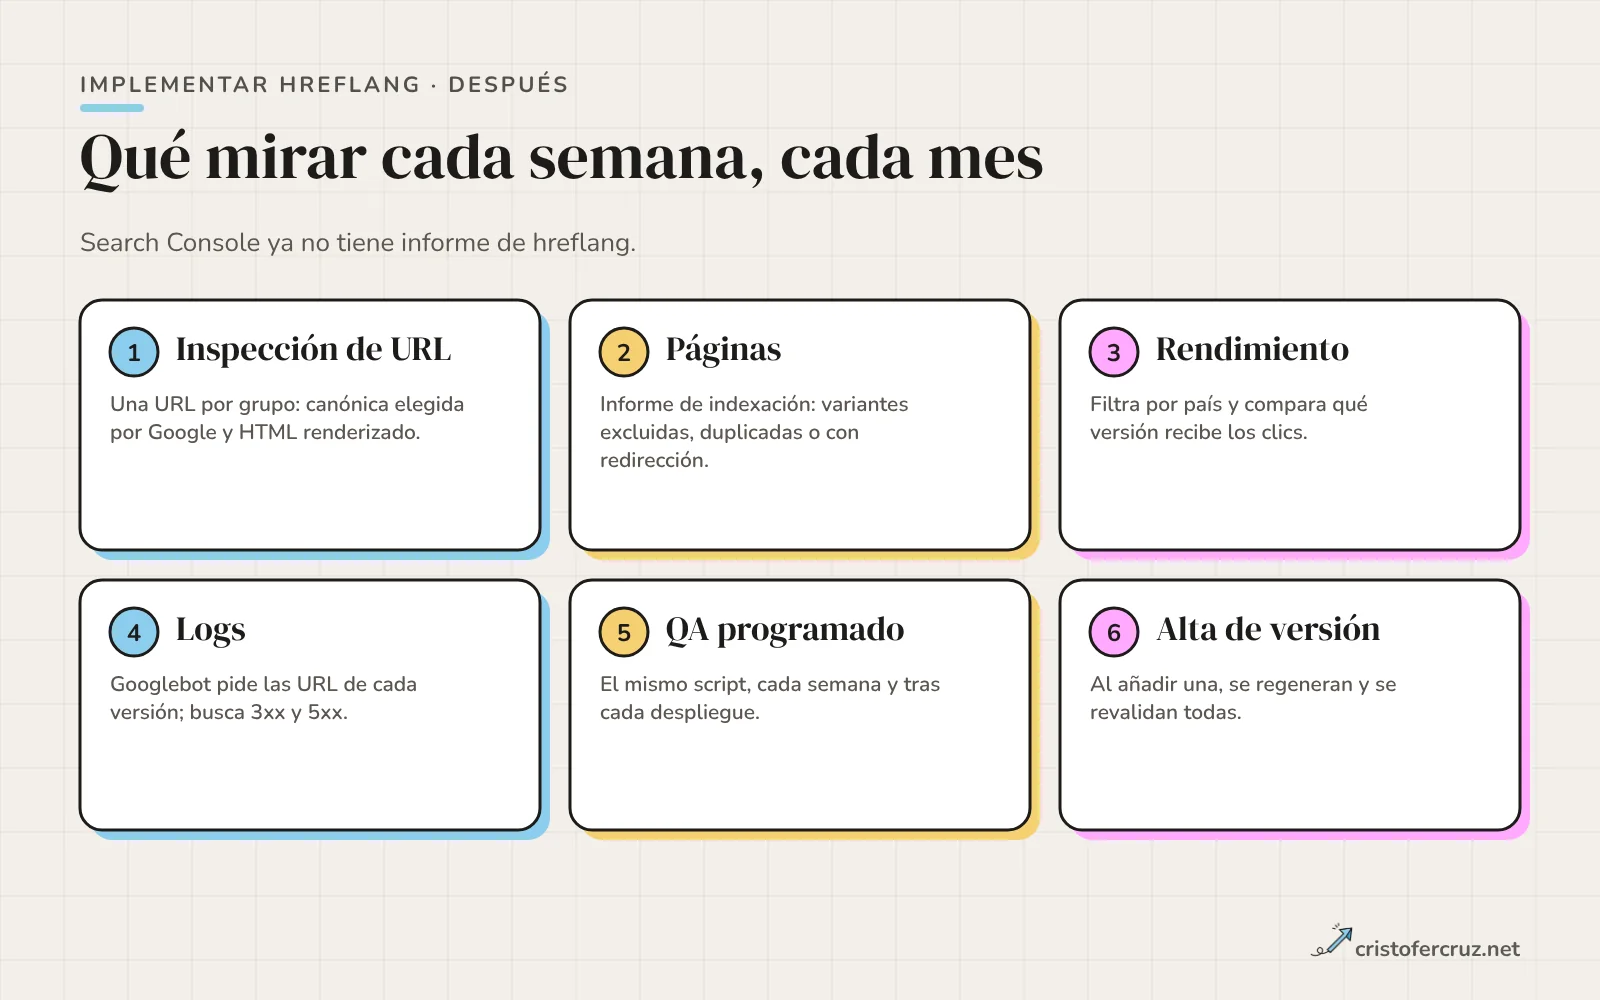
- Inspección de URL. Una URL por grupo y versión: qué canónica elige Google y cómo ve el HTML renderizado.
- Informe de páginas. Variantes excluidas, duplicadas o con redirección. Si una versión aparece como duplicada de otra, mira primero el canonical.
- Rendimiento filtrado por país. Compara qué versión recibe los clics en cada mercado. Es el síntoma que más se nota: la versión mexicana de tu tienda aparece en España.
- Logs. Qué URL de cada versión pide Googlebot y con qué código. Los 3xx y 5xx en un grupo hreflang son una señal inmediata. La guía de análisis de logs cubre cómo montarlo.
- QA recurrente. El mismo script, cada semana y tras cada despliegue.
Google no documenta plazos para que una corrección de hreflang se refleje, así que no prometas fechas. Un rastreo posterior solo confirma que la implementación está bien; el efecto lo mide el rendimiento por país a lo largo de semanas.
Cómo lo trato en mi web
Mi sitio es monolingüe y no necesita implementación multilingüe. El head emite, en includes/header.php, un hreflang="es-ES" y un x-default que apuntan los dos a la URL canónica de cada página. Son anotaciones autorreferentes: inocuas y sin efecto medible, como expliqué en la guía de hreflang.
No uso tabla de equivalencias, ni hreflang en sitemap o cabeceras, ni QA de reciprocidad: no hay con qué reciprocar. El código del artículo es de demostración sobre un sitio ficticio, no describe mi web ni proyectos de clientes. Si añado otro idioma, partiré de la tabla y el script de arriba.
Pon el QA en el mismo repositorio que el generador y haz que falle el despliegue si hay algún problema. Una validación que nadie ejecuta no protege nada.
Errores de proceso que se repiten
Los de sintaxis se detectan fácil. Estos son de proceso: escribir las etiquetas en cada plantilla en lugar de generarlas; mantener un conjunto en el HTML y otro distinto en el sitemap (Google los trata como equivalentes, pero combinarlos solo añade riesgo de contradicción); usar un redirector de idioma que impide a Googlebot ver todas las versiones; cambiar slugs sin actualizar los datos; y publicar una traducción automática sin revisar solo para cubrir un mercado. Las páginas localizadas solo son duplicadas si el contenido principal queda sin traducir, así que una traducción pobre es un problema de calidad. Y localizar no es solo traducir: si la versión mexicana usa los anglicismos de España, el problema es otro y lo explico en préstamos lingüísticos en SEO.
Si quieres que alguien revise un proyecto real con estas comprobaciones, es parte habitual de una auditoría SEO técnica.
Preguntas frecuentes sobre implementar hreflang
¿Es mejor hreflang en el HTML, en el sitemap o en la cabecera?
Para Google son equivalentes. El sitemap no engorda el HTML, el head es sencillo con pocas versiones y la cabecera es la única opción para PDF. Elige una, con una sola fuente de datos detrás.
¿Hay que poner x-default en todos los grupos?
No. Google lo describe como el valor para cuando ninguna otra versión coincide con el navegador del usuario. Si un grupo no tiene URL de reserva, omítelo en ese grupo.
¿Cuántas versiones puede tener un grupo?
Google no documenta un máximo en la guía de versiones localizadas. El límite práctico es el tamaño: en un sitemap grande, el tope de 50 MB sin comprimir llega antes que el de 50.000 URL.
¿Qué hago con las páginas que solo existen en un idioma?
Déjalas fuera de cualquier grupo o en un grupo de una sola versión. No inventes una URL de otro idioma para rellenar.
¿Cuánto tarda Google en aplicar los cambios?
No está documentado. Depende de cuándo vuelva a rastrear las URL del grupo, y no hay forma de fijarlo.
¿Puedo validar hreflang solo con Search Console?
No hay un informe específico desde que se retiró el de segmentación internacional. Reciprocidad y códigos se comprueban con un rastreo o con un script propio como el de este artículo.
¿Sirve hreflang entre dominios distintos?
Sí. Google indica que las URL alternativas no tienen que estar en el mismo dominio. Si usas sitemap, recuerda que un sitemap solo puede contener URL descendientes del directorio donde se aloja.
Referencias
- Tell Google about localized versions of your page Google Search Central
- Managing multi-regional and multilingual sites Google Search Central
- How Google crawls locale-adaptive pages Google Search Central
- What is URL canonicalization Google Search Central
- The International Targeting report is deprecated Ayuda de Search Console
- Sitemaps XML format sitemaps.org
- wp_head (action hook) WordPress Developer Resources
- How to implement hreflang tags in WordPress InspectWP