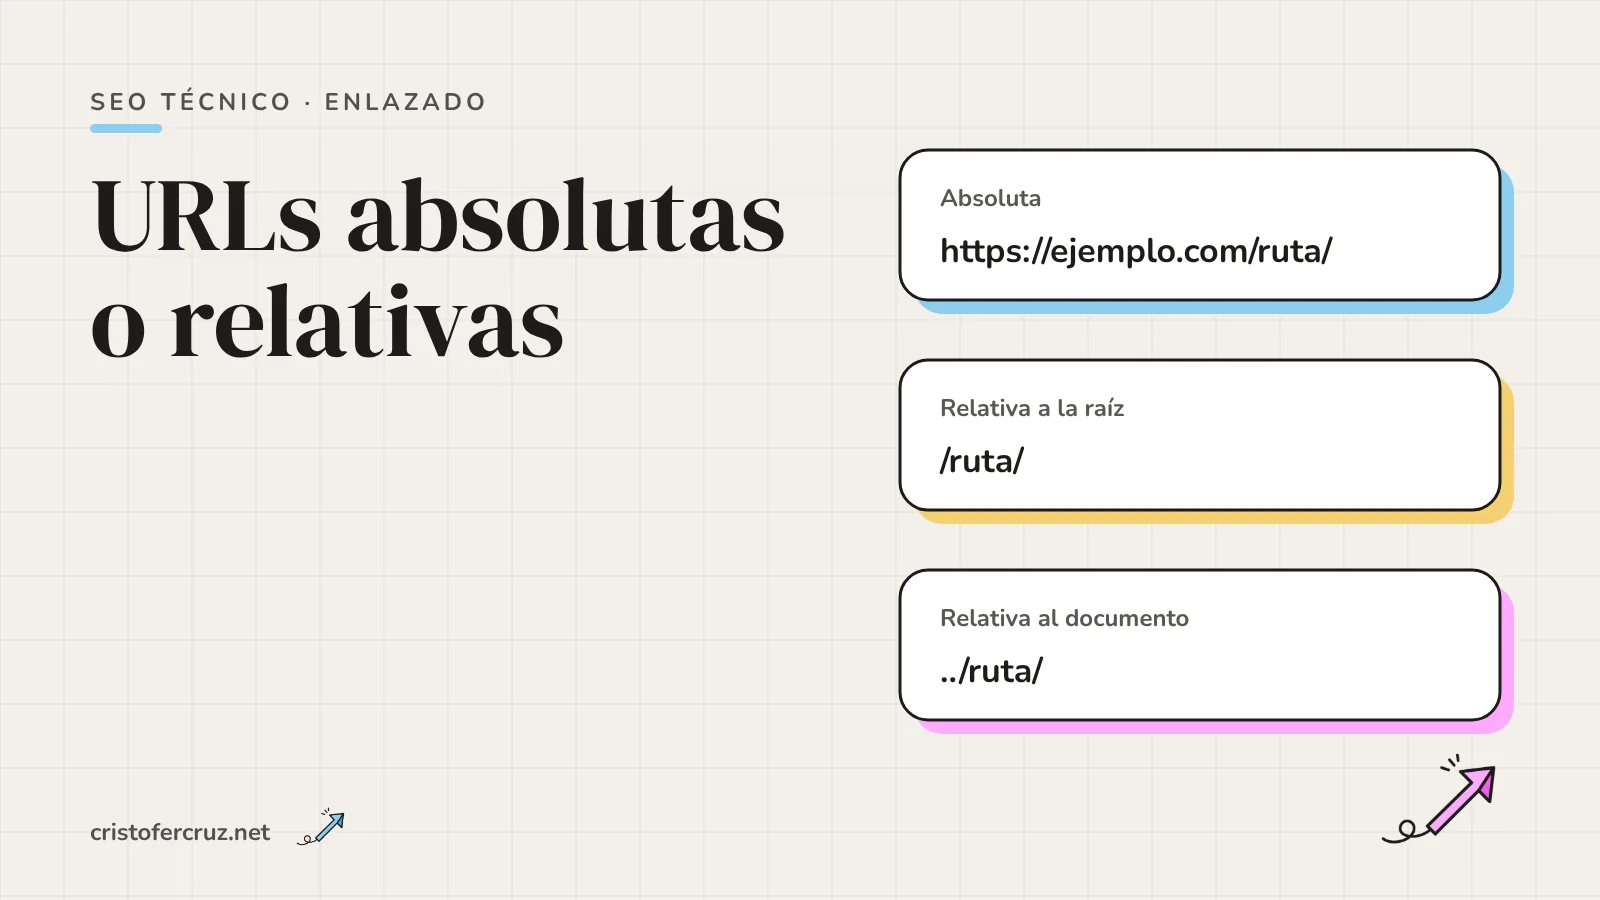
- Hay tres formas de escribir un enlace (absoluta, relativa a la raíz y relativa al documento) y el navegador las convierte siempre a una URL absoluta antes de pedirla.
- Google acepta enlaces internos con cualquiera de las tres, pero para
rel="canonical"recomienda absoluta, y exige URLs completas en hreflang y en sitemaps. - La relativa al documento es la que rompe cosas: cambia de destino según la barra final y puede generar bucles de URLs infinitas.
- La etiqueta
<base>altera la resolución de todos los enlaces relativos, incluidas las anclas#, pero no la de Open Graph. - Mi criterio: relativa a la raíz en el enlazado interno y absoluta en todo lo que lee otro sistema (canonical, hreflang, sitemap, og:url, og:image).
- En mi web, todos los enlaces internos de las páginas de los sitemaps son relativos a la raíz salvo uno. Tenía 349 absolutos y los he corregido; las absolutas que quedan son señales técnicas.
El error que se ve en migraciones y entornos de pruebas no suele ser elegir mal entre absoluta y relativa: es tener las dos mezcladas sin saberlo. Un staging cuyos enlaces del pie apuntan a producción, un canonical relativo que se resuelve contra el dominio equivocado o una imagen que carga en /guia/ y da 404 en /guia salen todos del mismo sitio.
Aquí explico cómo resuelve cada tipo de URL el navegador (con pruebas que he ejecutado), qué dice la documentación de Google y de otros estándares sobre cada pieza, dónde conviene la URL completa, qué hace <base> y cómo lo tengo yo, con el recuento real de mi código. La parte de caracteres, codificación y mayúsculas la trato en el artículo sobre la sintaxis de las URLs.
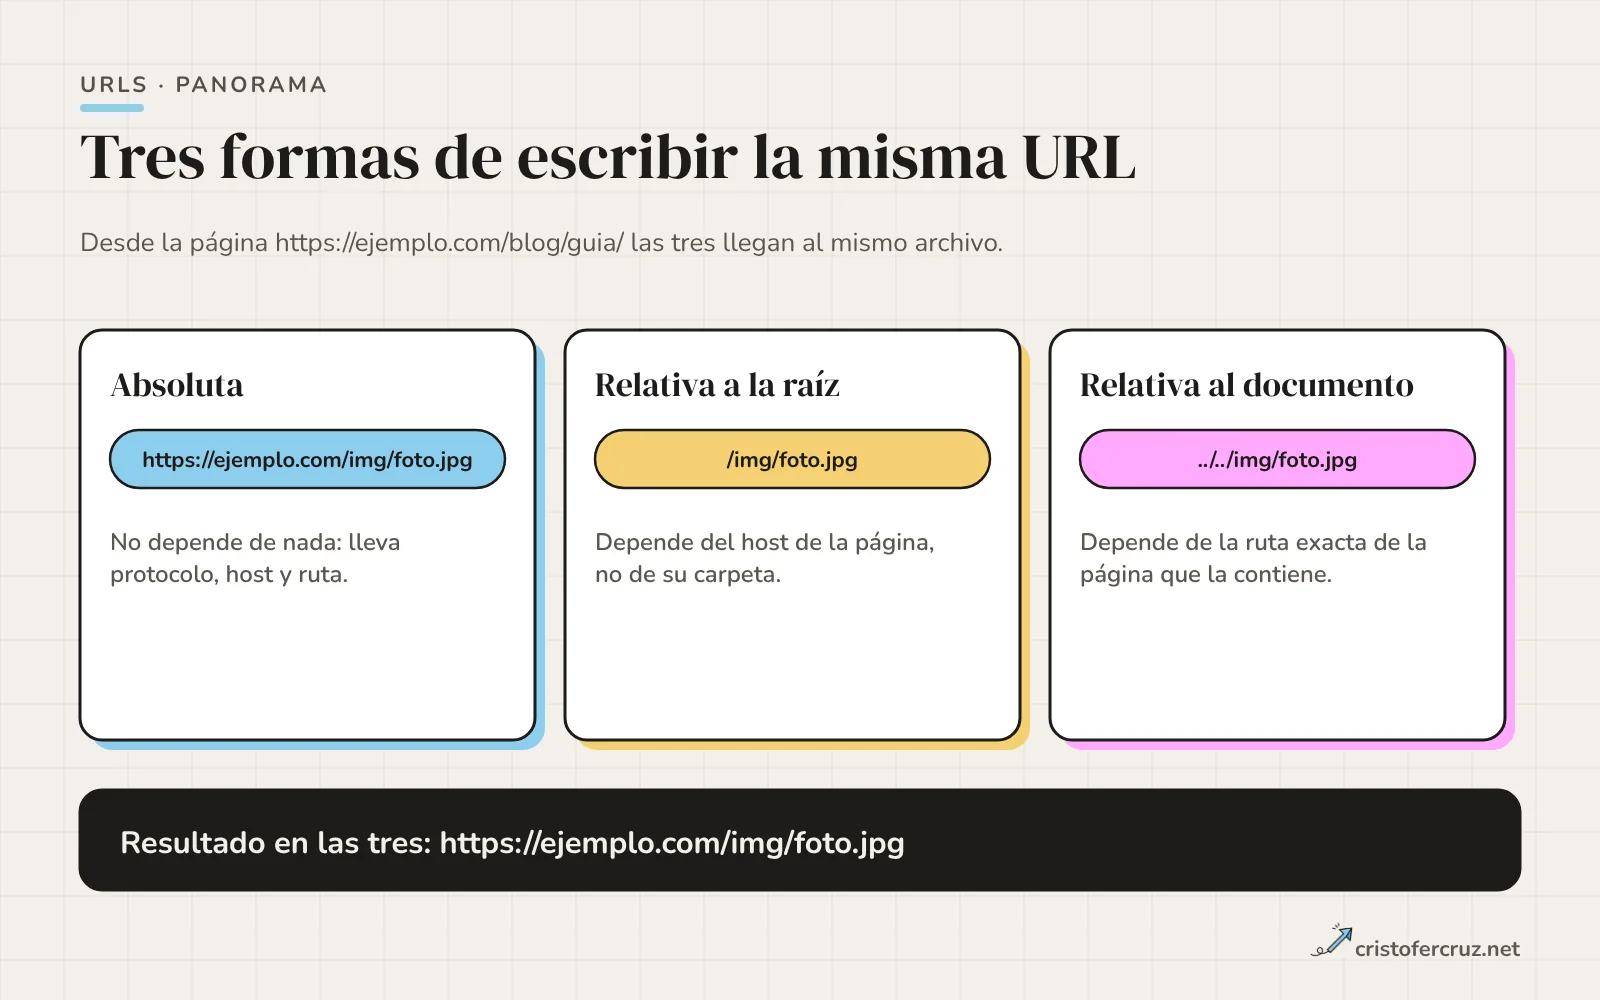
https://ejemplo.com/blog/guia/, las tres terminan en el mismo archivo.Tres formas de escribir la misma URL
Una referencia en un href o un src puede escribirse de tres maneras, y una cuarta que conviene conocer para no usarla.
| Tipo | Ejemplo | De qué depende |
|---|---|---|
| Absoluta | https://ejemplo.com/img/foto.jpg | De nada: lleva esquema, host y ruta. |
| Relativa a la raíz | /img/foto.jpg | Del esquema y el host de la página que la contiene. |
| Relativa al documento | ../img/foto.jpg o foto.jpg | De la ruta exacta de la página, incluida la barra final. |
| Relativa al protocolo | //cdn.ejemplo.com/foto.jpg | Solo del esquema. Es un resto de la época de http y https mezclados. |
Lo que sigue se centra en las tres primeras. La relativa al protocolo no tiene hoy ninguna ventaja: si todo es https, escribe https://. En mi web no hay ninguna (lo compruebo más abajo).
Cómo se resuelve una referencia
Ningún navegador ni rastreador trabaja con la referencia tal cual: la convierte en una URL absoluta combinándola con una URL base. El RFC 3986 (sección 5.1) establece de dónde sale esa base, por orden de prioridad: una base incrustada en el contenido, la de la entidad que lo envuelve, la URL con la que se recuperó el documento (la última, si hubo redirecciones) y, por último, una por defecto. En HTML, la primera es la etiqueta <base>, y casi siempre no existe, así que la base es la URL de la propia página.
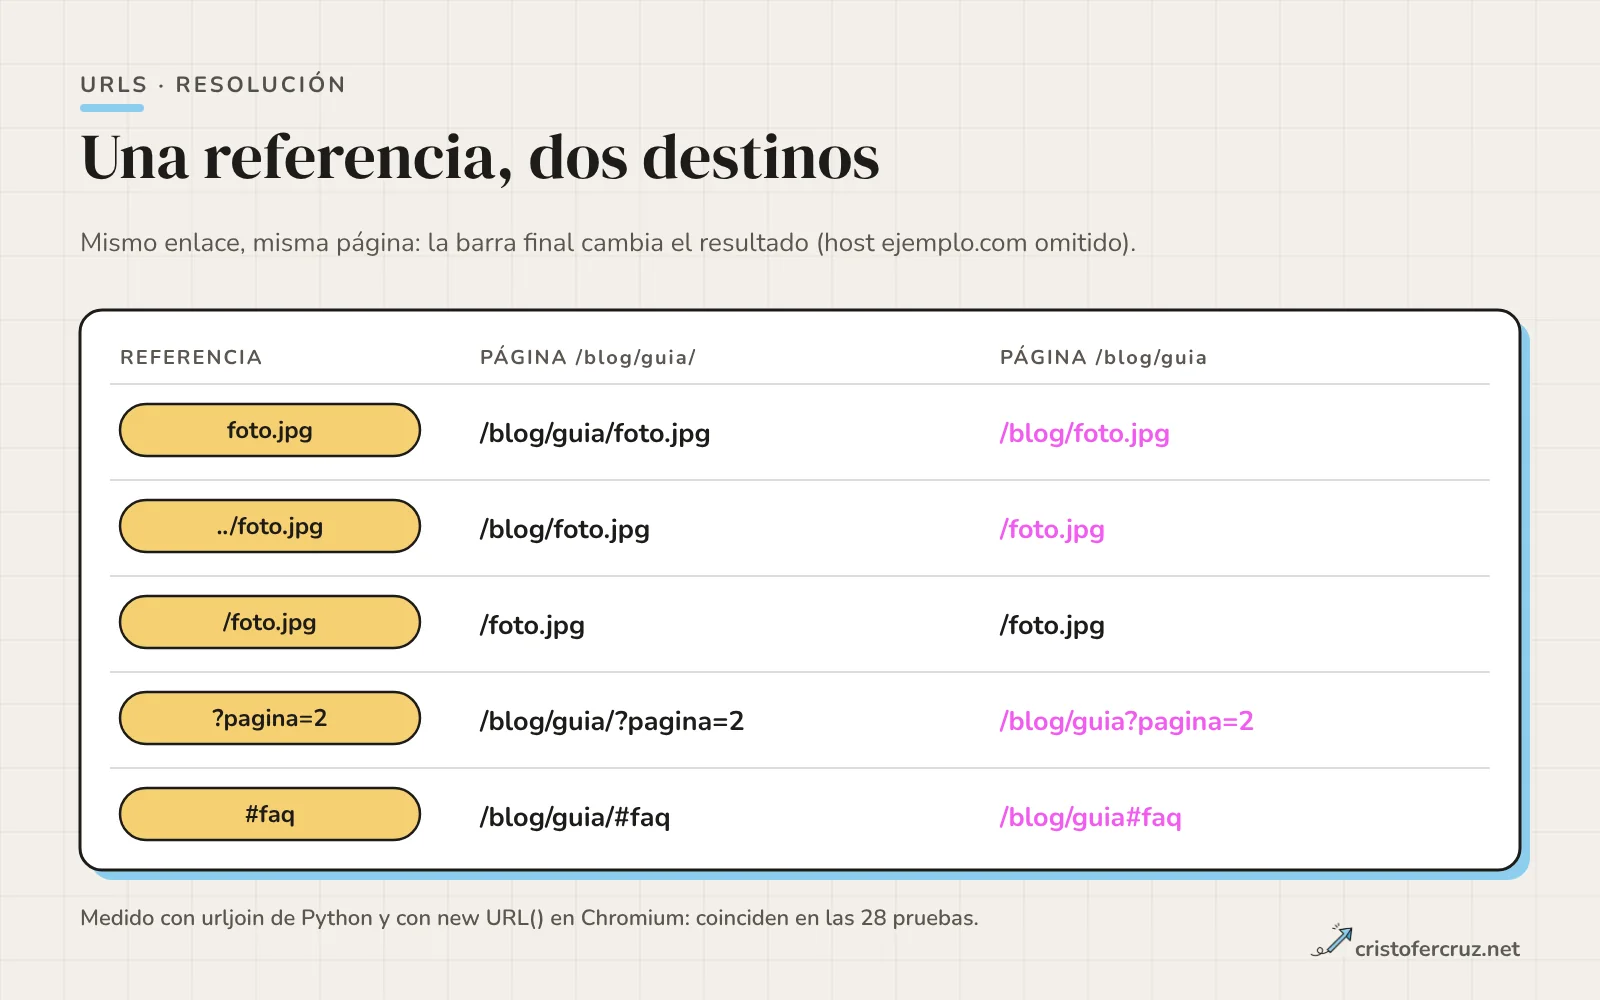
La mejor forma de entenderlo es ejecutarlo. Este script usa urljoin de Python con la misma página escrita con y sin barra final:
from urllib.parse import urljoin
for base in ("https://ejemplo.com/blog/guia/", "https://ejemplo.com/blog/guia"):
    for ref in ("foto.jpg", "../foto.jpg", "/foto.jpg", "?pagina=2", "#faq"):
print(f"{base:32} {ref:12} -> {urljoin(base, ref)}")| Referencia | Página /blog/guia/ | Página /blog/guia |
|---|---|---|
foto.jpg | /blog/guia/foto.jpg | /blog/foto.jpg |
../foto.jpg | /blog/foto.jpg | /foto.jpg |
/foto.jpg | /foto.jpg | /foto.jpg |
?pagina=2 | /blog/guia/?pagina=2 | /blog/guia?pagina=2 |
#faq | /blog/guia/#faq | /blog/guia#faq |
Solo la relativa a la raíz da el mismo resultado en las dos. Las demás heredan la barra final, o su ausencia, de la página que las contiene. El algoritmo es el mismo que describe el RFC: se quita el último segmento de la ruta base y se añade la referencia.
Comprobé que no es una peculiaridad de Python. Ejecuté 28 combinaciones (14 referencias contra las dos páginas) con urljoin y con new URL(ref, base) en Chromium, y el resultado fue idéntico en todas. También pasé los 21 ejemplos normales de la sección 5.4 del RFC 3986: urljoin coincide en los 21 y Chromium en 20; la excepción es //g, que el RFC deja en http://g y Chromium devuelve como http://g/ (el estándar WHATWG añade la barra raíz). Para un enlace con ruta, no hay diferencia práctica.
/foto.jpg no depende de la barra final.Relativas al documento: barra final y bucles
El caso que más cuesta detectar es el de la imagen o el enlace relativo al documento en una página accesible con y sin barra final. Lo reproduje con un servidor PHP de pruebas que devuelve la misma página en /guia/ y en /guia, con <img src="foto.png">. En Chromium, la primera pidió /guia/foto.png (200). La segunda pidió /foto.png (404 en mi prueba, porque el archivo solo existía bajo /guia/). El HTML es idéntico; la URL de la página decide el resultado.
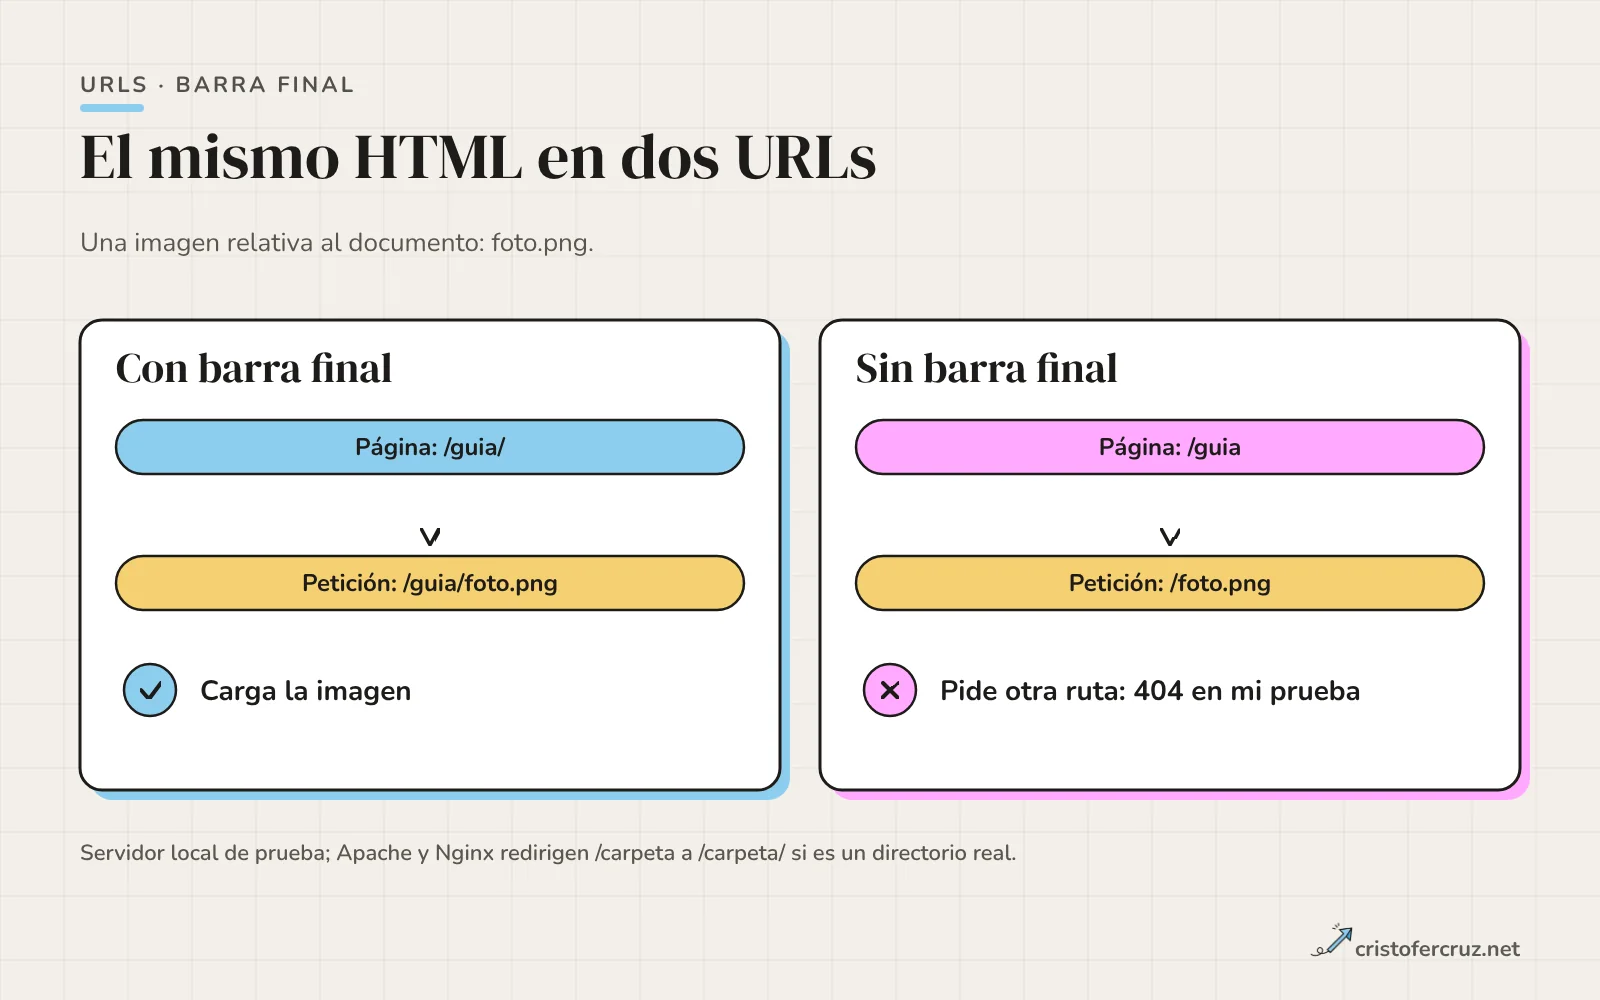
En un servidor bien configurado esto casi no pasa, porque redirige /carpeta a /carpeta/ cuando es un directorio real. Lo probé con Apache 2.4 y Nginx en local: ambos respondieron 301 a /carpeta/. Pero eso solo protege a los directorios. Las rutas que genera un CMS o un router no tienen directorio detrás, y ahí la protección no existe. Sobre cuándo /guia y /guia/ son URLs distintas para Google, lo explico en el artículo de sintaxis.
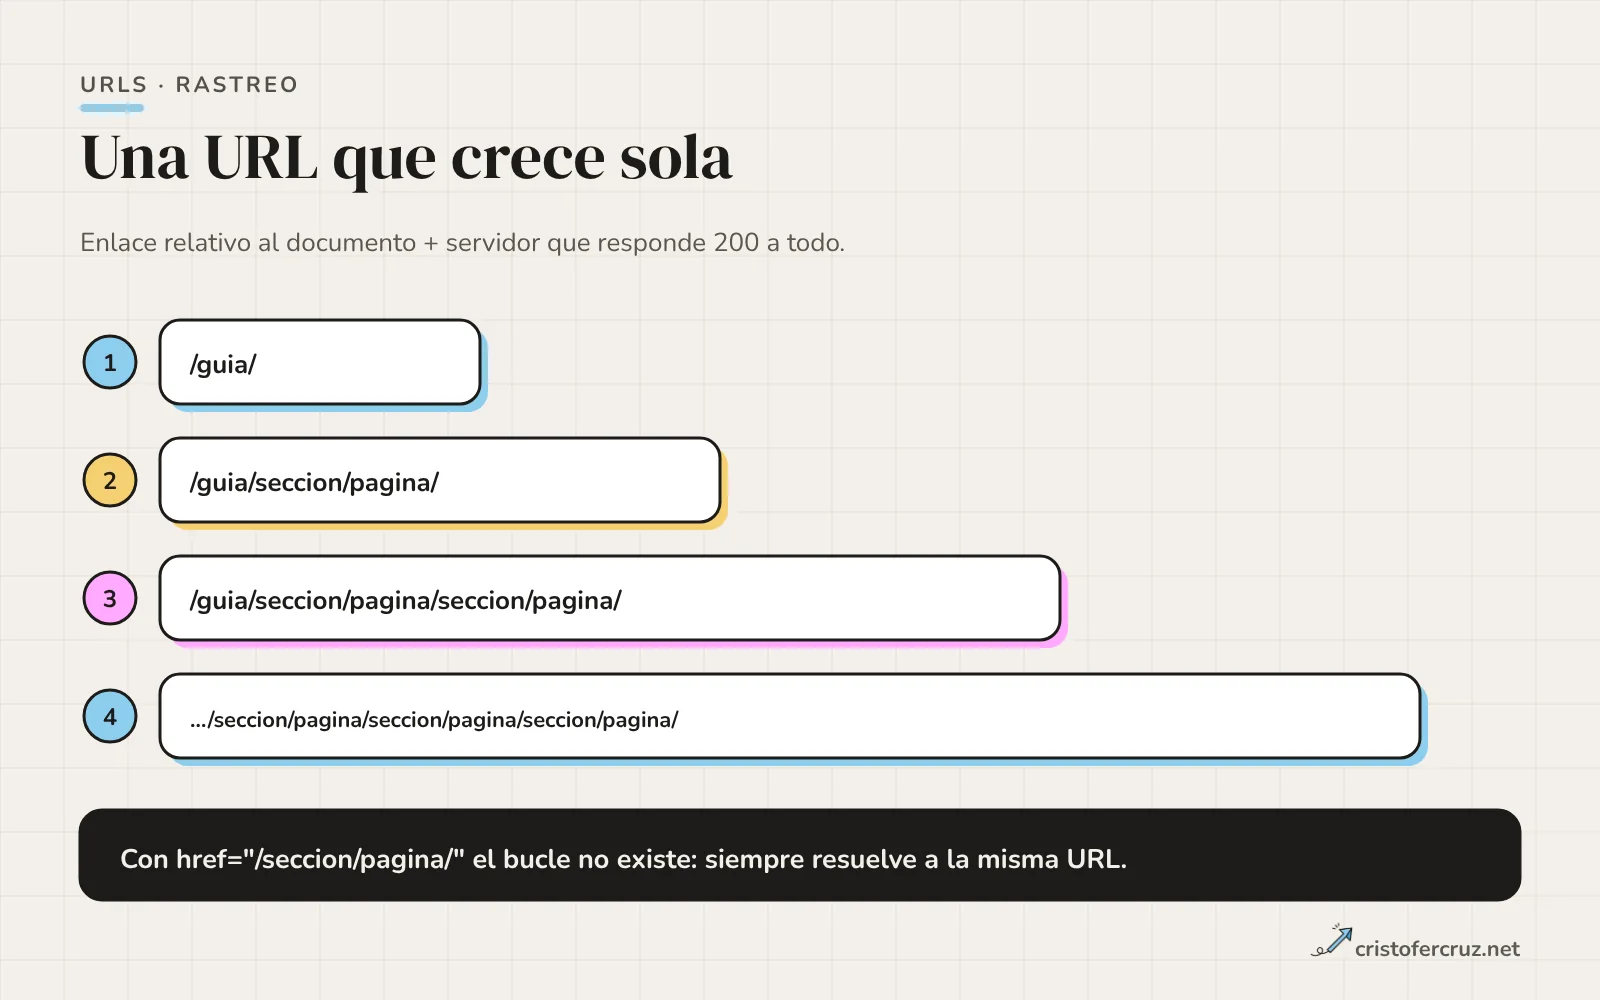
El segundo problema es el que Google documenta en su guía de estructura de URLs, en el apartado de enlaces relativos rotos: un enlace relativo al padre, como ../../category/stuff, puesto en la página equivocada puede producir URLs inventadas como https://example.com/category/community/category/stuff, y se convierte en un espacio infinito de URLs si el servidor no devuelve el estado correcto para las que no existen. Su recomendación es usar URLs relativas a la raíz en lugar de relativas al padre.
Reproduje el mecanismo con un servidor que responde 200 a cualquier ruta bajo /espiral/ y una página con <a href="seccion/pagina/">. Un rastreador sencillo que sigue ese enlace obtuvo, en cinco pasos, /espiral/, /espiral/seccion/pagina/, /espiral/seccion/pagina/seccion/pagina/ y así sucesivamente, una URL más larga cada vez. Con href="/seccion/pagina/", el rastreador se quedó en la misma URL. Es mi demostración; no afirmo que Googlebot caiga en ese bucle sin límite, solo que la URL que descubre es distinta cada vez.
Qué dice Google sobre los enlaces
La documentación de enlaces rastreables de Search Central da como válidos los dos formatos. Entre sus ejemplos recomendados aparecen <a href="https://example.com/stuff"> y también <a href="/products/category/shoes"> y <a href="./products/category/shoes">. La única condición que impone es que la URL del href se resuelva en una dirección web real. No dice que una forma posicione mejor que otra.
Esto desmonta lo que se repite en muchos artículos del tema: que las absolutas ayudan al rastreo o al crawl budget. Un texto del propio sector que revisé lo plantea como argumento («posiblemente más fácil de seguir, ya que las relativas se convierten antes en absolutas»), pero lo hace sin citar documentación de Google y con una redacción hedgeada; el artículo es de 2008 y se actualizó por última vez en 2016. Otro, de seo.com, recomienda absolutas con el argumento del crawl budget, pero su propia tesis es que lo que resuelve el problema es redirigir a una única versión del sitio. Estoy de acuerdo con esa segunda parte, y la explico en el artículo sobre versiones con y sin www y http.
Ninguno de los dos habla de canonical, hreflang ni de <base>, y ahí es donde el formato sí importa.
Dónde se exige la URL absoluta
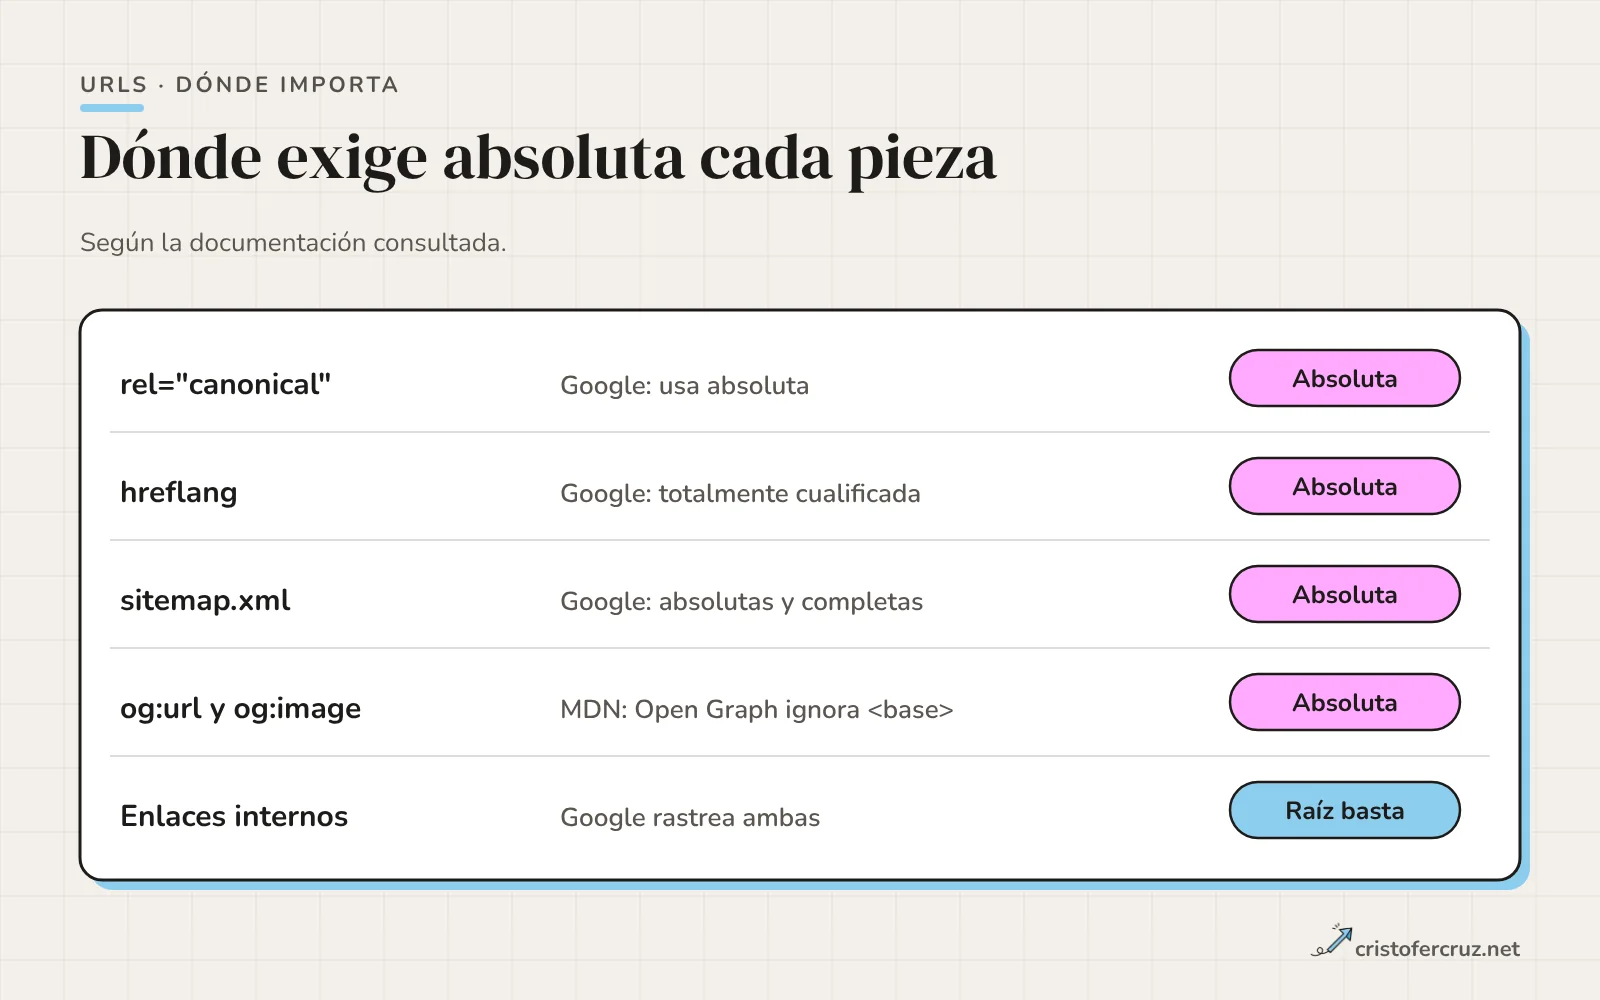
La regla que aplico: en el enlazado dentro del HTML, la relativa a la raíz es suficiente; en cualquier señal que lee otro sistema fuera de ese contexto, URL completa. Esto es lo que dice, o no dice, la documentación de cada pieza.
| Pieza | Qué dice la fuente | Qué hago |
|---|---|---|
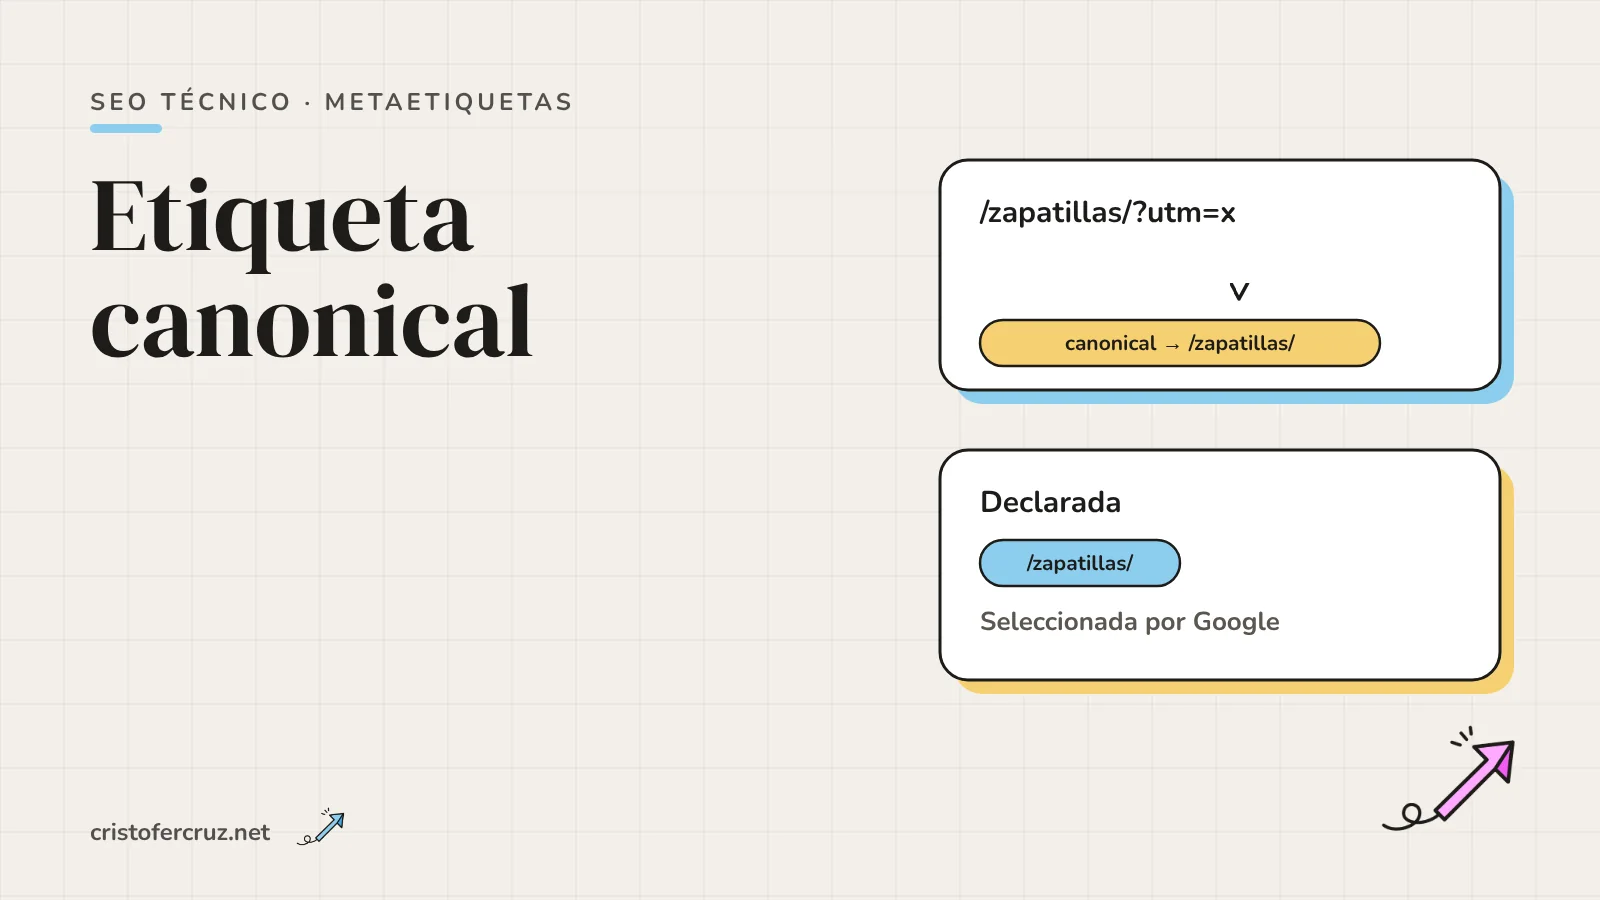
rel="canonical" | Google: «Use absolute paths rather than relative paths». Las relativas están soportadas, pero «can cause problems in the long run» y no las recomienda. | Absoluta |
| hreflang | Google: las URLs alternativas «must be fully-qualified, including the transport method», con ejemplo correcto https://example.com/foo y no //example.com/foo ni /foo. | Absoluta |
| Sitemap XML | Google: «Use fully-qualified, absolute URLs»; no usar /mypage.html. | Absoluta |
og:url y og:image | MDN: las etiquetas Open Graph no reconocen <base> y «should always have full absolute URLs». La especificación en ogp.me no formula la regla, aunque todos sus ejemplos son absolutos. | Absoluta |
| Datos estructurados | Google exige que las URLs de imagen sean rastreables e indexables; no dice que deban ser absolutas. Sus ejemplos usan URLs completas. | Absoluta, por prudencia |
Cabecera Link | El RFC 8288 permite referencias relativas y obliga a resolverlas según el RFC 3986; una base dentro del cuerpo no se aplica. Para hreflang en cabecera HTTP, Google pide la URL completa. | Absoluta |
| RSS | No lo he verificado en la especificación. Mi web no publica RSS (blog/feed.php es un JSON interno del listado). | No aplica |
Hay un matiz importante: en canonical, Google dice que las relativas están soportadas y en hreflang y sitemaps pide URLs completas y pone /foo como ejemplo de lo que no hay que escribir. No lo he puesto a prueba en Search Console con una relativa, así que no puedo decirte qué pasa en la práctica con un hreflang relativo; la guía lo prohíbe y con eso me basta para no probarlo en producción. Los detalles de cada anotación están en los artículos de la etiqueta canonical, de las anotaciones hreflang y de los sitemaps XML.
La etiqueta base y sus trampas
<base href> cambia la URL contra la que se resuelven todas las referencias relativas del documento. Según MDN, solo se respeta el primer <base> con href, y debe ir antes de cualquier otro elemento con atributos que sean URLs, como un <link>. Su href puede ser absoluto o relativo.
Las trampas son tres. La primera: afecta también a las anclas. MDN lo documenta así: un <a href="#id"> se resuelve contra la base y provoca una petición a esa URL con el fragmento añadido. La segunda: no afecta a Open Graph. La tercera: si alguien la añade por un plugin o una plantilla heredada, cada enlace relativo cambia de destino sin que nada falle en el HTML.
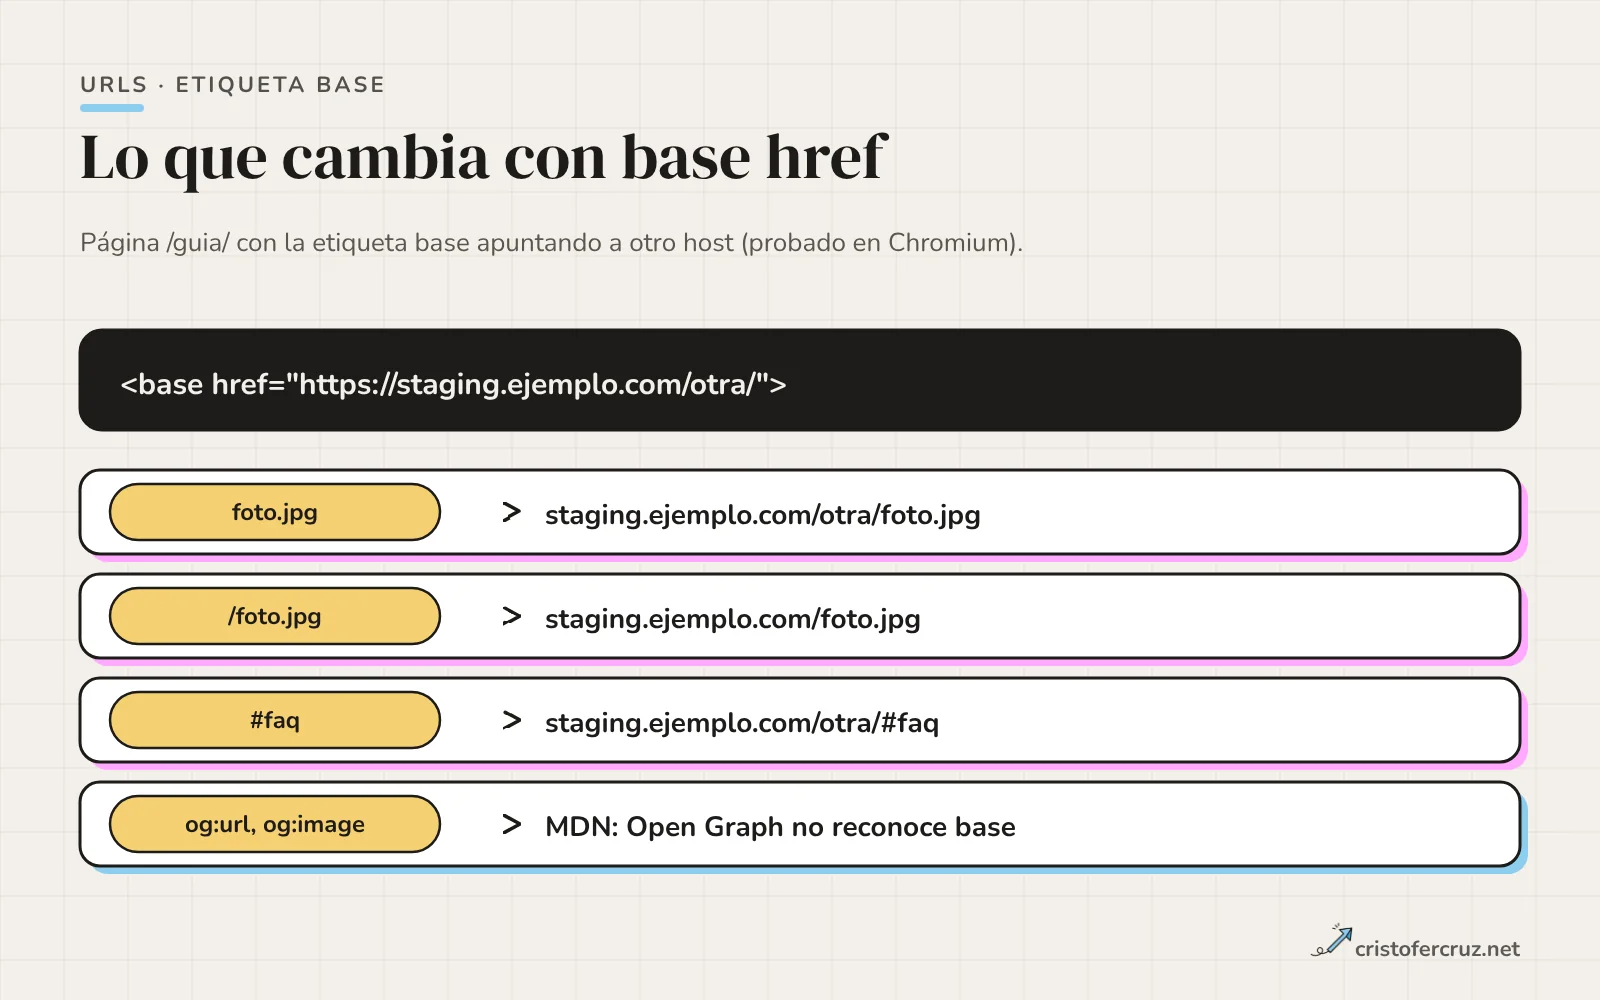
Lo probé en Chromium con una página /base/ que declara <base href="https://staging.ejemplo.com/otra/">:
| En el HTML | Destino que resolvió Chromium |
|---|---|
href="foto.jpg" | https://staging.ejemplo.com/otra/foto.jpg |
href="/foto.jpg" | https://staging.ejemplo.com/foto.jpg |
href="#faq" | https://staging.ejemplo.com/otra/#faq |
canonical absoluta y og:image relativa | El canonical sigue siendo el absoluto; el content de og:image queda como /img/x.jpg, sin resolver. |
Hasta una ruta que empieza por / cambia de host. Que la relativa a la raíz sea segura depende de que no haya <base>. Qué hace Googlebot con una base cuando extrae enlaces no lo he encontrado documentado y no lo he comprobado; mi criterio es no usarla.
<base href>, probado en Chromium.Enlazado interno: ventajas e inconvenientes de cada formato
Para los enlaces entre páginas de tu propio sitio, el criterio es operativo, no de posicionamiento, y se decide una vez al diseñar la arquitectura de la web. Esta es la comparación que uso al decidir una plantilla o revisar un enlazado interno heredado.
| Absoluta | Relativa a la raíz | Relativa al documento | |
|---|---|---|---|
| Portabilidad entre dominios y staging | Mala: hay que reemplazar el dominio en todo el contenido. | Buena | Buena |
| Riesgo de que staging enlace a producción | Alto | Bajo | Bajo |
| Independencia de la ruta de la página | Total | Total (dentro del host) | Ninguna |
| Sensible a la barra final | No | No | Sí |
| Copiar un bloque entre plantillas | Seguro | Seguro | Se rompe según la profundidad |
| Ante una web copiada por un scraper | Los enlaces apuntan a tu dominio hasta que los reescriban | Apuntan al dominio del copiador | Igual que raíz |
| Ante un cambio de dominio | Hay que reescribirlas | Siguen valiendo | Siguen valiendo |
La fila del scraper es un argumento que circula en la bibliografía del sector (lo plantean tanto Search Engine Journal como seo.com), y no lo he medido. Tómalo como una ventaja secundaria: un copiador puede reescribir los enlaces y casi siempre lo hace. Lo que sí es seguro es la consecuencia en un cambio de dominio: cada absoluta incrustada en el contenido sigue apuntando al dominio viejo hasta que la reescribes.
La relativa a la raíz resuelve la portabilidad sin perder independencia de la ruta. La relativa al documento solo me parece justificable en archivos que viajan juntos (un HTML descargable con sus recursos en la misma carpeta) y no en un sitio con plantillas y URLs limpias. Un enlace con dominio completo dentro de la propia web añade peso y riesgo, y no mejora nada que Google haya documentado.
Un detalle con https: MDN recomienda, para evitar contenido mixto, que las referencias a recursos propios sean relativas o https. Una referencia relativa hereda el esquema de la página, de modo que no puede quedarse en http:// por accidente. Una absoluta con http:// heredada de una migración sí puede, y los scripts y hojas de estilo así cargados se bloquean; según esa misma página, las imágenes <img src> se actualizan a https, pero no las que usan srcset o <picture>.
Migraciones y entornos de pruebas
El momento en que el formato de las URLs cuesta dinero es una migración. Las absolutas escritas a mano en contenidos, plantillas y ajustes del CMS son las que sobreviven al cambio de dominio, y cada una añade un salto de redirección. Antes de la salida busco el dominio antiguo en la base de datos y en las plantillas; después, rastreo la web nueva y cuento los enlaces internos que responden 301. En una migración SEO forma parte del mapa de trabajo, junto a las redirecciones 301.
En staging el riesgo es el inverso: las señales absolutas (canonical, og:url, sitemap) apuntan al dominio de producción si alguien las copió con el contenido. Si un staging indexable lleva canonical a producción, Google tiene una pista de cuál es la versión buena, pero no lo cuento como protección: un staging no debería poder indexarse por otra vía (autenticación, por ejemplo). El script de auditoría de más abajo, ejecutado contra la copia de pruebas, lista los enlaces que salen hacia el dominio real.
Antes de cambiar nada en una migración, genera las señales (canonical, hreflang, sitemap, og) desde una única constante de dominio, como hago yo con SITE_URL. Cambiar el dominio pasa a ser una línea, no un buscar y reemplazar sobre miles de páginas.
Cómo lo tengo en mi web
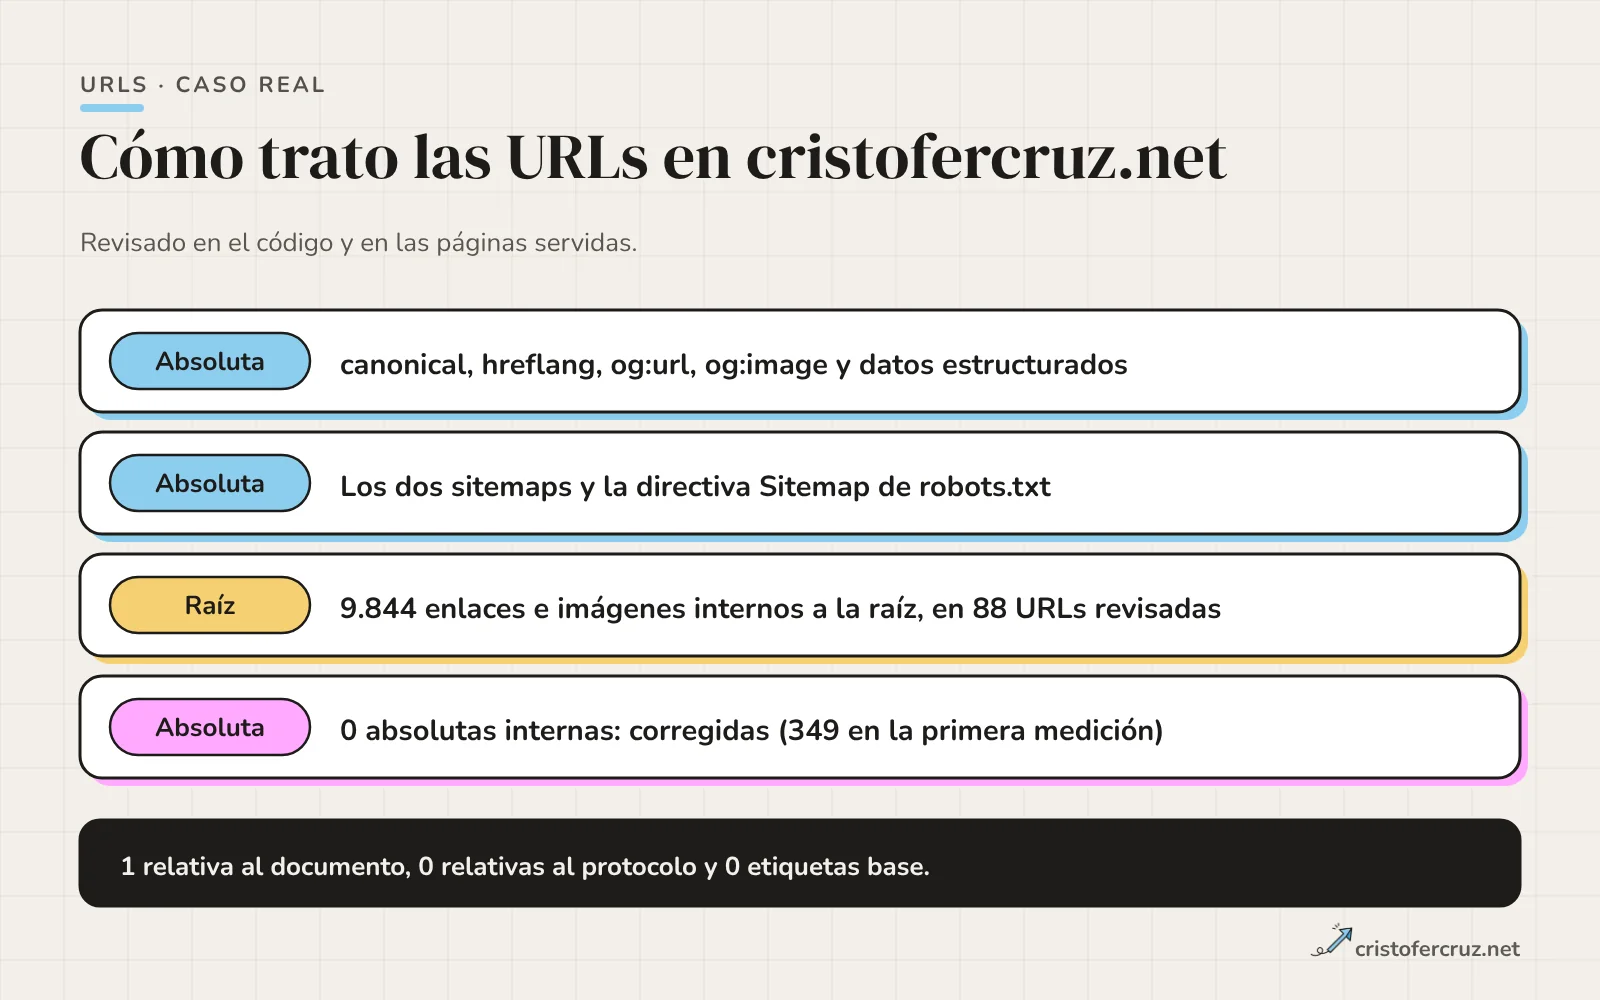
En el código de cristofercruz.net hay dos helpers y una constante. En includes/config.php, SITE_URL vale https://cristofercruz.net, BASE_PATH está vacío y url('ruta/') devuelve /ruta/, es decir, una URL relativa a la raíz. asset() hace lo mismo con los archivos con hash.
Las señales las construyen concatenando SITE_URL con ese helper. En includes/header.php, el canonical, el og:url y los dos hreflang (es-ES y x-default, autorreferenciales) son absolutos; og:image y twitter:image también, por SITE_URL . asset(...). Los datos estructurados (article-page.php y los esquemas de servicios) llevan también URLs completas, y los dos sitemaps (sitemap.xml y blog/sitemap.php) las escriben con https://cristofercruz.net delante. La directiva Sitemap: de robots.txt también.
Para medir el enlazado ejecuté el script de la sección siguiente contra las 88 URLs de los dos sitemaps, servidas desde mi copia local. Cuenta enlaces <a href> e imágenes <img src> del HTML ya renderizado:
| Tipo | Cantidad |
|---|---|
| Relativas a la raíz | 9.844 |
| Absolutas al propio dominio | 0 |
| Relativas al documento | 1 |
Relativas al protocolo (//) | 0 |
Etiquetas <base> | 0 |
La primera vez que lo medí eran 349 absolutos, el 4 % de los enlaces internos. Salían de los dos enlaces legales del pie (https://cristofercruz.net/aviso-legal/ y /politica-de-privacidad/, en includes/footer.php), de las URLs de los casos de éxito, que venían de includes/cases-data.php con el dominio completo, y de algunas páginas más. No era un criterio, sino una inconsistencia heredada, y lo primero que habría corregido antes de clonar la web a otro dominio. Lo corregí en dos pasos. Primero, cases-data.php, footer.php, city-page.php y contact-form.php, con lo que quedaron 49. Después, los enlaces escritos a mano en la home (reseñas incluidas), las 12 landings de servicio, las páginas de casos, las herramientas, contacto, la política de cookies y el enlace de privacidad de send.php. Repetí la medición después de cada paso.
Ahora hay 0 absolutas al propio dominio en los <a href> y <img src> de las 88 URLs de los sitemaps; todos los enlaces internos salvo uno son relativos a la raíz. Siguen existiendo URLs completas, y es lo que debe ser: el canonical, el og:url, los hreflang y el og:image salen de SITE_URL; los @id y url del JSON-LD llevan dominio; los sitemaps y robots.txt también; y el HTML del correo de confirmación de send.php es absoluto porque se abre fuera de mi web.
La relativa al documento es el enlace de descarga radar-local.html de la herramienta de geogrid, que está en una página con barra final (/herramientas/geogrid-seo-local/) y resuelve a un archivo que existe. Sirve, pero rompería con otra URL de la página; lo cambiaré por la ruta desde la raíz. En los 46 content.html de los demás artículos del blog hay 1.254 enlaces e imágenes internos, todos relativos a la raíz, ninguno absoluto al propio dominio.
Los recuentos salen de mi copia local, no del dominio publicado, y cambian cada vez que añado un artículo: de las 79 URLs de la primera medición pasé a 88 sin tocar el criterio.
Cómo auditar el formato de las URLs
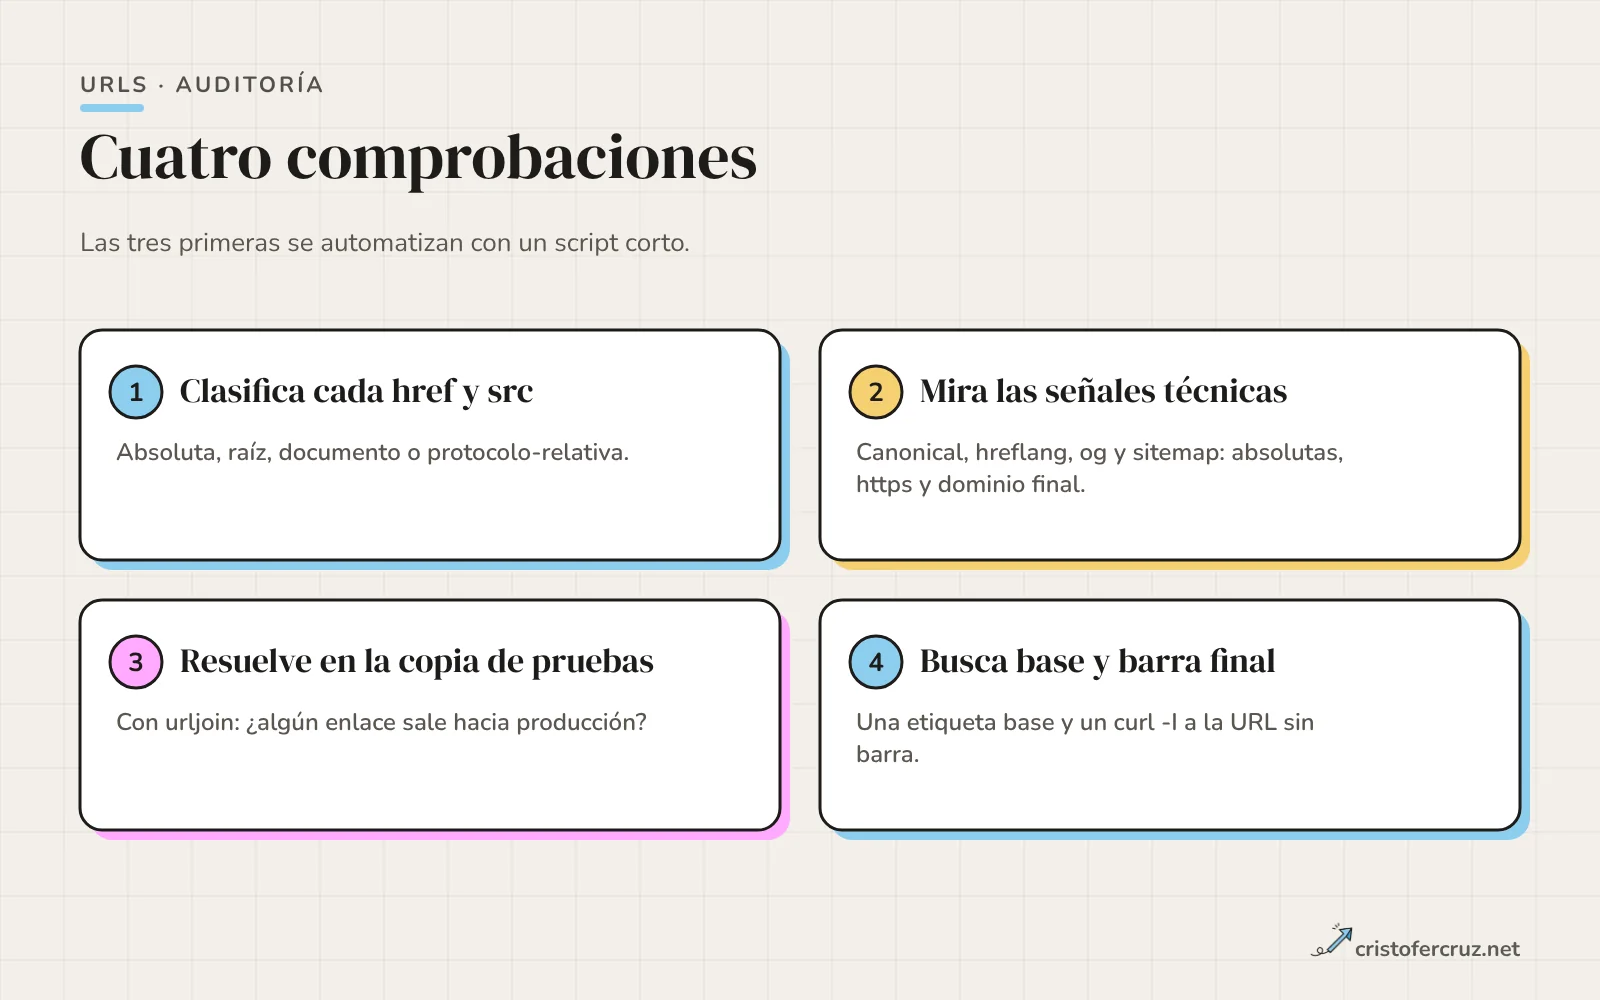
Esta es mi rutina, en orden. Las tres primeras se automatizan.
- Clasifica cada enlace e imagen en absoluta propia, externa, raíz, documento o protocolo-relativa. El script de abajo lo hace.
- Mira las señales técnicas. Canonical, hreflang, og:url, og:image y sitemap: todas con esquema y dominio finales.
- Resuelve en el entorno de pruebas. Pasa el mismo script por la copia de staging y filtra las absolutas con tu dominio de producción: son los enlaces que saldrían del entorno.
- Busca
<base>y prueba la barra final. Uncurl -Ia la URL con y sin barra final, y una búsqueda de la etiqueta base en el código fuente de las plantillas.
import re, sys, urllib.request
from collections import Counter
from html.parser import HTMLParser
from urllib.parse import urlsplit

HOST = "cristofercruz.net"

class Refs(HTMLParser):
    def __init__(self):
        super().__init__(); self.refs = []; self.bases = 0
    def handle_starttag(self, tag, a):
        a = dict(a)
        if tag == "base": self.bases += 1
        if tag == "a" and "href" in a: self.refs.append(a["href"])
        if tag == "img" and "src" in a: self.refs.append(a["src"])

def tipo(ref):
    if ref.startswith("#") or re.match(r"(mailto|tel):", ref): return None
    if ref.startswith("//"): return "protocolo-relativa"
    if re.match(r"https?://", ref):
        return "absoluta-propia" if urlsplit(ref).hostname in (HOST, "www." + HOST) else "externa"
    if ref.startswith("/"): return "raiz"
    return "documento"

cuenta, bases = Counter(), 0
for url in sys.argv[1:]:
    p = Refs(); p.feed(urllib.request.urlopen(url).read().decode("utf-8", "replace"))
    bases += p.bases
    cuenta.update(t for t in map(tipo, p.refs) if t)
print(dict(cuenta), "etiquetas base:", bases)
Se ejecuta con python3 clasifica.py URL1 URL2 …. Contra mi copia local devolvió {'raiz': 9844, 'externa': 727, 'documento': 1} etiquetas base: 0. No sigue redirecciones de dominio ni renderiza JavaScript: si tus enlaces los pinta el cliente, necesitas un rastreador que renderice.
Qué hacer esta semana
- Ejecuta la clasificación sobre tu sitemap y apunta cuántos enlaces internos son absolutos y de dónde salen.
- Comprueba que canonical, hreflang, og:url, og:image y sitemap llevan esquema, dominio y barra final definitivos, y que salen de una sola constante.
- Busca
<baseen las plantillas y las páginas renderizadas. - Sustituye cualquier enlace relativo al documento por su ruta desde la raíz, empezando por plantillas y menús.
- Haz un
curl -Ia una URL de carpeta sin barra final y mira que redirige a la versión con barra, o al revés, siempre en la misma dirección.
Preguntas frecuentes
¿Es mejor usar URLs absolutas o relativas para el SEO?
Google no documenta que una forma posicione mejor que otra en los enlaces: acepta ambas. Lo que sí documenta es que para canonical recomienda absolutas y para hreflang y sitemaps exige URLs completas. Mi criterio es relativas a la raíz en el enlazado interno y absolutas en todas las señales.
¿Las URLs relativas afectan al crawl budget?
No he encontrado documentación de Google que lo afirme. El riesgo real de las relativas al documento es otro: pueden generar URLs inexistentes o infinitas si el servidor responde 200 a todo, y eso sí consume rastreo.
¿Puedo usar un canonical relativo?
Google dice que lo soporta, pero que puede dar problemas a largo plazo y no lo recomienda. No hay ahorro que lo compense: escribe la URL completa.
¿Qué diferencia hay entre /ruta y ../ruta?
La primera cuelga siempre de la raíz del host. La segunda sube un nivel desde la carpeta de la página actual, por lo que cambia si la página está en otra profundidad o si falta la barra final.
¿Una absoluta protege del contenido copiado?
Es un argumento habitual y no lo he medido. Un scraper que copia el HTML conserva tus enlaces absolutos hasta que los reescribe, y es sencillo hacerlo. No lo uses como razón principal.
¿Debo evitar la etiqueta base?
Yo sí. Cambia la resolución de todos los enlaces relativos, incluidas las anclas, y no afecta a Open Graph. Si no tienes una razón concreta, no la añadas, y si la heredas de un tema, revisa qué enlaces cambian.
¿Qué hago si mi CMS genera absolutas con el dominio de staging?
Corrígelo en la configuración del CMS (muchos tienen un ajuste de URL del sitio) y vuelve a rastrear el entorno hasta que el script no encuentre enlaces hacia el dominio de producción. Si ya está indexado, es una migración encubierta y toca revisar canonicals y redirecciones.
Referencias y fuentes
- Hacer que tus enlaces se puedan rastrear Google Search Central
- Cómo especificar una URL canónica Google Search Central
- Versiones localizadas de tu página Google Search Central
- Cómo crear un sitemap Google Search Central
- Estructura de URLs recomendada Google Search Central
- RFC 3986, sección 5: Reference Resolution IETF
- RFC 8288: Web Linking IETF
- <base>: el elemento de URL base del documento MDN
- Mixed content MDN
- The Open Graph protocol ogp.me
- Relative vs. absolute URLs for internal linking Search Engine Journal
- Absolute vs. Relative URLs in SEO SEO.com