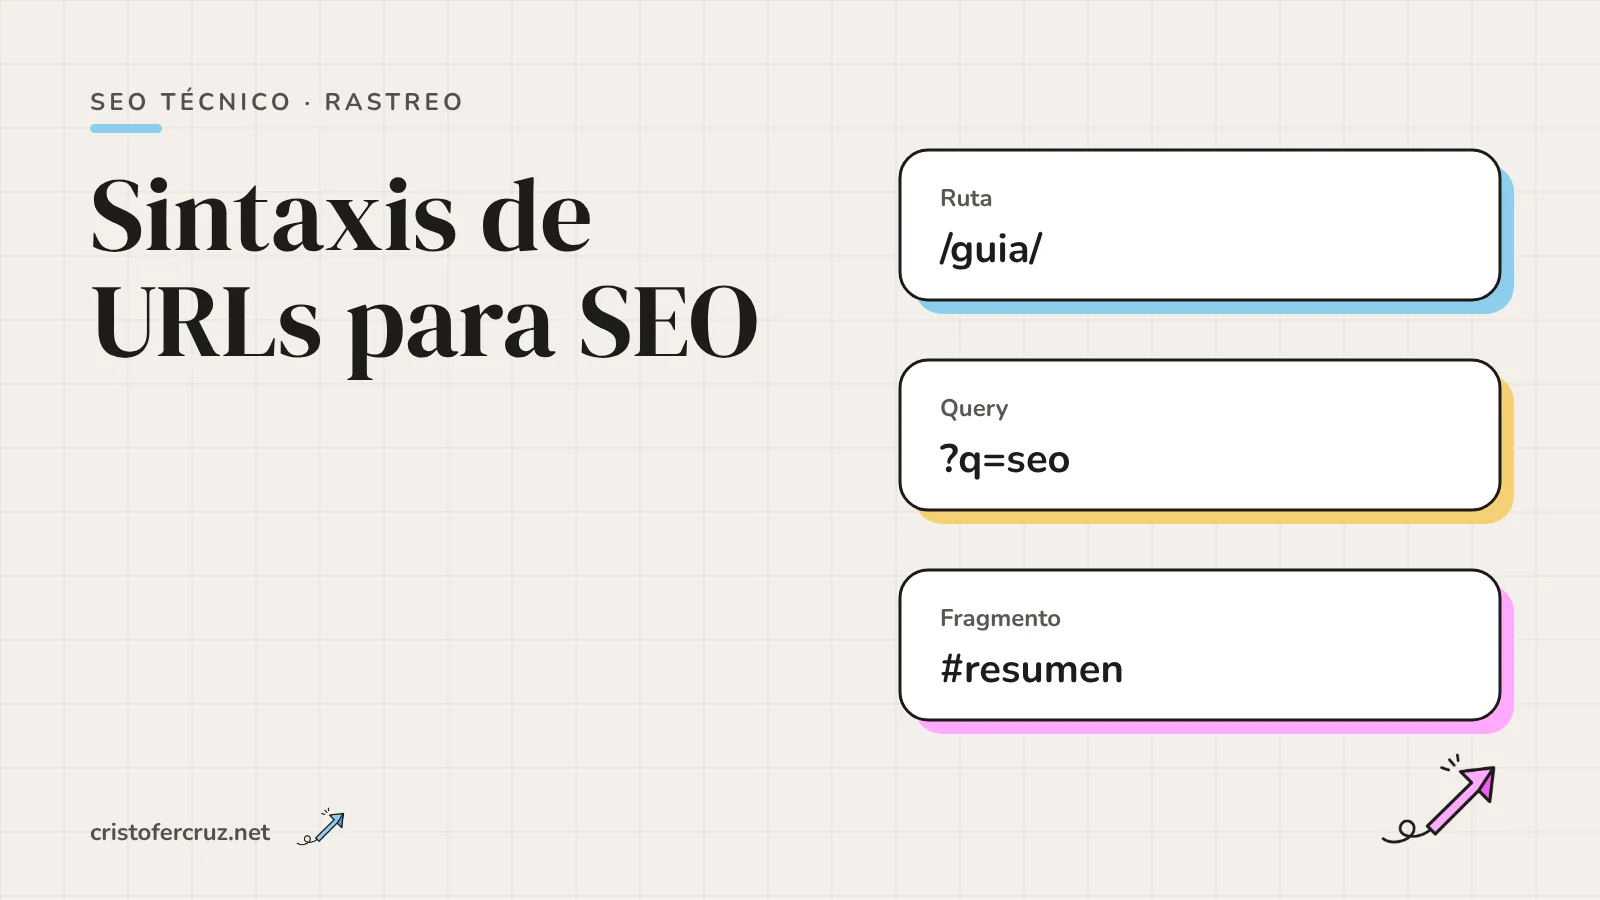
- Una URL tiene seis piezas (esquema, credenciales, host, puerto, ruta, query y fragmento) y solo la ruta y la query distinguen una página de otra dentro de tu dominio.
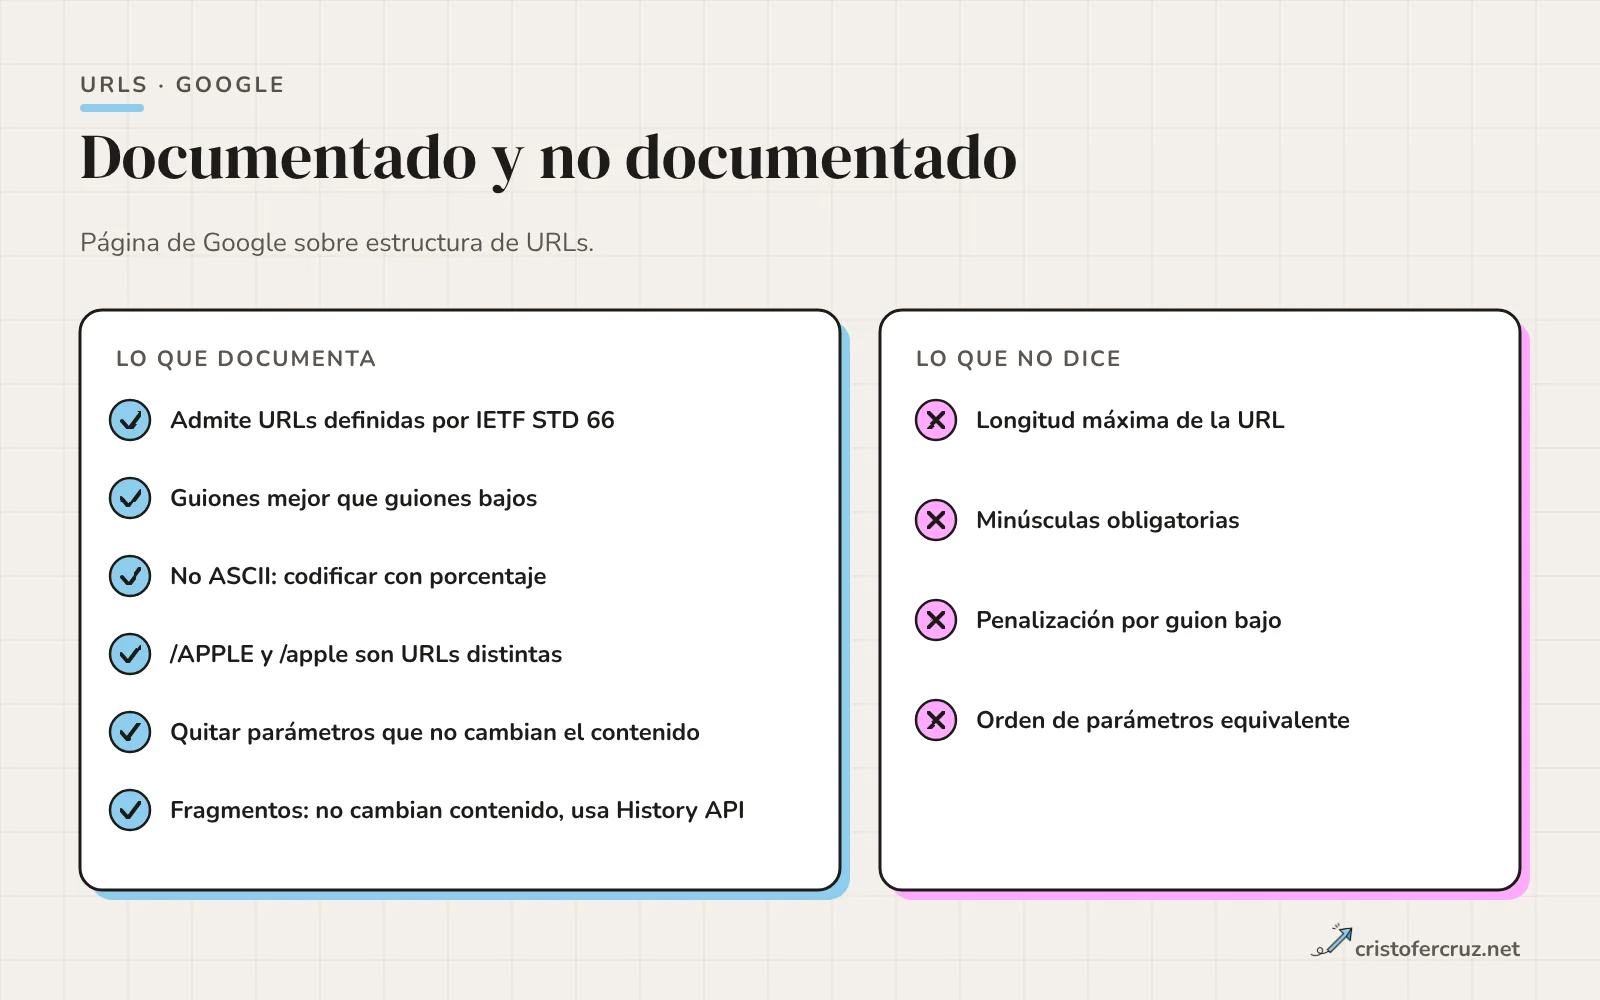
- Google admite las URLs definidas por el estándar IETF STD 66 y recomienda guiones, palabras legibles, caracteres no ASCII codificados y pocos parámetros. Dice que
/APPLEy/appleson URLs distintas. - El host no distingue mayúsculas; la ruta sí, porque eso lo decide tu servidor. Con la barra final pasa algo parecido: en la raíz da igual, en el resto son rutas distintas.
- Lo que sigue a
#no viaja al servidor. Si cambia el contenido, usa la History API y no fragmentos. - La página de Google sobre estructura de URLs no fija ninguna longitud máxima. El único límite documentado que he encontrado es el del protocolo de sitemaps: menos de 2.048 caracteres.
- Elige una forma (minúsculas, guiones, barra final) y que todo lo demás, canonical, sitemap y enlaces, coincida con ella.
Una URL con una mayúscula, una barra de más o un parámetro de seguimiento sigue enseñando la misma página al usuario. Para un rastreador es otra cadena de texto, y por tanto otra URL. La mayoría de problemas de duplicados, canonicals ignoradas y rastreo desperdiciado empiezan en una diferencia de un carácter que nadie vio.
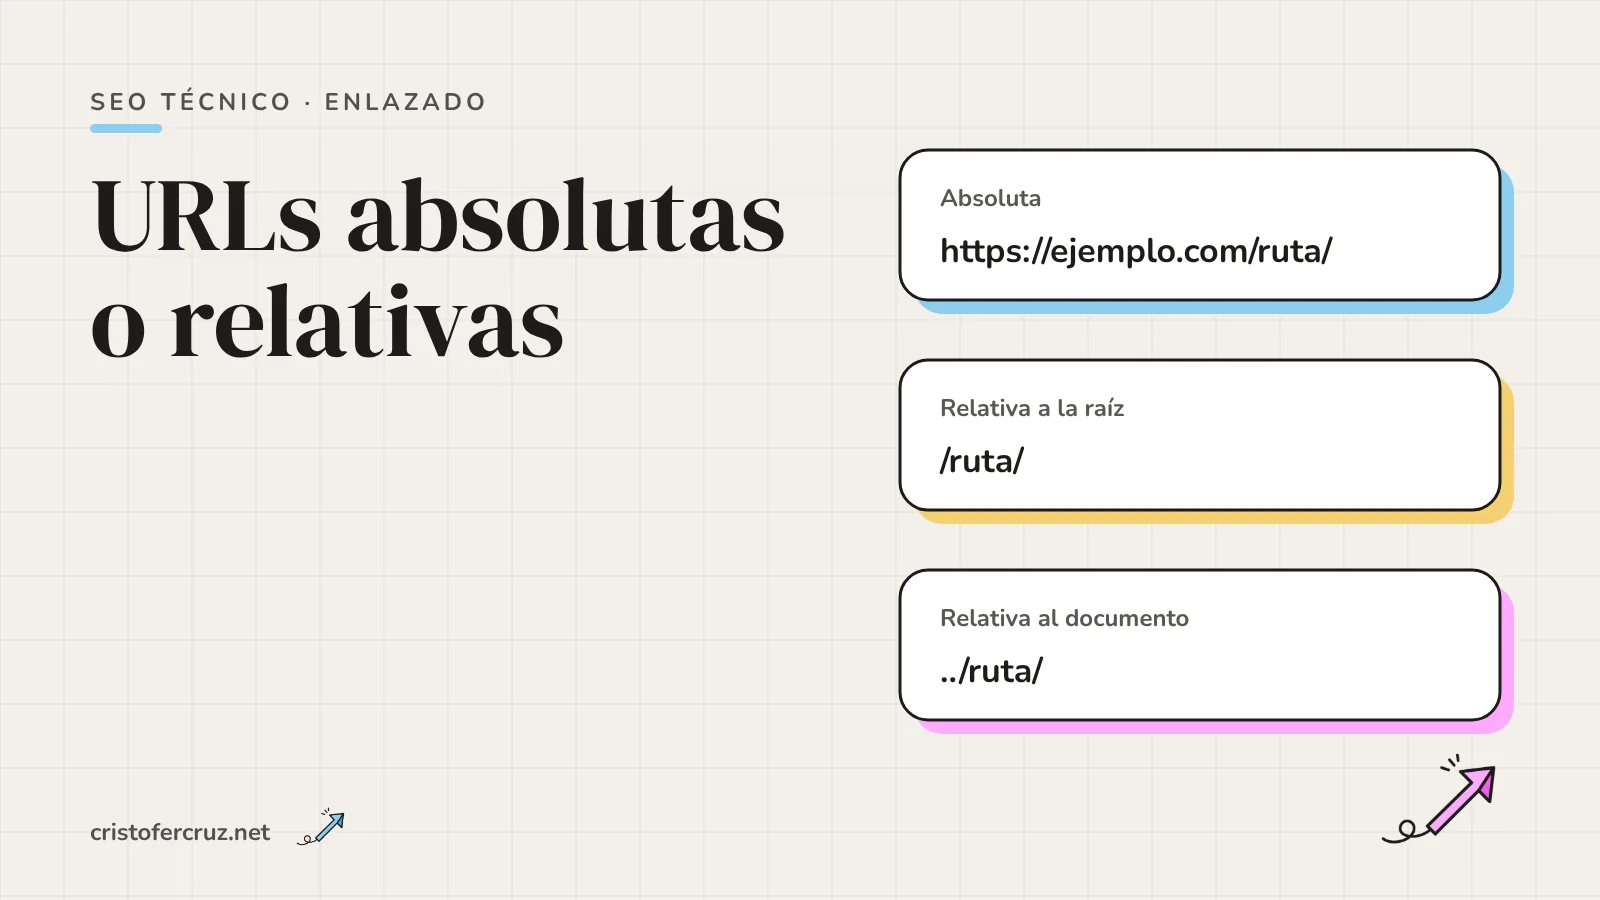
Aquí desmonto la sintaxis de una URL con ejemplos que he ejecutado (Python, Node y un Apache de pruebas), resumo lo que Google dice y lo que no dice, y reviso las 77 URLs de mi propio sitio. Si buscas cuándo escribir la URL completa o solo la ruta, eso tiene su artículo sobre URLs absolutas y relativas.
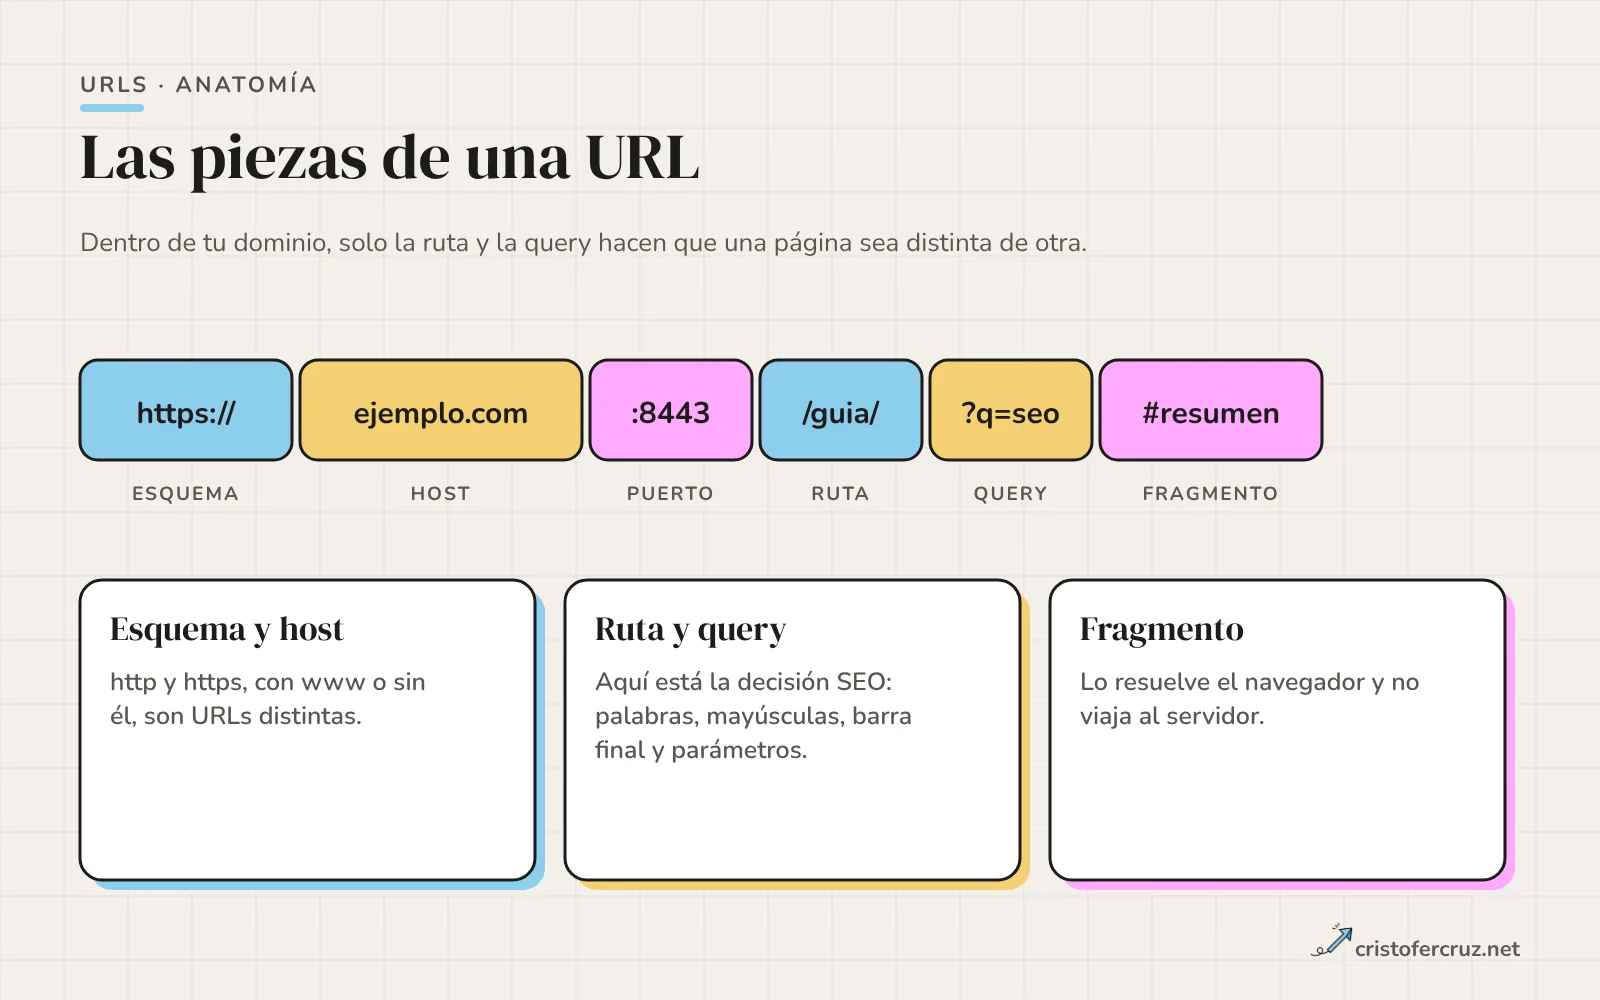
Anatomía de una URL: seis piezas
Tomo esta URL de prueba, con todo lo que puede llevar una: https://usuario@Ejemplo.COM:8443/guía/Árbol-ñandú/?q=a+b&utm_source=news#sección-2. Python la parte así:
from urllib.parse import urlsplit
p = urlsplit(u)
p.scheme    # 'https'
p.netloc    # 'usuario@Ejemplo.COM:8443'
p.hostname  # 'ejemplo.com'
p.port      # 8443
p.path      # '/guía/Árbol-ñandú/'
p.query     # 'q=a+b&utm_source=news'
p.fragment # 'sección-2'| Pieza | Ejemplo | Qué hay que saber en SEO |
|---|---|---|
| Esquema | https | http y https son URLs distintas. Se resuelve con una redirección, como explico en el artículo sobre versiones con www, sin www, http y https. |
| Credenciales | usuario@ | Existen en la sintaxis, pero no tienen lugar en una URL pública. |
| Host | ejemplo.com | No distingue mayúsculas. Un subdominio es parte del host; sus implicaciones están en la guía sobre subdominios y SEO. |
| Puerto | :8443 | El 443 en https y el 80 en http se omiten. Un puerto distinto es otro origen. |
| Ruta | /guía/Árbol-ñandú/ | Aquí vive casi toda la decisión SEO: palabras, jerarquía, mayúsculas y barra final. |
| Query | ?q=a+b&utm_source=news | Parámetros. Cada combinación es una URL distinta salvo que algo las consolide. |
| Fragmento | #sección-2 | Lo resuelve el navegador, no el servidor. |
El RFC 3986 lo formula así: esquema y ruta son obligatorios (la ruta puede estar vacía), la autoridad va precedida de //, la query empieza en el primer ? y el fragmento en el primer #. Un detalle que importa luego: https://x.es tiene ruta vacía y https://x.es/ tiene ruta /. Python las separa (path='' frente a path='/'); Node las normaliza a la segunda.
RFC 3986 y WHATWG URL: dos estándares, dos comportamientos
Google dice que admite las URLs definidas por el estándar IETF STD 66, que es el RFC 3986. Los navegadores, en cambio, siguen el URL Standard de WHATWG, que según su propio texto busca «alinear el RFC 3986 y el RFC 3987 con las implementaciones actuales» y los tiene por informativos. En la práctica conviven y no siempre dan el mismo resultado, como se ve pasando la misma URL por Python (urllib.parse, más cerca del RFC) y por Node (new URL(), que implementa WHATWG):
| Entrada | Python 3.13 (urlsplit) | Node 22 (new URL) |
|---|---|---|
HTTPS://X.ES:443/a/../b/./c | Conserva X.ES:443 en netloc y no resuelve .. | https://x.es/b/c |
https://x.es | path='' | https://x.es/ |
/guía/Árbol | No codifica nada | /gu%C3%ADa/%C3%81rbol |
/a b{c} | No codifica nada | Espacio, { y } pasan a %20, %7B y %7D |
https://cañón.es/ | .encode('idna') da xn--can-8mak.es | hostname ya devuelve xn--can-8mak.es |
/%c3%b1 (hex en minúscula) | Sin tocar | Sin tocar: /%c3%b1, mientras que /ñ sale como /%C3%B1 |
Un analizador de logs, un crawler y un script de redirecciones pueden normalizar distinto: pasa las URLs de dos fuentes por la misma función antes de compararlas. La última fila lo ilustra: %c3%b1 y %C3%B1 representan el mismo carácter, pero como cadenas no son iguales y el RFC pide mayúsculas en los hexadecimales («URI producers and normalizers should use uppercase hexadecimal digits»). Si tu CMS genera enlaces con hexadecimales en minúscula, tus datos tendrán dos cadenas para una misma URL.
Qué dice Google sobre la estructura de URLs
La página de Google sobre prácticas recomendadas de estructura de URLs es breve. Esto es lo que afirma y lo que no:
| Tema | Qué dice la documentación |
|---|---|
| Estándar | Admite URLs definidas por IETF STD 66. Los caracteres reservados deben ir codificados con porcentaje. |
| Palabras | Mejor palabras legibles que identificadores numéricos largos, y en el idioma de tu audiencia, con transliteraciones cuando proceda. |
| Caracteres no ASCII | Se codifican con porcentaje. Los caracteres ASCII no reservados pueden dejarse sin codificar. |
| Separadores | Guiones mejor que guiones bajos; estos se desaconsejan «por razones históricas». |
| Mayúsculas | Trata /APPLE y /apple como URLs distintas. Si tu servidor las trata igual, convierte a una sola forma. |
| Parámetros | Pares clave=valor unidos con &. Quita los que no cambian el contenido. Evita ID de sesión en la URL. |
| Fragmentos | No los uses para cambiar el contenido; usa la History API. |
| Longitud | No dice nada. La página no fija un máximo. |
Dos matices sobre lo que repiten muchas guías. La preferencia por guiones es una recomendación de legibilidad; no hay penalización documentada por el guion bajo. Y «usa minúsculas» es una buena práctica de ingeniería que Google no exige de forma expresa: lo que pide es una sola forma por página.
Caracteres, codificación y URLs con ñ y acentos
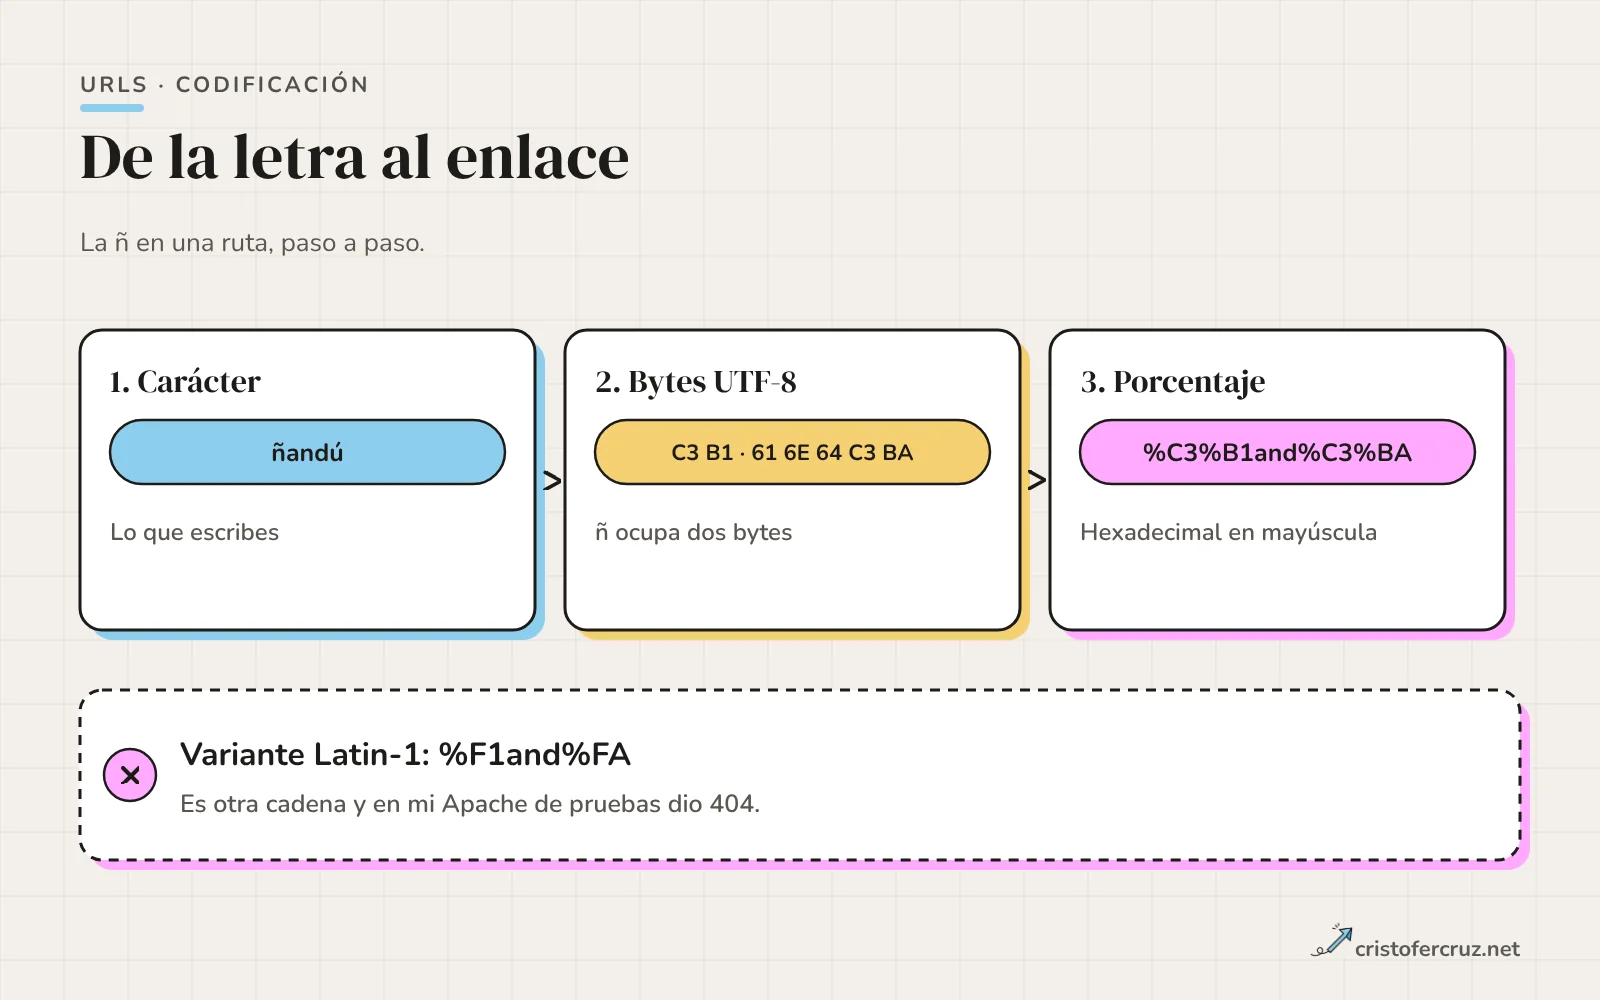
Una URL real solo transporta un conjunto limitado de caracteres. Los no reservados (letras ASCII, cifras, -, ., _, ~) van tal cual; los reservados con función de separador (/ ? # & =) se codifican cuando son datos, y todo lo demás se codifica como bytes UTF-8 precedidos de %. Así lo hace Python:
quote('ñandú')          # '%C3%B1and%C3%BA'
quote('café con leche') # 'caf%C3%A9%20con%20leche'
quote('¿qué?')          # '%C2%BFqu%C3%A9%3F'
quote('a/b', safe='')   # 'a%2Fb'
quote('a&b')            # 'a%26b'
quote('100%')           # '100%25'
'ñ'.encode('utf-8')     # b'\xc3\xb1'  -> %C3%B1
quote('ñ', encoding='latin-1')  # '%F1'
La ñ ocupa dos bytes en UTF-8 (C3 B1) y por eso se escribe %C3%B1. La última línea es el caso que rompe enlaces: la misma letra en Latin-1 es %F1. En mi Apache de pruebas, con un archivo llamado ñandú.html, estas tres peticiones devolvieron 200 (/guia/ñandú.html, %C3%B1and%C3%BA y %c3%b1and%c3%ba) y %F1and%FA devolvió 404. Si un enlace antiguo viene de una página en ISO-8859-1, ahí está tu 404.
Acentos y ñ en el slug: qué hago yo
Google no prohíbe los caracteres no ASCII (su propia página pone ejemplos en alemán y japonés). Mi criterio, que es de ingeniería y no una regla de Google, es escribir los slugs en ASCII: sin tildes y con la ñ sustituida. Elimino una fuente de duplicados (%C3%B1 frente a %c3%b1 frente a n) y los enlaces se copian bien en cualquier sitio.
Ese criterio tiene una trampa propia del español: año sin tilde es ano, que es otra palabra. En un slug como /mejores-moviles-ano-2026/ la lectura cambia. Si el término lleva ñ y quieres evitar el equívoco, reformula el slug (/mejores-moviles-2026/) o conserva la ñ y asume la codificación. Los dominios con ñ siguen otro camino: se convierten a punycode, como vi con cañón.es, que queda en xn--can-8mak.es.
En un sitio multilingüe, las anotaciones de hreflang deben llevar esa forma exacta, barra final incluida.
Mayúsculas y minúsculas
El host no distingue mayúsculas: el URL Standard dice que, si el dominio es ASCII, el resultado se pasa a minúsculas, y urlsplit(...).hostname en Python devolvió ejemplo.com para Ejemplo.COM. La ruta sí es sensible, aunque depende del servidor. Esto vi en mi Apache de pruebas, en Linux:
| Petición | Resultado |
|---|---|
/blog/post/ | 200 |
/Blog/post/ (la carpeta es blog) | 404 |
/Blog/x.html (existe Blog/x.html) | 200 |
/blog/x.html (no existe) | 404 |
Con un sistema de archivos que distingue mayúsculas, /Blog/ y /blog/ son dos carpetas diferentes. En un servidor que no las distinga (no lo he probado: depende del sistema de archivos y del software) la misma página respondería en las dos y tendrías duplicados sin querer. Google no conoce cómo está montado tu servidor y toma ambas formas como URLs distintas.
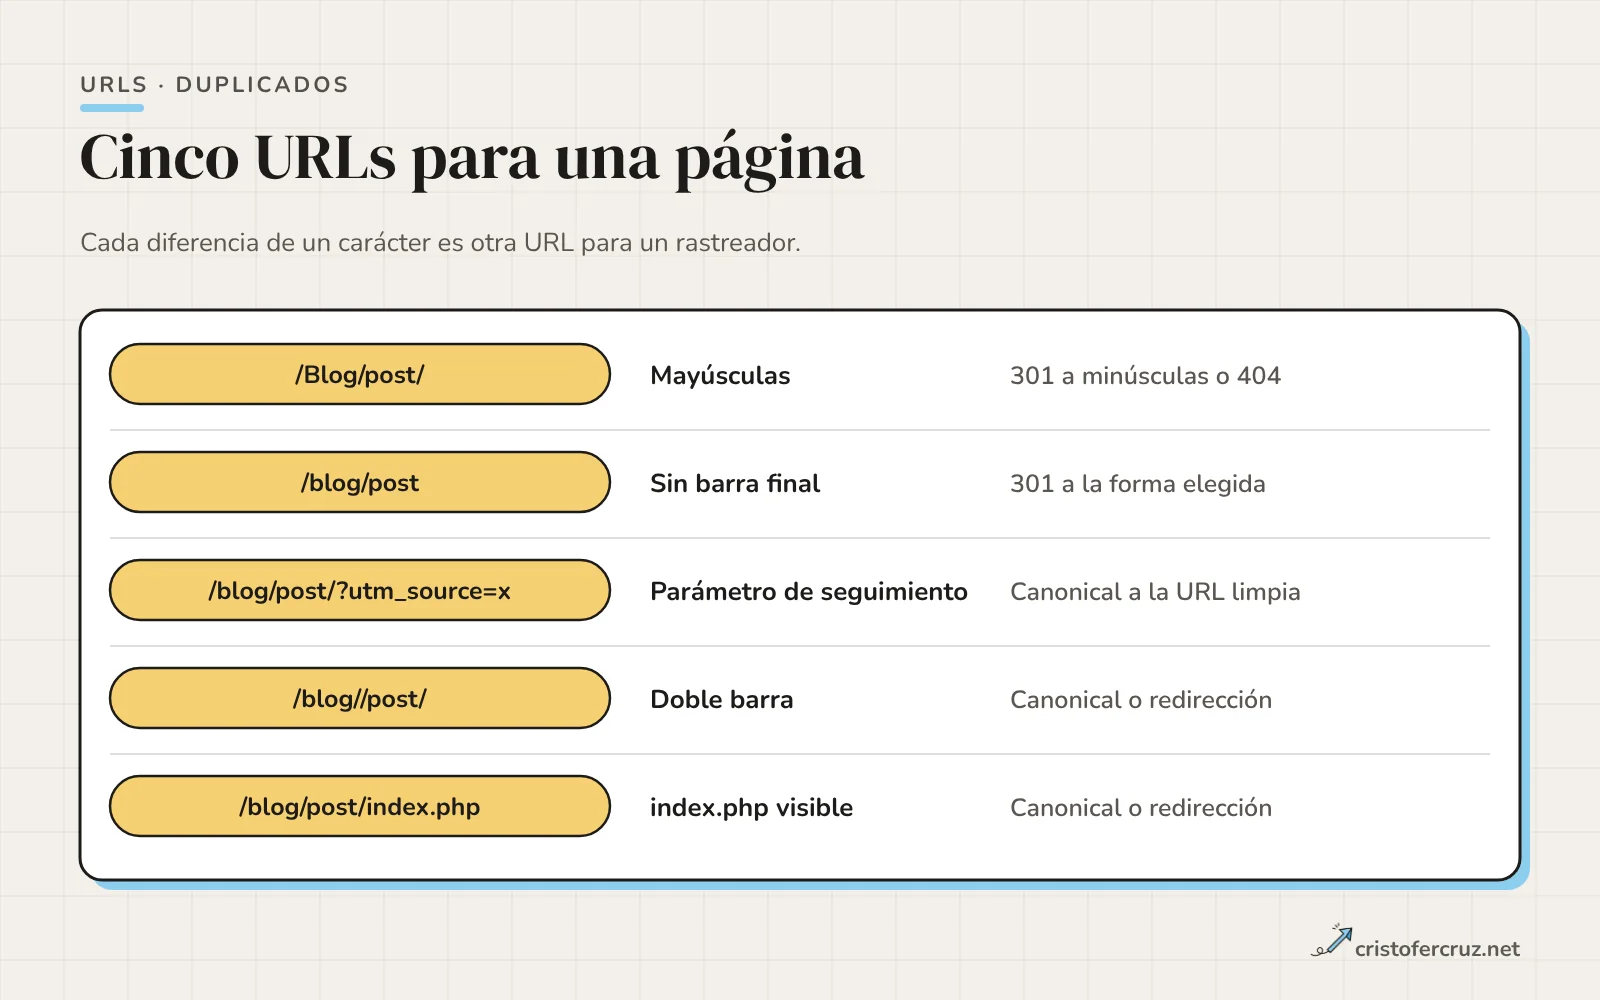
La solución es una regla única. O redirigir cualquier variante con mayúsculas a la forma en minúsculas (301), o devolver 404 a todo lo que no sea la forma correcta. Con 404 pierdes las visitas de quien escriba la mayúscula; con 301 mantienes una URL más viva. Qué tipo de redirección usar en cada caso está en la guía de tipos de redirecciones.
Barra final: cuándo son URLs distintas
Tras el dominio, https://x.es y https://x.es/ son lo mismo: el navegador siempre envía / como ruta. En cualquier otro punto, /blog/post y /blog/post/ son rutas diferentes que un servidor puede responder igual o de forma distinta. Ahrefs resume el criterio en la misma línea: es una cuestión de preferencia siempre que seas consistente; los problemas aparecen cuando ambas versiones sirven el mismo contenido, contenido distinto, o chocan con hreflang. No he podido abrir la entrada histórica de Google sobre el tema, así que no la cito.
Lo que sí puedo mostrar es cómo se comporta un Apache estándar, con el módulo mod_dir, ante una carpeta con index.html:
GET /blog/post/   -> 200
GET /blog/post    -> 301 Location: /blog/post/
GET /doc.pdf      -> 200
GET /doc.pdf/     -> 404
Las carpetas llevan barra y el servidor redirige solo; los archivos no la llevan y con ella dan 404. Con un CMS o un framework depende de su enrutador: pruébalo. Cuál elijas da igual; lo que no da igual es que el canonical repita exactamente la forma elegida y que sitemap y enlaces internos hagan lo mismo.
Parámetros: orden, duplicados y cuáles quitar
Google recomienda separar claves y valores con = y añadir parámetros con &, como en ?category=dresses&sort=low-to-high&sid=789. Desaconseja las sintaxis con corchetes o dos puntos y la de solo comas. Para varios valores de una misma clave propone un carácter que no choque con STD 66, como la coma.
Un servidor lee los parámetros como una lista de pares y cada herramienta decide qué hacer con ellos. Esto dio Python con q=a+b&q=c%20d&b=2&a=1:
parse_qsl(query)
# [('q', 'a b'), ('q', 'c d'), ('b', '2'), ('a', '1')]
parse_qs(query)
# {'q': ['a b', 'c d'], 'b': ['2'], 'a': ['1']}
parse_qs('color=rojo&talla=m') == parse_qs('talla=m&color=rojo')   # True
'/p?color=rojo&talla=m' == '/p?talla=m&color=rojo'                # False
Leídos como datos, dos órdenes son equivalentes; como URL, son dos cadenas distintas. No he encontrado documentación de Google sobre si trata esas dos formas como la misma URL, así que no lo doy por hecho: lo seguro es generar los parámetros siempre en el mismo orden. Otros detalles de sintaxis: en una query, + significa espacio en el formato de formularios (q=a+b se lee como a b), mientras que en la ruta + es un más literal. Python y URLSearchParams de JavaScript escriben el espacio como +; encodeURIComponent lo escribe como %20.
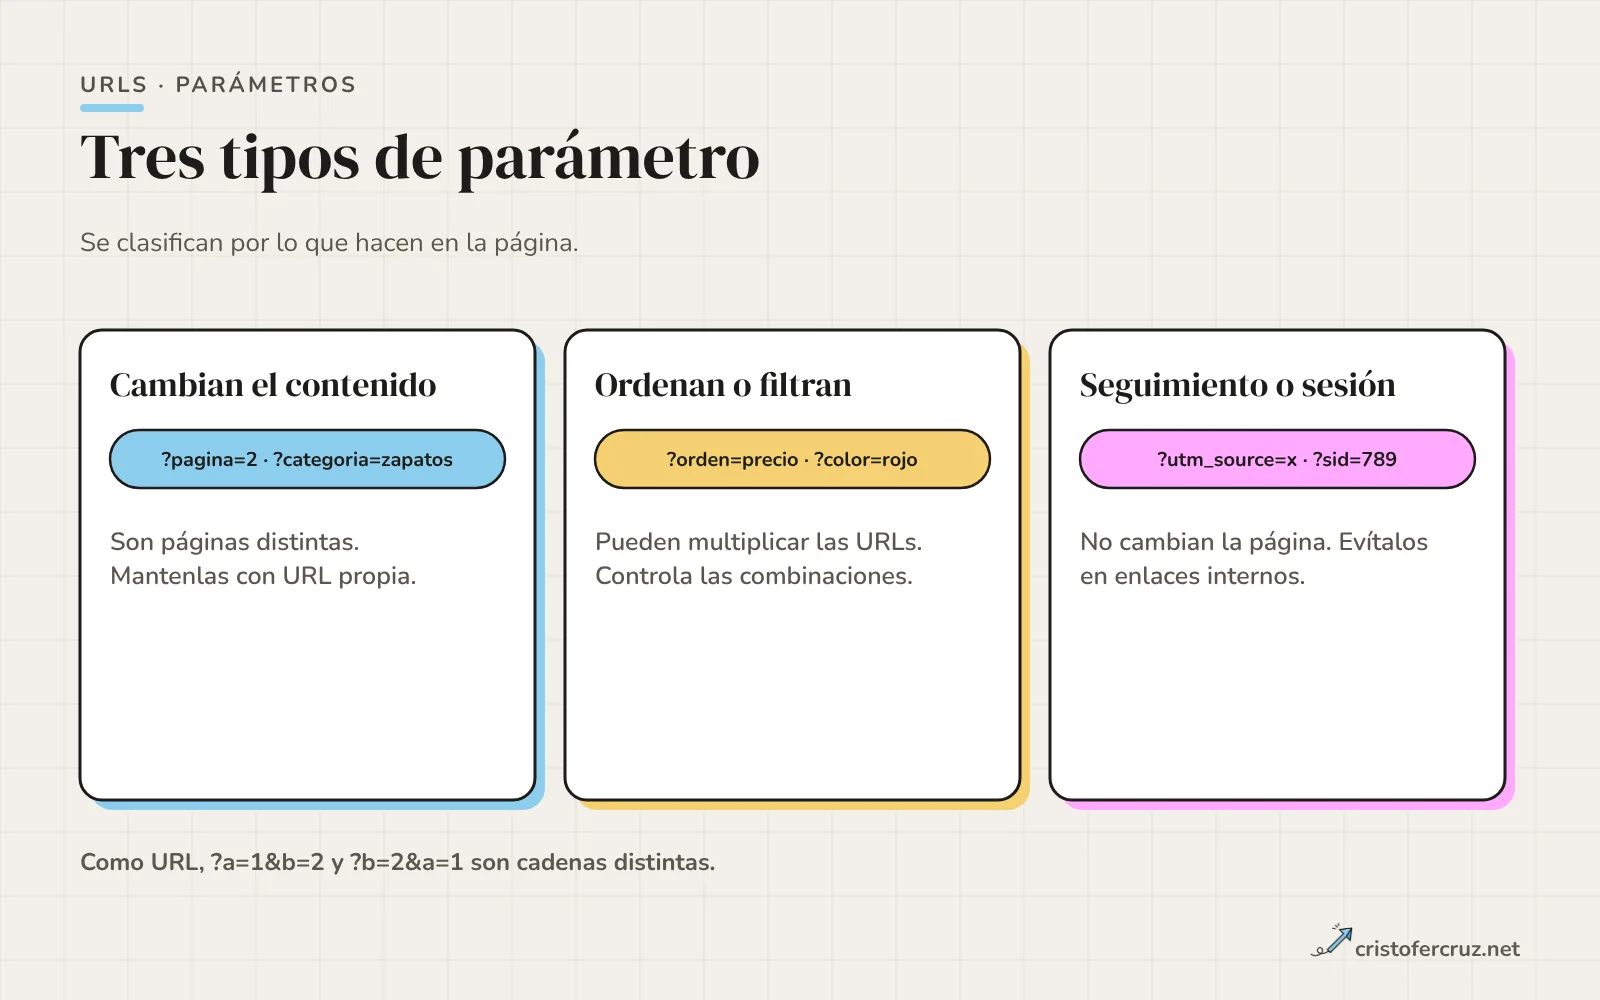
La decisión SEO está en separar los parámetros que cambian el contenido de los que no. Google lo plantea así: quita los que no alteran la página, evita ID de sesión (usa cookies) y ten cuidado con filtros combinables, que crean explosión de URLs casi duplicadas. Para consolidar, la página de Google sobre duplicados califica las redirecciones y rel="canonical" como señales fuertes y el sitemap como señal débil, y dice que se pueden combinar. Para bloquear listados sin valor, Google apunta a robots.txt. La herramienta de parámetros de URL de Search Console ya no existe: Google la retiró en marzo de 2022.
Fragmentos: lo que va detrás de #
El fragmento lo interpreta el navegador y no llega al servidor. Lo comprobé pidiendo /blog/post/?a=1#seccion-2 con curl -v a mi Apache: la línea de petición fue GET /blog/post/?a=1 HTTP/1.1, sin el #seccion-2. El RFC 3986 lo recoge en sentido parecido: al comparar URIs para una acción de red, el fragmento debería excluirse.
La documentación de JavaScript SEO de Google es clara: no uses fragmentos para cargar contenido distinto, porque Googlebot no puede resolver esas URLs de forma fiable, y usa la History API para enrutar entre vistas. Una app que muestre /#/productos y /#/contacto está pidiendo siempre la misma URL al servidor. Los fragmentos sí sirven para lo que fueron creados: saltar a una sección con un ancla. Cómo afecta el renderizado del cliente a esto lo cubre el artículo sobre CSR, SSR, SSG e ISR.
Longitud: lo que no está documentado
La página de estructura de URLs de Google no da ningún máximo y no he buscado un límite en otras páginas suyas, así que no lo afirmo. El único número documentado que he encontrado es el del protocolo de sitemaps: el valor de <loc> debe tener menos de 2.048 caracteres. Los límites de navegadores y servidores no los he verificado. El mismo protocolo exige que el archivo esté codificado en UTF-8, que los valores estén escapados como entidades (un & en una query se escribe & dentro del XML), que todos los URLs sean del mismo host y que usen el mismo protocolo.
Slugs y URLs amigables: criterios
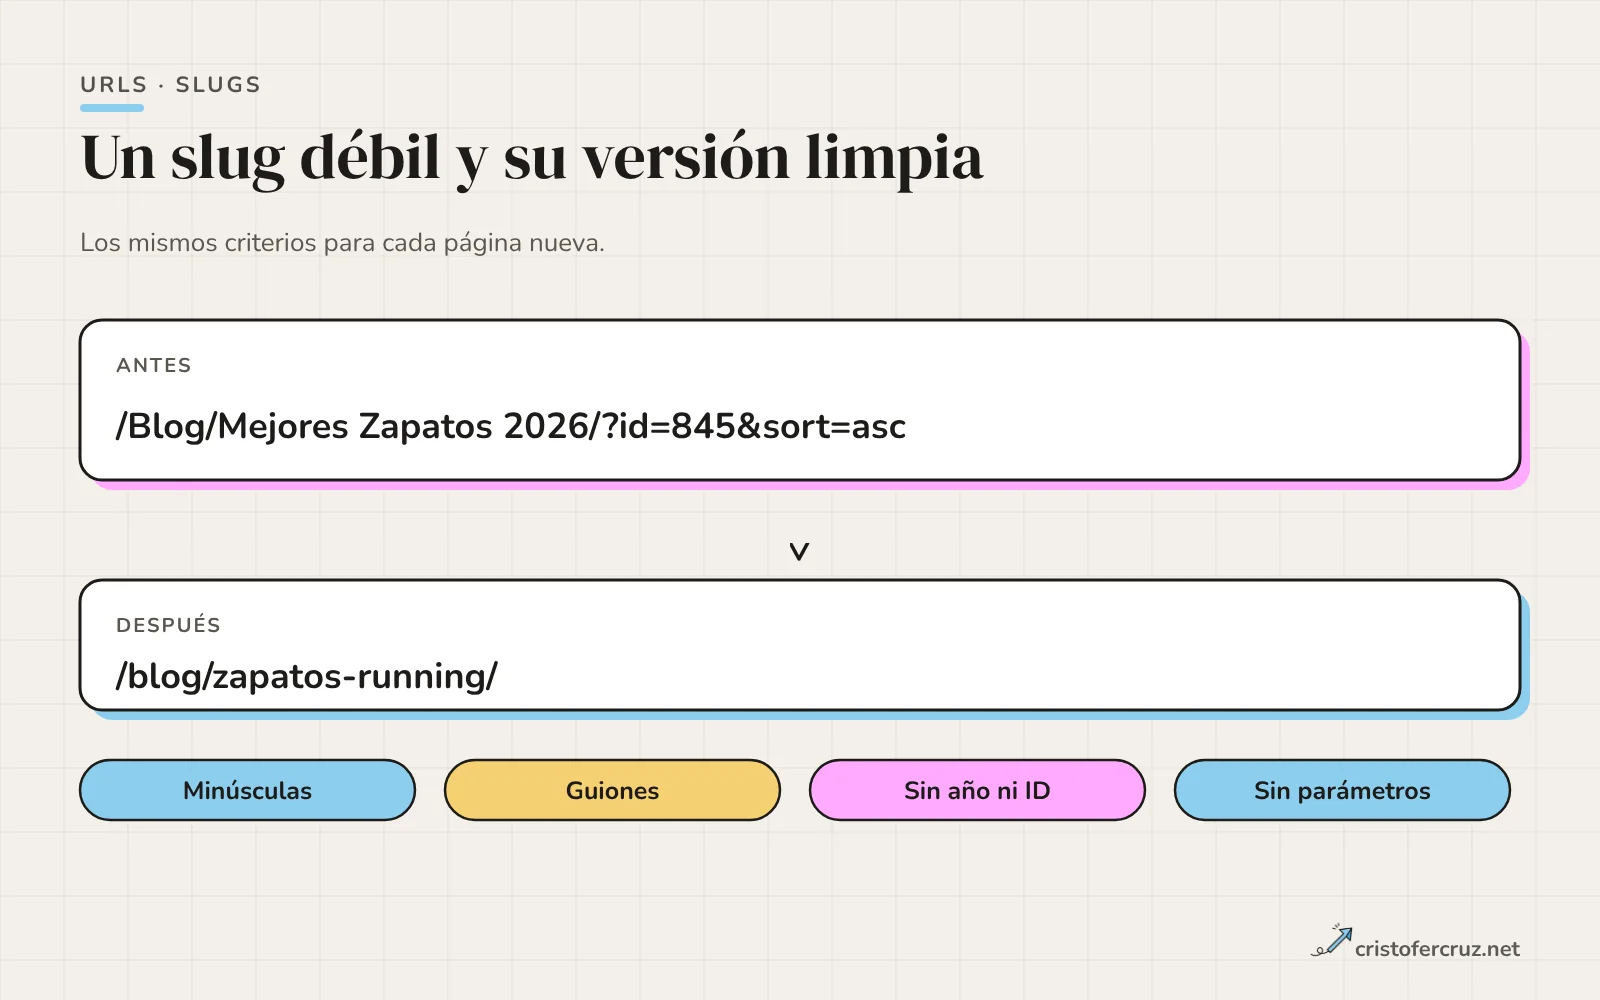
Una URL amigable es la que un humano puede leer y adivinar. Google lo respalda con el ejemplo de /wiki/Aviation frente a identificadores largos. Estos son los criterios que aplico al elegir un slug:
- Una o pocas palabras que describan la página, en el idioma del contenido.
- Guiones entre palabras, nada de espacios ni guiones bajos.
- Todo en minúsculas y en ASCII.
- Sin fechas ni años cuando el contenido pueda actualizarse; cambiar el año cambia la URL.
- Sin identificadores de base de datos, sin parámetros de ordenación y sin extensión que dependa de la tecnología (
.php). - Profundidad igual a la jerarquía real, que es una decisión de arquitectura web antes que de redacción.
Cambiar una URL que ya existe
Una URL publicada con enlaces y posiciones tiene valor acumulado. Cambiarla solo para mejorar la estética rara vez compensa. Si hay un motivo claro (mayúsculas que generan duplicados, parámetros que ensucian, una reestructuración), el orden es siempre el mismo: redirección 301 de la antigua a la nueva, sin cadenas, y actualizar canonical, sitemap, enlaces internos y hreflang a la forma nueva. La redirección debe quedar activa durante bastante tiempo; cuánto y por qué lo detalla el artículo de redirecciones SEO.
Errores típicos y qué se ve en cada uno
| Error | Qué se ve | Arreglo |
|---|---|---|
| Mayúsculas en enlaces internos | Dos URLs con 200, o una con 404 | Forma única; 301 o 404 para el resto |
| Barra final mixta | Enlaces internos que pasan por una redirección | Enlazar siempre a la forma final |
| Parámetros de seguimiento en enlaces internos | URLs con utm_ rastreadas desde dentro | Quitar los parámetros; medir con eventos |
| Fragmentos para vistas distintas | El servidor recibe siempre la misma URL | History API y URLs reales |
| Hexadecimal en minúscula o Latin-1 | Dos cadenas para una URL o un 404 | UTF-8 y hexadecimal en mayúscula |
Doble barra o /index.php accesibles | 200 con contenido duplicado | Canonical autorreferenciado o redirección |
Antes de redactar reglas, mira qué URLs rastrea Googlebot de verdad. Un analizador de logs te enseña en un rato cuántas variantes con mayúsculas, parámetros o doble barra existen y cuáles reciben visitas.
Cómo lo tengo en mi web
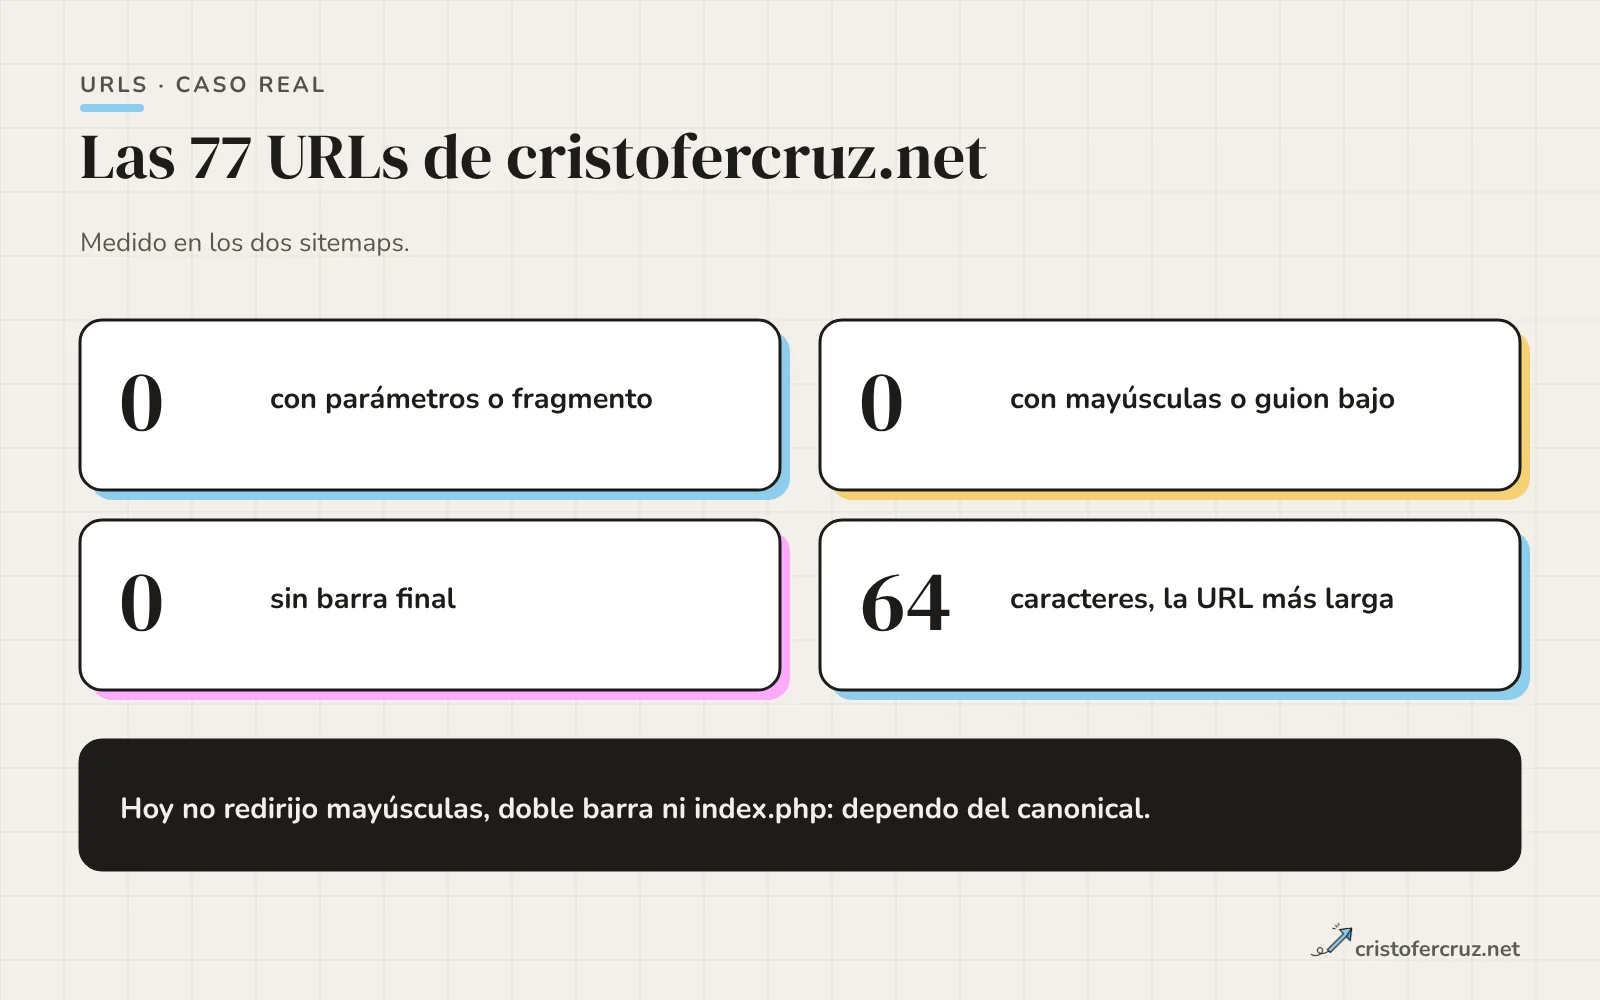
He medido mis URLs leyendo los dos sitemaps y el código. Cuando lo medí había 77 URLs: 41 en sitemap.xml y 36 en el sitemap del blog, que crece con cada artículo. Resultados, con las 77:
| Comprobación | Resultado |
|---|---|
URLs con parámetros (?) o fragmento (#) | 0 |
| URLs con mayúsculas o guion bajo | 0 |
URLs con caracteres no ASCII o % | 0 |
| URLs sin barra final | 0 (todas terminan en /) |
URLs en http o con otro host | 0 (todas https://cristofercruz.net) |
| Longitud máxima | 64 caracteres: /servicios/recuperacion-penalizaciones/ con el dominio |
| Profundidad | 1 nivel en 16, 2 niveles en 60 y la home |
| Slugs del blog | 2,7 palabras de media, 30 caracteres como máximo (36 artículos) |
El código del blog solo acepta slugs con la expresión ^[a-z0-9]+(?:-[a-z0-9]+)*$: letras minúsculas ASCII, cifras y guiones. Un artículo con otro nombre de carpeta ni se lista ni se renderiza. El canonical sale de la ruta de la página con barra final y sin query. De los 383 enlaces internos con ruta que encontré en contenidos del blog, plantillas y páginas index.php, ninguno carece de barra final, lleva parámetros o tiene mayúsculas (descontando los que apuntan a archivos).
Pruebas contra el sitio publicado, con curl, de una página del blog:
| Petición | Respuesta |
|---|---|
/blog/cache-seo/ | 200 |
/blog/cache-seo | 301 a /blog/cache-seo/ |
/Blog/cache-seo/ y /blog/Cache-SEO/ | 404 |
/blog/cache-seo/?utm_source=x | 200, canonical a /blog/cache-seo/ |
//blog/cache-seo/ y /blog//cache-seo/ | 200, canonical a /blog/cache-seo/ |
/blog/cache-seo/index.php | 200, canonical a /blog/cache-seo/ |
Lo que hoy no hago: no redirijo la doble barra ni index.php (dependen del canonical), no redirijo las mayúsculas a minúsculas (dan 404) y no tengo reglas de servidor para parámetros. En robots.txt no bloqueo parámetros. En el listado del blog, ?pagina=2 lleva su propio canonical, ?q= y ?categoria= salen con noindex, follow y canonical a /blog/, y ?utm_source=x devuelve canonical a /blog/. Cómo declaro cada URL en el sitemap lo explico en la guía de sitemaps XML. Lo que no he verificado es qué hace Google con la doble barra en mi sitio, porque no he mirado sus logs de rastreo.
Cómo auditar la sintaxis de URLs
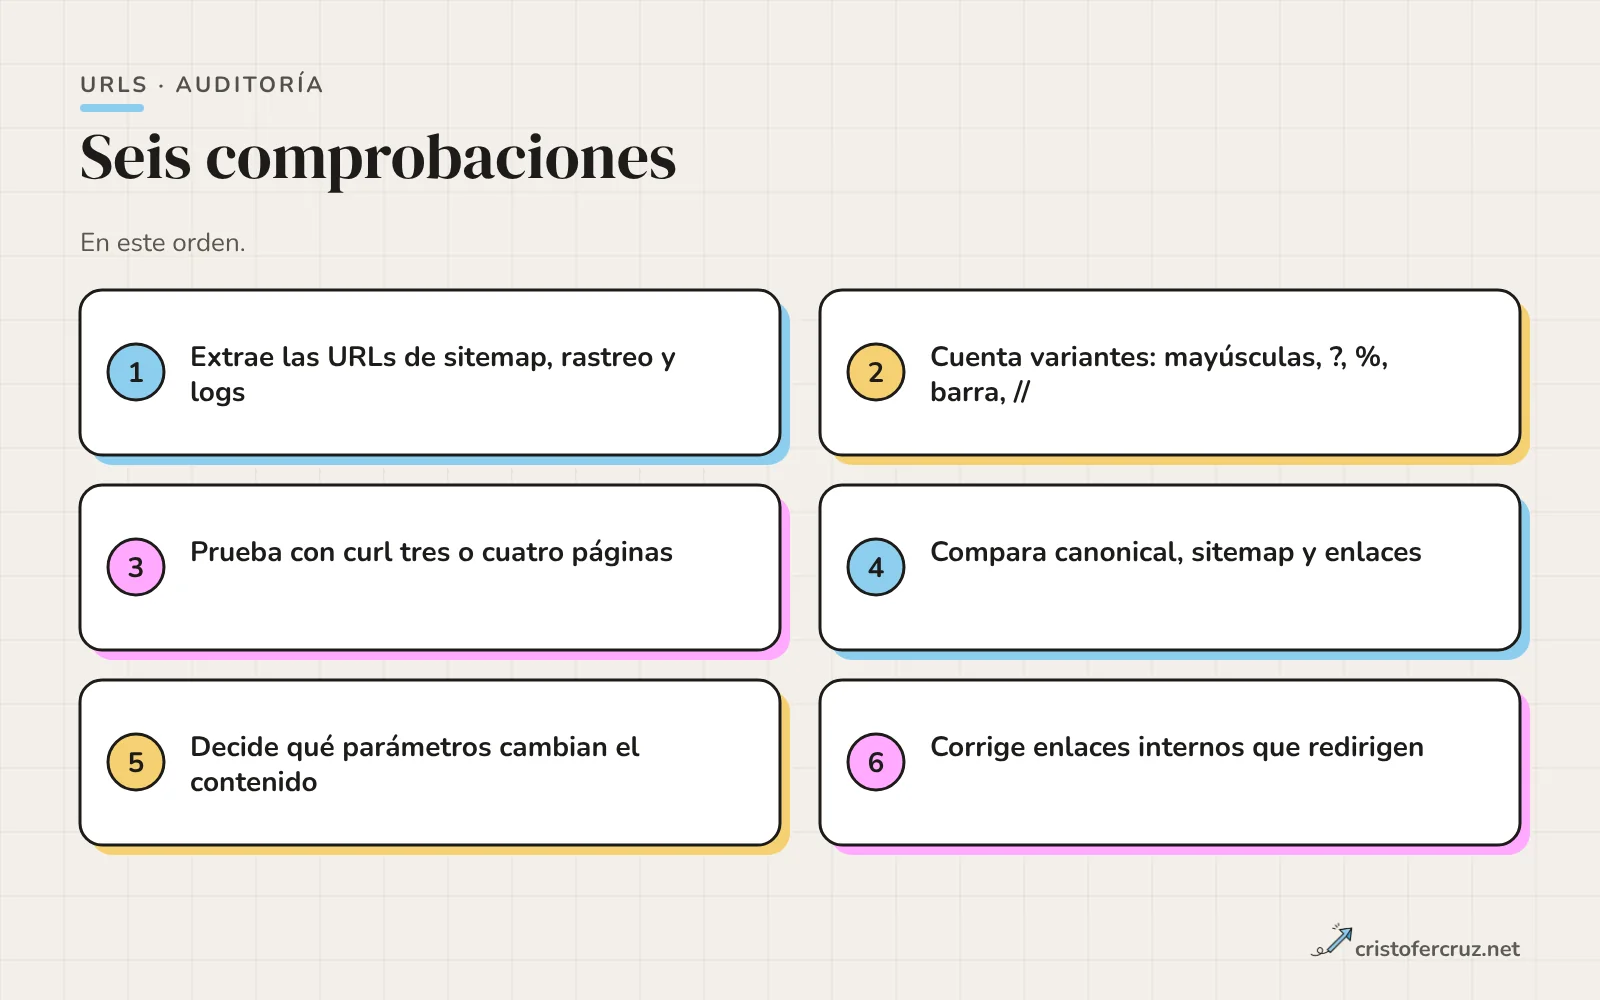
- Extrae las URLs del sitemap y de un rastreo del sitio, y de los logs si los tienes.
- Cuenta variantes con una hoja de cálculo o un script: URLs con mayúsculas, con
?, con%, sin barra final, con doble barra y conindex.en la ruta. - Prueba con curl las variantes de tres o cuatro páginas representativas:
curl -s -o /dev/null -w '%{http_code} %{redirect_url}\n' URL. Para ver rutas con//o..sin que curl las limpie, añade--path-as-is. - Compara canonical, sitemap y enlaces internos: deben repetir la misma cadena.
- Mira los parámetros que llegan en los logs o en Search Console y decide para cada uno si cambia el contenido.
- Revisa los enlaces internos que pasan por una redirección y corrígelos para que apunten a la forma final.
Preguntas frecuentes
¿Google distingue mayúsculas y minúsculas en las URLs?
Sí en la ruta. La documentación de Google dice que trata /APPLE y /apple como URLs diferentes y aconseja convertirlas a una sola forma si tu servidor las trata igual. El nombre de dominio no distingue mayúsculas.
¿Es mejor la URL con barra final o sin ella?
Ninguna es mejor por sí misma. En la raíz del dominio no hay diferencia; en el resto son rutas distintas. Elige una, redirige la otra y haz que canonical, sitemap y enlaces internos usen la elegida.
¿Guiones o guiones bajos?
Google recomienda guiones y desaconseja los guiones bajos «por razones históricas». No documenta una penalización por usar guiones bajos; es una recomendación de convención y legibilidad.
¿Puedo usar ñ y tildes en la URL?
Se puede: los caracteres no ASCII se codifican en UTF-8 con porcentaje (ñ es %C3%B1). Yo prefiero slugs en ASCII por evitar variantes de codificación, con cuidado en palabras como año, cuya versión sin ñ es otra palabra.
¿Cuál es la longitud máxima de una URL para SEO?
La página de Google sobre estructura de URLs no fija ninguna. El protocolo de sitemaps sí limita el valor de <loc> a menos de 2.048 caracteres. Para el resto, mantén las URLs cortas por legibilidad, no por una regla documentada.
¿Los parámetros UTM crean URLs duplicadas?
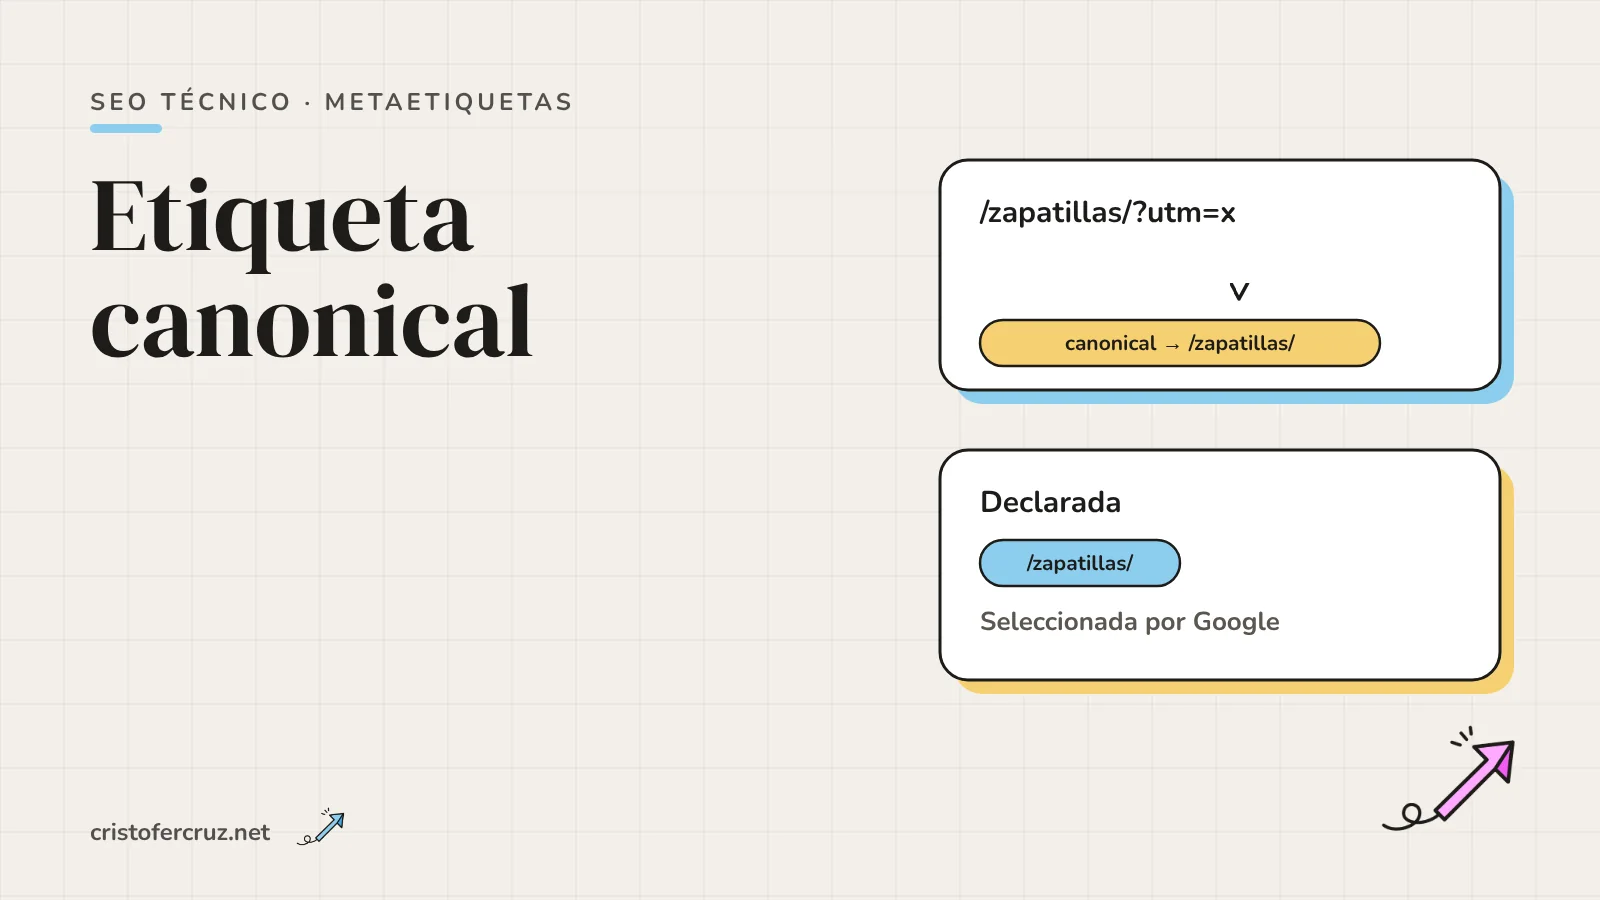
Crean URLs distintas que muestran la misma página. Evítalos en enlaces internos y deja un canonical autorreferenciado en la página limpia, que es lo que hago yo.
¿Googlebot rastrea lo que va después de #?
La documentación de Google indica que no se usen fragmentos para cambiar el contenido, porque Googlebot no puede resolver esas URLs de forma fiable. Además, el fragmento no se envía al servidor en la petición.
Fuentes consultadas
- Prácticas recomendadas para la estructura de URLs Google Search Central
- Cómo consolidar URLs duplicadas Google Search Central
- Fundamentos de SEO para JavaScript Google Search Central
- Spring cleaning: the URL Parameters tool Google Search Central Blog
- RFC 3986: Uniform Resource Identifier (URI): Generic Syntax IETF
- URL Standard WHATWG
- Protocolo de sitemaps sitemaps.org
- What Is A Trailing Slash & When Does It Matter Ahrefs