- El HTML no posiciona por sí mismo: decide si Google puede rastrear, renderizar, entender y mostrar tu página.
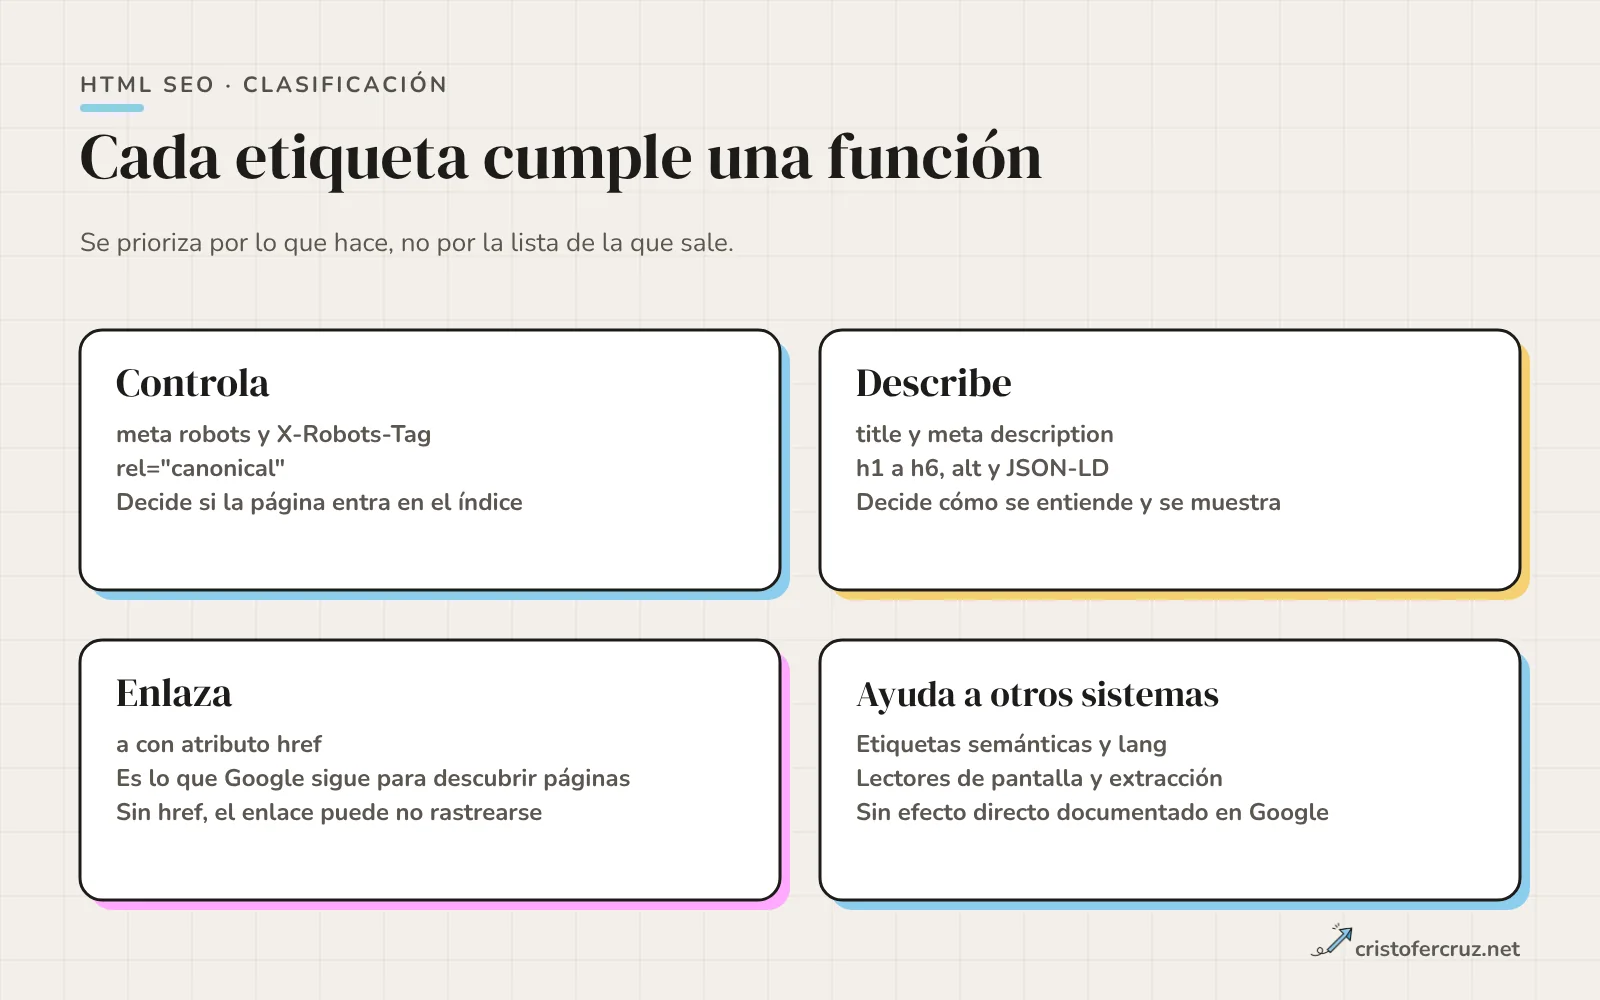
- Cada etiqueta cumple una de cuatro funciones (controla, describe, enlaza o ayuda a otros sistemas) y se prioriza por esa función.
- Lo que condiciona el rastreo (robots, canonical, enlaces con
href) tiene que estar ya en el HTML que devuelve el servidor. - Según Google, ni el orden ni la cantidad de encabezados son un factor de ranking, y la web en general no es HTML válido. El HTML semántico se usa por accesibilidad y mantenimiento, no como atajo de posiciones.
- Google no usa meta keywords ni
rel="prev"yrel="next", y tampoco el atributolangpara detectar el idioma.
El 17 de noviembre de 2026 rastreé 99 URLs de mi propia web y no encontré ningún enlace sin href, ningún noindex ni una sola página con dos h1. Lo que sí encontré fue una decisión mía que ahora tengo que defender o corregir: 59 de las 60 portadas de blog llevan el alt vacío. Este artículo ordena las etiquetas HTML por lo que hacen en Google, separa lo que la documentación dice de lo que se repite sin fuente y termina con ese rastreo, números incluidos.
Qué es el HTML SEO y por qué no basta con "poner las etiquetas"
Si buscas "etiquetas HTML para SEO", casi todas las guías te dan la misma lista: title, meta description, encabezados, alt, canonical, robots, schema. La lista es correcta, pero no dice cuáles tienen efecto en Google, cuáles sirven a otros sistemas y cuáles ni siquiera lee. Aquí las ordeno por lo que hacen, con la documentación de Google como referencia y con lo que me encontré al auditar mi web.
El HTML determina si Google puede rastrear, entender y mostrar bien una página. A partir de eso clasifico cada etiqueta en una de cuatro funciones. Unas controlan si la página entra en el índice (robots, canonical). Otras describen cómo se entiende y se muestra (title, description, encabezados, alt, schema). Otras enlazan y dejan que Google descubra más páginas (el elemento a con href). Y otras ayudan a sistemas que no son el buscador: lectores de pantalla, herramientas de extracción de contenido (etiquetas semánticas, lang).
Qué hace Google con tu HTML: rastrear, renderizar e indexar
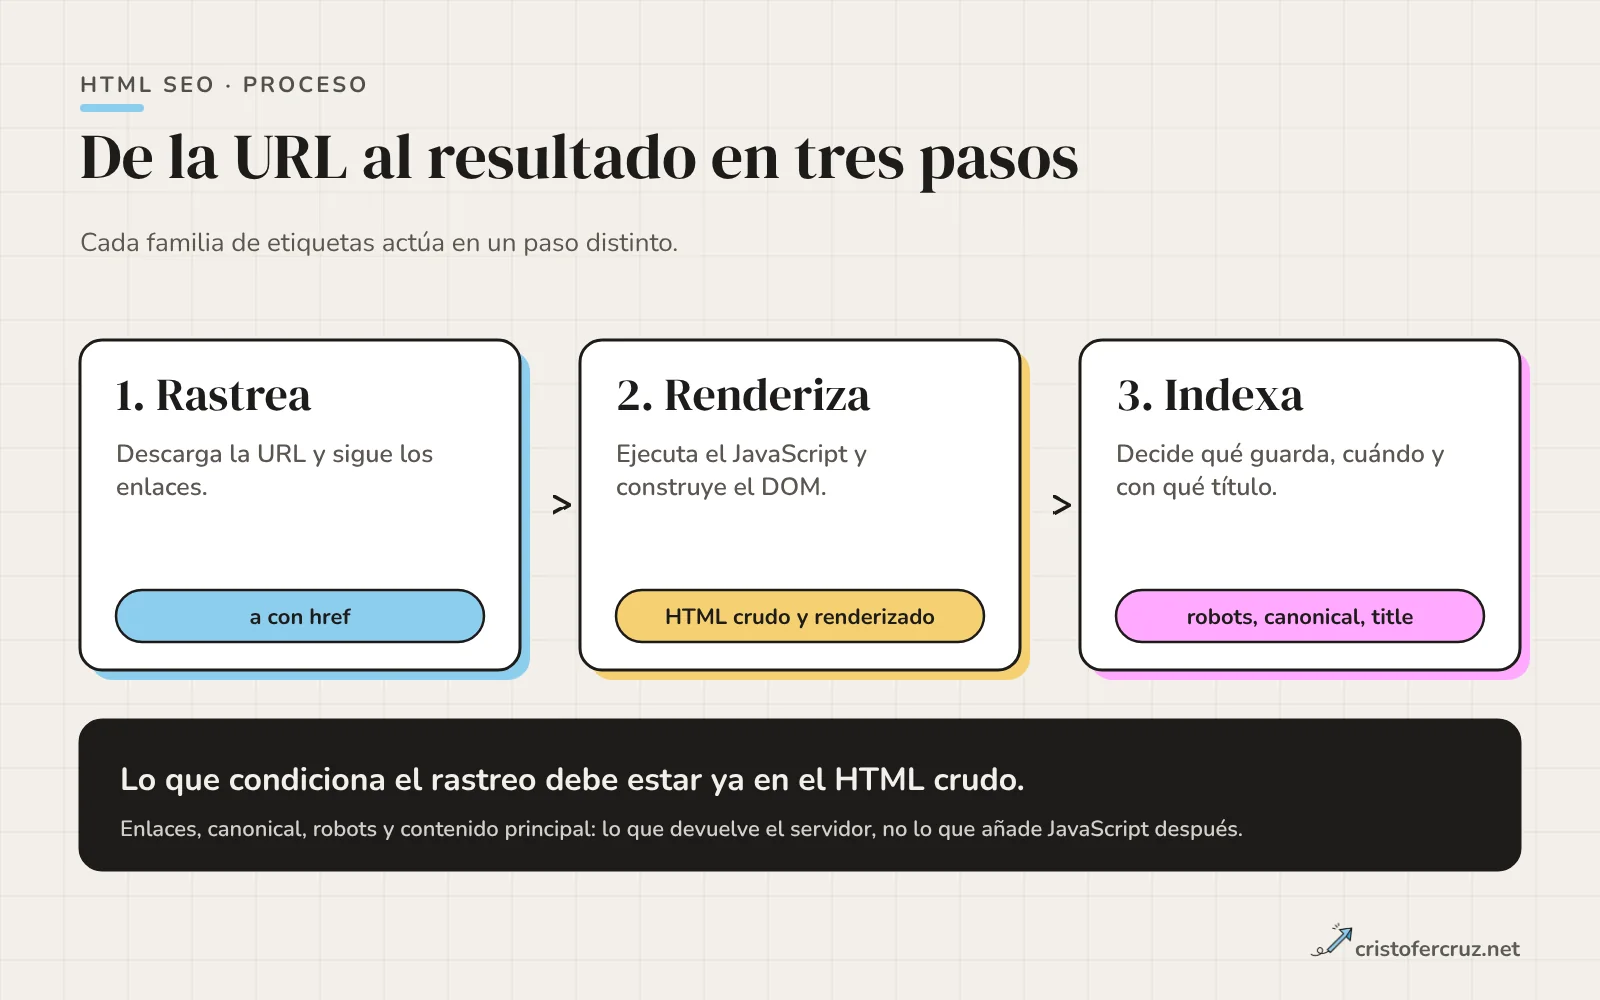
Google trabaja en tres pasos. Primero rastrea: descarga la URL y descubre otras a través de los enlaces. Después renderiza: ejecuta el JavaScript para ver la página como la vería un navegador. Por último indexa: decide qué guarda, cuándo lo muestra y con qué título y fragmento.
Cada familia de etiquetas actúa en un paso distinto. Los enlaces con href pesan en el rastreo, robots y canonical en la indexación, title y description en cómo se presenta el resultado. Un fallo en el primer paso, como un enlace que Google no puede seguir, deja sin efecto lo que venga después.
HTML crudo frente a HTML renderizado
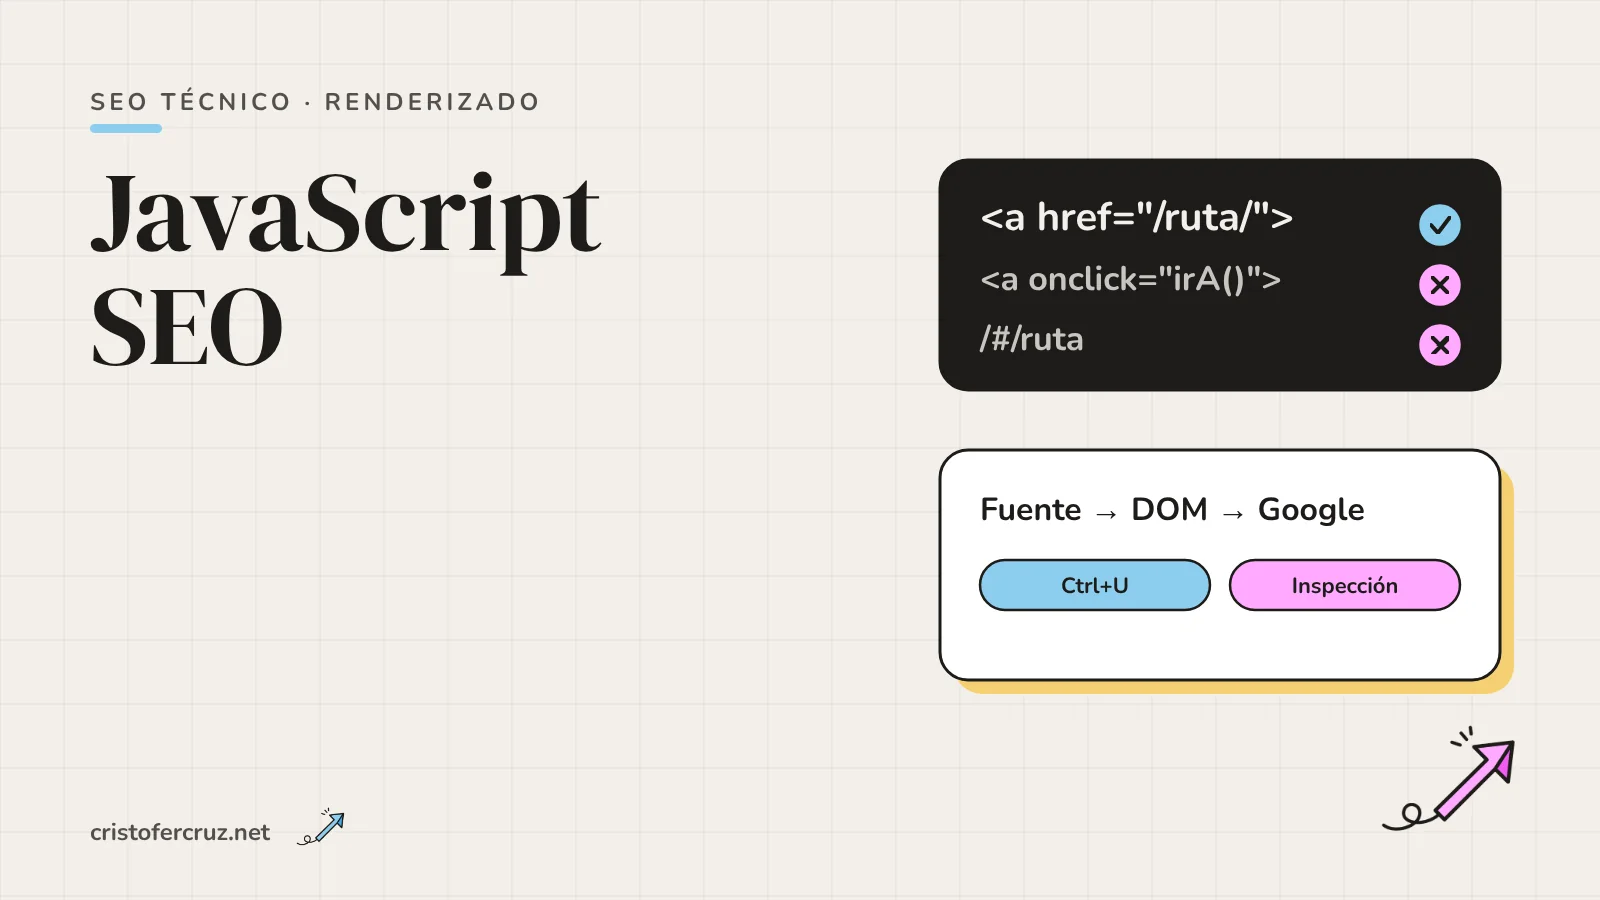
Hay dos versiones de tu HTML y conviene no mezclarlas. El HTML crudo es lo que devuelve el servidor y lo ves con "Ver código fuente" (view-source:). El HTML renderizado es el DOM final, después de ejecutar JavaScript, y lo ves en "Inspeccionar" del navegador.
Mi web genera el HTML en el servidor con PHP, así que las dos versiones se parecen mucho. En una aplicación que construye la página en el navegador pueden ser muy distintas. Por eso lo que condiciona el rastreo (enlaces, canonical, robots, el contenido principal) debe estar ya en el HTML crudo: si depende de JavaScript, Google puede ver la página más tarde o de otra forma. Ahrefs avisa, además, de que el código fuente no sirve para analizar sitios con mucho JavaScript, porque solo muestra la versión previa a la ejecución.
Si quieres profundizar en cuándo se genera el HTML, tengo dos guías: JavaScript SEO y la comparativa de CSR, SSR, SSG e ISR.
Etiquetas de control: deciden si la página entra en el índice
Un title flojo pierde visitas; un noindex olvidado hace desaparecer la página. Por eso empiezo por estas etiquetas.
Meta robots y X-Robots-Tag
La meta robots le dice a Google si puede indexar la página y seguir sus enlaces:
<meta name="robots" content="noindex, nofollow">Según la documentación de Google, si hay reglas en conflicto se aplica la más restrictiva, y el valor por defecto es index, follow. No hace falta escribir index, follow en cada página, y una sola regla restrictiva gana sobre todas las demás.
Bloquear una URL en robots.txt no impide que se indexe, y además Google no podrá leer el noindex si no puede rastrear la página. Para sacar una página del índice, usa noindex y deja que Google la rastree. La cabecera HTTP X-Robots-Tag hace lo mismo que la meta, pero sirve para ficheros que no son HTML, como PDF o imágenes. Tengo una guía de cada una: robots.txt y la cabecera X-Robots-Tag.
Me pasó con un cliente del sector travel: al migrar la web de preproducción a producción se arrastraron por defecto las directivas meta robots del entorno de pruebas, y 1.200 URLs salieron con noindex. No se detectó hasta siete días después del lanzamiento, al cruzar Search Console con un rastreo de Screaming Frog. Se corrigió cambiando las directivas meta robots a index, follow.
La etiqueta canonical
La canonical indica cuál es la URL preferida cuando el mismo contenido se puede abrir desde varias:
<link rel="canonical" href="https://cristofercruz.net/blog/html-seo/">Usa siempre una URL absoluta: Google no recomienda las relativas porque pueden dar problemas a largo plazo. En cada página indexable pongo una canonical que apunta a ella misma. Google la describe como una señal fuerte, no como una directiva: si la contradices con redirecciones, con enlaces internos o con el sitemap (una señal débil, según su documentación), puede elegir otra URL.
Los tres usos típicos son los parámetros de URL, las versiones con y sin barra final y el contenido republicado. Y hay tres cosas que evitar: apuntar a una URL que redirige, combinar canonical con noindex (Google lo desaconseja de forma explícita) y poner más de una canonical distinta en la misma página. El detalle está en mi guía de la etiqueta canonical, y la elección entre rutas completas o relativas, en URLs absolutas y relativas.
Enlaces rastreables: el elemento a con href
Es la etiqueta de la que depende el rastreo y suele quedar fuera de las listas de etiquetas SEO. Google explica que, normalmente, solo puede rastrear un enlace si es un elemento <a> con atributo href.
<!-- Google puede rastrearlo -->
<a href="/servicios/auditoria-seo/">Auditoría SEO</a>

<!-- Google puede no seguirlo de forma fiable -->
<a routerLink="/servicios/auditoria-seo/">Auditoría SEO</a>
<span href="/servicios/auditoria-seo/">Auditoría SEO</span>
<a onclick="irA('/servicios/auditoria-seo/')">Auditoría SEO</a>
Google dice que puede intentar interpretar los formatos del segundo bloque, pero no de forma fiable. Atributos como class u onclick no estorban si el <a> tiene href. El texto del enlace debe ser descriptivo y conciso, sin "haz clic aquí" ni "leer más". Si el enlace es una imagen, Google usa su alt como texto ancla. Y para marcar la naturaleza del enlace existen los valores rel: nofollow para fuentes en las que no confías, sponsored para enlaces de pago y ugc para contenido de usuarios.
El caso que más problemas da es la tarjeta clicable: una card entera envuelta en un enlace, o un div con un evento de clic. Lo explico en cómo enlazar una card box, y el panorama general del enlazado, en la guía de enlazado interno.
Viewport, charset y lang
Tres líneas del head que parecen menores:
<html lang="es">
<meta charset="utf-8">
<meta name="viewport" content="width=device-width, initial-scale=1">
La etiqueta viewport indica a Google que la página está pensada para móviles. Google recomienda usar Unicode, es decir, UTF-8. Y lang pide una aclaración: Google dice que detecta el idioma a partir del texto, no de ese atributo. Yo lo mantengo porque lo usan los lectores de pantalla y otros sistemas, pero no es hreflang, que es la señal que sí usa Google para decidir qué versión de idioma servir. Para esa parte, mira mi guía de hreflang y la de SEO móvil.
Etiquetas de descripción: deciden cómo se muestra tu página
Estas etiquetas cambian cómo te presenta Google: el título del resultado, el fragmento, la imagen. Un fallo aquí cuesta clics, no indexación.
La etiqueta title
<title>HTML SEO: etiquetas y HTML semántico que sí importan</title>Las recomendaciones de Google para el title son claras: uno por página, descriptivo y conciso, distinto en cada URL, con la marca de forma breve (al inicio o al final) y sin repetir palabras clave. Es el texto que Google puede usar como enlace azul del resultado, así que conviene escribirlo pensando en quien busca.
Lo más útil de su documentación es la lista de motivos por los que reescribe un título: está incompleto (solo el nombre del sitio), está obsoleto (un año que ya no coincide con la página), es inexacto, repite texto genérico en muchas páginas o no hay un título principal claro. Para construir el enlace puede usar también el h1, el og:title o el texto de los enlaces que apuntan a la página. Si tu title y tu h1 dicen cosas distintas, dejas que decida Google.
Sobre la longitud, unos 60 caracteres son una guía práctica para que no se corte en el resultado, no una regla de Google. El título de este post tiene 52 caracteres y mi plantilla añade "| Cristofer Cruz", así que el título completo llega a 69. En el rastreo que cuento más abajo, cinco páginas de mi web ya pasan de 60.
La meta description
<meta name="description" content="Qué etiquetas HTML usa Google, cuáles ignora y cómo aplicar HTML semántico sin mitos.">Google dice que puede usarla como fragmento del resultado, y la palabra clave es "puede": también puede sustituirla por texto de la propia página según la consulta. La escribo pensando en el clic y no en el ranking: una promesa breve de qué resuelve la página y qué va a encontrar quien entre, distinta en cada URL. Si quieres controlar qué partes del texto salen en el fragmento, existe data-nosnippet, que explico en cómo controlar qué texto de tu página sale en Google.
Encabezados H1 a H6
Muchas guías dan por hecho que una jerarquía perfecta de encabezados mejora el posicionamiento. Google dice en su guía de inicio de SEO que tener los encabezados en orden semántico es estupendo para los lectores de pantalla, pero que para Search no importa si se usan fuera de orden, y que tampoco hay un número ideal de encabezados.
Con eso hago tres cosas. Pongo un h1 visible y claro, porque Google lo usa para identificar el título principal de la página. Mantengo una jerarquía lógica, porque ayuda a quien lee y a quien navega con lector de pantalla. Y no elijo ningún encabezado por su tamaño de letra: para el tamaño está el CSS.
| Nivel | Para qué lo uso |
|---|---|
| h1 | El título de la página. Uno, visible y coherente con el title |
| h2 | Las grandes secciones. Cada una responde a una pregunta del lector |
| h3 | Subapartados dentro de un h2 |
| h4 a h6 | Casi nunca hacen falta |
Imágenes: alt, picture y loading
<picture>
  <source srcset="esquema-funciones.avif" type="image/avif">
  <source srcset="esquema-funciones.webp" type="image/webp">
  <img src="esquema-funciones.jpg" alt="Esquema de las cuatro funciones de una etiqueta HTML"
       width="1200" height="630" loading="lazy">
</picture>
Google define el alt como un texto corto pero descriptivo que explica la relación de la imagen con el contenido. Descríbela y no rellenes palabras clave. Para las imágenes puramente decorativas se deja alt="", una decisión que revisé en mi web y cuento más abajo. La etiqueta picture sirve para ofrecer formatos modernos con una alternativa.
loading="lazy" solo debe ir en imágenes que no se ven al cargar la página. Según web.dev, aplicarlo a imágenes visibles en la primera pantalla, incluida la posible imagen LCP, empeora el LCP: en su prueba con WordPress, las páginas de archivo perdieron entre un 13 % y un 15 %, y en las páginas individuales la diferencia fue neutral. Hay más en texto alternativo y en optimización de imágenes SEO.
Datos estructurados en JSON-LD
Los datos estructurados son marcado adicional que describe el contenido con un vocabulario común (schema.org). Google recomienda JSON-LD, un bloque de script independiente del HTML visible:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "HTML SEO: qué etiquetas y HTML semántico importan de verdad",
  "author": { "@type": "Person", "name": "Cristofer Cruz" },
  "datePublished": "2026-11-17"
}
</script>
Según Google, el marcado puede habilitar resultados enriquecidos, sin garantía de que aparezcan, y su documentación de introducción no dice nada sobre el ranking. Yo lo uso para dejar claro qué es la página y quién la firma, y compruebo que el marcado valida con la prueba de resultados enriquecidos. La explicación completa está en datos estructurados y schema markup, y el concepto de fondo, en entidades SEO.
HTML semántico y SEO: qué es cierto y qué es mito
Google dice en su guía de inicio de SEO que la web en general no es HTML válido y que el orden de los encabezados no importa para Search. De ahí sale lo que sí se puede afirmar del HTML semántico: no hay evidencia pública de que mueva posiciones, y sí la hay de que mejora la accesibilidad. Las guías se contradicen justo en ese punto, así que lo separo en cuatro partes.
Qué son las etiquetas semánticas y cuáles usar
Una etiqueta es semántica cuando su nombre dice qué es el contenido y no cómo se ve. Un div no dice nada; un nav dice "aquí está la navegación".
| Etiqueta | Qué marca | Dónde la pongo |
|---|---|---|
header | Cabecera de la página o de una sección | Logo y menú, o título y autor de un artículo |
nav | Bloque de navegación principal | Menú, migas de pan, índice |
main | El contenido principal, único por página | Envuelve lo que no se repite entre páginas |
article | Contenido que se entiende por sí solo | Un post, una ficha de caso |
section | Bloque temático con su propio encabezado | Cada gran apartado de una página |
aside | Contenido relacionado pero secundario | Notas laterales, artículos relacionados |
figure y figcaption | Imagen o ejemplo con su pie | Infografías y capturas |
time | Una fecha legible por máquinas | Fecha de publicación y actualización |
footer | Pie de página o de una sección | Enlaces legales, contacto |
El esqueleto de una página de blog queda así:
<body>
  <header>
    <nav>...</nav>
  </header>
  <main>
    <article>
      <h1>Título del post</h1>
      <p><time datetime="2026-11-17">17 nov. 2026</time></p>
      <section>
        <h2>Primer apartado</h2>
        <p>...</p>
      </section>
    </article>
    <aside>Artículos relacionados</aside>
  </main>
  <footer>...</footer>
</body>
Lo que importa es que cada etiqueta diga algo cierto. Un solo main por página y un nav bien etiquetado sirven más que usar las nueve etiquetas por usarlas.
Qué dice Google (y qué no dice)
Semrush afirma en su guía que las páginas con HTML semántico bien implementado tienen una ventaja competitiva de SEO, pero no aporta datos que lo respalden. Google, en su guía de inicio de SEO, dice dos cosas que van en dirección contraria: que el orden de los encabezados no importa para Search y que la web en general no es HTML válido, de modo que casi nunca puede apoyarse en el significado semántico oculto en la especificación.
No he encontrado evidencia pública de un efecto directo del HTML semántico en las posiciones. Lo que sí está documentado es su efecto en la accesibilidad. Si alguien te promete subir posiciones por cambiar un div por un section, pídele el dato.
Por qué usarlo igualmente
Por tres razones que no dependen de Google. La primera es la accesibilidad: los lectores de pantalla permiten saltar entre zonas de la página (cabecera, navegación, contenido) y entre encabezados, y sin esa estructura la página es una pared; lo desarrollo en accesibilidad web y SEO. La segunda es el mantenimiento: un HTML que dice lo que es se entiende y se cambia con menos errores. La tercera es la extracción por otros sistemas: lectores, herramientas y modelos de IA que segmentan el contenido se apoyan en la estructura. Es una hipótesis razonable, no un dato confirmado, y la trato como tal.
Errores habituales: div por todas partes, h1 por estilo, cards clicables
Tres errores, cada uno con su corrección:
<!-- 1. Un div donde va un encabezado -->
<div class="titulo">Contacto</div>
<h2>Contacto</h2>

<!-- 2. Un h1 elegido por su tamaño, no por su función -->
<h1 class="texto-pequeno">Contacto</h1>
<h2 class="texto-pequeno">Contacto</h2>

<!-- 3. Un div clicable en lugar de un enlace -->
<div onclick="irA('/contacto/')">Escríbeme por email</div>
<a href="/contacto/">Escríbeme por email</a>
A estos tres suma el de la card entera envuelta en un enlace con título, imagen y párrafo dentro: en pantalla se ve bien, pero produce un enlace con un texto enorme para quien usa lector de pantalla. Lo trato en cards clicables. Y cuidado con esconder contenido con CSS para "limpiar" el diseño: tengo notas sobre el contenido oculto con CSS.
Etiquetas y atributos que Google ignora o ha dejado de usar
Según la documentación de Google sobre etiquetas especiales, varias cosas que todavía se rellenan con esmero no te aportan nada en Search. La meta keywords no la usa y no tiene efecto en la indexación ni en el ranking. Los atributos rel="prev" y rel="next" ya no los utiliza para la paginación. La etiqueta nositelinkssearchbox no está soportada, porque la función dejó de existir. El idioma lo detecta por el texto y no por lang. Y cualquier meta que no soporte, la ignora.
Meta refresh es un caso aparte: Google recomienda sustituirla por una redirección 301 del lado del servidor. Tengo el detalle en meta refresh y http-equiv.
Si tu plugin o tu plantilla añade alguna de estas, no pasa nada por dejarlas. Lo que no merece es tiempo de trabajo rellenándolas.
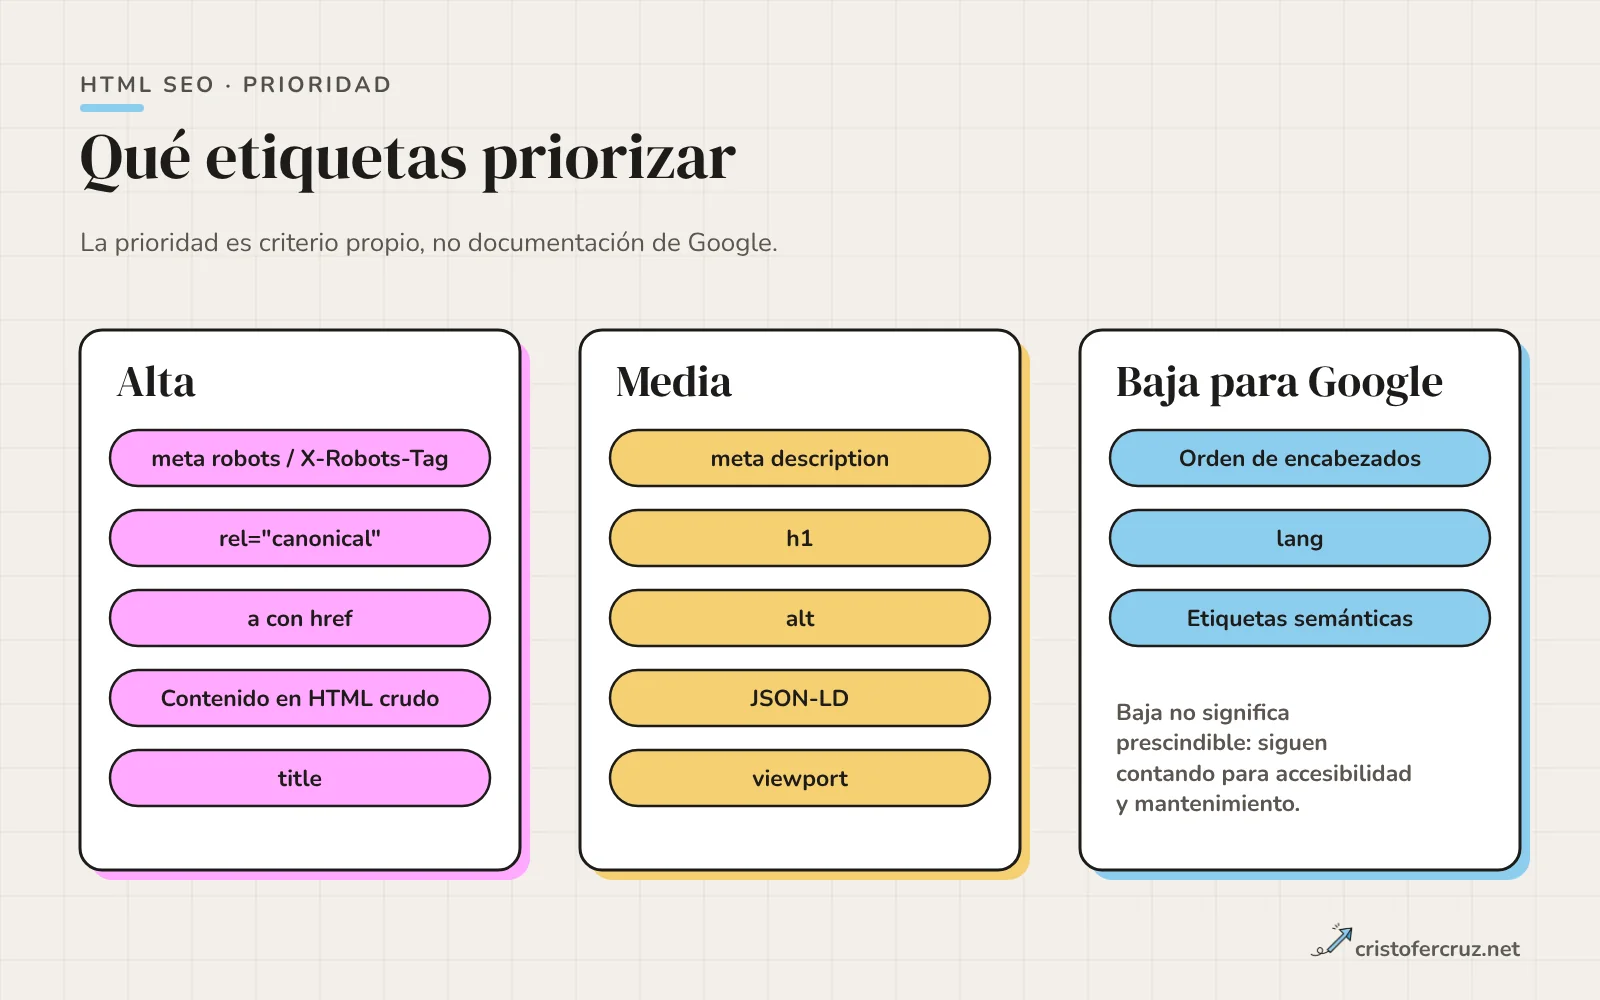
Qué etiquetas priorizar: matriz por función e impacto
La tabla ordena lo anterior por función y por lo que pasa si falla. La columna de prioridad es criterio mío, no de Google, y la dejo así marcada para que nadie la tome por documentación oficial.
| Etiqueta | Función | Qué confirma Google | Si falla | Prioridad |
|---|---|---|---|---|
| meta robots / X-Robots-Tag | Controla | Aplica la regla más restrictiva; por defecto index, follow | La página desaparece o se indexa lo que no debe | Alta |
rel="canonical" | Controla | Es una señal fuerte, no una directiva | Se indexa o se consolida la URL equivocada | Alta |
a con href | Enlaza | Solo rastrea de forma fiable enlaces con href | Google no descubre páginas | Alta |
| Contenido principal en el HTML crudo | Controla | Renderiza JavaScript, pero con matices | Indexación tardía o incompleta | Alta |
title | Describe | Puede reescribirlo si es pobre o inexacto | Título del resultado flojo | Alta |
| meta description | Describe | Puede usarla como fragmento | Menos clics | Media |
h1 | Describe | Lo usa para identificar el título principal | Google elige otro título | Media |
alt | Describe | Texto corto y descriptivo de la imagen | Pierdes contexto en las imágenes | Media |
| JSON-LD | Describe | Puede habilitar resultados enriquecidos, sin garantía | Sin elegibilidad para enriquecidos | Media |
viewport | Controla | Indica página apta para móvil | Experiencia móvil rota | Media |
| Orden de los encabezados | Ayuda a otros | No importa para Search | Peor accesibilidad, no ranking | Baja |
lang | Ayuda a otros | No lo usa para el idioma | Los lectores de pantalla pronuncian mal | Baja para Google |
| Etiquetas semánticas | Ayuda a otros | Sin efecto directo documentado | Accesibilidad y mantenimiento | Baja para Google |
Una prioridad baja para Google no convierte la etiqueta en prescindible: el orden de los encabezados y las etiquetas semánticas siguen contando para accesibilidad y mantenimiento.
Cómo auditar el HTML de tu web paso a paso
Son siete pasos, pensados para repetirlos después de cada despliegue:
- Compara el código fuente con el DOM renderizado. Abre
view-source:y la pestaña Elements de DevTools en la misma URL. Si lo importante solo aparece en la segunda, tienes un problema de renderizado. - Comprueba lo que ve Google. La inspección de URL de Search Console muestra el HTML renderizado y la canonical que Google ha elegido.
- Rastrea el sitio. Con Screaming Frog, Ahrefs o un script propio, extrae de cada URL el title, la meta description, los h1, la canonical y la meta robots.
- Extrae lo que el rastreador no trae por defecto. Con XPath o expresiones regulares localizas, por ejemplo, enlaces sin href o imágenes sin alt. Las consultas están en mi guía de XPath y regex para SEO.
- Revisa enlaces e imágenes. Cuenta los
<a>sin href y las imágenes sin atributo alt o con alt vacío, y decide cuáles son decorativas. - Valida el JSON-LD. Que se lea sin errores y que describa algo que está visible en la página.
- Repite tras cada despliegue. Un noindex o una canonical rota suelen llegar con una versión nueva.
Una consulta XPath para encontrar enlaces sin destino:
//a[not(@href) or normalize-space(@href)='']Lo que encontré al auditar cristofercruz.net
Para no quedarme en la teoría, pasé este mismo método a mi web. El 17 de noviembre de 2026 hice un rastreo con un script propio sobre las URLs de mis dos sitemaps (páginas y blog). Analicé 99 de las 100 URLs: una no devolvió respuesta durante el rastreo, aunque respondió bien al repetir la petición a mano, y la dejo fuera del recuento.
| Comprobación | Resultado |
|---|---|
| title y meta description presentes y sin duplicados | En las 99 páginas |
| Un solo h1 | En las 99 páginas |
| Saltos de nivel en los encabezados | Ninguno |
| Canonical autorreferente | En las 99 páginas |
| noindex | En ninguna |
lang="es" y viewport | En las 99 páginas |
| Un solo main por página | En las 99 páginas |
Enlaces <a> sin href | 0 de 12.984 |
| Imágenes sin atributo alt | 0 de 1.397 |
| JSON-LD que no se lee | Ninguno |
| Título completo (con marca) de más de 60 caracteres | 5 páginas, entre 61 y 70 |
| Meta description de más de 155 caracteres | 8 páginas, entre 156 y 160 |
| Imágenes con alt vacío | 710 de 1.397 |
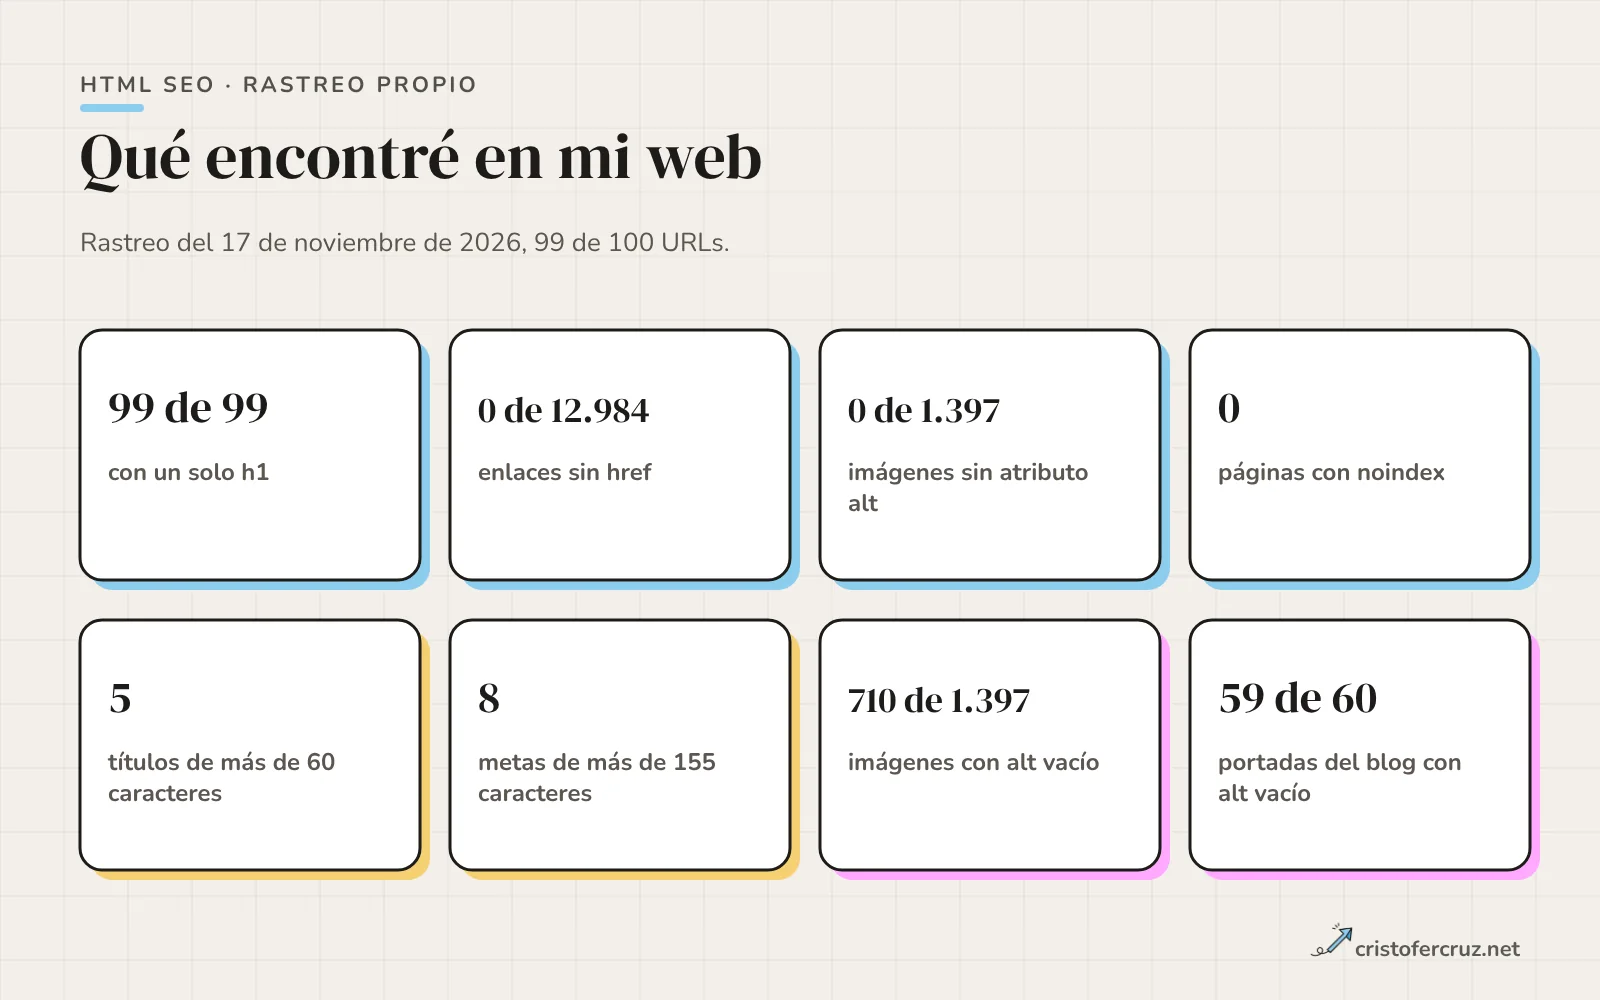
La estructura base está limpia: un h1, jerarquía sin saltos, canonical propia y ningún enlace sin href. Se explica por cómo está montada la web, con el HTML generado en el servidor con PHP, así que lo que ve Google en el código fuente es lo que hay.
Lo que no es un error pero voy a revisar son las imágenes con alt vacío. De las 710, buena parte son decorativas (avatares, flechas del diseño). Pero en 59 de las 60 URLs del sitemap del blog la portada del post lleva alt="". La portada acompaña al h1 y puede considerarse decorativa, aunque es la imagen principal de la página y tengo que decidir si merece una descripción.
El resto son recortes menores. Cinco títulos pasan de 60 caracteres cuando se suma la marca y ocho descripciones se pasan por entre uno y cinco caracteres. No son errores y son los únicos cortes que Google podría hacer en mi web.
Este rastreo mide el HTML, no el posicionamiento. No sé qué efecto tendrá corregir esos detalles y no voy a prometer ninguno. Si quieres que se haga este mismo análisis en tu web, forma parte de mi auditoría SEO técnica.
Preguntas frecuentes sobre HTML y SEO
¿El HTML válido es un factor de ranking?
Google no dice que lo sea. En su guía de inicio de SEO explica que la web en general no es HTML válido, por lo que no puede apoyarse en la semántica de la especificación. Validar el código ayuda a evitar errores de renderizado y a mantenerlo, pero no esperes subir posiciones solo por eso.
¿Cuántos H1 puede tener una página?
Google no fija un número. Yo pongo uno, visible y coherente con el title, porque Google lo usa para identificar el título principal. Si hay varios encabezados igual de prominentes, puede dudar de cuál es.
¿Qué etiquetas HTML son las más importantes para SEO?
Las que controlan la indexación y el rastreo: meta robots, rel="canonical" y los enlaces <a href>, junto con el title. Las demás importan, pero su fallo cuesta menos.
Referencias y fuentes
- Etiquetas meta y atributos que admite Google Google Search Central
- Title links Google Search Central
- Enlaces rastreables Google Search Central
- Guía de inicio de SEO Google Search Central
- Consolidar URLs duplicadas (canonical) Google Search Central
- Introducción a los datos estructurados Google Search Central
- Lazy loading de la imagen LCP web.dev
- Etiquetas HTML, guía básica Ahrefs
- HTML semántico Semrush