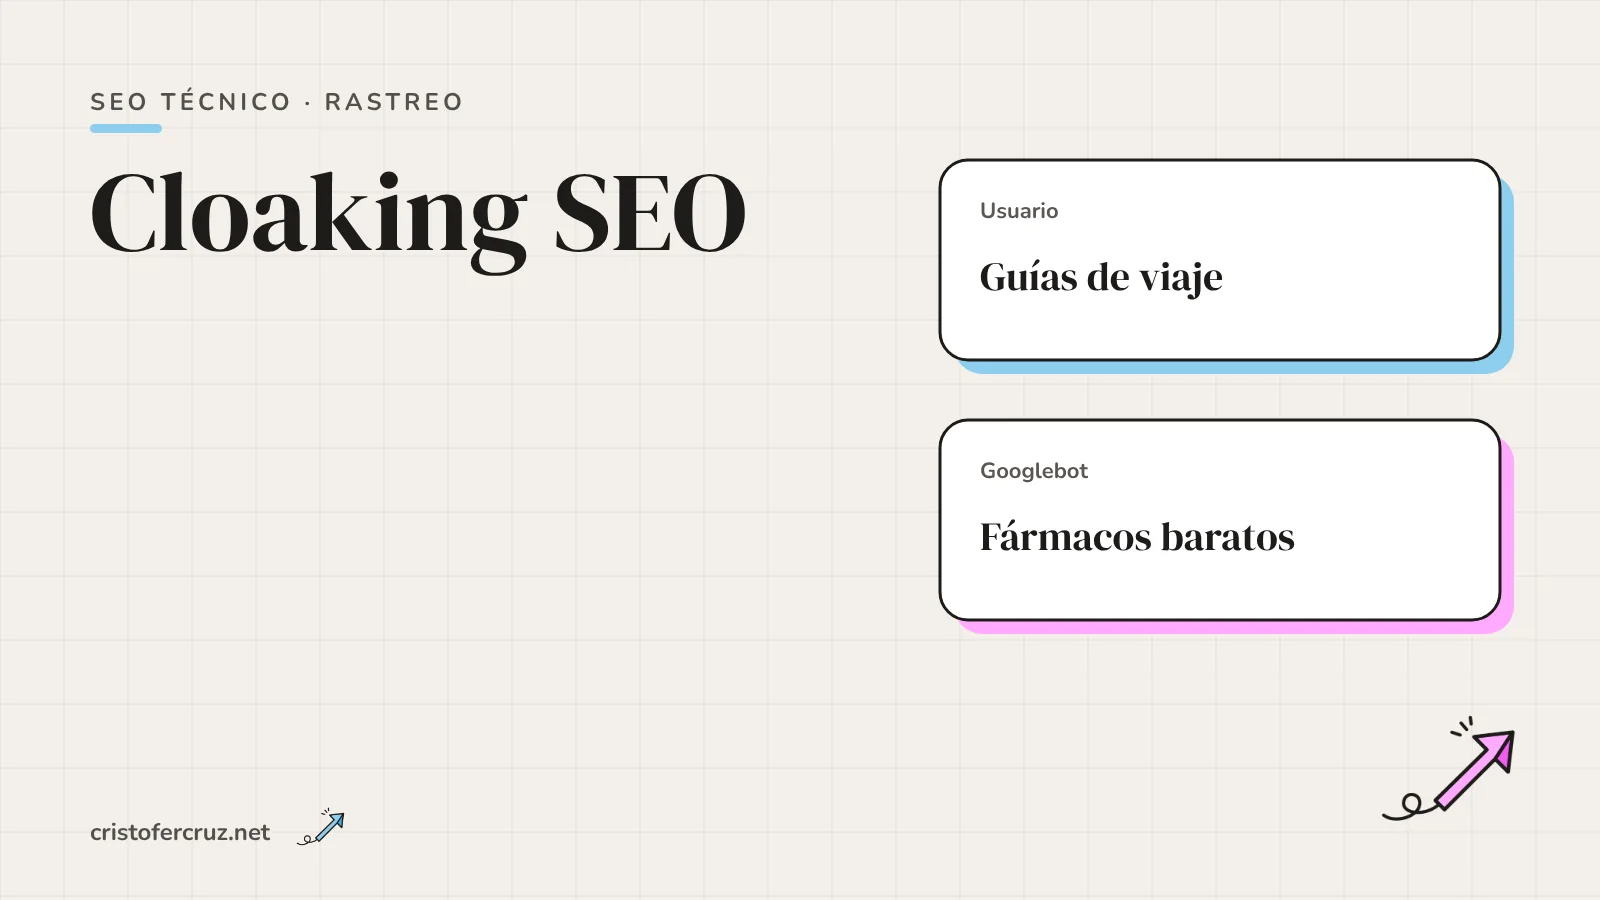
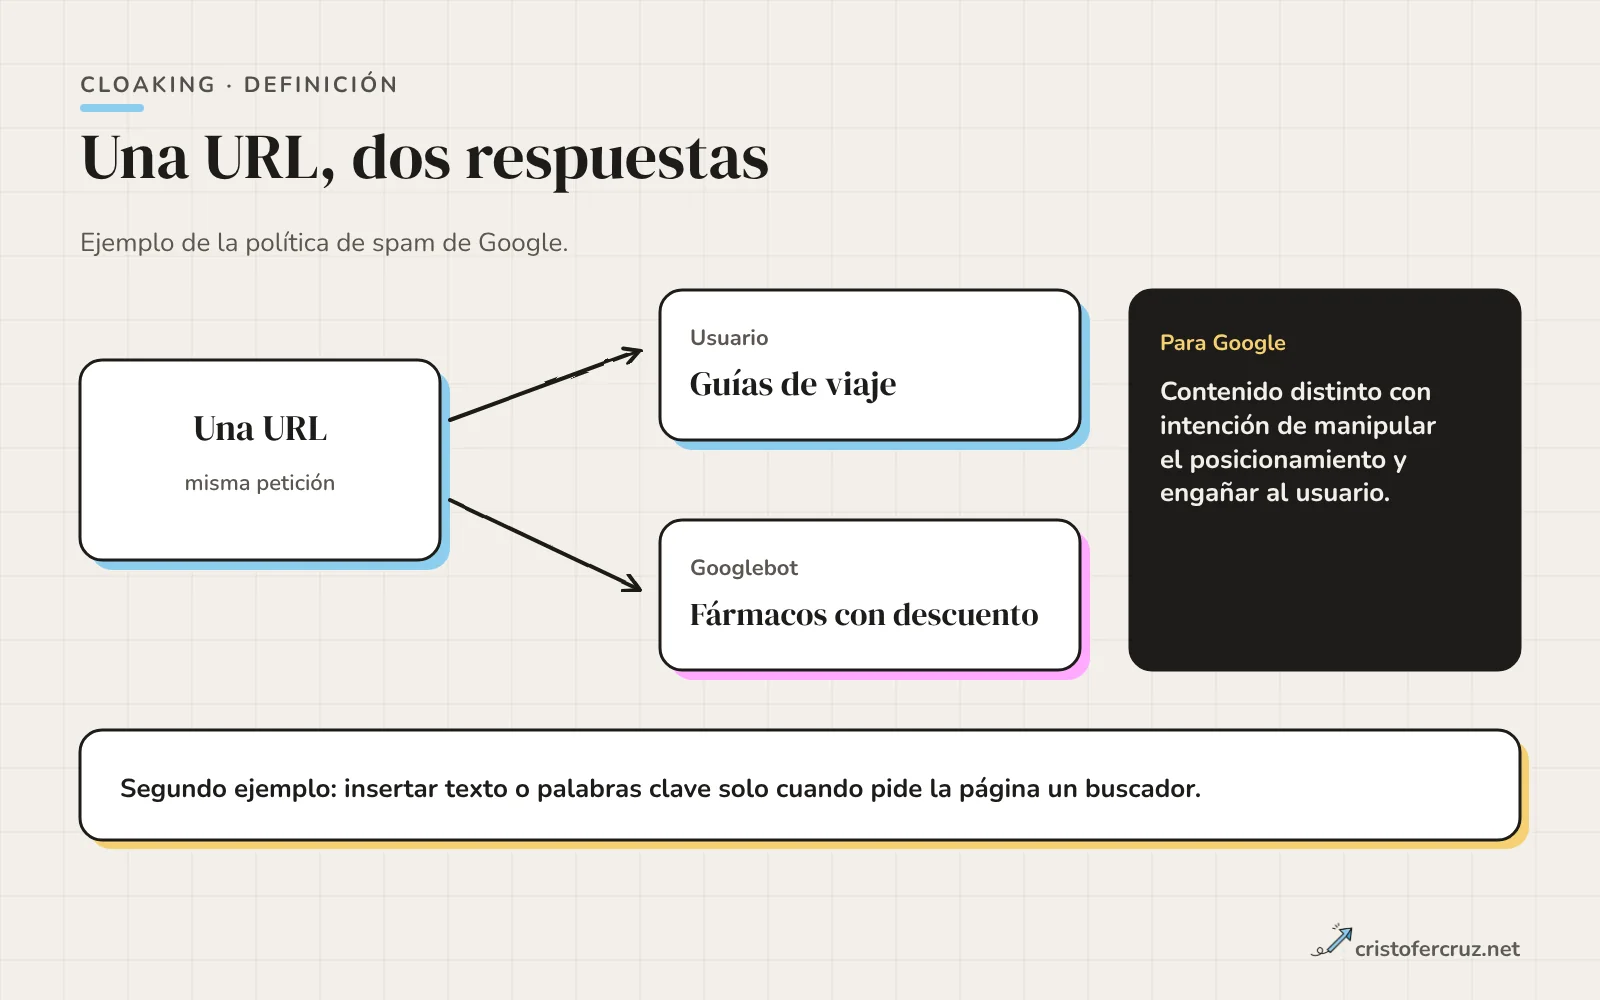
- Para Google, cloaking es presentar contenido distinto a los usuarios y a los buscadores con intención de manipular el posicionamiento. Lo que cuenta es la diferencia de contenido, no la técnica que la produce.
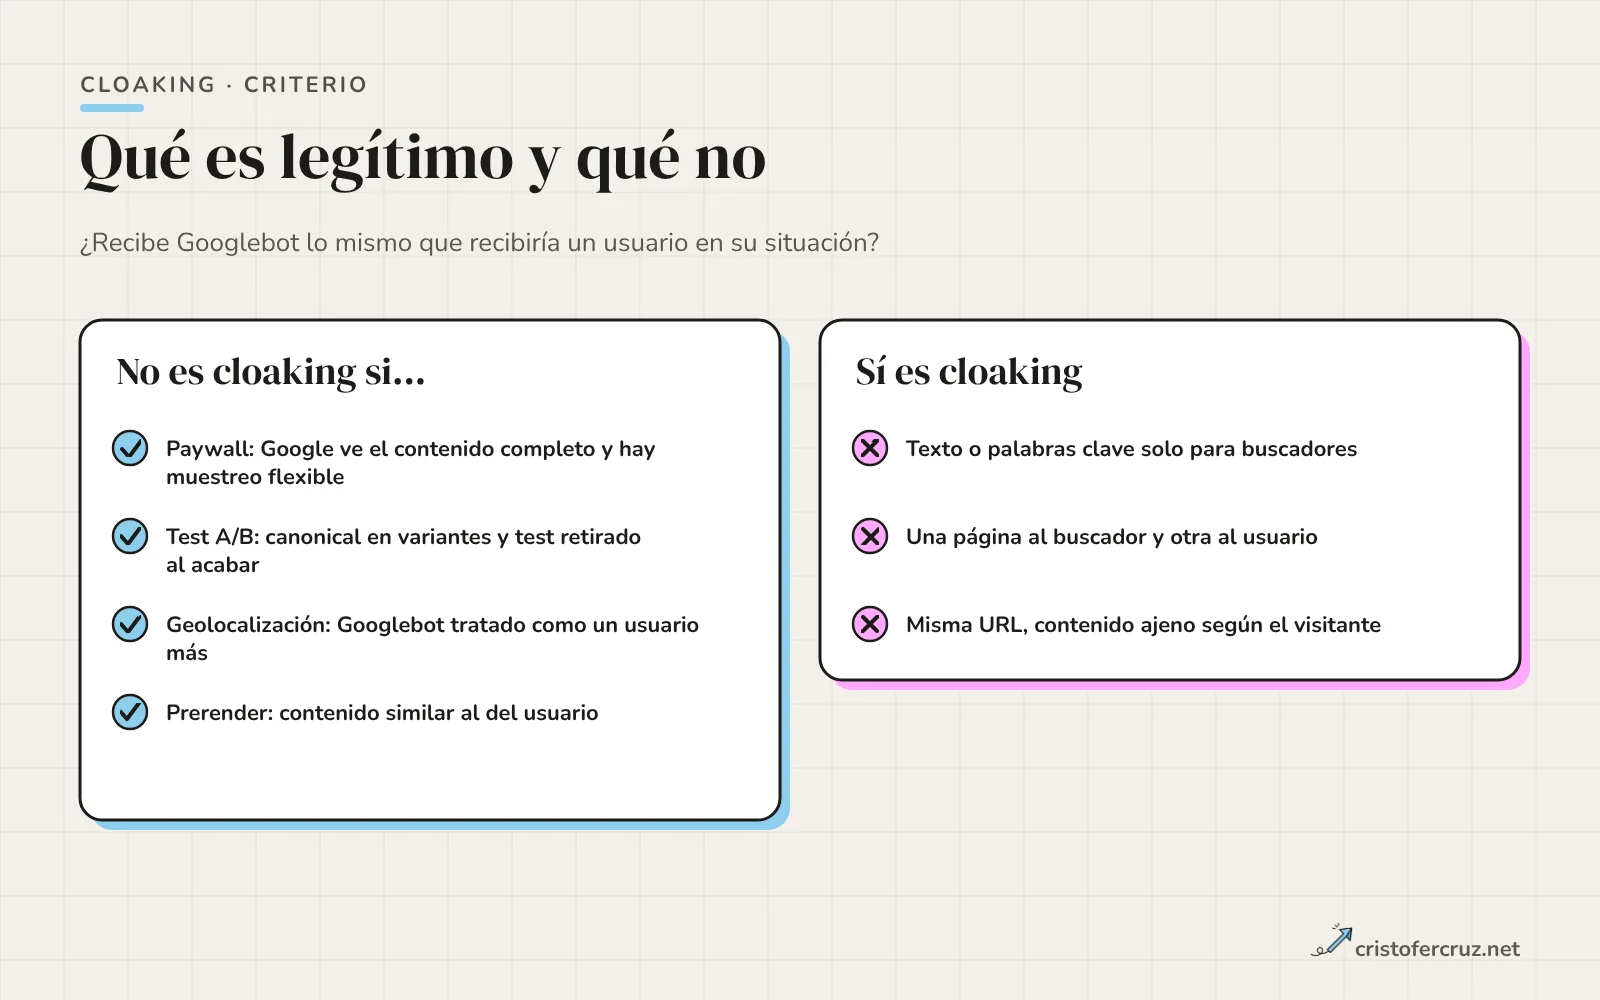
- Paywalls, A/B testing, personalización, geolocalización y prerenderizado no son cloaking mientras Googlebot reciba lo mismo que recibiría un usuario en su situación.
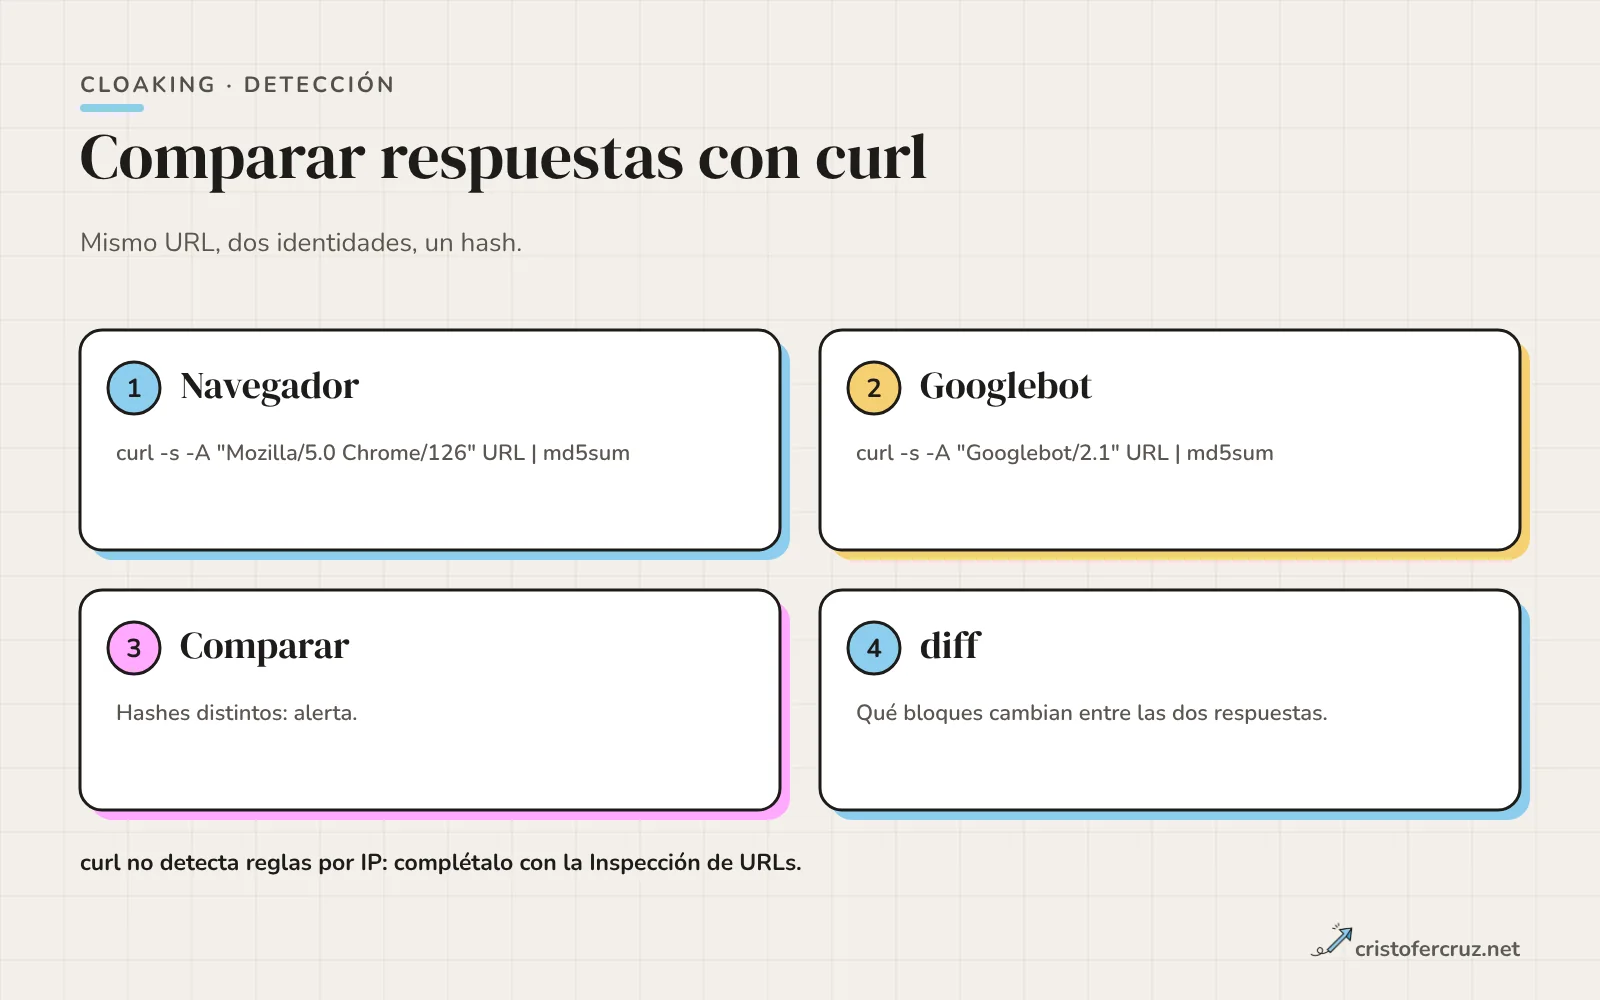
- La detección básica es comparar con
curl -Ael HTML que devuelve la misma URL con distintos user-agent, pero no detecta el cloaking por IP ni por referer. - El cloaking más habitual hoy es el de las webs hackeadas: páginas de farmacia o de texto japonés que solo ve el buscador y que el dueño no encuentra navegando.
- Una acción manual por cloaking se resuelve corrigiendo todas las páginas afectadas y enviando una solicitud de revisión desde Search Console.
- Servir una versión distinta a los bots de IA no está tratado en la documentación de Google. Hay opiniones, no una regla escrita.
Casi todo lo que se publica sobre cloaking se queda en la definición y en una lista de técnicas black hat. Lo que le pasa de verdad a un SEO es otra cosa: un cliente cuyo tráfico se hunde sin motivo, una web con miles de URLs de farmacia que nadie ve al navegar, o la duda legítima de si su paywall, su test A/B o su prerender cuentan como cloaking.
Aquí separo lo que Google define como cloaking de lo que no lo es, te enseño los comandos curl con los que lo compruebo (probados contra servidores de laboratorio con nginx y Apache), explico cómo se reconoce una web hackeada, qué pasa con una acción manual y qué hay documentado sobre servir contenido distinto a los bots de IA. Al final verifico mi propia web.
Qué es cloaking según Google
La política de spam de Google, en la sección «Cloaking», lo define como la práctica de presentar contenido distinto a los usuarios y a los buscadores con la intención de manipular el posicionamiento y engañar a los usuarios. Pone dos ejemplos, y los dos son muy concretos:
- Mostrar a los buscadores una página sobre destinos de viaje y a los usuarios una página sobre fármacos con descuento.
- Insertar texto o palabras clave en una página solo cuando quien la solicita es un buscador y no una persona.
La misma sección aclara dos cosas más. Si una web usa tecnologías que los buscadores no leen bien, como JavaScript o imágenes, Google recomienda que buscadores y usuarios accedan al mismo contenido. Y un paywall no se considera cloaking si Google puede ver el contenido completo y se siguen sus directrices de muestreo flexible. Desde el punto de vista práctico, la definición tiene dos partes: hay una diferencia de contenido entre lo que ve el buscador y lo que ve el usuario, y hay un propósito engañoso.
La segunda parte no la mide ninguna herramienta; la primera sí: dada una URL, qué bytes recibe cada cliente. Por eso la auditoría de este artículo trabaja sobre diferencias de respuesta y la interpretación («¿es engañoso?») es un juicio posterior.
Cómo se implementa: user-agent, IP, referer y cookies
Servir algo distinto exige que el servidor distinga al visitante. Google no publica un catálogo de técnicas, así que lo que sigue sale de lo que he montado y probado en el laboratorio de este artículo, no de una lista oficial.
| Señal | Cómo decide el servidor | Lo detecta curl -A |
|---|---|---|
| User-agent | Compara la cabecera User-Agent con «Googlebot», «bingbot»… | Sí, si usas el mismo texto |
| Dirección IP | Consulta si la IP pertenece a rangos de buscadores | No: tu IP no es la de Google |
| Referer | Sirve otra cosa a quien llega desde un resultado de Google | No, salvo que añadas -e |
| Cookies o sesión | Cambia el contenido si no hay cookie previa | Solo si replicas la cookie |
| JavaScript en cliente | Un script inserta o retira bloques según condiciones del navegador | No: curl no ejecuta JS |
El caso más simple es el de user-agent. En mi laboratorio de nginx basta un map sobre $http_user_agent que envía a una página distinta si contiene «googlebot». En Apache lo hace un .htaccess con mod_rewrite, que es además el sitio donde más veces lo he visto en webs infectadas:
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} (googlebot|bingbot) [NC,OR]
RewriteCond %{HTTP_REFERER} ^https?://([^/]+\.)?google\. [NC]
RewriteCond %{REQUEST_URI} ^/$
RewriteRule ^$ /spam.html [L]
La segunda condición es la que hace útil el ejemplo: el spam sale también para quien llega desde Google, así que el dueño que escribe la URL a mano nunca lo ve.
Qué es legítimo y qué no
La duda que más me llega no es sobre webs de farmacia sino sobre casos de negocio normales. Mi regla: si Googlebot recibe lo mismo que recibiría un usuario real en su situación, no hay diferencia de contenido que manipule.
| Situación | ¿Cloaking? | Condición según la documentación de Google |
|---|---|---|
| Paywall o contenido de suscripción | No | Google ve el contenido completo y se siguen las directrices de muestreo flexible; marcado con datos estructurados |
| Test A/B | No | No mostrar URLs distintas a Googlebot, usar rel="canonical" en las variantes y retirar el test cuando acabe |
| Personalización y geolocalización | No, si Googlebot se trata como cualquier otro visitante | Tratarlo como a cualquier usuario del país desde el que rastrea |
| Prerenderizado o dynamic rendering | No, si el contenido es similar | Google lo ve como un workaround, no como solución a largo plazo |
| Texto o enlaces solo para bots | Sí | Ejemplo explícito de la política de spam |
| Una página al bot y otra al usuario | Sí | Ejemplo explícito de la política de spam |
Paywalls y contenido de suscripción
Google documenta dos piezas. La guía de muestreo flexible recomienda un modelo medido (unos artículos gratis) o un adelanto con las primeras frases. La documentación de datos estructurados para contenido de pago explica el marcado: isAccessibleForFree en false, más un hasPart de tipo WebPageElement con un cssSelector que apunta al bloque de pago. Según esa página, ayuda a Google a distinguir el contenido de pago del cloaking. Y si el contenido de pago no debe llegar al navegador, elige un paywall que no lo envíe: ocultarlo con CSS sobre un HTML que ya lo trae es otra cosa.
Test A/B, geolocalización y personalización
La documentación sobre pruebas de sitio dice que mostrar URLs distintas a Googlebot que a las personas es cloaking, contrario a sus políticas de spam, tanto si lo haces «por lógica de servidor o por robots.txt, o cualquier otro método». Para las variantes recomienda rel="canonical" hacia la original en lugar de un noindex, un redirect 302 (no 301) si rediriges a variantes, y retirar los elementos del test en cuanto acabe: un experimento que dure más de lo necesario puede interpretarse como un intento de engañar a los buscadores.
Para geolocalización e idioma, la página de Google sobre páginas adaptables a la configuración regional dice que Googlebot parece rastrear desde IP de Estados Unidos y sin Accept-Language. No menciona la palabra cloaking; su alternativa preferida son URLs separadas por configuración regional con hreflang, que ya traté en el artículo de hreflang.
Prerender y dynamic rendering
Servir a los bots HTML ya renderizado y a los usuarios la aplicación de JavaScript implica detectar al bot por user-agent, o sea, la misma mecánica del cloaking. Google lo aborda en la documentación de dynamic rendering: según su texto, Googlebot generalmente no lo considera cloaking, siempre que el contenido sea similar. Y avisa de que servir contenido distinto, su ejemplo es una página de gatos para usuarios y otra de perros para el rastreador, sí puede considerarse cloaking. La misma página lo llama «un workaround y no una solución a largo plazo».
Si hoy dependes de un servicio de prerender, la pregunta de cumplimiento es si el HTML de los bots contiene lo mismo que el DOM final del usuario; la de diseño es cómo salir, y para eso están mi guía de JavaScript y SEO y la comparativa de estrategias de renderizado.
Cómo se detecta con curl y distintos user-agent
El método más rápido es pedir la misma URL con dos identidades y comparar lo que llega. Con el laboratorio de nginx de antes, estos fueron los resultados reales:
$ for ua in "Mozilla/5.0 Chrome/126" \
    "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" \
    "curl/8.5.0"; do
    printf '%s  ' "$ua"; curl -s -A "$ua" http://127.0.0.1:8347/ | md5sum
  done
Mozilla/5.0 Chrome/126  8d52b06d442c2035a0010a414f42d806  -
Mozilla/5.0 (compatible; Googlebot/2.1; ...)  c3648311be6a6973fecee4d023515fc5  -
curl/8.5.0  8d52b06d442c2035a0010a414f42d806  -
Dos hashes distintos ya son una alerta, y con diff ves qué cambia (en el laboratorio, un título de guías de viaje frente a otro de fármacos baratos). También probé el mismo servidor con un user-agent de GPTBot: devolvió el hash de la versión de usuario, porque mi regla solo reconoce «googlebot». Un cloaking por user-agent solo se ve con el user-agent que el atacante programó.
Lo que curl no ve
Con el Apache del laboratorio repetí la prueba con la regla de referer, sobre la misma URL:
| Petición | Página recibida |
|---|---|
curl sin más | Guías de viaje (limpia) |
curl -A Googlebot/2.1 | Fármacos con descuento (spam) |
curl -e https://www.google.es/ | Fármacos con descuento (spam) |
curl -A "Mozilla/5.0 (compatible; bingbot/2.0)" | Fármacos con descuento (spam) |
La lección es que cada prueba solo descarta la señal que has probado. Un curl normal te da una web limpia aunque el servidor esté infectado, y un curl -A Googlebot no detecta una regla que dependa de la IP. Si el atacante filtra por rangos de IP de Google, que publica sus rangos en JSON y permite verificar a los rastreadores por DNS inverso, ningún curl desde tu máquina lo reproducirá. Los métodos de verificación los explico en el artículo sobre análisis de logs SEO, y es la misma idea al revés: el user-agent es texto que cualquiera escribe.
Por eso combino tres fuentes y no me fío de una sola:
- curl con varias señales (user-agent, referer,
Accept-Language) y comparación de hashes. - Inspección de URLs en Search Console, con «Probar URL publicada» y «Ver página probada», que muestra lo que ve Google desde sus propias IP. Es el único test que no se puede esquivar filtrando por IP. Ojo: los nombres de los botones en la interfaz pueden variar con las actualizaciones.
- Búsquedas
site:en Google para encontrar URLs que no has creado. La copia en caché de Google ya no existe, así que no cuentes con ella.
Cloaking en webs hackeadas: el caso real más frecuente
Cuando alguien me trae una web con «una caída inexplicable», lo más probable no es una decisión de marketing sino una infección. Google lo dice en la política de spam: los hackers suelen usar el cloaking para que al propietario le cueste más detectar el problema. Sus dos guías sobre este hackeo (en web.dev) describen:
- Cloaked keywords and links hack: genera automáticamente muchas páginas con texto, enlaces e imágenes sin sentido, para manipular el posicionamiento.
- Japanese keyword hack: crea páginas con texto japonés autogenerado en directorios con nombres aleatorios (el ejemplo de la guía es
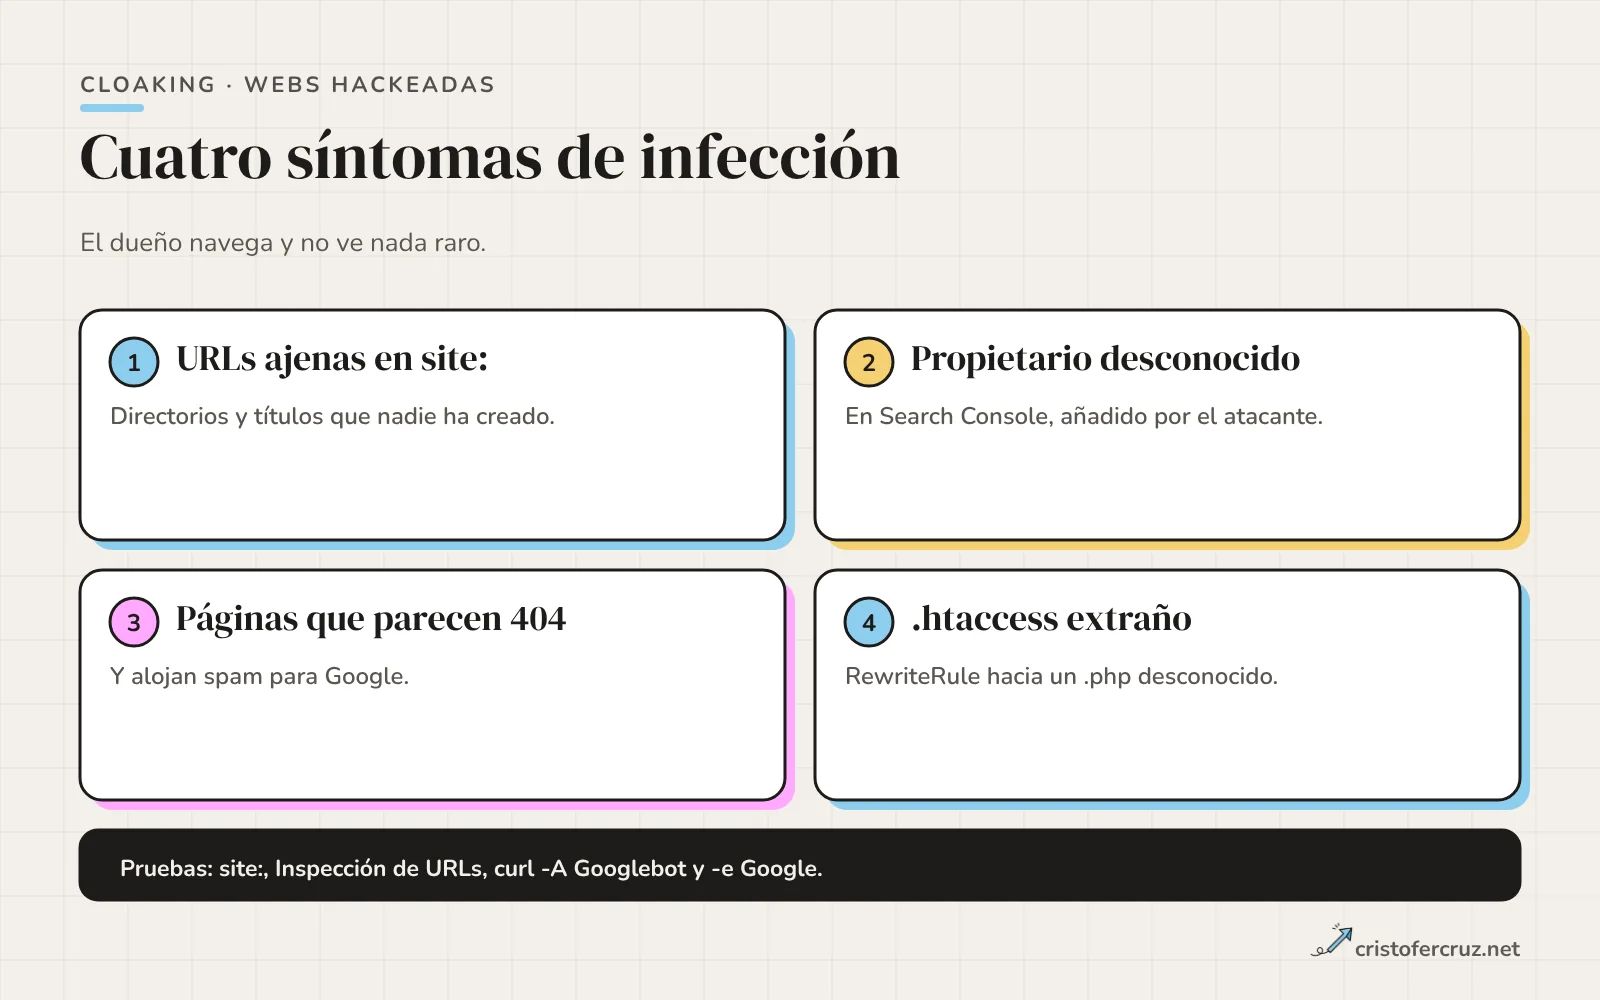
example.com/ltjmnjp/341.html), con enlaces de afiliado a tiendas de mercancía falsificada. Los atacantes pueden además añadirse como propietarios en Search Console, y algunas páginas hackeadas parecen un 404 (truco que la guía llama cloaking).
Qué miro primero
- El informe de problemas de seguridad de Search Console y la lista de propietarios verificados: si hay uno que no reconoces, es un síntoma que la propia guía incluye.
- Una búsqueda
site:tudominio.comy recorrer varias páginas de resultados en busca de URLs, directorios o títulos que no son tuyos. Google sugiere probar también con otro buscador. - La Inspección de URLs sobre esas URLs sospechosas para ver el contenido real que recibe Google.
- Los códigos de respuesta de esas URLs, porque una página «not found» para ti y con spam para Google es el truco que describe la guía.
- Los
.htaccess(reglasRewriteRulehacia un.phpdesconocido), y archivos comoindex.php,404.phpowp-load.phpcon código ofuscado (base64_decode,eval,gzinflate).
La limpieza que recomienda Google sigue un orden: copia de seguridad, .htaccess limpios, reinstalar núcleo, temas y plugins, borrar archivos sospechosos, limpiar sitemaps, quitar propietarios desconocidos y comprobar con la Inspección de URLs que el spam devuelve «No encontrado». Sin cerrar la vulnerabilidad de origen, la reinfección es probable.
Consecuencias y cómo salir de una acción manual
La política general dice que las webs que la incumplen pueden posicionar peor o no aparecer, y que la detección combina sistemas automáticos con revisión humana que puede acabar en acción manual. La ayuda de Search Console lista una categoría «Cloaking and/or sneaky redirects» y, por separado, la de problemas graves de spam, que cita el cloaking en casos de «infracciones repetidas o flagrantes». Cito los nombres en inglés porque no he podido comprobar la versión en español.
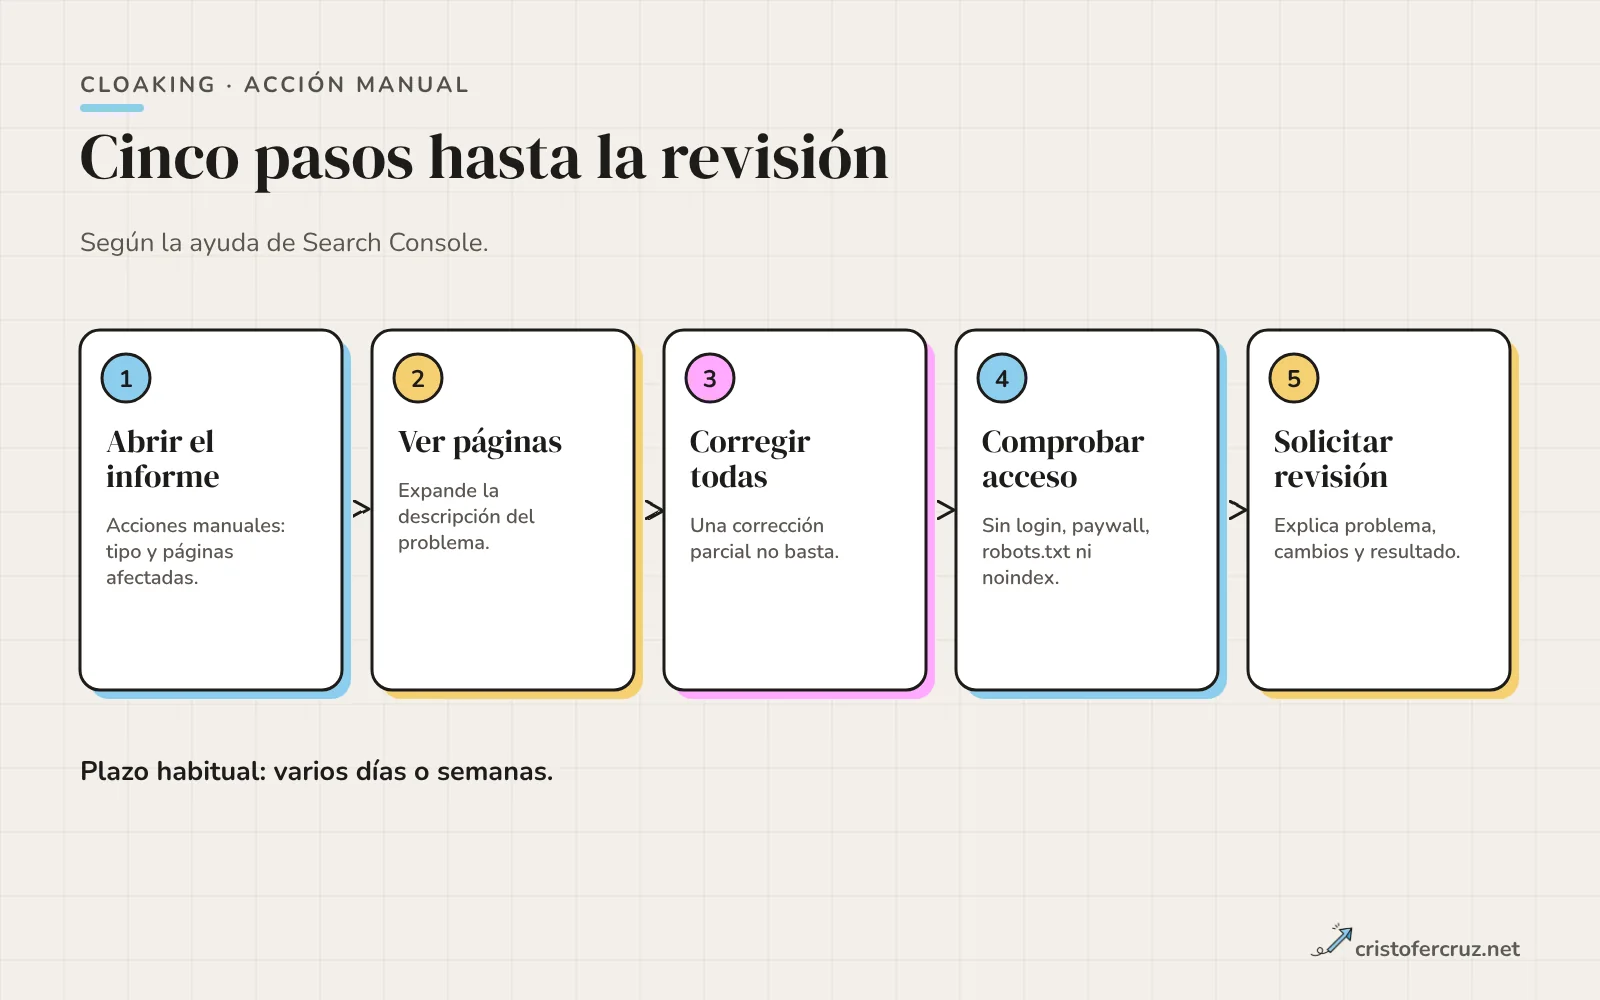
El proceso documentado para salir es este:
- Abre el informe de acciones manuales y expande la descripción: indica el tipo de problema y las páginas afectadas.
- Corrige todas las páginas afectadas. Según la ayuda, una corrección parcial no devuelve parcialmente a los resultados.
- Comprueba que Google puede acceder a ellas, sin inicio de sesión, paywall ni bloqueos por robots.txt o noindex, algo que puedes probar con la Inspección de URLs.
- Pulsa «Solicitar revisión» y explica el problema concreto, qué has hecho y el resultado.
Los plazos: la ayuda dice que la mayoría de revisiones tardan «varios días o semanas», y las vinculadas a enlaces, más. Google envía correo al recibir la solicitud y al terminar la revisión. El proceso completo, del diagnóstico a la solicitud, es lo que hago en recuperación de penalizaciones.
Una acción manual no es la única consecuencia: la política habla de posicionar peor sin acción manual, y eso no lo notifica nadie. Si el tráfico cae sin mensaje en Search Console, el cloaking sigue siendo una hipótesis por verificar.
Bots de IA y user-agent: ¿servirles otro contenido es cloaking?
Hay tres hechos y una pregunta abierta. Hechos: la política de spam de Google define el cloaking respecto a usuarios y buscadores; los rastreadores de IA se identifican con user-agent propios (los documenté en la sección de bots del artículo de logs); y el user-agent es una cabecera que cualquiera puede falsificar. Pregunta abierta: si servir una versión simplificada a esos bots es cloaking.
Lo que he encontrado, con fecha y con el límite de lo que dicen:
- En febrero de 2026, Search Engine Land recogió que John Mueller no tenía constancia de nada que respalde servir páginas separadas en Markdown a los LLM, y que Bing (Fabrice Canel) señaló que las versiones que no ve ningún usuario suelen estar descuidadas o rotas. El autor del artículo escribe que servir una versión a los LLM y otra a los usuarios «técnicamente podría considerarse una forma de cloaking», y cita a Lily Ray llamándolo «básicamente cloaking». Es una lectura del medio, no una declaración de política de Google.
- En agosto de 2025, Cloudflare acusó a Perplexity de usar un agente no declarado que se presentaba como un Chrome 124 en Mac cuando se bloqueaban sus user-agent oficiales, PerplexityBot y Perplexity-User. Perplexity respondió que Cloudflare confundía sus asistentes iniciados por usuarios con rastreadores. Lo cito como ejemplo de por qué el user-agent no identifica nada de forma fiable, no como veredicto.
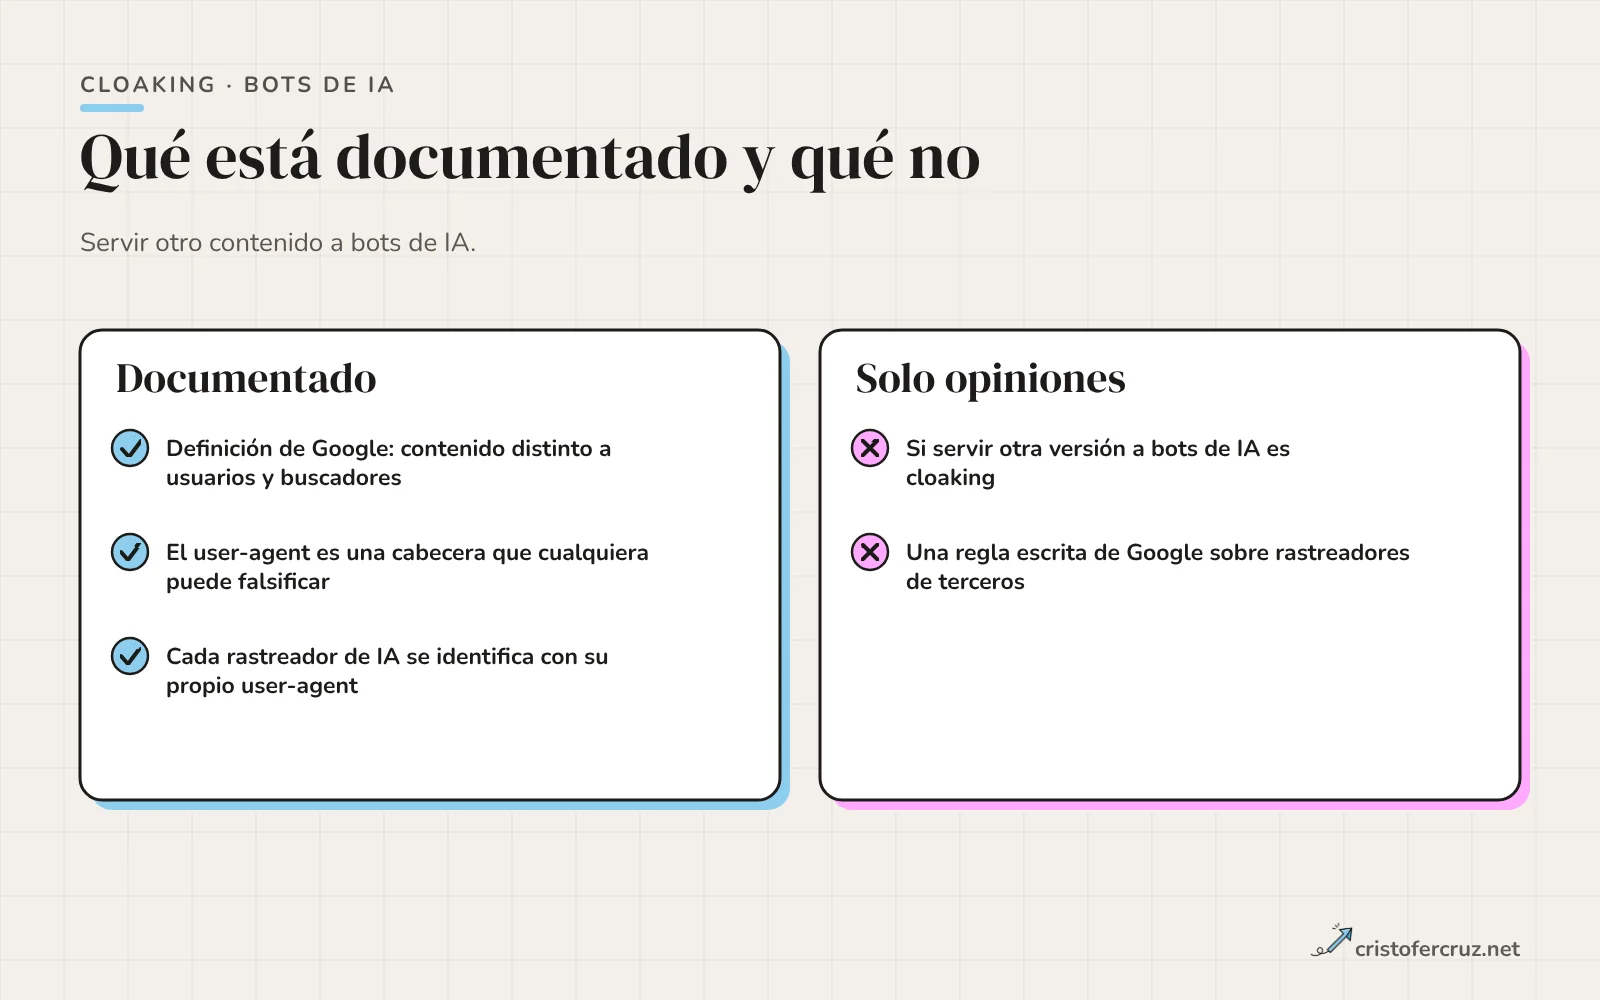
Mi criterio, que es una interpretación y no una norma escrita: decidir qué bots entran (con robots.txt, cabeceras o bloqueos por IP verificada) es control de acceso, y no veo ahí contenido distinto. Dar a los bots de IA un texto que no existe para los usuarios es la situación que la política describe para los buscadores, y además es un riesgo operativo: esa versión se queda sin mantener. Si lo que buscas es que los modelos te citen, el trabajo útil está en el contenido y en la estructura de la página pública, y eso lo desarrollo en cómo posicionar en buscadores de IA.
Cómo lo tengo yo: una única respuesta para todos
Esto es lo que he verificado sobre cristofercruz.net, en el servidor de desarrollo local (PHP 8.3) con el código del sitio.
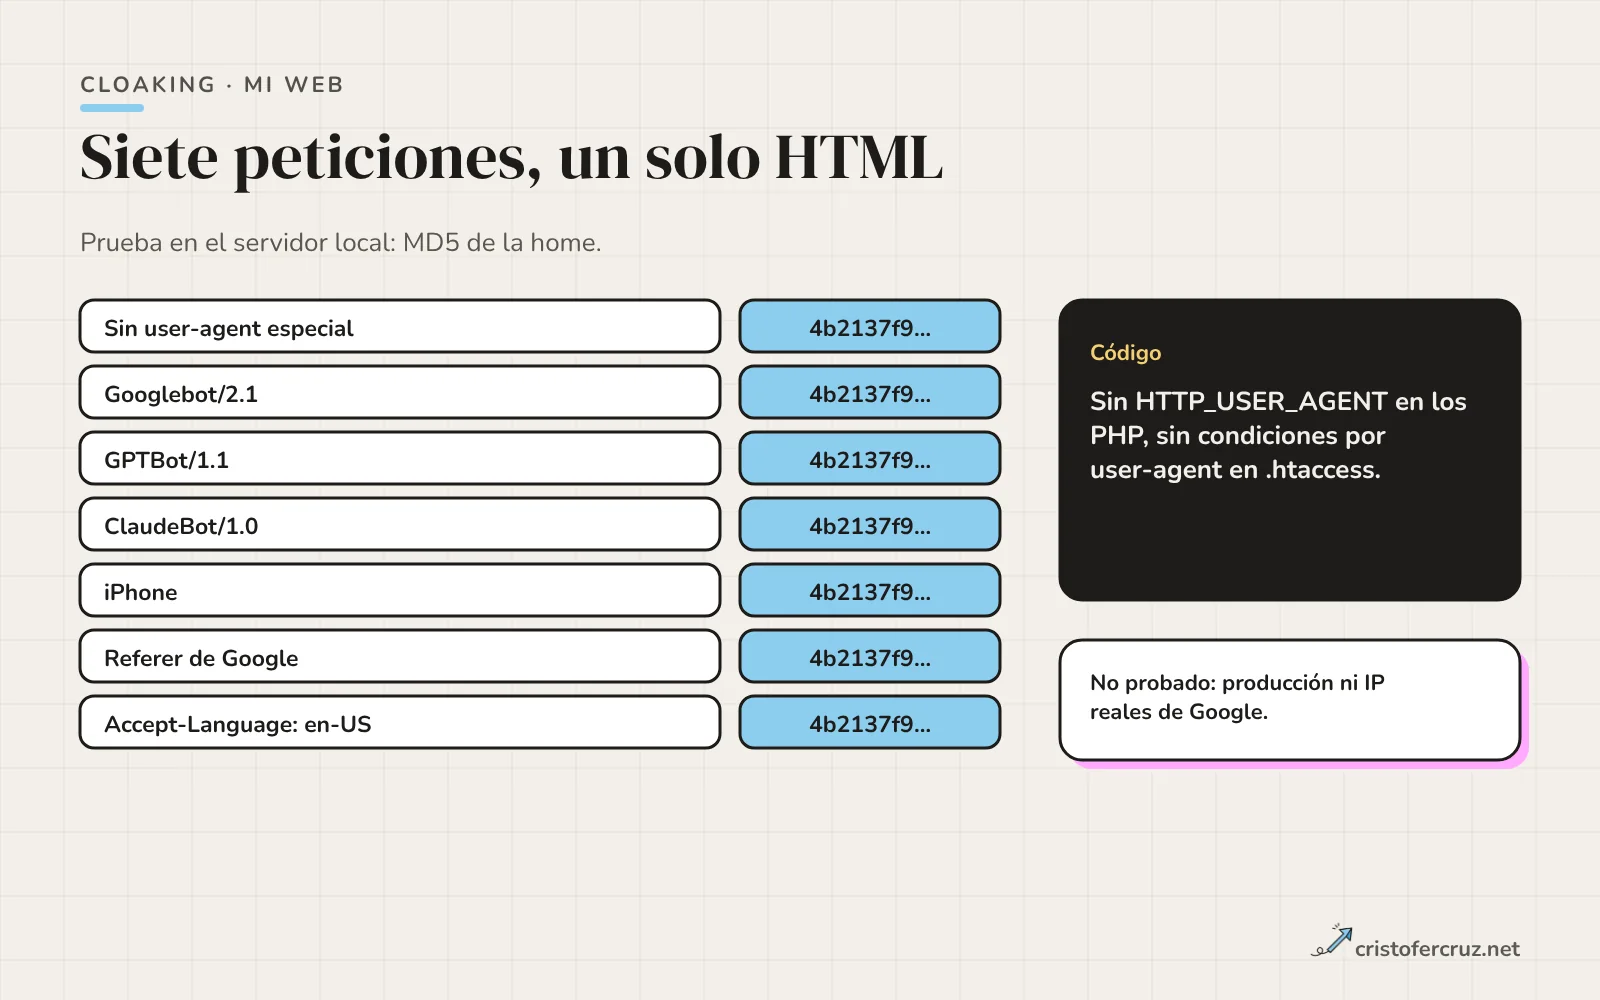
Código. Busqué lógica por user-agent en los PHP, el .htaccess y los JavaScript del sitio. No hay ninguna referencia a HTTP_USER_AGENT, a rastreadores concretos ni a navigator.userAgent en el código de las páginas. Las únicas menciones a Googlebot, GPTBot o bingbot están en el analizador de logs, una herramienta que clasifica líneas de log en el navegador del visitante. El .htaccess tiene tres reglas de reescritura (activar el motor y dos [F,L] que bloquean /tools/ y /.git/) y ninguna condición por user-agent o referer.
Respuesta. Pedí la home con siete identidades distintas y calculé el MD5 del HTML recibido:
| Petición a la home | MD5 del HTML |
|---|---|
| Sin user-agent especial | 4b2137f9… |
| Googlebot/2.1 | 4b2137f9… |
| GPTBot/1.1 | 4b2137f9… |
| ClaudeBot/1.0 | 4b2137f9… |
| User-agent de iPhone | 4b2137f9… |
Referer de Google (-e) | 4b2137f9… |
Accept-Language: en-US | 4b2137f9… |
Los siete hashes son idénticos (165.514 bytes en todos). Un matiz honesto: en páginas con formulario, como /contacto/ o algunas landings de servicio, el HTML cambia entre peticiones porque incluye un token de sesión. Pidiendo /contacto/ dos veces con el mismo user-agent salen hashes distintos, con solo dos líneas de diferencia en el diff: un campo oculto del formulario, no una rama por bot. En páginas con formulario conviene filtrar esa línea antes de comparar.
Lo que no he comprobado. Todo esto es el servidor de desarrollo local. No he repetido la prueba contra el dominio en producción, ni he verificado qué recibe Googlebot desde sus IP reales (eso solo lo dice la Inspección de URLs o el log del servidor), ni he revisado el servidor o la configuración de hosting fuera del código del repositorio. Una web puede estar limpia en su código y contaminada por algo que no está en él.
Cómo audito un posible cloaking, en cinco pasos
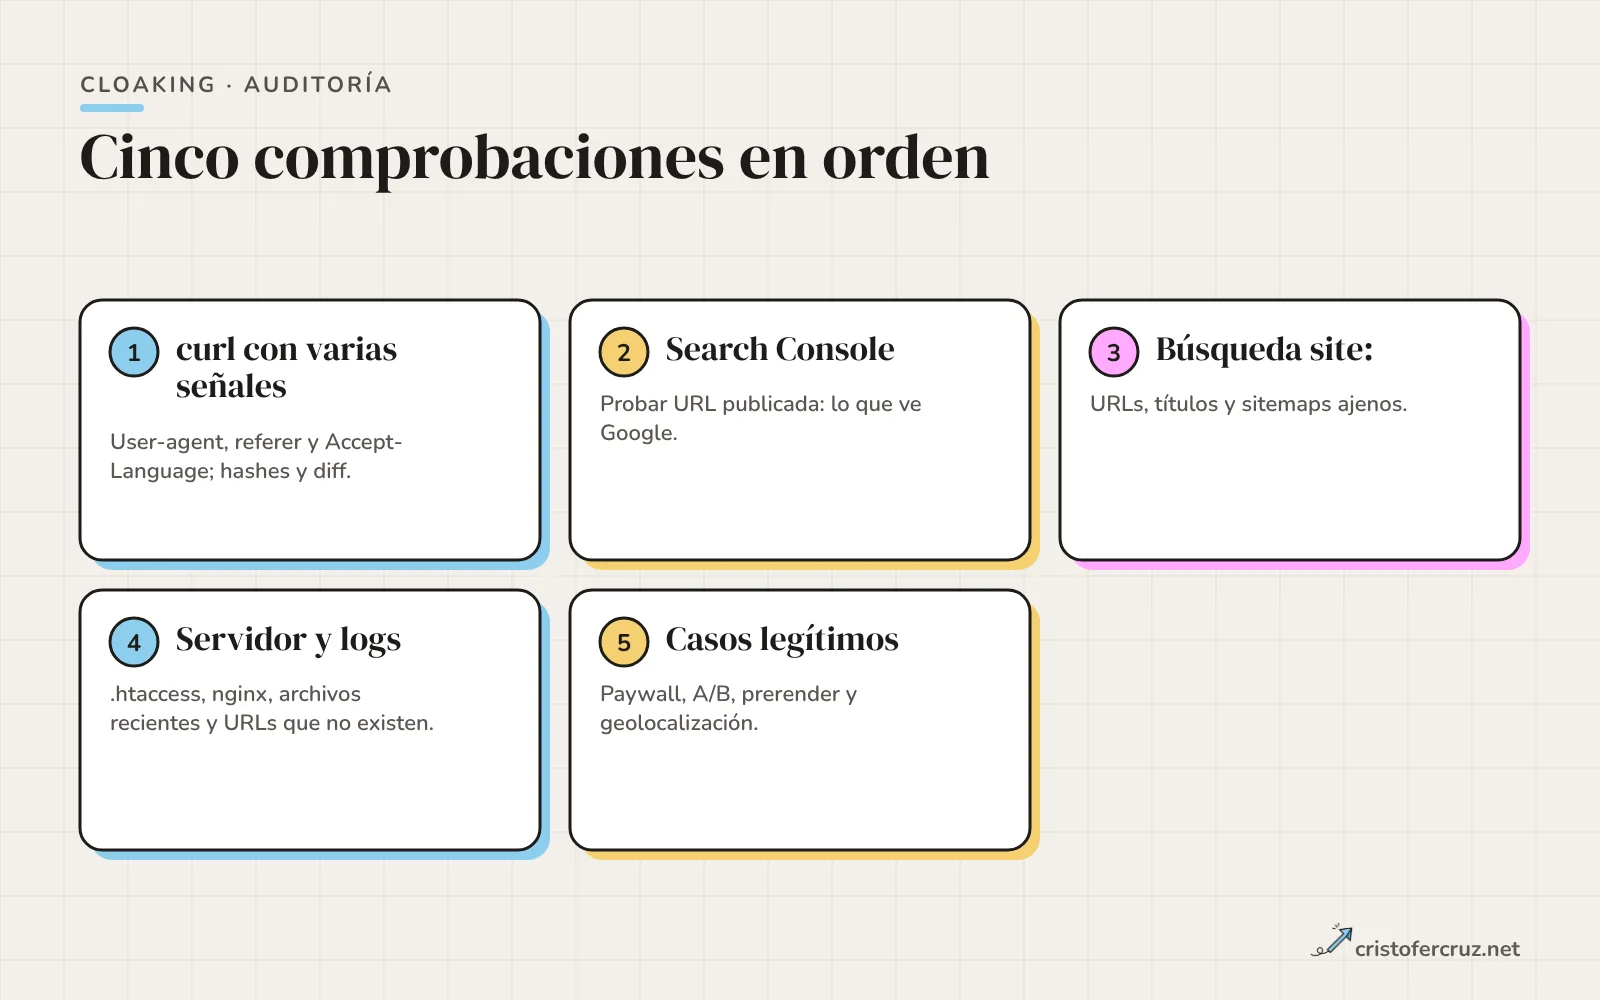
- Compara respuestas con curl. Mismo URL con user-agent de navegador, de Googlebot y de bots de IA, más una prueba con referer de Google. Hashes y
diffsi no coinciden. - Prueba la URL en Search Console. «Probar URL publicada» y revisión del HTML y la captura. Si lo que ve Google no coincide con lo que ves tú, tienes el hallazgo.
- Busca contenido ajeno con
site:. URLs, títulos y directorios que no has creado; sitemaps que no reconoces. - Revisa servidor y logs.
.htaccess, configuración de nginx, archivos modificados recientemente, y en el log los rastreos de URLs que no existen en tu web; la auditoría SEO que hago incluye esta comprobación entre las de rastreo e indexación. - Revisa los casos legítimos. Paywall con marcado, tests A/B con canonical y fecha de fin, prerender con contenido equivalente, geolocalización tratando al bot como a un usuario más.
Si el cloaking es una decisión tuya, desmóntalo ya. Si es una infección, limpia, cierra la vulnerabilidad y no pidas revisión hasta haber corregido todo.
Para controlar por bot lo que sí es legítimo, como indexación o fragmentos en resultados, está la cabecera X-Robots-Tag con directivas por user-agent, que no sirve contenido distinto sino instrucciones distintas sobre el mismo contenido.
Preguntas frecuentes
¿Qué es el cloaking en SEO?
Presentar contenido distinto a los usuarios y a los buscadores con la intención de manipular el posicionamiento y engañar a los usuarios.
¿Un paywall es cloaking?
No, según Google, si ve el contenido completo y sigues sus directrices de muestreo flexible. El marcado con datos estructurados ayuda a diferenciarlo del cloaking.
¿El test A/B y la personalización cuentan como cloaking?
No, si no muestras a Googlebot URLs o contenido distintos de los de los usuarios, usas rel="canonical" en las variantes y retiras el test al terminar.
¿Es cloaking usar dynamic rendering o un servicio de prerender?
Googlebot generalmente no lo considera cloaking siempre que el contenido sea similar, aunque Google lo describe como workaround y no como solución a largo plazo.
¿Cómo compruebo si mi web hace cloaking?
Pide la misma URL con curl -A usando user-agent de navegador y de Googlebot, compara los hashes y haz diff si no coinciden. Complétalo con la Inspección de URLs y con búsquedas site:: curl no detecta reglas por IP.
¿Cómo salgo de una acción manual por cloaking?
Corrige todas las páginas afectadas, comprueba que Google puede acceder a ellas y pulsa «Solicitar revisión» en el informe de acciones manuales. La mayoría de revisiones tardan varios días o semanas.
¿Servir contenido distinto a los bots de IA es cloaking?
No está documentado por Google. Hay opiniones, pero no una regla escrita sobre los rastreadores de IA de terceros. Decidir qué bots acceden es control de acceso; servirles un contenido que los usuarios no ven es otra cosa y conlleva riesgo.
Referencias
- Spam policies for Google web search Google Search Central
- Manual Actions report Ayuda de Search Console
- Paywalled content structured data Google Search Central
- Website testing and Google Search Google Search Central
- Dynamic rendering as a workaround Google Search Central
- How Google crawls locale-adaptive pages Google Search Central
- Fix the cloaked keywords and links hack web.dev
- Fix the Japanese keyword hack web.dev
- Google and Bing don't recommend separate markdown pages for LLMs Search Engine Land
- Cloudflare delists and blocks Perplexity from crawling websites Search Engine Journal